Muse Glimmer is Meta's causale taalmodel met 30 miljard parameters en een speciale perceptie-encoder, gedestilleerd uit Muse Spark en gepubliceerd voor autonome agentische workloads op consumenten- en werkstationhardware. Verdeeld via Ollama onder Apache 2.0, richt het zich op betrouwbaar toolgebruik, taken met een lange horizon, multimodaal begrip en herstel van fouten – zonder dat er gevolgtrekkingen uit de cloud nodig zijn. Deze technische brief van Workstation herschrijft en breidt de openbare modelkaart uit voor ingenieurs die lokale agenten vervoeren.
- Klas: 30B causale LM + perceptie-encoder; gedestilleerd uit Muse Spark; visie + tools + denken.
- Dienen:
ollama run muse-glimmer(~18GB, 128K, tekst+afbeelding); Apple Silicon:muse-glimmer:30b-mlx(~21GB, DFlash). - Fit: altijd ingeschakelde lokale/air-gapped agents op één GPU of Mac Silicon - geen MoE-clustermodel met meerdere TB.
- Sterkte signaal: leidt Meta's gerapporteerde grootteklassematrix op MCP-Atlas, DeepSearch QA, WildClawBench, SWE-Bench Pro, AA-LCR, Beam128K (hoge redenering).
- Operaties: steiger via
ollama launch(Claude Code, OpenCode, Hermes, OpenClaw); regeren met evals, HITL, MCP auth.
Primaire bronnen: Ollama-bibliotheek — muze-glimmer; Methodologie voor meta-evaluatie — Muse Glimmer-methodologie. Nummers en tags veranderen; verifieer de live-modelkaart vóór aanschaf.
1. Architectuur- en ontwerpintentie
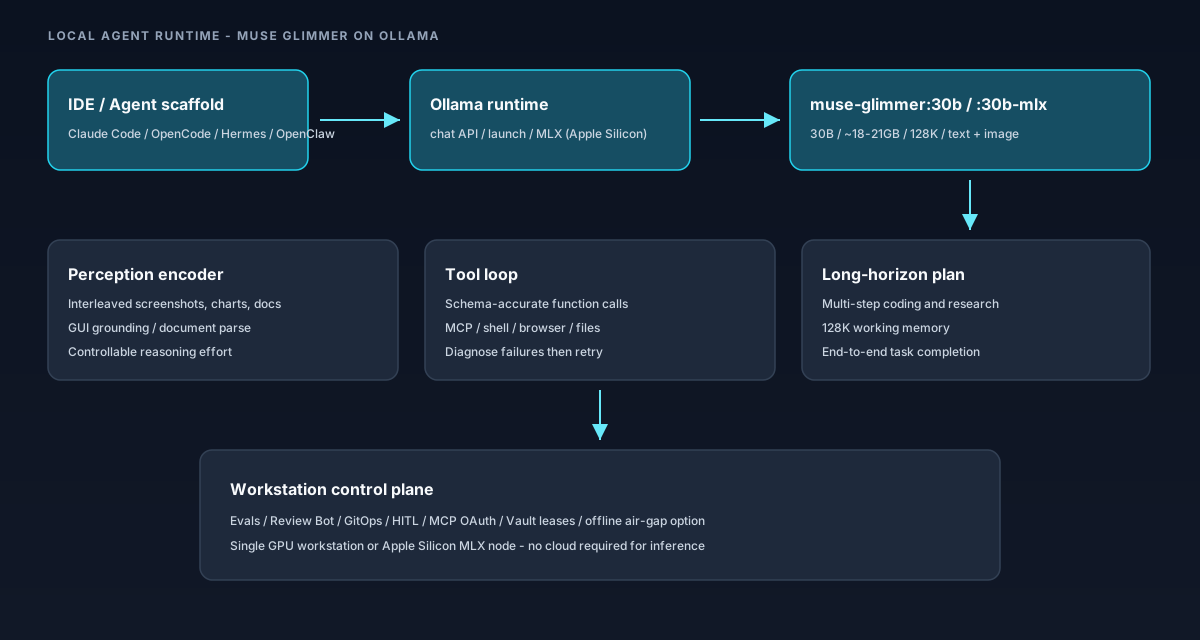
Muse Glimmer is niet gepositioneerd als een algemene chat-MoE. Meta's framing is end-to-end voltooiing van agenttaken over hardware die u kunt kopen voor een bureau of een klein laboratoriumrek:
- Causale LM-ruggengraat (30B) – next-token-generatie met meerstaps redeneerketens die gedurende lange workflows worden ondersteund.
- Speciale perceptie-encoder — accepteert tussengevoegde tekst en afbeeldingen, zodat agenten over schermafbeeldingen, grafieken en documenten kunnen redeneren in hetzelfde contextvenster als tooltranscripties.
- Destillatie uit Muse Spark — overdracht van capaciteiten naar een footprint die zich richt op single-GPU/consumentenklasse-implementatie in plaats van alleen datacenter-service.
- Herstelgedrag bij fouten — wanneer een toolaanroep mislukt of een onverwachte lading retourneert, wordt het model getraind/afgestemd om een diagnose te stellen en het opnieuw te proberen in plaats van de episode te stoppen.
- Beheersbare inspanning — de redeneersterkte is selecteerbaar, zodat operators latentie kunnen inruilen voor kwaliteit per route.
- Meertalige trainingsdekking — Meta vermeldt trainingsgegevens uit meer dan 100 talen.
Voor Workstation-stacks is de productimplicatie: behandel Glimmer als een runtime-brein van agenten achter MCP-tools, shells, browsers en bestandseditors – niet als vervanging voor elke closed frontier API-oproep.
2. Ollama-distributie (tags, footprint, I/O)
Zoals gepubliceerd op de Ollama-bibliotheekkaart (controleer live-groottes):
| Label | Ongeveer. maat | Context | Invoer | Opmerkingen |
|---|---|---|---|---|
muse-glimmer:latest / :30b | ~18GB | 128K | Tekst, afbeelding | Standaard single-GPU-pad |
muse-glimmer:30b-mlx | ~21GB | 128K | Tekst, afbeelding | Ollama MLX-motor; DFlash + afbeelding op Apple Silicon |
# Pull + interactive
ollama run muse-glimmer

# Apple Silicon (MLX)
ollama run muse-glimmer:30b-mlx

# HTTP chat (localhost Ollama)
curl http://localhost:11434/api/chat \
  -d '{"model":"muse-glimmer","messages":[{"role":"user","content":"Hello!"}]}'

# Scaffold launchers (from Ollama applications list)
ollama launch claude --model muse-glimmer
ollama launch opencode --model muse-glimmer
ollama launch hermes --model muse-glimmer
ollama launch openclaw --model muse-glimmer
Python-/JS-clients moeten de tag die u hebt gevalideerd vastzetten (muse-glimmer versus :30b-mlx) in configuratie, niet in hardcode latest bij productieagenten.
3. Capaciteitsoppervlak (technische lezing)
- End-to-end agentische voltooiing – Meta haalt sterke resultaten aan op DeepSearch QA, MCP-Atlas, τ3-Bench (bankieren) en SWE-Bench-familietaken die het succes van meerdere beurten meten, en geen eenmalige trivia.
- Betrouwbaar gereedschapsgebruik — brede dekking van functieaanroepen met schemaprecisie voor uitgebreide workflows (cruciaal voor MCP-toolvloten).
- Redeneren in meerdere stappen — samenhang van plannen over een lange horizon; kan worden gecombineerd met het 128K-contextvenster voor het bewaren van transcripties en documenten.
- Herstel van mislukkingen — onverwachte toolresultaten diagnosticeren en opnieuw proberen; vermindert het afbreken van “brosse agentia” bij nachtelijke banen.
- Multimodaal redeneren - perceptie-encoder maakt screenshot/grafiek/document doorschoten met tekst mogelijk (GUI-aarding en doc-parsebanken opgenomen in Meta's matrix).
- Compatibiliteit met steigers — OpenClaw, Hermes Agent en soortgelijke orkestratiepatronen; Ollama vermeldt Claude Code- en OpenCode-draagraketten als eersteklas apps.
4. Benchmarkmatrix (meta-gerapporteerd, hoge redenering)
Meta vergelijkt Muse Glimmer-30B (hoge redenering) met Gemma4-31B en Qwen3.6-27B in de denkmodus. Kop Workstation-lezing: Glimmer leidt er meerdere agent openbare suites (MCP-Atlas, DeepSearch QA, WildClawBench, Gaia2, SWE-Bench Pro) terwijl ze peers volgen of koppelen aan sommige desktop-agent- en GDP-val-statistieken. Altijd opnieuw opstarten jouw harnas.
| Categorie | Benchmark | Glimmer-30B | Gemma4-31B | Qwen3.6-27B |
|---|---|---|---|---|
| Algemeen agent | MCP-Atlas (openbaar) | 75.5 | 54.2 | 62.5 |
| DeepSearch-QA | 74.6 | 61.7 | 71.1 | |
| τ3-Bankieren | 23.5 | 15.1 | 16.7 | |
| WildClawBench | 47.6 | 37.6 | 43.2 | |
| GDPVal-AA v2 | 953 | 811 | 1141 | |
| Gaia2 | 43.3 | 36.4 | 40.0 | |
| SkillsBench (met vaardigheden) | 44.3 | 32.4 | 46.6 | |
| OSWorld-geverifieerd | 65.9 | 58.5 | 75.6 | |
| Agentische codering | SWE-Bench Pro | 51.2 | 36.9 | 50.2 |
| SWE-Bench geverifieerd | 76.0 | 66.6 | 77.2 | |
| TerminalBench 2.1 | 51.7 | 43.4 | 60.7 | |
| SciCode | 43.6 | 43.4 | 39.8 | |
| Multimodaal | CharXiv-redenering | 78.8 | 77.7 | 78.4 |
| ScreenSpot Pro | 75.4 | 75.9 | 76.1 | |
| OmniDocBench v1.5 | 75.8 | 72.5 | 77.8 | |
| MMMU Pro | 74 | 73 | 75 | |
| Redenering / LCR | IFBench | 77.0 | 76.0 | 70.8 |
| AIME 2026 | 94.7 | 89.2 | 94.1 | |
| GPQA-diamant (AA) | 83.5 | 85.7 | 84.2 | |
| HLE-tekst (AA) | 22.0 | 23.6 | 23.1 | |
| AA-LCR | 80.0 | 68.3 | 73.3 | |
| Straal128K | 65.1 | 58.2 | 63.0 |
Veiligheidsbanken (CI Memories, Siren AgentDojo) laten afwegingen zien: Glimmer rapporteert een hoog nut onder AgentDojo-injecties met mid-pack ASR; behandel veiligheid als een implementatiecontroleprobleem (promptfirewalls, toelatingslijsten voor tools, HITL) - niet als een opgeloste modeleigenschap. Zie Meta's methodologie-pdf voor beoordelingsmodellen, aantal pogingen en kanttekeningen bij het harnas.
5. Evaluatiemethodiek (wat de cijfers betekenen)
De methodologienota van Meta is essentieel voordat u een cel in een bordspel citeert:
- Peer-selectie: open modellen van maatklasse (Gemma4-31B, Qwen3.6-27B); peers kunnen zelfgerapporteerde of intern gereproduceerde scores gebruiken; Kunstmatige analyse gebruikt indien beschikbaar voor alle drie.
- Bemonstering: Glimmer gerapporteerd met hoge redeneersterkte met temperatuur=1,0 / top_p=0,95 / top_k=64; collega's gebruiken door de leverancier aanbevolen denkconfiguraties (Qwen gebruikt koelere temperaturen op sommige agentbanken).
- Vooroordeel bij harnas: Meta merkt op dat modellen van derden mogelijk niet zijn afgestemd op Meta’s tool-/systeemprompts – absolute rangen kunnen verschuiven onder peer-native scaffolds.
- MCP-Atlas: multi-turn toolgebruik op meer dan 20 MCP-servers; LLM-rechter slagingspercentage (drempel 0,75) op 500 publieke taken, gemiddeld over 4 runs.
- DeepSearch-kwaliteitsgarantie: autonome browseloop (zoeken/openen/vinden) op 900 harde onderzoeksvragen; F1 via juryextractie.
- WildClawBench / Gaia2: gedockeriseerde agenttaken met lange horizon onder OpenClaw-achtige harnassen met gebeurtenisinjectie en gemengde deterministische/LLM-beoordeling.
- SWE-Bench: bash + bestandshulpprogramma's; Pro en Verified gemiddeld over meerdere runs – Pro-vergelijkingen vermijden de verfijnde taakvariant van Qwen.
- OSWorld-geverifieerd: GUI-only Ubuntu VM-besturing vanaf schermafbeeldingen (geen directe shell); verschillen in actieruimte tussen modellen zijn van belang.
- Straal128K: niet-agentische lange-contextgeheugentest op 128K - relevant als u grote transcripties in de context houdt zonder RAG.
Workstation-beleid: publiceer Meta’s matrix ter oriëntatie en stuur vervolgens de productie op een interne gouden set (uw MCP-tools, uw repo’s, uw latentie-SLO).
6. Hardware en serveerrealiteit
- Enkele GPU-klasse: ~18GB gewichtsvoetafdruk impliceert een moderne 24GB+ consument/professional. GPU is de praktische NVIDIA-vloer zodra KV-cache en vision-activeringen in aanmerking worden genomen; profiel met uw maximale context en gelijktijdige sessies.
- Apple Silicon: de voorkeur geven aan
:30b-mlx(~21GB) voor Ollama's MLX-pad met DFlash speculatieve decodering en native beeldinvoer - Mac Studio / Mac mini Max-configuraties zijn eersteklas MKB-knooppunten. - Niet Kimi-K3-klasse: dit is geen MoE met meerdere knooppunten. Als je open agents met biljoen parameters nodig hebt, bekijk dan onze gids voor open gewichten; Glimmer is eigenaar van de altijd aan op het bureau niche.
- Kubernetes: pakket Ollama of een OpenAI-compatibel zijspan per knooppunt; keep model haalt uw privéregister/cache op; stel Ollama niet ongebonden bloot aan internet.
7. Beveiliging en beheer voor agenten die altijd actief zijn
Lokale gewichten verminderen het uitgaand verkeer van gegevens, maar vergroten de explosieradius van een gecompromitteerde agenthost. Minimale Workstation-basislijn:
- MCP OAuth 2.1 + kortstondige geheimen (Vault-leases) — zie agent beveiligingsartikel.
- Toelatingslijsten voor tools en beleid voor uitgaand netwerkverkeer per agent-identiteit.
- HITL houdt toezicht op onomkeerbare acties (betalingen, productinzet, massale e-mail).
- Prompt-injectiemonitoring op door tools geretourneerde inhoud (bedreigingsmodel in Siren AgentDojo-stijl).
- Offline / air-gap-modus getest als een eersteklas runbook, geen hoop.
8. Productiechecklist
- Ollama-tag vastzetten (
30bversus30b-mlx) en neem digest/hash op in GitOps. - Bouw een gouden suite met 20 tot 50 taken die uw MCP-tools en codeerworkflows weerspiegelt; volg pass@1 en p95-latentie op elk inspanningsniveau.
- Draadsteiger (
ollama launch …of aangepast) met gestructureerde registratie van tooloproepen en nieuwe pogingen. - Definieer hybride router: Glimmer local voor privé RAG/agents; cloud-failover voor overflow/piek-IQ.
- Documenteer VRAM/unified-memory-headroom op 32K / 64K / 128K met vision aan.
- Juridisch: Apache 2.0-beoordeling voor uw distributiemodel (meestal eenvoudig versus restrictieve licenties met een open gewicht).
- Ship Review Bot + evaluatiepoorten voordat onbeheerde nachtagenten worden ingeschakeld.
Gepubliceerd door Workstation. Modelkaart: ollama.com/bibliotheek/muse-glimmer.