
Le deep learning (DL) est l’apprentissage de représentations avec des réseaux de neurones multicouches : les paramètres θ sont optimisés pour qu’une composition de transforms non linéaires mappe des entrées haute dimension (pixels, tokens, formes d’onde) vers des sorties de tâche (labels, boxes, embeddings ou séquences échantillonnées). Ce brief technique Workstation réécrit l’aperçu conceptuel d’AWS pour les ingénieurs et agents IA qui déploient des systèmes sur Kubernetes, SageMaker et Bedrock.
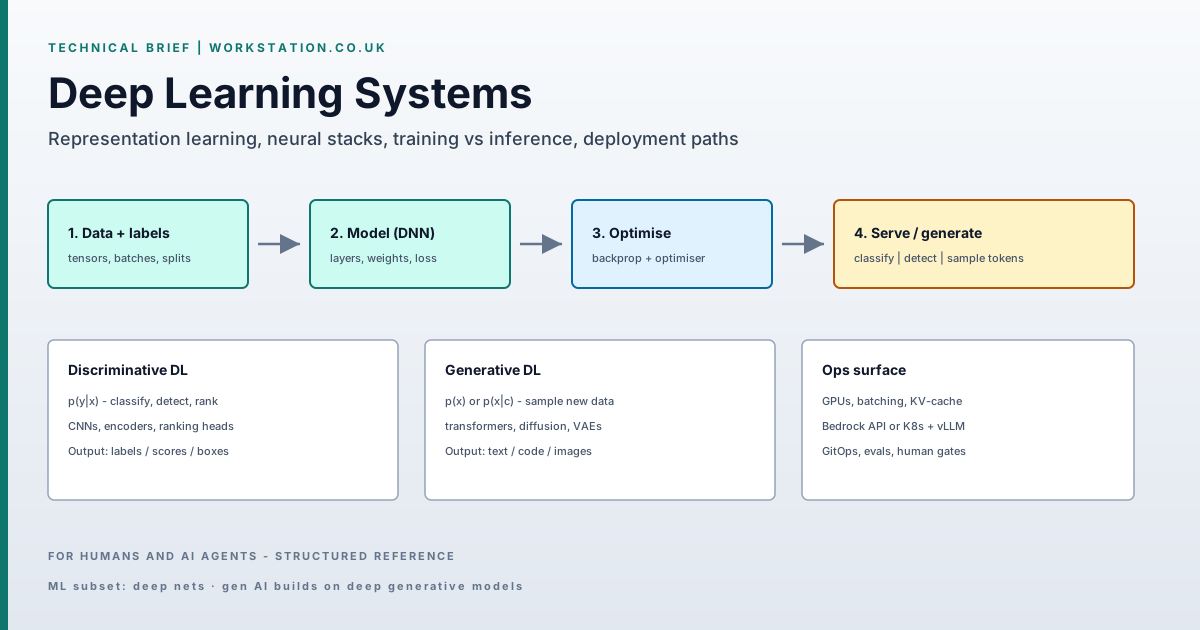
- Définition : DL ⊂ ML ; ANN multicouches entraînés principalement par descente de gradient sur une perte différentiable.
- Scission : discriminant p(y|x) vs génératif p(x) ou p(x|c).
- Gen AI : en général grands transformers (ou diffusion) + serving + politique ; pas une science séparée du DL.
- Contraintes dures : volume de données labellisées/nettoyées, FLOPs/VRAM accélérateur, drift/ops.
- Route : tabulaire → ML classique ; perception → entraîner/servir DL ; agents langage → API foundation model ou inférence open-weight.
Source primaire : AWS — What is Deep Learning?. Les specs et noms de services évoluent ; vérifiez la doc AWS actuelle avant de provisionner.
1. Définition formelle
Un modèle profond est une fonction paramétrique f_θ composée de L couches. La couche ℓ calcule h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)) pour une non-linéarité σ (ReLU, GELU, SiLU, etc.). L’entraînement cherche θ = {W, b, …} pour minimiser le risque empirique :
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
Contrairement aux pipelines superficiels qui s’appuient sur des features conçues à la main, les réseaux profonds apprennent des features hiérarchiques à partir de tenseurs bruts ou légèrement prétraités. C’est pourquoi le DL domine la vision, la parole et le NLP à grande échelle : l’espace de features est trop haute dimension pour l’ingénierie manuelle.
2. Deep learning discriminant vs génératif
Les modèles discriminants estiment p(y|x) ou une frontière de décision — classifieurs, détecteurs, rankers, embedders. Les modèles génératifs (deep generative) estiment p(x) ou p(x|c) et peuvent échantillonner de nouvelles instances : LLMs next-token, modèles d’image diffusion, VAEs, GANs.
Les foundation models utilisés dans les agents produit sont des systèmes génératifs profonds entraînés à grande échelle, puis alignés et servis. Appeler Bedrock Converse ou un endpoint vLLM auto-hébergé est de l’inférence sur un tel modèle — toujours du deep learning en dessous.
3. Pourquoi les systèmes de production en dépendent
Surfaces déployées qui intègrent déjà le DL (ou des foundation models adossés au DL) :
- Agents conversationnels et synthèse de code
- ASR / TTS et UIs vocales
- Scoring fraude / anomalie sur séquences
- Piles de perception (ADAS, CV industrielle, imagerie médicale)
- Personnalisation et ranking de recherche avec tours profondes
Si un item de roadmap est « fonctionnalité IA », l’implémentation est presque toujours un modèle profond, une API foundation-model, ou un hybride (RAG + outils) par-dessus.
4. Taxonomie des tâches (carte d’implémentation)
4.1 Vision par ordinateur
CNNs / ViTs mappent des tenseurs image vers classes, boxes, masks ou embeddings. Patterns de production : modération de contenu, reconnaissance d’attributs, détection logo/PPE, inspection de défauts en ligne. Métriques : mAP, IoU, latence à batch size 1 sur GPU cible.
4.2 Parole
Modèles acoustiques + modèles de langage (ou ASR end-to-end) tolèrent accent, SNR et variance de débit de parole. Charges : assistance centre de contact, dictée clinique, sous-titrage. Métriques : WER, facteur temps réel (RTF).
4.3 NLP
Des classifieurs encodeurs aux LLMs decoder-only. Charges : intent/slot, résumé, QA documentaire, indexation de sentiment. Les LLMs dominent le texte ouvert ; les encodeurs plus petits gagnent encore sur classify/extract bornés en latence.
4.4 Recommandeurs
Rankers two-tower / DeepFM / transformer sur séquences d’interactions user–item. Sorties : listes classées avec diversité et contraintes métier. Offline : NDCG/recall ; online : CTR/CVR avec contrôles d’exploration.
4.5 Applications génératives
Échantillonnage + usage d’outils : RAG sur corpus privés, assistance code, rédaction de documents, workflows multi-agents. Sur AWS : Bedrock FMs ou poids hébergés SageMaker. Sur les estates Workstation : pools GPU Kubernetes (vLLM/Ollama) sous GitOps quand la résidence ou l’économie unitaire l’exigent.
5. Architecture : couches et forward pass
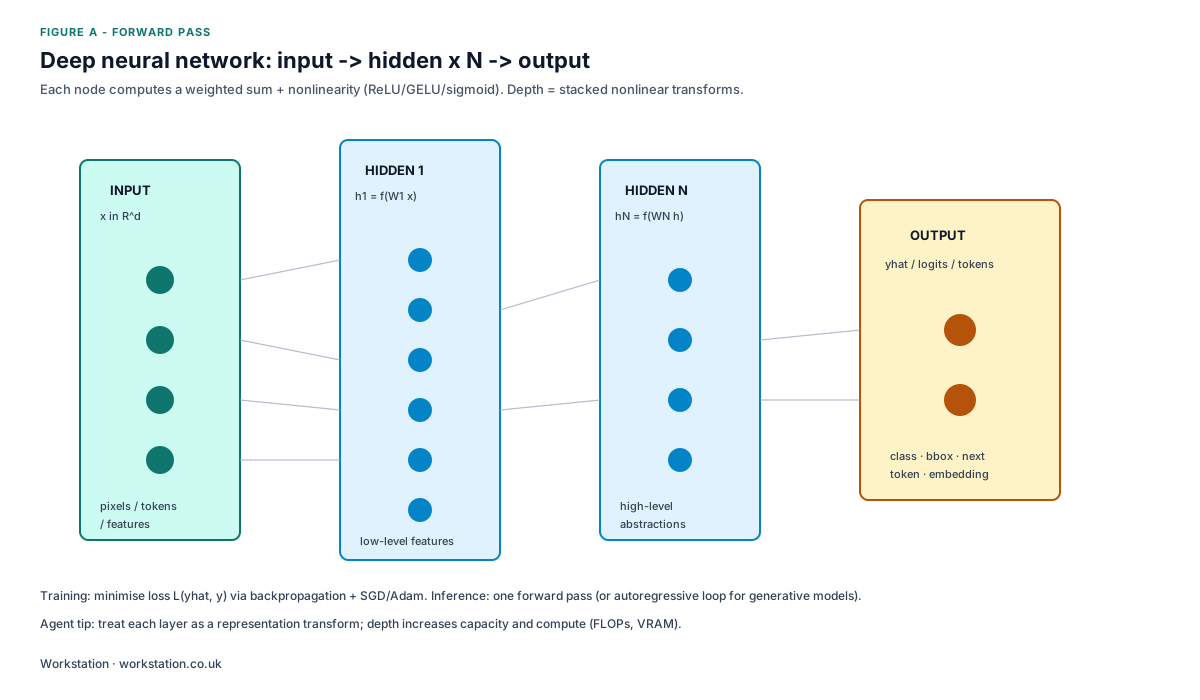
- Couche d’entrée — interface tenseur : pixels normalisés, IDs de tokens, frames log-mel, ou vecteurs tabulaires.
- Couches cachées — transforms de représentation successives. Les couches précoces capturent la structure locale (bords, n-grams) ; les plus profondes capturent la sémantique de tâche. La profondeur augmente la capacité expressive et le compute (FLOPs, mémoire d’activation).
- Couche de sortie — tête de tâche : logits softmax, régression de bounding-box, CTC, ou projection vocab pour décodage autorégressif.
Entraînement = de nombreux forward + backward passes. Inférence = forward seulement (plus KV-cache / speculative decoding pour les LLMs).
6. ML vs DL vs IA générative
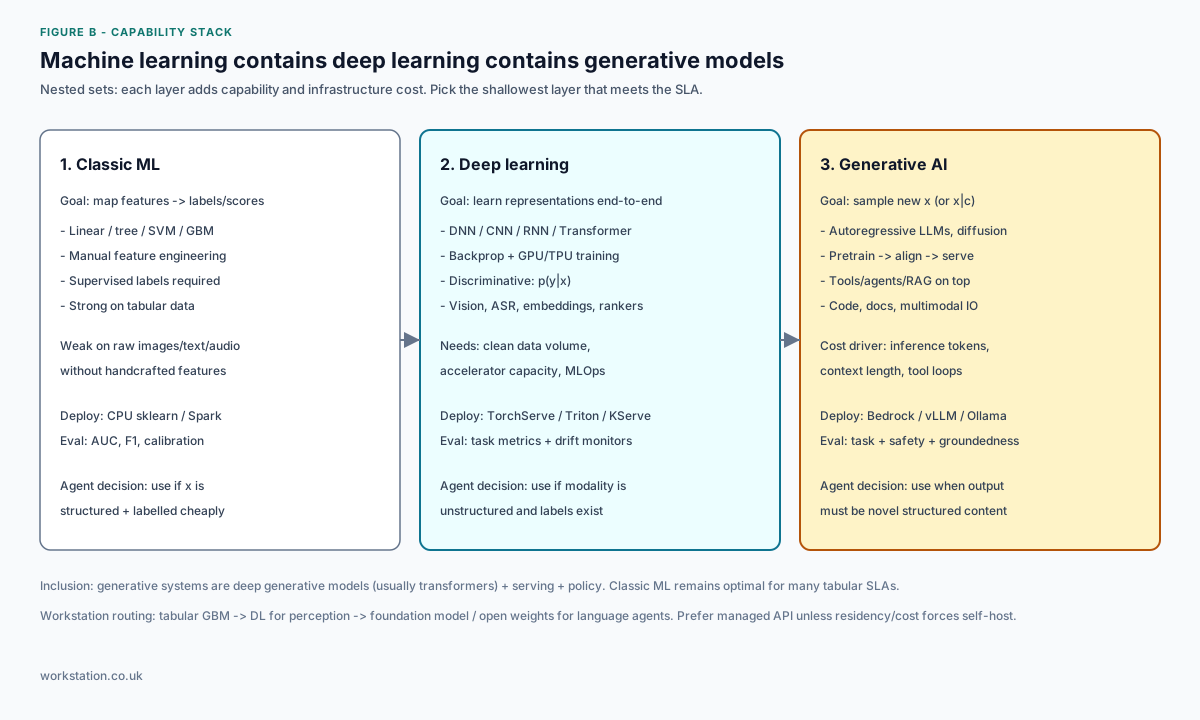
| Couche | Objectif | Pile typique |
|---|---|---|
| ML classique | p(y|φ(x)) avec φ engineered | GBM / linéaire sur tables warehouse |
| Deep learning | f_θ(x) end-to-end sur modalités brutes | PyTorch + Triton/KServe sur nœuds GPU |
| IA générative | échantillonner x ou x|c ; agents/outils au-dessus | Bedrock Converse ou vLLM + RAG |
6.1 Avantages du DL sur le ML superficiel (quand ils s’appliquent)
- Modalités non structurées — des embeddings partagés écrasent la variance de paraphrase (« payer » vs « virer de l’argent »).
- Découverte de features — les gradients sculptent des internes utiles sans listes de features manuelles.
- Transfer / fine-tune — réutiliser des backbones préentraînés ; réduire les données labellisées vs entraînement from scratch.
- Modélisation de séquences / ensembles — les transformers gèrent les dépendances longue portée que bag-of-features rate.
Le DL ne bat pas automatiquement un GBM bien réglé sur des données tabulaires denses avec de fortes features. Choisissez par modalité et régime de données, pas par mode.
7. Modes de défaillance et contraintes
- Qualité des données — le bruit de labels et le distribution shift dominent les budgets d’erreur. Versionnez les datasets ; mettez en quarantaine les outliers avant qu’ils n’entrent dans le set d’entraînement.
- Compute — l’entraînement et l’inférence large-batch sont liés à l’accélérateur. Des GPUs sous-dimensionnés produisent des boucles de plusieurs jours et tuent la vitesse d’itération.
- Ops — sans gates d’eval, moniteurs de drift, télémétrie de coût et rollback (GitOps), les modèles pourrissent en production quels que soient les diagrammes d’architecture.
8. Accélération cloud vs auto-hébergement
Le cloud raccourcit le cycle d’expérience : pools GPU/CPU élastiques, notebooks/pipelines gérés, et foundation models en APIs. Blocs de construction AWS :
- Amazon SageMaker — entraîner, tuner, héberger des artefacts DL custom.
- Amazon Bedrock — invoquer des foundation models avec IAM, Guardrails et ZDR optionnel.
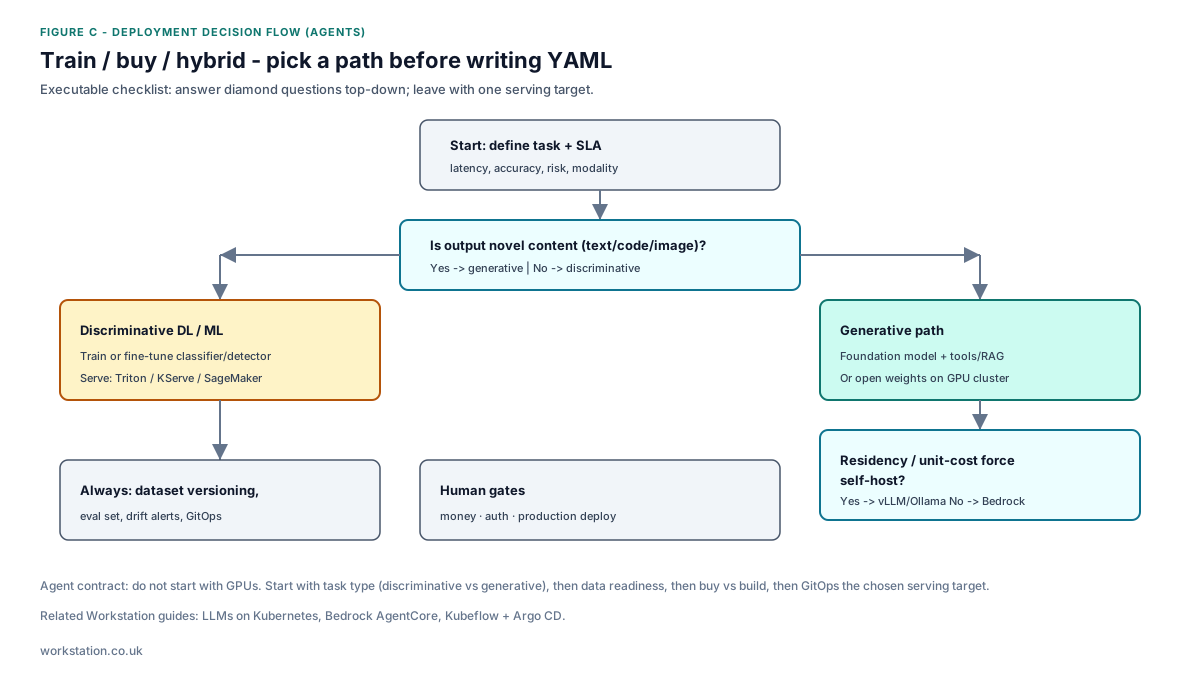
Auto-hébergez sur Kubernetes quand les poids ouverts, la résidence des données ou l’économie des tokens favorisent des GPUs détenus. Pattern : model registry + KServe/vLLM + sync Argo CD.
9. Checklist d’exécution
- Écrire la tâche comme un objectif mesurable (métrique + latence + classe de risque).
- Sélectionner la couche de pile de la Figure B ; ne sautez pas vers gen AI pour un scorecard tabulaire.
- Budgéter la préparation des données + OpEx d’inférence ; l’entraînement est souvent une minorité du coût de vie.
- Implémenter le harness d’eval avant un large rollout ; câbler les alertes de drift.
- Lectures suivantes : serving LLM ou agents Bedrock.
Publié par Workstation — plateformes d’automatisation, logiciels multi-agents, livraison Kubernetes.


