La boutique est ouverte

Nous construisons les machines Workstation AI pour les sites web, les agents IA et l'entraînement de LLM — configurez-les et achetez-les en ligne.

Entrer dans la boutique
Produits IA
Labs IAAgents OpenAIAgents ClaudeGrok BotCRM natif Workstation AIMarketingTous les produits
Solutions IA
IA appliquéeAgents IAIA générativeAutomatisation par IAMontée en compétence IAOffres IA pour PMELaboratoire IA d'entrepriseStations de travail IAMatériel et logiciels NVIDIACalcul accéléré NVIDIAIA privéeClusters GPUIA en périphérieIA par secteur
Services IA
Modernisation des plateformesIngénierie numériqueFondations data et IAOpérations autonomesConseil IAAutomatisation DevOpsCybersécuritéDéveloppement logicielCréation d'agentsMise en place MLOps
À propos
EntrepriseNotre histoirePartenairesTémoignages clients
Centres de données IA
Analyses IASérie JevLabo de benchmarksChoix de modèles
Articles
Documentation
OS LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
Plateformes cloud d'IAAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryClouds et places de marché GPU
Centres de données IA privésPour les cabinets d'avocatsPour les cabinets comptablesPlateformes sur siteCloud entièrement sécurisé
OutilsRing PromoterJobshout
Actualités
Blog
Nous contacterSe connecter

Stations de travail IA, logiciels multi-agents IA, infrastructure GPU et solutions d'agents intelligents pour les entreprises modernes.

Nous contacter

Solutions IA

IA appliquéeAgents IAIA générativeAutomatisation par IAMontée en compétence IAOffres IA pour PMELaboratoire IA d'entrepriseIA par secteur

Produits

Tous les produitsWorkstation AI native CRM & ERPMarketingAgents OpenAIRing PromoterJobshout

Entreprise

À proposEntrepriseCentres de données IAPourquoi WorkstationPartenairesTémoignages clientsTarifsContactTenthMatrix

Ressources

Analyses IAArticlesDocumentationOS LinuxPlateformes cloud d'IACentres de données IA privésBlogRechercherPlan du site
Bureau du Royaume-Uni
77-79 Marlowes, Hemel Hempstead HP1 1LFItinéraire : prenez la sortie 20 de la M25, Outer LondonN° d'entreprise: 11641870Lun - Ven : 9h00 - 18h00 GMT
+44 7515 356 146
Bureau de Belgique
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Lun - Ven : 9h00 - 18h00 CET
+32 492 45 67 46
Bureau de l'Inde
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI. Tous droits réservés.

ConfidentialitéSuppression des donnéesCookiesConditions d'utilisationPlan du site web

NVIDIA Partner · Royaume-Uni

Solutions de calcul accéléré NVIDIA

D’un seul GPU pour centre de données à une usine d’IA à l’échelle du rack refroidie par liquide, Workstation dimensionne, fournit, assemble, installe et prend en charge toute la gamme de calcul accéléré NVIDIA pour les organisations britanniques.

Parcourir la gammeParler à un ingénieur
  • 34Systèmes, GPU, réseaux et logiciels NVIDIA
  • 5étapes, du dimensionnement au support à long terme
  • UKingénierie, assemblage et tests en charge prolongée

Le calcul accéléré, sans risque d’intégration

Le calcul accéléré déplace les parties les plus lourdes d’une charge de travail, comme l’entraînement et l’inférence d’IA, la simulation, l’analytique et le rendu, des CPU généralistes vers des GPU et des processeurs spécialisés. Résultat : davantage de travail par rack et par watt, et des résultats en quelques heures plutôt qu’en plusieurs jours.

Il faut plus qu’un GPU pour y parvenir. Chaque accélérateur a besoin d’un serveur capable de l’alimenter et de le refroidir, d’un réseau qui l’alimente en données et de logiciels sous licence et pris en charge. En tant que NVIDIA Partner doté de ses propres ingénieurs, nous réunissons ces éléments en un système unique et testé, et restons à vos côtés après la mise en service.

  • Des conseils indépendants sur la plateforme NVIDIA adaptée à vos charges de travail
  • Des configurations complètes et NVIDIA-Certified plutôt que des pièces détachées
  • Assemblés, préparés et testés en charge prolongée dans notre atelier britannique
  • Installés, câblés et mis en service sur votre site
  • Un interlocuteur unique au Royaume-Uni pour le support, les mises à niveau et la garantie

Les composants d’un système accéléré

Quatre couches fonctionnent ensemble. Nous spécifions les quatre pour qu’aucune ne devienne un goulet d’étranglement.

GPU

Ils effectuent les calculs parallèles qui sous-tendent l’IA, la simulation et le graphisme. La taille et la bande passante de la mémoire déterminent généralement le GPU dont vous avez besoin.

CPU et systèmes

Ils alimentent les GPU, exécutent le système d’exploitation et conservent les données en mémoire. Le châssis détermine l’alimentation, le refroidissement et le nombre de GPU possibles.

Réseau et DPU

Ils transfèrent les données entre GPU, serveurs et stockage. Les DPU déchargent le CPU des tâches de réseau, de stockage et de sécurité.

Logiciels

Les pilotes, CUDA, les frameworks d’IA et les outils de cluster transforment le matériel en une plateforme exploitable par vos équipes.

Pourquoi les organisations passent au calcul accéléré

Les charges de travail dépassent les CPU

Les modèles d’IA et les jeux de données croissent plus vite que les performances des CPU. Les tâches débordent, les niveaux de service se dégradent et la facture d’électricité grimpe.

Les flux de travail se complexifient

La préparation des données, l’entraînement, l’inférence et la visualisation tournent souvent sur des équipements distincts. Une plateforme accélérée unique simplifie la chaîne.

Les nouvelles applications créent de nouveaux silos

Ajouter l’IA à côté des applications existantes peut créer des îlots de matériel. Une plateforme partagée et certifiée garde l’ensemble gérable.

La gamme

Produits de calcul accéléré NVIDIA

Chaque système, GPU, produit réseau et licence logicielle ci-dessous peut être fourni seul ou dans le cadre d’une configuration complète. Filtrez par type, comparez les caractéristiques principales et demandez un devis.

Systèmes et plateformes

NVIDIA Vera Rubin NVL72

Système à l’échelle du rack pour l’IA agentique et les plus grands modèles

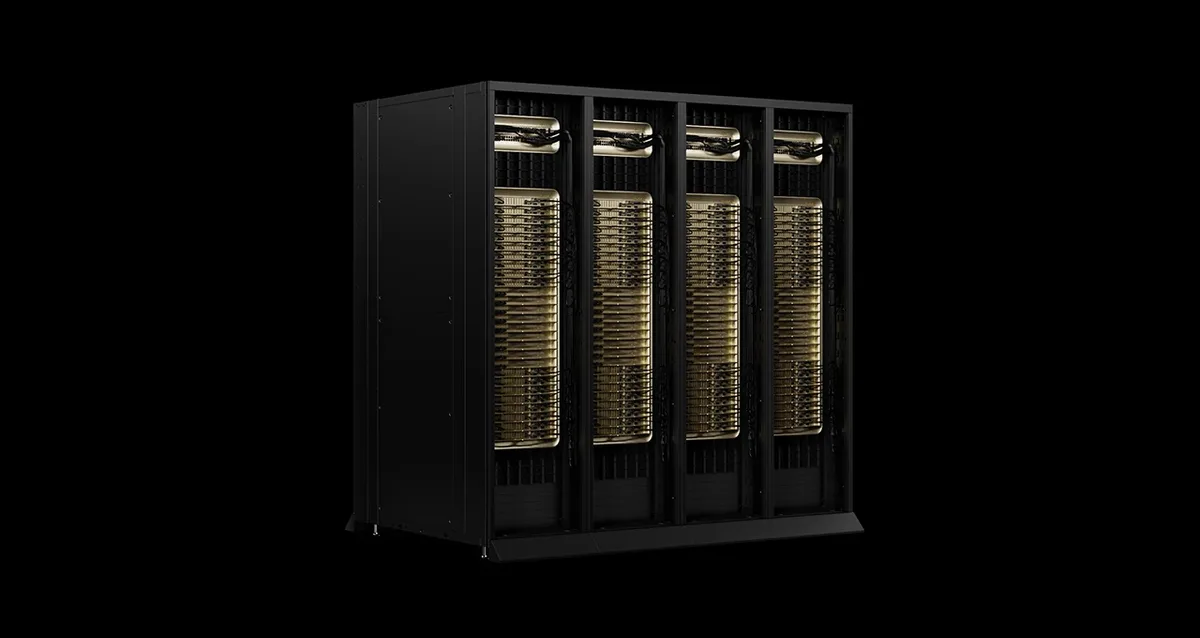
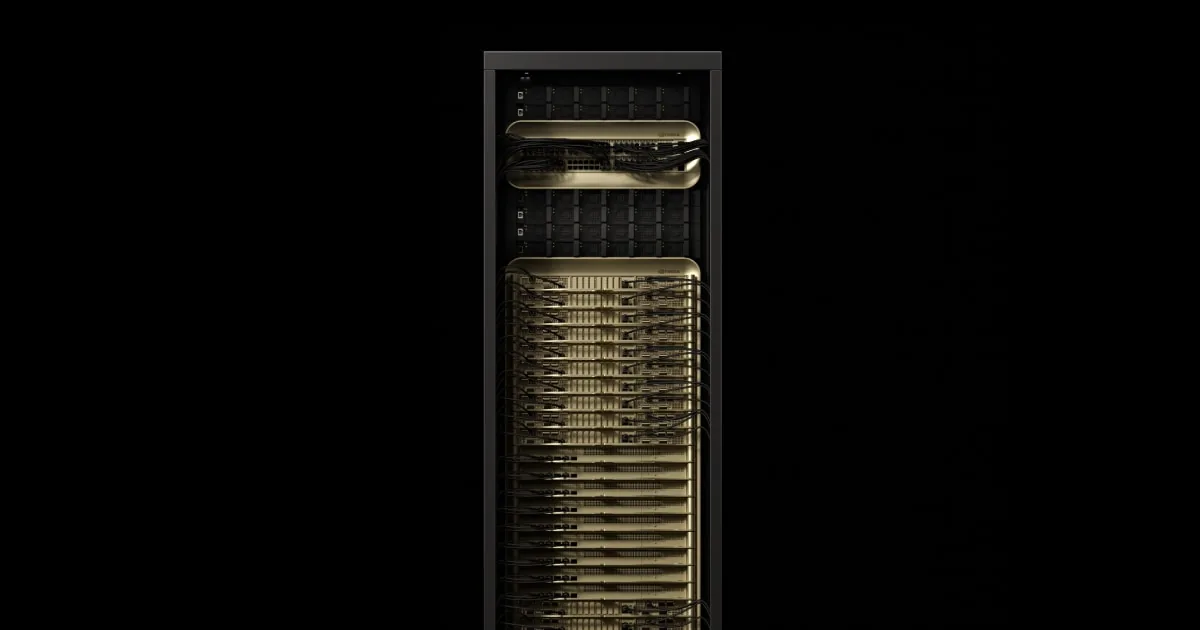
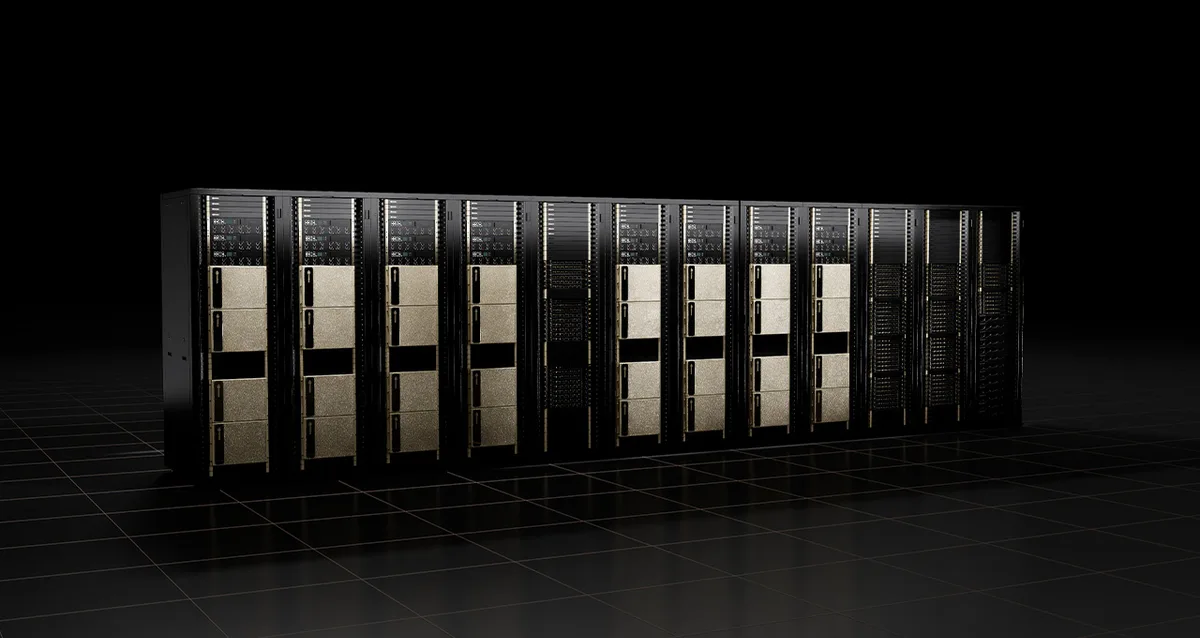
La toute dernière génération à l’échelle du rack de NVIDIA réunit 72 GPU Rubin et 36 CPU Vera dans un seul domaine NVLink, de sorte qu’un rack se comporte comme un unique accélérateur de très grande taille.

Pour qui: Usines d’IA, concepteurs de modèles et fournisseurs de services qui préparent leur prochain grand déploiement

Avantages

  • Bien plus de tokens par mégawatt que la génération Grace Blackwell, selon les chiffres de NVIDIA
  • Mémoire HBM4 dimensionnée pour les modèles à des milliers de milliards de paramètres et à long contexte
  • Des plateaux modulaires sans câbles qui simplifient la maintenance dans le rack

Caractéristiques principales

Configuration72× Rubin GPU, 36× Vera CPU
Mémoire GPU20.7 TB HBM4 | 1,400 TB/s
Inférence NVFP43,600 PFLOPS (sparse)
Bande passante NVLink216 TB/s (sixth generation)
Mémoire CPUUp to 54 TB LPDDR5X
FormatRack, third-generation MGX NVL72

Ce que fait Workstation: Nous vérifions très tôt l’alimentation, le refroidissement et la charge au sol du site, sécurisons l’allocation et planifions la livraison, l’installation et la mise en service en fonction de votre salle informatique.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

NVIDIA GB300 NVL72 (DGX GB300)

Rack Blackwell Ultra refroidi par liquide pour le raisonnement IA

Trente-six CPU Grace et 72 GPU Blackwell Ultra partagent une seule fabric NVLink dans un rack unique refroidi par liquide. NVIDIA le propose aussi sous le nom DGX GB300.

Pour qui: Organisations qui servent des modèles de raisonnement à de nombreux utilisateurs et équipes qui entraînent à l’échelle des modèles de pointe

Avantages

  • Un net bond en tokens par seconde et par utilisateur par rapport aux systèmes basés sur Hopper
  • 37 TB de mémoire rapide conservent les longs contextes et les grands modèles dans un seul domaine
  • Les SuperNIC ConnectX-8 offrent à chaque GPU un accès réseau à 800 Gb/s

Caractéristiques principales

GPU72× Blackwell Ultra
CPU36× Grace (2,592 Arm Neoverse V2 cores)
Mémoire GPU20 TB | up to 576 TB/s
Mémoire rapide37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
Bande passante NVLink130 TB/s

Ce que fait Workstation: Nous planifions le refroidissement liquide et l’alimentation avec votre équipe infrastructures, coordonnons la livraison du rack intégré et le mettons en service selon une référence validée.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

NVIDIA GB200 NVL72 (DGX GB200)

Système Grace Blackwell à l’échelle du rack dans un seul domaine NVLink

Le premier rack Grace Blackwell : 72 GPU Blackwell et 36 CPU Grace reliés par NVLink et refroidis par liquide, pour les très grands entraînements et l’inférence en temps réel.

Pour qui: Équipes qui entraînent ou servent des modèles à des milliers de milliards de paramètres et ont besoin d’un vaste pool de mémoire GPU partagé

Avantages

  • Inférence en temps réel sur de très grands modèles de langage, bien plus rapide que sur H100 selon les chiffres de NVIDIA
  • Le refroidissement liquide augmente la densité et l’efficacité énergétique
  • Le NVLink de cinquième génération offre 1.8 TB/s entre deux GPU quelconques

Caractéristiques principales

Configuration72× Blackwell GPU, 36× Grace CPU
Mémoire GPU13.4 TB HBM3E | 576 TB/s
NVFP4 Tensor Core1,440 PFLOPS sparse | 720 PFLOPS dense
Bande passante NVLink130 TB/s
Mémoire CPU17 TB LPDDR5X | 14 TB/s
RefroidissementLiquid cooled

Ce que fait Workstation: Nous évaluons votre site pour le refroidissement liquide, gérons la livraison et l’intégration à votre réseau et à votre stockage, et assurons le support du rack après la mise en service.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

NVIDIA DGX B300

Huit GPU Blackwell Ultra dans un système DGX

Un serveur DGX autonome doté de huit GPU Blackwell Ultra, du réseau NVIDIA et de toute la pile logicielle DGX, prêt à fonctionner seul ou à rejoindre un BasePOD ou un SuperPOD.

Pour qui: Entreprises qui bâtissent leur première véritable usine d’IA et équipes qui préfèrent le design de référence NVIDIA à une configuration sur mesure

Avantages

  • 2.3 TB de mémoire GPU dans un seul nœud pour les grands modèles
  • Réseau ConnectX-8 et BlueField-3 intégré pour la montée en charge horizontale
  • Le logiciel DGX assure la cohérence de chaque nœud du cluster dès le premier jour

Caractéristiques principales

GPU8× Blackwell Ultra
Mémoire GPU2.3 TB total
Performances IA72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
Réseau8× ConnectX-8, 2× BlueField-3 DPU

Ce que fait Workstation: Nous vérifions l’alimentation et la circulation d’air du rack, livrons et installons le système en rack, le connectons à votre fabric et vous le remettons avec DGX OS et les pilotes validés.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
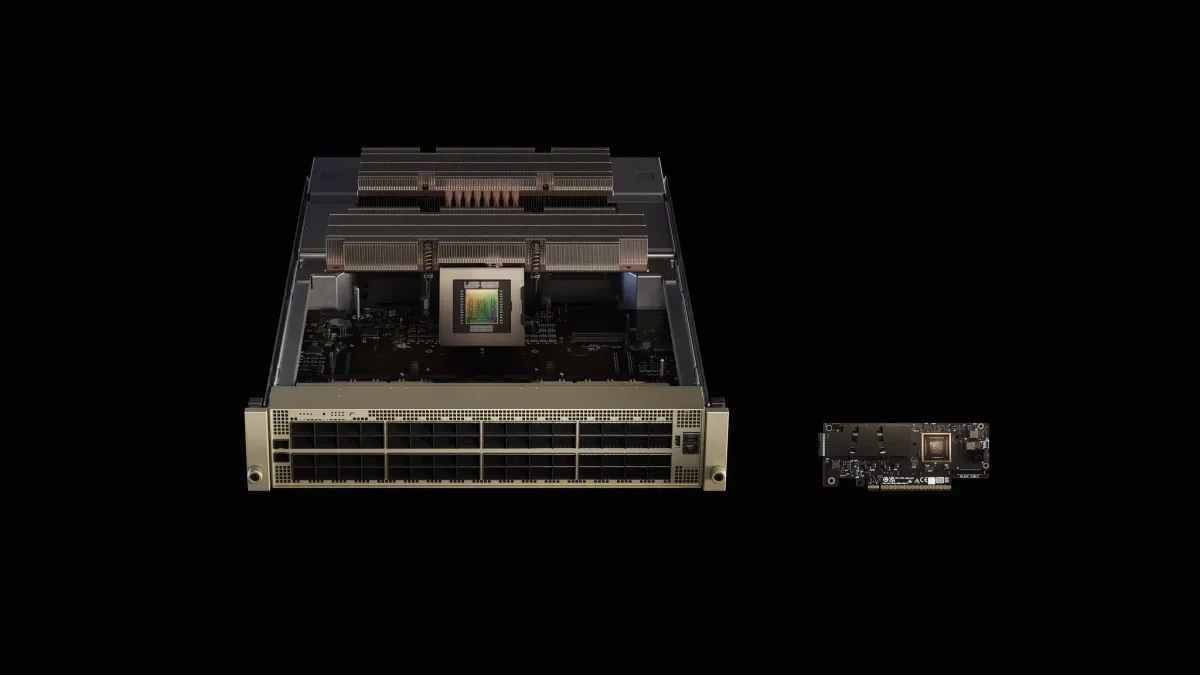
Systèmes et plateformes

NVIDIA DGX B200

DGX Blackwell éprouvé pour l’entraînement et l’inférence

Huit GPU Blackwell reliés par NVLink dans un seul châssis DGX, une brique largement déployée pour l’IA sur site.

Pour qui: Équipes qui passent de Hopper ou de GPU cloud à une plateforme Blackwell en propre

Avantages

  • Une seule plateforme pour l’entraînement, le fine-tuning et l’inférence
  • 1,440 GB de mémoire GPU répartis sur huit GPU reliés par NVLink
  • S’intègre aux designs de référence BasePOD et SuperPOD au fil de votre croissance

Caractéristiques principales

GPU8× Blackwell
Mémoire GPU1,440 GB total
Performances IA72 PFLOPS training, 144 PFLOPS inference
Réseau8× ConnectX-7, 2× BlueField-3 DPU

Ce que fait Workstation: Nous le dimensionnons selon vos modèles, le livrons et l’installons, puis configurons les pilotes, CUDA et NVIDIA AI Enterprise avant la remise.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
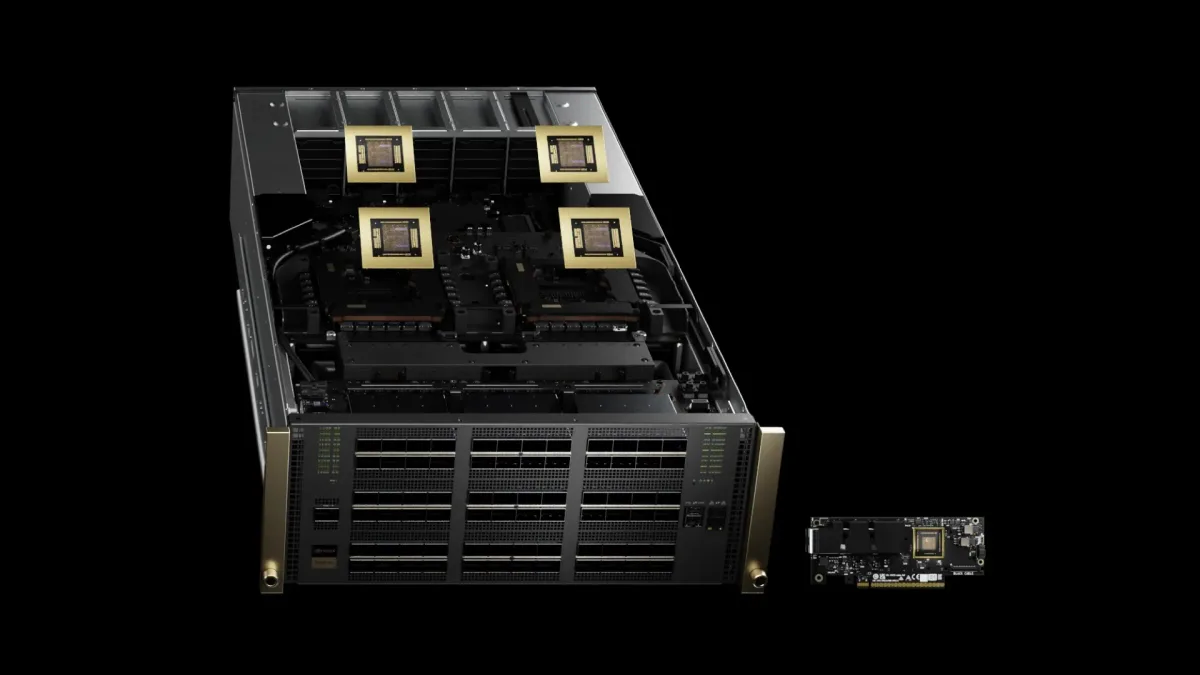
Systèmes et plateformes

NVIDIA HGX

Carte de base à huit GPU intégrée aux serveurs des partenaires

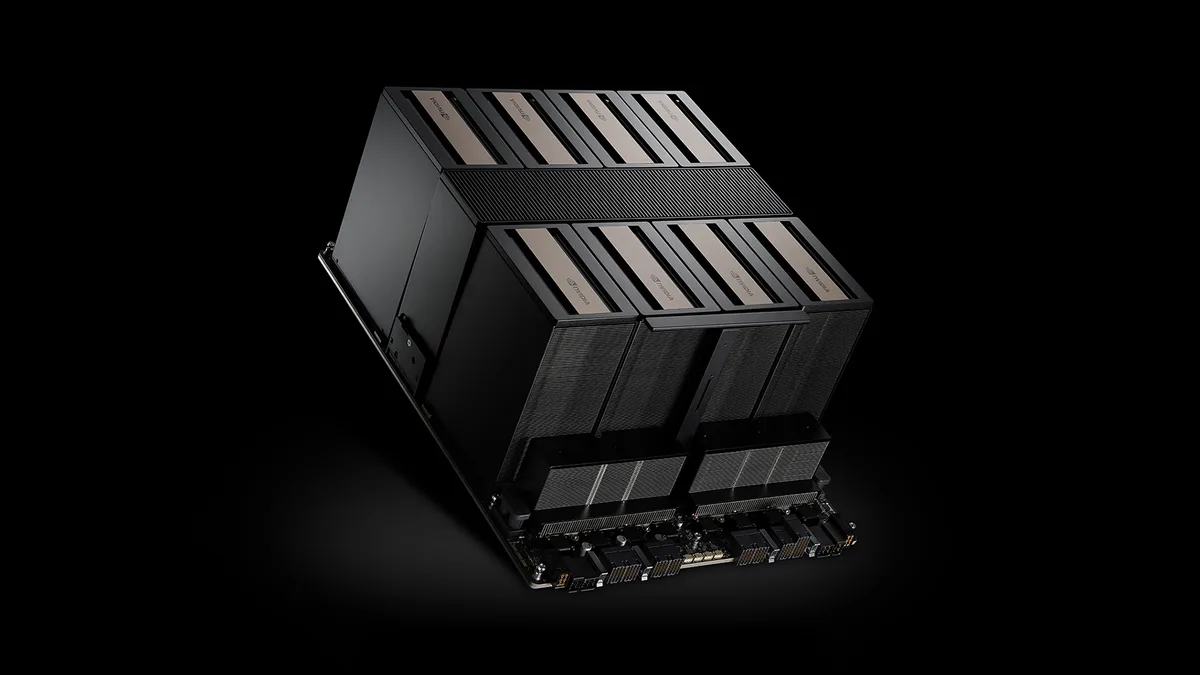
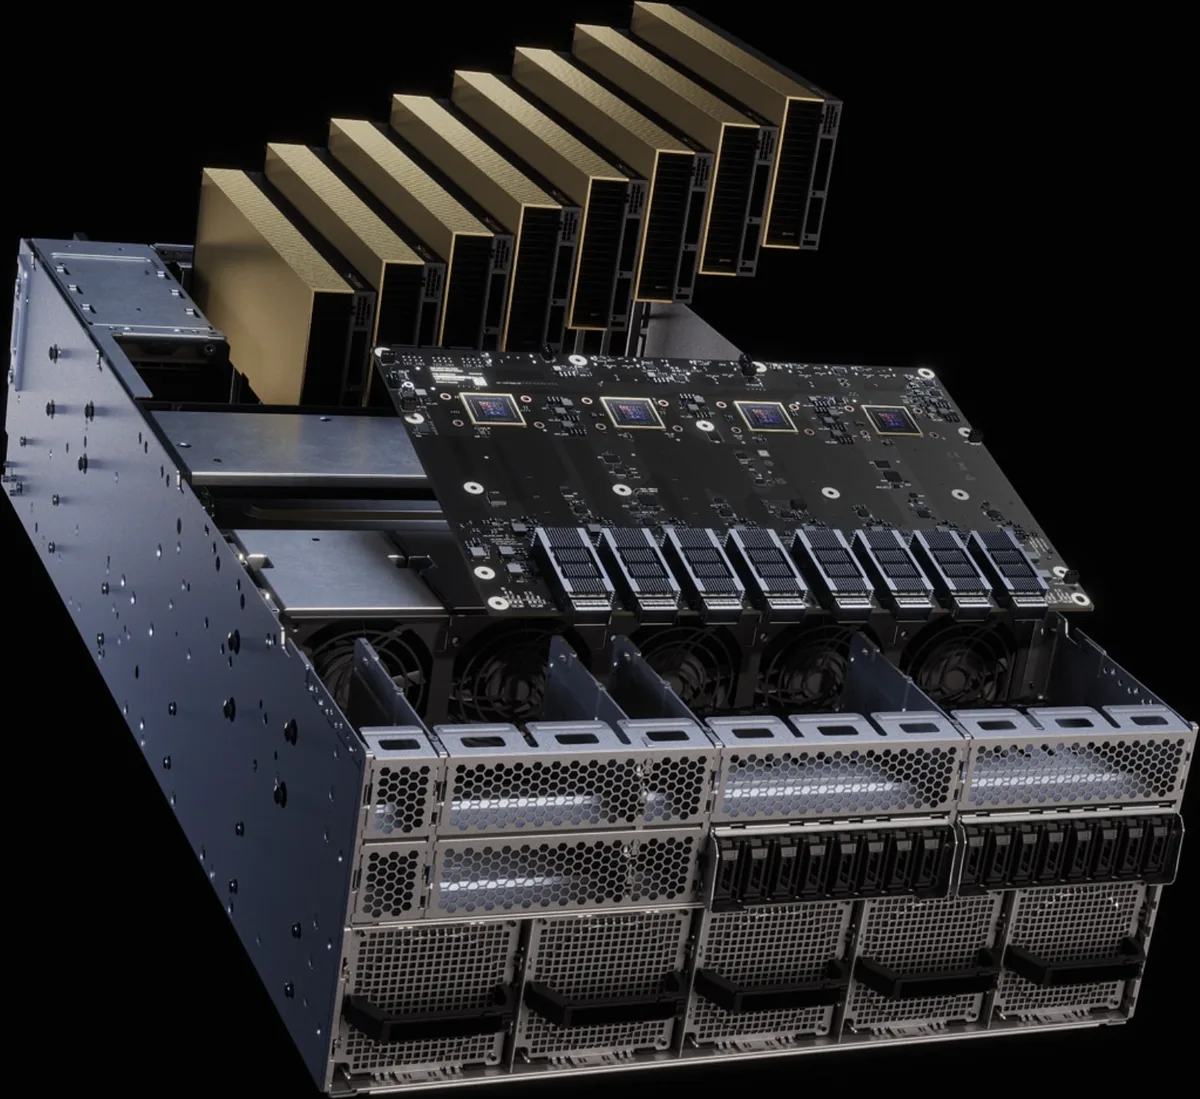
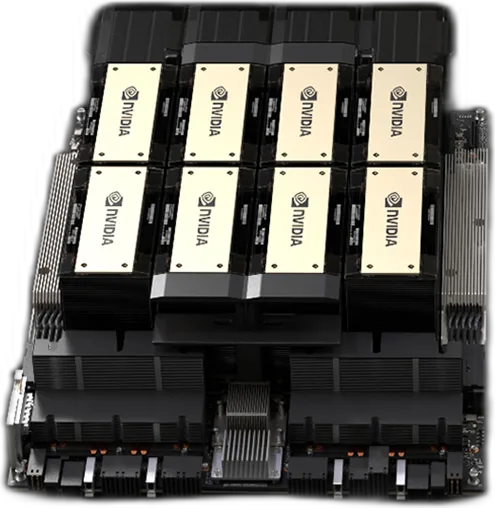
HGX est la carte de base GPU reliée par NVLink de NVIDIA que les constructeurs de serveurs intègrent à leurs propres systèmes : vous obtenez des GPU haut de gamme avec le châssis, le CPU et la marque de support de votre choix.

Pour qui: Organisations qui veulent des GPU phares auprès de leur fournisseur de serveurs préféré

Avantages

  • Choisissez la marque de serveur, le CPU et le stockage adaptés à votre parc
  • NVLink et NVSwitch relient les huit GPU à pleine vitesse
  • Couvre les générations Blackwell, Blackwell Ultra et Rubin

Caractéristiques principales

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
Bande passante NVLink14.4 TB/s total (HGX B300 and B200)

Ce que fait Workstation: Nous nous procurons le serveur HGX auprès de la marque de votre choix, le testons en charge prolongée à pleine puissance dans notre atelier et l’installons avec votre réseau.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

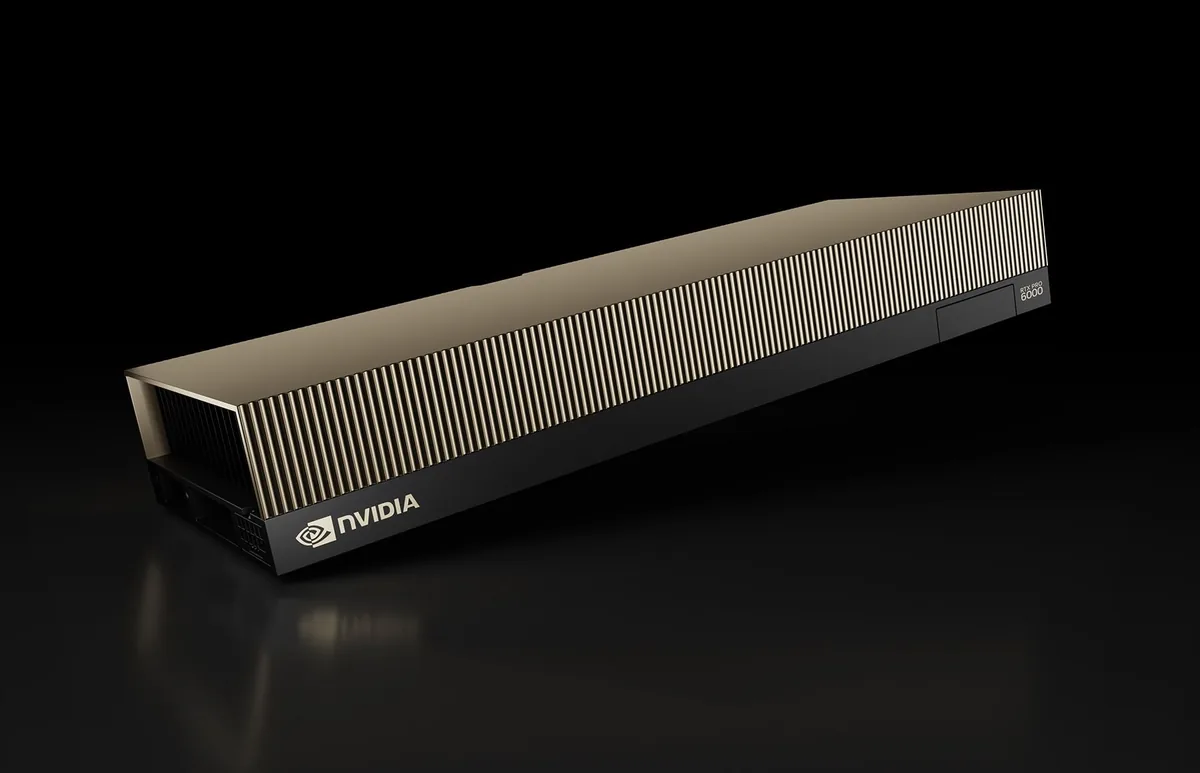
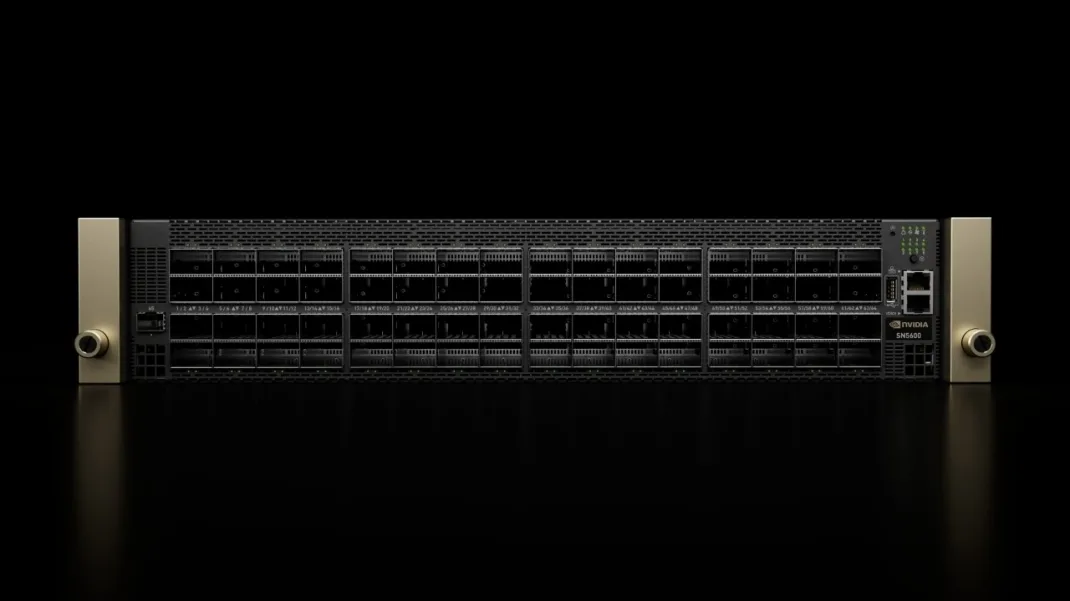
NVIDIA RTX PRO Server

Serveur Blackwell universel pour l’IA d’entreprise et le graphisme

Un serveur pour centre de données doté de jusqu’à huit GPU RTX PRO 6000 Blackwell Server Edition, qui exécute IA, simulation, rendu et stations de travail virtuelles sur une seule plateforme. C’est le serveur accéléré grand public de NVIDIA, et sa page EGX renvoie désormais ici.

Pour qui: Entreprises qui migrent leurs charges de travail existantes vers des GPU en parallèle de nouveaux services d’IA

Avantages

  • Un seul type de serveur pour l’inférence IA, le calcul visuel et la data science
  • Les options refroidies par air conviennent à la plupart des salles serveurs existantes
  • Validé avec NVIDIA AI Enterprise et Omniverse

Caractéristiques principales

GPUUp to 8× RTX PRO 6000 Blackwell Server Edition
Mémoire GPU800 GB (8-GPU configuration)
Bande passante mémoire13 TB/s (8-GPU configuration)
Graphisme RTX3 PFLOPS
ConfigurationsMGX 2U, 4U and 6U (6U liquid cooled)

Ce que fait Workstation: Nous spécifions le châssis et le nombre de GPU selon vos charges de travail, vérifions qu’il est NVIDIA-Certified, puis l’assemblons, le testons en charge prolongée et l’installons.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

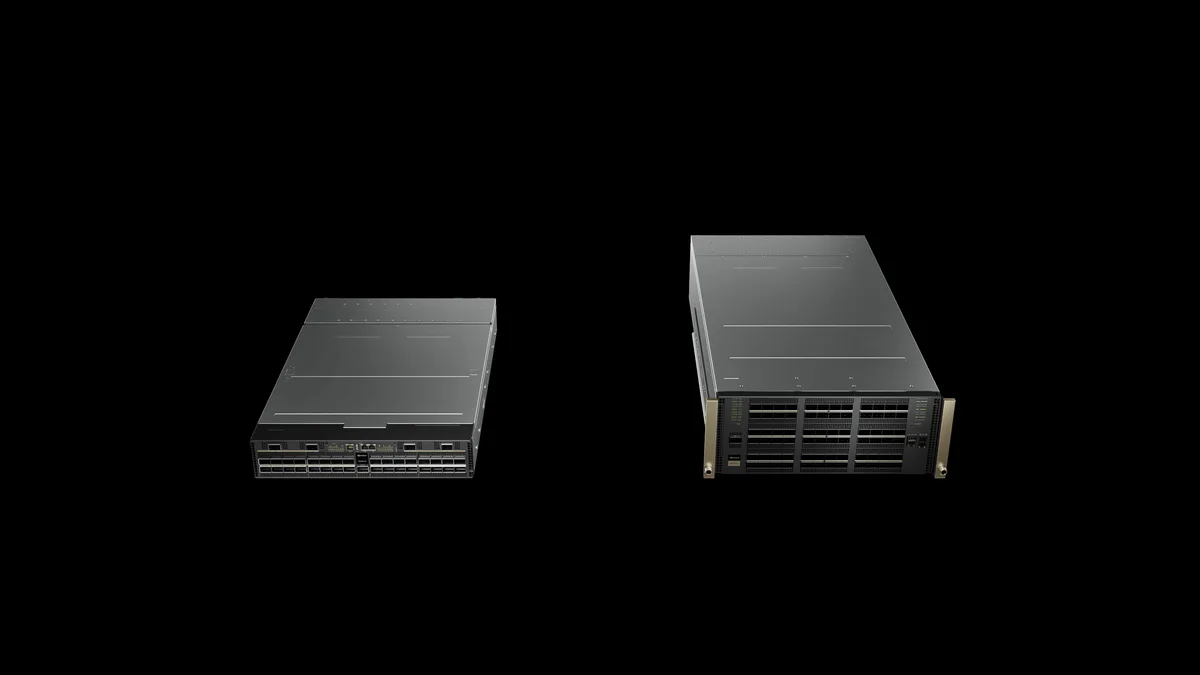
NVIDIA DGX SuperPOD

Plan clés en main pour des usines d’IA à grande échelle

Une architecture de référence complète qui combine systèmes DGX, réseau NVIDIA, stockage certifié et logiciels de gestion en unités évolutives et reproductibles.

Pour qui: Laboratoires de recherche, grandes entreprises et fournisseurs de services d’IA qui construisent des clusters de centaines ou de milliers de GPU

Avantages

  • Un design éprouvé élimine une grande partie du risque d’intégration
  • Évolue jusqu’à des dizaines de milliers de GPU en unités reproductibles
  • Inclut Mission Control et Base Command Manager pour l’exploitation

Caractéristiques principales

TypeReference architecture
Brique de baseScalable units of DGX systems
ÉchelleUp to tens of thousands of GPUs
StockageNVIDIA-certified partner storage
LogicielsNVIDIA AI Enterprise, Base Command Manager, Mission Control

Ce que fait Workstation: Nous pilotons la conception avec NVIDIA et les partenaires de stockage, gérons le plan de projet, installons les unités évolutives et restons votre interlocuteur support.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

NVIDIA DGX BasePOD

Design de référence pour votre premier cluster DGX

Un design éprouvé pour deux systèmes DGX ou plus, avec réseau, stockage et logiciel de cluster assortis : plus petit qu’un SuperPOD, mais construit de la même façon.

Pour qui: Équipes qui passent d’un seul système DGX à un petit cluster partagé

Avantages

  • Commencez avec deux systèmes et ajoutez-en sans tout repenser
  • Réseau et stockage adaptés aux GPU
  • Logiciel de cluster inclus pour l’ordonnancement et la supervision

Caractéristiques principales

TypeReference architecture
Échelle2 or more DGX systems
RéseauPer reference architecture
StockagePartner storage
LogicielsNVIDIA AI Enterprise, Base Command

Ce que fait Workstation: Nous dimensionnons le cluster, fournissons chaque élément, le montons en rack et le câblons, puis configurons l’ordonnancement pour que vos équipes puissent le partager dès le premier jour.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

CPU NVIDIA Grace et Vera

CPU Arm pour centres de données conçus pour les usines d’IA

Les CPU maison de NVIDIA se connectent à ses GPU via NVLink-C2C. Le Grace CPU Superchip est déjà disponible dans les serveurs des partenaires, et son successeur, Vera, cible l’IA agentique.

Pour qui: Centres HPC, opérateurs cloud et tous ceux qui exécutent des traitements gourmands en CPU aux côtés des GPU

Avantages

  • Bande passante mémoire élevée grâce à la LPDDR5X
  • Deux fois plus de performances à consommation égale que les principaux CPU traditionnels, selon les chiffres de NVIDIA
  • Une liaison cohérente et à haut débit avec les GPU NVIDIA

Caractéristiques principales

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Bande passante mémoire de GraceUp to 1 TB/s LPDDR5X
Vera CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

Ce que fait Workstation: Nous trouvons le serveur partenaire adapté à votre pile logicielle, testons vos applications sur Arm avec vous, puis assemblons et prenons en charge la solution.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

NVIDIA OVX

Serveurs L40S pour Omniverse et les jumeaux numériques

OVX est le design de serveur validé par NVIDIA pour Omniverse, associant des GPU L40S à un réseau ConnectX-7 ou BlueField-3 pour la simulation, le rendu et l’IA.

Pour qui: Industriels, architectes et équipes d’ingénierie qui créent des jumeaux numériques industriels

Avantages

  • Un seul serveur pour le graphisme, la simulation et l’inférence IA
  • Validé pour Omniverse et NVIDIA AI Enterprise
  • Évolue sur des centaines de serveurs via une fabric à haut débit

Caractéristiques principales

GPU4× or 8× NVIDIA L40S
CPU2× Intel Xeon Gold or 2× AMD EPYC
Mémoire hôte384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
Stockage1 TB NVMe boot, 2× 4 TB NVMe
RéseauConnectX-7 or BlueField-3

Ce que fait Workstation: Nous assemblons des serveurs au modèle OVX auprès de partenaires certifiés, configurons Omniverse et les pilotes, et les connectons à vos outils de conception.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

NVIDIA AGX (Jetson AGX Thor)

Ordinateurs IA pour robots et machines autonomes

AGX est la plateforme NVIDIA pour les machines autonomes. Son modèle phare actuel, Jetson AGX Thor, apporte un GPU Blackwell aux robots, véhicules et machines intelligentes.

Pour qui: Équipes robotique, automobile et industrie qui intègrent l’IA dans des machines

Avantages

  • Exécute des modèles de perception et d’IA générative directement sur la machine
  • Sa faible consommation convient aux conceptions mobiles et embarquées
  • Utilise le même logiciel CUDA que les plateformes NVIDIA pour centres de données

Caractéristiques principales

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
Performances IA2070 TFLOPS (FP4)
OptionsDeveloper kit, or T5000 and T4000 production modules

Ce que fait Workstation: Nous fournissons kits de développement et modules de production, vous aidons à choisir cartes porteuses et boîtiers, et vous accompagnons du prototype au déploiement.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

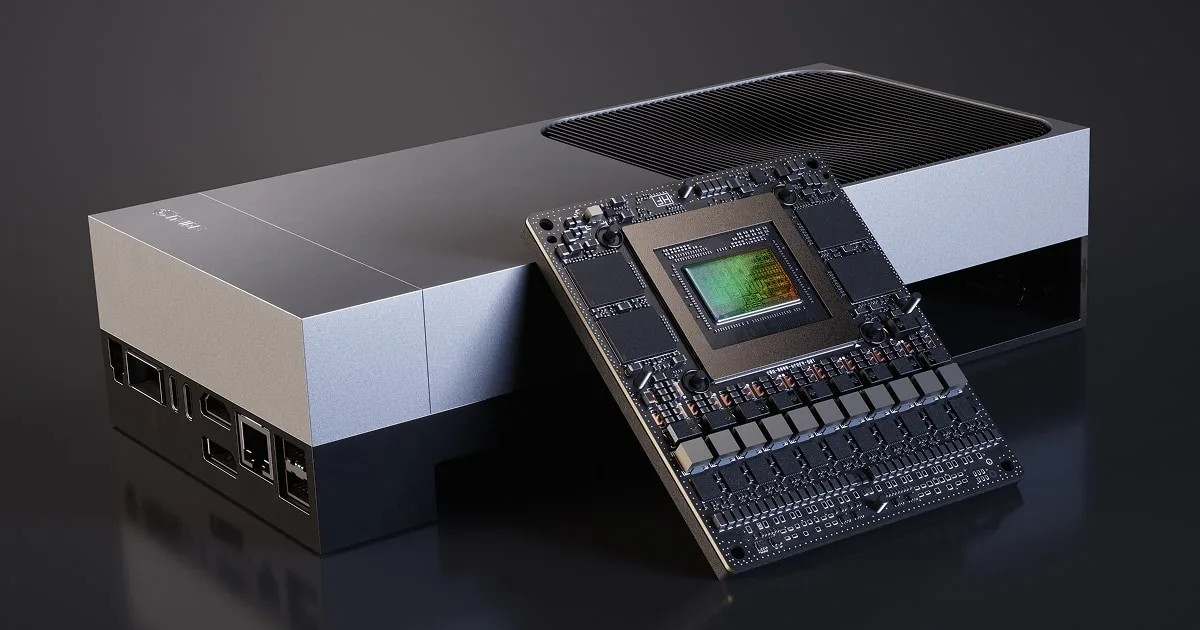
NVIDIA IGX Thor

IA industrielle en périphérie avec sécurité fonctionnelle

IGX est la plateforme d’entreprise NVIDIA pour l’IA physique en périphérie industrielle et médicale, avec un îlot de sécurité dédié et un support logiciel à long terme.

Pour qui: Fabricants de dispositifs médicaux, usines et opérateurs d’infrastructures qui ont besoin d’une certification de sécurité et d’un support de longue durée

Avantages

  • Conception de sécurité fonctionnelle visant ISO 26262 et IEC 61508
  • Dix ans de support logiciel d’entreprise NVIDIA
  • GPU RTX PRO Blackwell en option pour les modèles plus lourds

Caractéristiques principales

Performances IAUp to 5,581 TFLOPS FP4 (sparse) with discrete GPU
GPU intégré2,560-core Blackwell
Processeur14-core Arm Neoverse-V3AE, 2.6 GHz
Mémoire128 GB LPDDR5X, 273 GB/s
Consommation40–130 W, up to 300 W for the discrete GPU

Ce que fait Workstation: Nous fournissons kits de développement et systèmes de production, vous aidons à préparer les preuves de certification et accompagnons le déploiement sur votre site.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
Systèmes et plateformes

NVIDIA Groq 3 LPX

Rack d’inférence à faible latence pour Vera Rubin

LPX est un rack de 256 accélérateurs d’inférence LPU qui fonctionne aux côtés du Vera Rubin NVL72 pour générer des tokens rapidement et de façon prévisible pour l’IA interactive et agentique.

Pour qui: Fournisseurs de services d’IA dont les utilisateurs ont besoin de temps de réponse rapides et constants

Avantages

  • Génération de tokens déterministe et à faible latence
  • Un débit par mégawatt nettement supérieur pour les modèles à des milliers de milliards de paramètres, selon les projections de NVIDIA
  • Une liaison directe à faible latence avec les racks NVL72

Caractéristiques principales

Accélérateurs256 LPUs per rack
Mémoire sur puce128 GB SRAM per rack (500 MB per LPU)
Bande passante SRAM40 PB/s per rack
Bande passante scale-up640 TB/s per rack
FormatNVIDIA MGX ETL rack

Ce que fait Workstation: Nous évaluons son intégration dans vos projets Vera Rubin, confirmons la disponibilité auprès de NVIDIA et planifions l’installation aux côtés de vos autres racks.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
GPU pour centres de données

NVIDIA H200 (SXM)

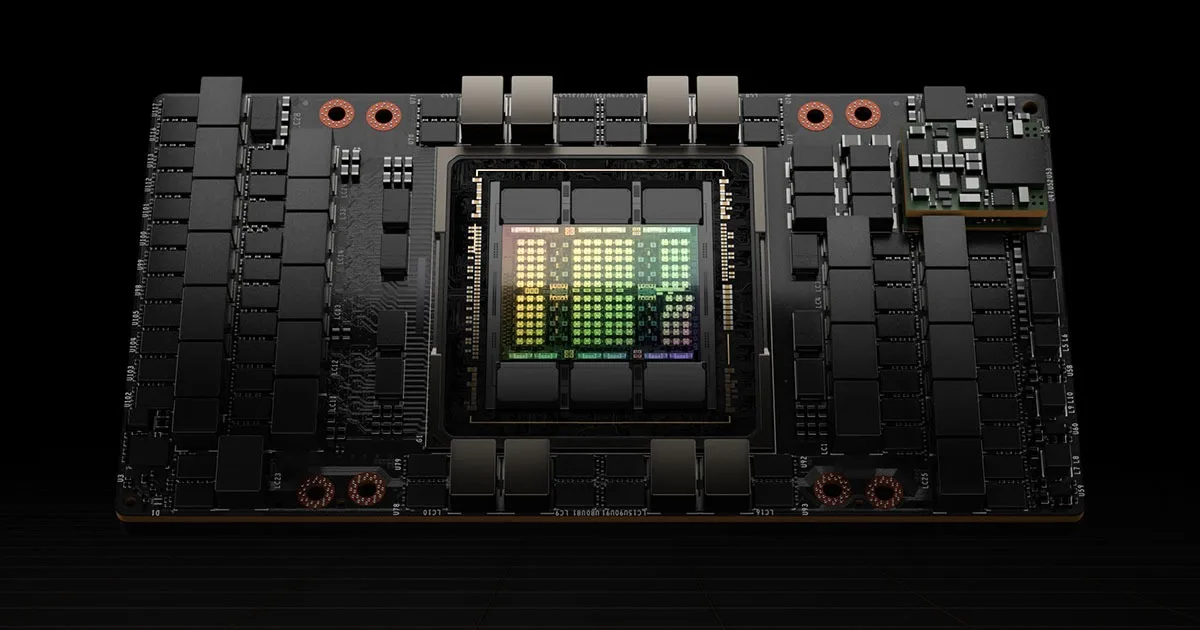
GPU Hopper avec 141 GB de HBM3e

Le H200 conserve l’architecture Hopper mais ajoute bien plus de mémoire, et plus rapide, ce qui profite à l’inférence des grands modèles et au HPC limité par la mémoire. La version SXM s’intègre aux serveurs HGX.

Pour qui: Équipes qui exécutent de grands modèles de langage et des codes HPC sur des serveurs HGX

Avantages

  • 141 GB par GPU accueillent des modèles plus grands sans les découper
  • Une bande passante mémoire accrue accélère les traitements limités par la mémoire
  • Exécute le même logiciel CUDA que le H100

Caractéristiques principales

ArchitectureNVIDIA Hopper
Mémoire GPU141 GB HBM3e
FormatSXM (HGX)
RefroidissementPassive (server airflow)

Ce que fait Workstation: Nous fournissons le H200 dans un serveur HGX certifié, le testons en charge prolongée et l’installons avec vos pilotes et votre pile logicielle.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗
GPU pour centres de données

NVIDIA H200 NVL

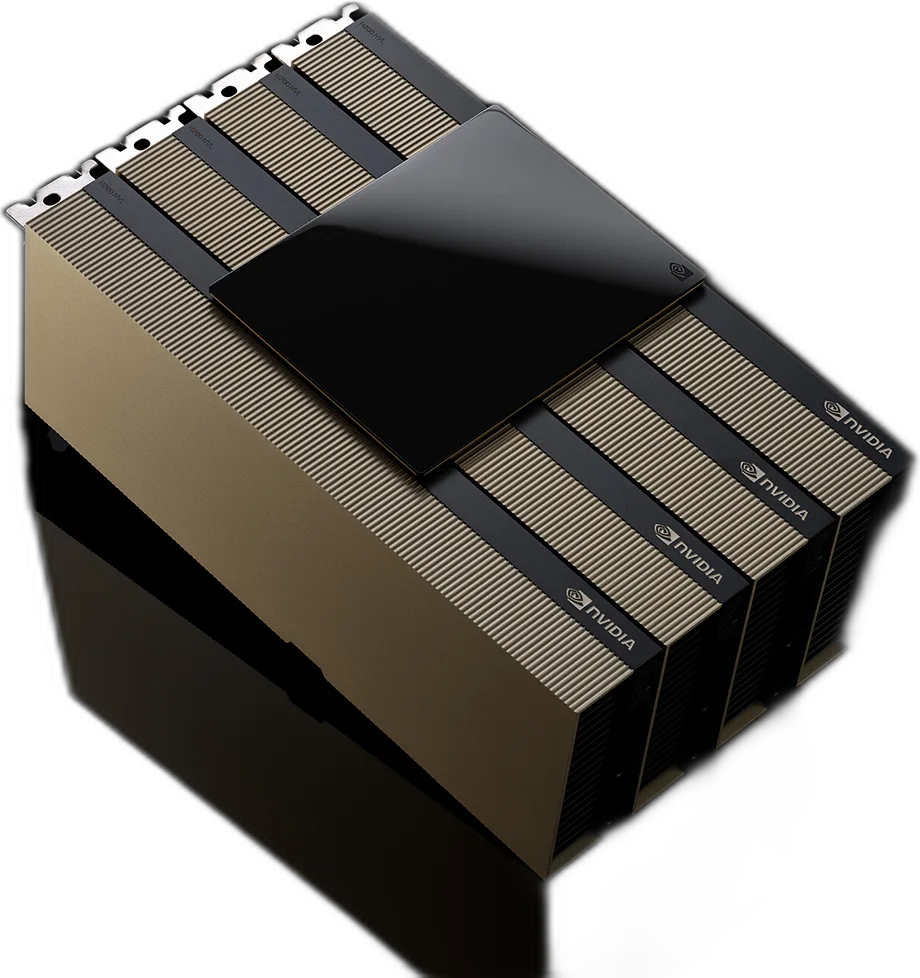
GPU Hopper de 141 GB pour serveurs PCIe refroidis par air

La version PCIe du H200 pour les racks d’entreprise standard. Des ponts NVLink permettent d’associer des cartes pour les modèles qui demandent plus de mémoire.

Pour qui: Entreprises qui ajoutent l’inférence de grands modèles à leurs salles serveurs existantes refroidies par air

Avantages

  • Une grande mémoire GPU sans passer au refroidissement liquide
  • Les ponts NVLink associent les GPU pour les modèles plus grands
  • Compatible avec les serveurs NVIDIA-Certified courants

Caractéristiques principales

ArchitectureNVIDIA Hopper
Mémoire GPU141 GB HBM3e
FormatPCIe, dual slot
RefroidissementPassive (server airflow)

Ce que fait Workstation: Nous vérifions l’alimentation, la circulation d’air et la disposition des emplacements de votre châssis, puis montons, testons et livrons les cartes ou un serveur complet.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

GPU pour centres de données

NVIDIA H100 PCIe 80 GB

GPU Hopper pour l’entraînement et l’inférence dans les serveurs PCIe

Le H100 PCIe apporte le Transformer Engine et le calcul confidentiel de Hopper aux serveurs standard.

Pour qui: Équipes disposant de serveurs GPU PCIe qui ont besoin des performances éprouvées de Hopper

Avantages

  • Le Transformer Engine accélère l’entraînement et l’inférence des modèles de langage
  • Multi-Instance GPU divise une carte en instances isolées
  • Prise en charge matérielle du calcul confidentiel

Caractéristiques principales

ArchitectureNVIDIA Hopper
Mémoire GPU80 GB HBM2e
FormatDual-slot, full height, full length
RefroidissementPassive (server airflow)
InterfacePCIe

Ce que fait Workstation: Nous installons le H100 dans des serveurs pour lesquels il est certifié, le testons en charge prolongée et configurons CUDA, les pilotes et les éventuelles licences vGPU ou AI Enterprise.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

GPU pour centres de données

NVIDIA RTX PRO 6000 Blackwell Server Edition

GPU Blackwell de 96 GB pour serveurs rack

Une carte Blackwell à refroidissement passif dotée de 96 GB de mémoire pour l’inférence IA, le rendu, la simulation et les stations de travail virtuelles en centre de données.

Pour qui: Entreprises qui regroupent leurs charges IA et graphiques sur un seul type de GPU

Avantages

  • 96 GB par GPU pour les grands modèles et les scènes volumineuses
  • Prend en charge l’IA comme le graphisme professionnel
  • Consommation configurable selon le serveur

Caractéristiques principales

ArchitectureNVIDIA Blackwell
Mémoire GPU96 GB GDDR7 with ECC
Puissance maximaleUp to 600 W (configurable)
InterfacePCIe 5.0 x16
FormatDual-slot, passive (server airflow)

Ce que fait Workstation: Nous fournissons les cartes seules ou dans un RTX PRO Server, et les testons à pleine charge avant livraison.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

GPU pour centres de données

NVIDIA RTX PRO 4500 Blackwell Server Edition

GPU Blackwell mono-slot pour serveurs denses

Un GPU Blackwell compact de 32 GB à refroidissement passif qui permet d’installer de nombreuses cartes dans un serveur pour l’inférence, la vidéo et les postes de travail virtuels.

Pour qui: Équipes qui étendent l’inférence ou les postes virtuels à de nombreux utilisateurs pour un coût par GPU réduit

Avantages

  • Le format mono-slot permet davantage de GPU par serveur
  • 32 GB de GDDR7 pour les modèles de taille moyenne
  • Sa consommation réduite convient aux racks existants

Caractéristiques principales

ArchitectureNVIDIA Blackwell
Mémoire GPU32 GB GDDR7
FormatSingle slot, 4.4" H × 10.5" L
RefroidissementPassive (server airflow)

Ce que fait Workstation: Nous déterminons combien de cartes vos serveurs peuvent alimenter et refroidir, puis assemblons et testons la configuration.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

GPU pour centres de données

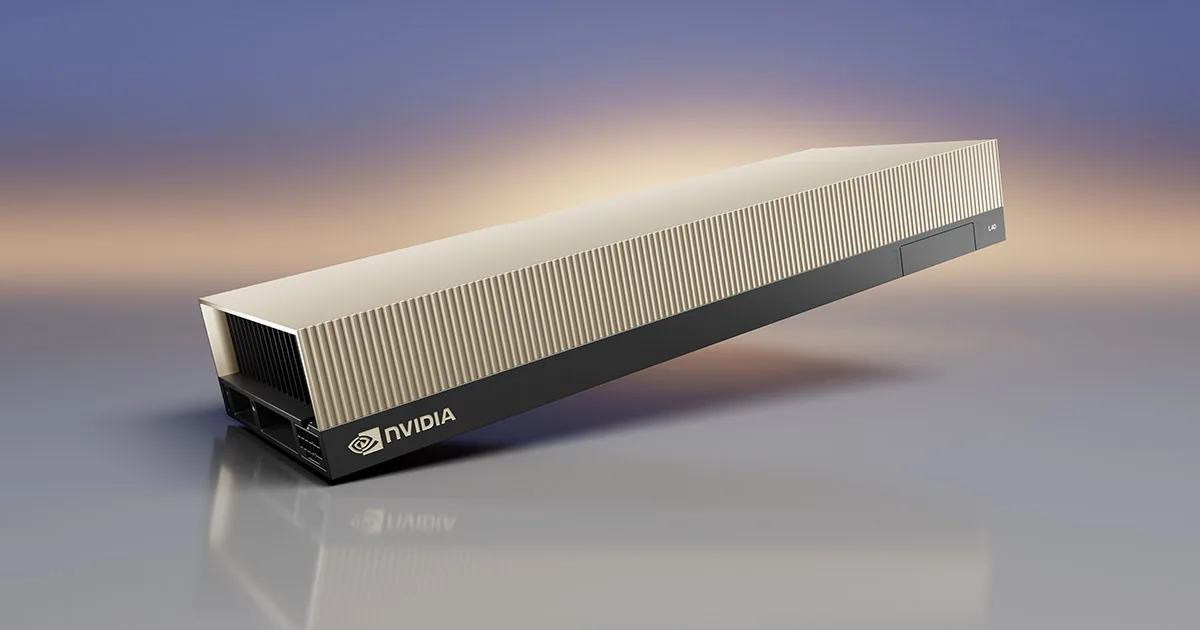
NVIDIA L40S

Polyvalent de 48 GB pour l’IA et le graphisme

Un GPU Ada Lovelace pour centre de données équilibré pour l’inférence, le fine-tuning et le graphisme 3D, et le GPU du design OVX de NVIDIA.

Pour qui: Équipes qui ont besoin d’un seul GPU pour l’IA et les charges visuelles

Avantages

  • De solides performances en inférence et en fine-tuning pour son prix
  • Ray tracing matériel pour le rendu et Omniverse
  • Une carte PCIe standard pour les serveurs courants

Caractéristiques principales

ArchitectureNVIDIA Ada Lovelace
Mémoire GPU48 GB GDDR6 with ECC
FormatDual-slot, 4.4" H × 10.5" L
RefroidissementPassive (server airflow)
InterfacePCIe

Ce que fait Workstation: Nous associons le L40S à des serveurs certifiés, testons la configuration en charge prolongée et l’installons avec pilotes et licences configurés.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

GPU pour centres de données

NVIDIA L40

GPU de 48 GB pour le rendu et les stations de travail virtuelles

Le L40 se concentre sur le graphisme : rendu, Omniverse et stations de travail virtuelles en centre de données.

Pour qui: Équipes design et médias qui déplacent leurs stations de travail vers le centre de données

Avantages

  • 48 GB pour les scènes et ressources volumineuses
  • Compatible avec le logiciel de GPU virtuel NVIDIA
  • Refroidissement passif pour serveurs standard

Caractéristiques principales

ArchitectureNVIDIA Ada Lovelace
Mémoire GPU48 GB GDDR6 with ECC
FormatDual-slot, 4.4" H × 10.5" L
RefroidissementPassive (server airflow)
InterfacePCIe

Ce que fait Workstation: Nous configurons profils et licences vGPU pour offrir à vos utilisateurs des stations de travail distantes aussi réactives qu’en local.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

GPU pour centres de données

NVIDIA L4

GPU low-profile pour une inférence et une vidéo efficaces

Une petite carte Ada Lovelace basse consommation pour l’IA vidéo, l’inférence et les postes de travail virtuels, de la périphérie au centre de données.

Pour qui: Organisations qui ajoutent l’IA à de nombreux serveurs ou à des sites en périphérie aux budgets énergétiques serrés

Avantages

  • Faible consommation et format low-profile : elle s’intègre à presque tous les serveurs
  • Particulièrement adaptée à l’analyse vidéo et à l’inférence
  • Évolue de façon économique sur de nombreux nœuds

Caractéristiques principales

ArchitectureNVIDIA Ada Lovelace
Mémoire GPU24 GB GDDR6
FormatSingle-slot, low profile
RefroidissementPassive (server airflow)
InterfacePCIe

Ce que fait Workstation: Nous vérifions la compatibilité avec vos serveurs existants, fournissons les cartes et configurons pilotes et logiciels d’inférence.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Réseau

Plateforme Ethernet NVIDIA Spectrum-X

Un Ethernet optimisé pour les usines d’IA

Spectrum-X associe des commutateurs Ethernet Spectrum à des SuperNIC Spectrum-X pour offrir aux clusters d’IA un Ethernet prévisible et à haut débit.

Pour qui: Organisations qui veulent une fabric IA que leur équipe réseau sait déjà exploiter

Avantages

  • Une bande passante effective plus élevée que l’Ethernet standard pour le trafic entre GPU
  • Utilise des outils et des compétences Ethernet familiers
  • Fait partie des designs d’usine d’IA validés par NVIDIA

Caractéristiques principales

TypeEthernet networking platform
ComposantsNVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
Cas d’usageAI clusters and AI factories

Ce que fait Workstation: Nous concevons la fabric, fournissons commutateurs, SuperNIC et câbles, l’installons, la testons et la documentons pour votre équipe.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Réseau

Plateforme NVIDIA Quantum-X800 InfiniBand

InfiniBand nouvelle génération pour l’entraînement à grande échelle

Les commutateurs Quantum-X800 et les SuperNIC ConnectX-8 forment la fabric InfiniBand la plus performante de NVIDIA pour l’entraînement IA et le HPC.

Pour qui: Centres HPC et équipes IA qui entraînent à grande échelle

Avantages

  • Latence très faible pour les tâches fortement couplées
  • Conçu pour les plus grands clusters d’entraînement et HPC
  • Géré et supervisé avec UFM

Caractéristiques principales

TypeInfiniBand networking platform
ComposantsNVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
Cas d’usageLarge-scale AI training and HPC

Ce que fait Workstation: Nous concevons la topologie, fournissons et câblons chaque lien, et mettons la fabric en service avec la supervision UFM en place.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Réseau

Commutateurs Ethernet NVIDIA Spectrum

Commutateurs Ethernet pour centres de données jusqu’à 800 Gb/s

Les commutateurs Spectrum acheminent le trafic IA, stockage et cloud, seuls ou dans le cadre de Spectrum-X.

Pour qui: Équipes centre de données et réseau qui renouvellent leur commutation leaf et spine

Avantages

  • Vitesses de port jusqu’à 800 Gb/s
  • Fonctionne dans les fabrics IA comme dans les réseaux de centre de données classiques
  • S’associe à NetQ pour l’exploitation réseau et la télémétrie

Caractéristiques principales

TypeEthernet switch family
Vitesse de portUp to 800 Gb/s
UsageAI and cloud data-centre fabrics

Ce que fait Workstation: Nous dimensionnons ports et optiques, configurons les commutateurs et les intégrons à votre réseau existant.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Réseau

Commutateurs NVIDIA Quantum InfiniBand

Commutation à faible latence pour le HPC et l’IA

Les commutateurs Quantum InfiniBand constituent les fabrics à faible latence sur lesquelles reposent les clusters HPC et IA.

Pour qui: Équipes de calcul scientifique et d’IA aux charges de travail fortement couplées

Avantages

  • Latence très faible entre les nœuds
  • Éprouvé dans les clusters HPC et IA
  • Gestion centralisée avec UFM

Caractéristiques principales

TypeInfiniBand switch family
UsageHPC and AI data centres

Ce que fait Workstation: Nous planifions la topologie, fournissons câbles et optiques, puis installons et vérifions la fabric.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Réseau

NIC et SuperNIC NVIDIA ConnectX

Adaptateurs réseau pour Ethernet et InfiniBand

Les adaptateurs ConnectX relient les serveurs à la fabric. Les SuperNIC comme la ConnectX-8 sont optimisées pour le trafic entre GPU dans les clusters d’IA.

Pour qui: Quiconque connecte des serveurs GPU ou du stockage à un réseau à haut débit

Avantages

  • Une seule gamme pour Ethernet et InfiniBand
  • Les SuperNIC offrent à chaque GPU son propre accès à haut débit
  • Les délestages matériels réduisent la charge du CPU

Caractéristiques principales

TypeNetwork adapter and SuperNIC family
FabricsEthernet and InfiniBand
Vitesse maximale800 Gb/s per GPU (ConnectX-8 SuperNIC)

Ce que fait Workstation: Nous associons adaptateurs, câbles et transceivers à vos commutateurs et serveurs, et installons firmware et pilotes.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Réseau

DPU NVIDIA BlueField

Unités de traitement des données pour le réseau, le stockage et la sécurité

Les DPU BlueField déchargent le CPU du serveur des tâches de réseau, de stockage et de sécurité, et les isolent sur du matériel dédié.

Pour qui: Opérateurs cloud, usines d’IA et organisations soucieuses de sécurité

Avantages

  • Libère des cœurs CPU pour les applications
  • Isole les services d’infrastructure des charges de travail des locataires
  • Programmable avec NVIDIA DOCA

Caractéristiques principales

TypeData processing unit (DPU) family
GénérationsBlueField-3, BlueField-4
LogicielsNVIDIA DOCA

Ce que fait Workstation: Nous fournissons et installons les cartes BlueField, et vous aidons à déployer les services DOCA dont vous avez besoin.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Logiciels

NVIDIA AI Enterprise

Logiciels pris en charge pour l’IA en production

La suite NVIDIA de frameworks d’IA, de microservices NIM et d’outils, avec support d’entreprise et branches de versions à long terme.

Pour qui: Toute organisation qui exploite l’IA en production sur des GPU NVIDIA

Avantages

  • Support d’entreprise et branches de versions stables
  • Les microservices NIM accélèrent le déploiement des modèles
  • Fonctionne sur des systèmes NVIDIA-Certified sur site ou dans le cloud

Caractéristiques principales

LicencesPer GPU subscription
InclutAI frameworks, NIM microservices, pretrained models
AssistanceNVIDIA Enterprise Business Standard Support
Essai90-day evaluation

Ce que fait Workstation: Nous chiffrons et activons les licences, installons les logiciels avec votre matériel et vous prévenons avant le renouvellement.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Logiciels

NVIDIA Mission Control

Logiciel d’exploitation pour les usines d’IA

Mission Control automatise l’exploitation quotidienne des grands clusters GPU, de l’orchestration des charges de travail aux contrôles de santé et à la reprise.

Pour qui: Exploitants de DGX SuperPOD et d’autres grands clusters d’IA

Avantages

  • Automatise les opérations courantes du cluster
  • Améliore la résilience en détectant les pannes et en assurant la reprise
  • Une vue unique des charges de travail et de l’infrastructure

Caractéristiques principales

TypeAI-factory operations and cluster management software
FonctionsWorkload orchestration, infrastructure resiliency, cluster automation
Base de licenceConfirmed on quote

Ce que fait Workstation: Nous déployons Mission Control avec votre cluster et formons vos opérateurs à son utilisation.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Logiciels

NVIDIA Run:ai

Orchestration et ordonnancement des GPU

Run:ai mutualise les GPU entre les équipes et les alloue à la demande, pour que ce matériel coûteux reste occupé plutôt qu’inactif.

Pour qui: Organisations qui partagent des GPU entre de nombreux data scientists ou projets

Avantages

  • Meilleure utilisation des GPU grâce à la mutualisation dynamique
  • Quotas, priorités et contrôle d’accès pour un partage équitable
  • Fonctionne dans les environnements sur site, hybrides et cloud

Caractéristiques principales

TypeGPU orchestration and scheduling platform
Fonctionne surKubernetes
DéploiementOn premises, hybrid or cloud
Base de licenceConfirmed on quote

Ce que fait Workstation: Nous installons Run:ai sur votre cluster Kubernetes, définissons les quotas avec vos équipes et en assurons le support.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Logiciels

NVIDIA Base Command Manager

Provisionnement et supervision de clusters

Base Command Manager provisionne, supervise et gère les clusters GPU, à partir de quelques nœuds.

Pour qui: Équipes informatiques qui exploitent des clusters GPU de toute taille

Avantages

  • Automatise le provisionnement sur Arm et x86
  • Tableaux de bord de santé et supervision en temps réel
  • Interface web, ligne de commande et API

Caractéristiques principales

TypeCluster management software
Licence gratuiteUp to 8 accelerators per system
Version actuelleBase Command Manager 11
InterfacesBaseView web UI, CLI, API

Ce que fait Workstation: Nous installons et configurons Base Command Manager dans le cadre des clusters que nous construisons.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Logiciels

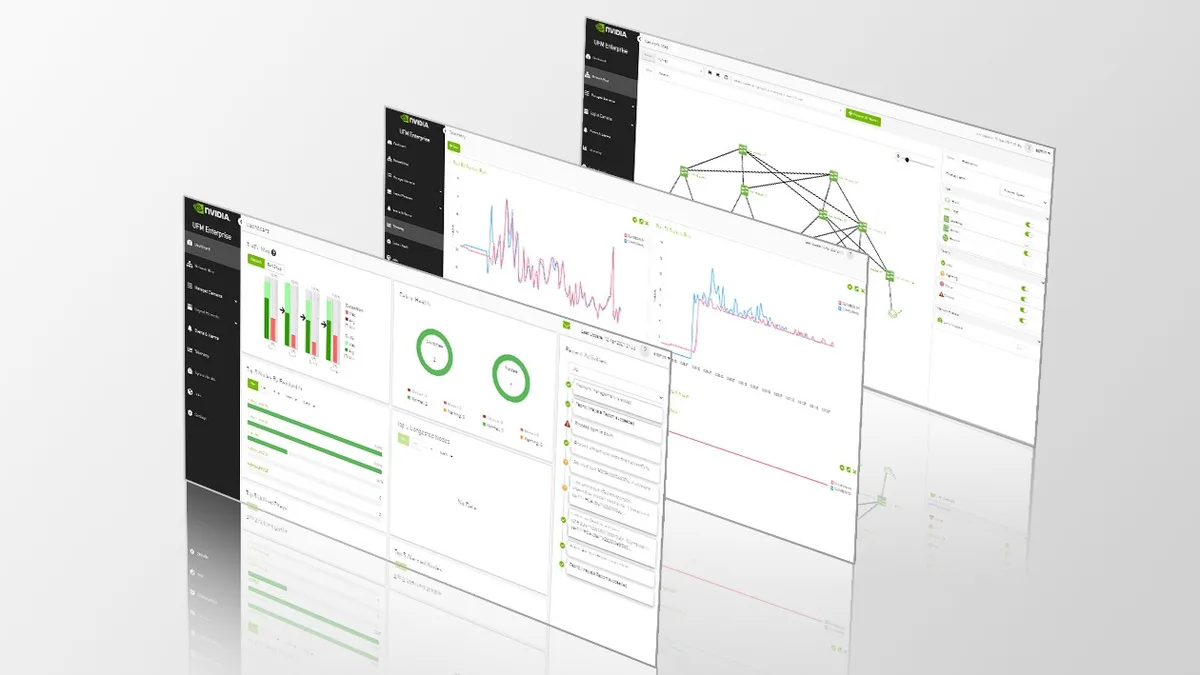
NVIDIA UFM

Unified Fabric Manager pour InfiniBand

UFM supervise et gère les fabrics InfiniBand, et aide à les dépanner.

Pour qui: Équipes qui exploitent des clusters InfiniBand

Avantages

  • Télémétrie de la fabric en temps réel
  • Localisation des pannes plus rapide
  • Gestion centralisée des commutateurs et des liens

Caractéristiques principales

TypeInfiniBand fabric management and telemetry software
Compatible avecNVIDIA Quantum InfiniBand switches

Ce que fait Workstation: Nous déployons UFM avec votre fabric et configurons des alertes conformes à vos procédures d’exploitation.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Logiciels

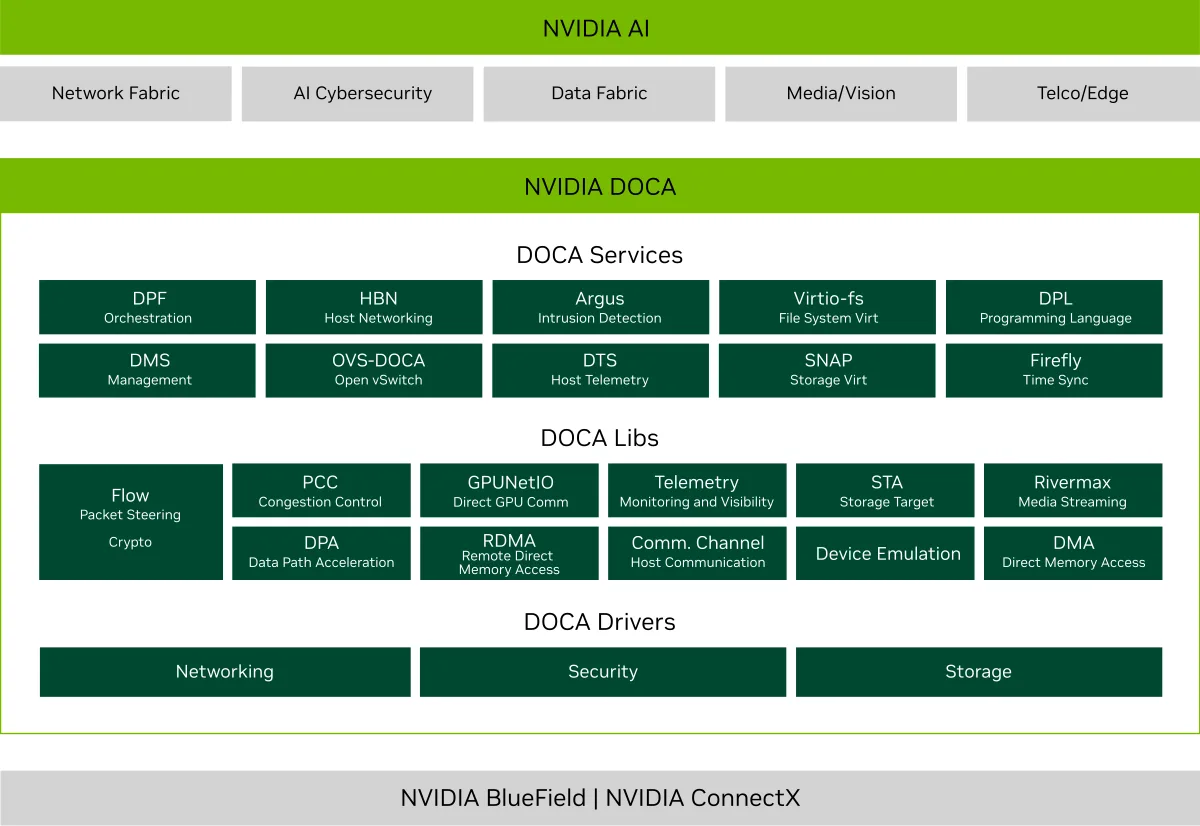
NVIDIA DOCA

Framework logiciel pour BlueField et les SuperNIC

DOCA est le SDK et l’environnement d’exécution permettant de créer des services qui tournent sur les DPU BlueField et les SuperNIC.

Pour qui: Développeurs et équipes plateforme qui s’appuient sur BlueField

Avantages

  • Un seul framework pour toutes les générations de DPU et de SuperNIC
  • Accélère le développement de services délestés
  • Un environnement d’exécution pour déployer ces services en production

Caractéristiques principales

TypeSDK and runtime framework
Fonctionne surNVIDIA BlueField DPUs and SuperNICs

Ce que fait Workstation: Nous vous aidons à mettre en place des environnements DOCA et à déployer des services sur les cartes BlueField que nous fournissons.

Prix sur devisDemander un devis ↗
Voir sur NVIDIA.com ↗

Les caractéristiques sont résumées à partir des informations publiées par NVIDIA et peuvent évoluer d’une révision à l’autre. Les valeurs marquées sparse supposent la parcimonie. Nous confirmons la configuration exacte, le prix et le délai de livraison dans chaque devis.

Ce que fait Workstation sur chaque commande

Les mêmes cinq étapes, que vous achetiez un GPU ou une rangée de racks

Dimensionnement

Nous partons de vos modèles, données, utilisateurs et site, puis dimensionnons calcul, mémoire, réseau, alimentation et refroidissement.

Approvisionnement

Nous nous approvisionnons auprès de NVIDIA et de ses partenaires serveurs, confirmons les délais et vous tenons informé jusqu’à la livraison.

Assemblage et tests en charge prolongée

Les systèmes sont assemblés, préparés et soumis à des tests de stress à pleine charge dans notre atelier britannique avant expédition.

Installation

Nos ingénieurs livrent, montent en rack, câblent et mettent en service sur site, puis vous remettent l’ensemble avec sa documentation.

Assistance

La même équipe gère les problèmes logiciels, les mises à niveau, les renouvellements de licences et les demandes de garantie.

Toutes les catégories NVIDIA

Adhésion Trade

Les membres Trade bénéficient d’une assistance technique gratuite sur chaque commande et d’un temps d’ingénieur illimité — aide à la configuration, aux pilotes, aux logiciels et au dépannage, aussi longtemps que vous possédez le matériel.

Découvrir l’adhésion Trade

Questions fréquentes

Pourquoi tous les prix sont-ils sur devis ?

Les prix et les allocations du calcul accéléré évoluent rapidement, et la plupart des commandes dépendent de la configuration exacte, du site et des logiciels. Un devis nous permet de confirmer le prix, la disponibilité et le délai actuels pour ce dont vous avez réellement besoin.

Pouvez-vous fournir un seul GPU plutôt qu’un système complet ?

Oui. Nous fournissons des GPU pour centres de données à l’unité, mais vérifions toujours que votre serveur est certifié pour les alimenter et les refroidir, et pouvons les installer et les tester pour vous.

Installez-vous des systèmes à l’échelle du rack et refroidis par liquide ?

Oui. Pour des systèmes comme le GB300 NVL72, nous travaillons avec votre équipe infrastructures sur l’alimentation, le refroidissement et la charge au sol bien avant la livraison, puis installons et mettons en service sur site.

Par quelle plateforme NVIDIA commencer ?

Cela dépend de vos modèles, de vos utilisateurs et de votre site. De nombreuses équipes commencent avec un RTX PRO Server ou des L40S pour combiner IA et graphisme, puis passent à HGX ou DGX pour l’entraînement à grande échelle. Parlez à un ingénieur et nous vous recommanderons un point de départ.

Planifiez votre projet de calcul accéléré NVIDIA

Dites-nous ce que vous devez exécuter et où cela doit être hébergé. Un ingénieur reviendra vers vous avec une configuration recommandée et un devis.

Parler à un ingénieur