Muse Glimmer คือโมเดลภาษาเชิงสาเหตุ 3 หมื่นล้านพารามิเตอร์ของ Meta พร้อมตัวเข้ารหัสการรับรู้โดยเฉพาะ กลั่นจาก Muse Spark และเผยแพร่สำหรับปริมาณงานเอเจนต์อัตโนมัติบนฮาร์ดแวร์ผู้บริโภคและเวิร์กสเตชัน จัดจำหน่ายผ่านทาง Ollama ภายใต้ Apache 2.0โดยกำหนดเป้าหมายการใช้เครื่องมือที่เชื่อถือได้ งานในขอบเขตที่ยาวนาน การทำความเข้าใจหลายรูปแบบ และการกู้คืนความล้มเหลว โดยไม่ต้องอาศัยการอนุมานบนคลาวด์ ข้อมูลสรุปด้านเทคนิค Workstation นี้เขียนใหม่และขยายการ์ดโมเดลสาธารณะสำหรับวิศวกรที่จัดส่งตัวแทนในพื้นที่
- ระดับ: 30B สาเหตุ LM + ตัวเข้ารหัสการรับรู้; กลั่นจาก Muse Spark; วิสัยทัศน์+เครื่องมือ+ความคิด
- ให้บริการ:
ollama run muse-glimmer(~18GB, 128K, ข้อความ+รูปภาพ); Apple Silicon:muse-glimmer:30b-mlx(~21GB, DFlash) - พอดี: เอเจนต์แบบโลคัล/แบบ air-gapped ที่เปิดใช้งานตลอดเวลาบน GPU หรือ Mac Silicon หนึ่งตัว ไม่ใช่โมเดลคลัสเตอร์ MoE แบบหลาย TB
- สัญญาณความแรง: นำไปสู่เมทริกซ์ระดับขนาดที่รายงานของ Meta บน MCP-Atlas, DeepSearch QA, WildClawBench, SWE-Bench Pro, AA-LCR, Beam128K (การใช้เหตุผลสูง)
- การดำเนินการ: นั่งร้านผ่าน
ollama launch(Claude Code, OpenCode, เฮอร์มีส, OpenClaw); ควบคุมด้วย evals, HITL, MCP auth
แหล่งที่มาหลัก: ไลบรารี Ollama - รำพึงริบหรี่; วิธีการประเมินเมตา — วิธีการ Muse Glimmer. ตัวเลขและแท็กเปลี่ยนไป ตรวจสอบบัตรโมเดลสดก่อนจัดซื้อ
1. ความตั้งใจด้านสถาปัตยกรรมและการออกแบบ
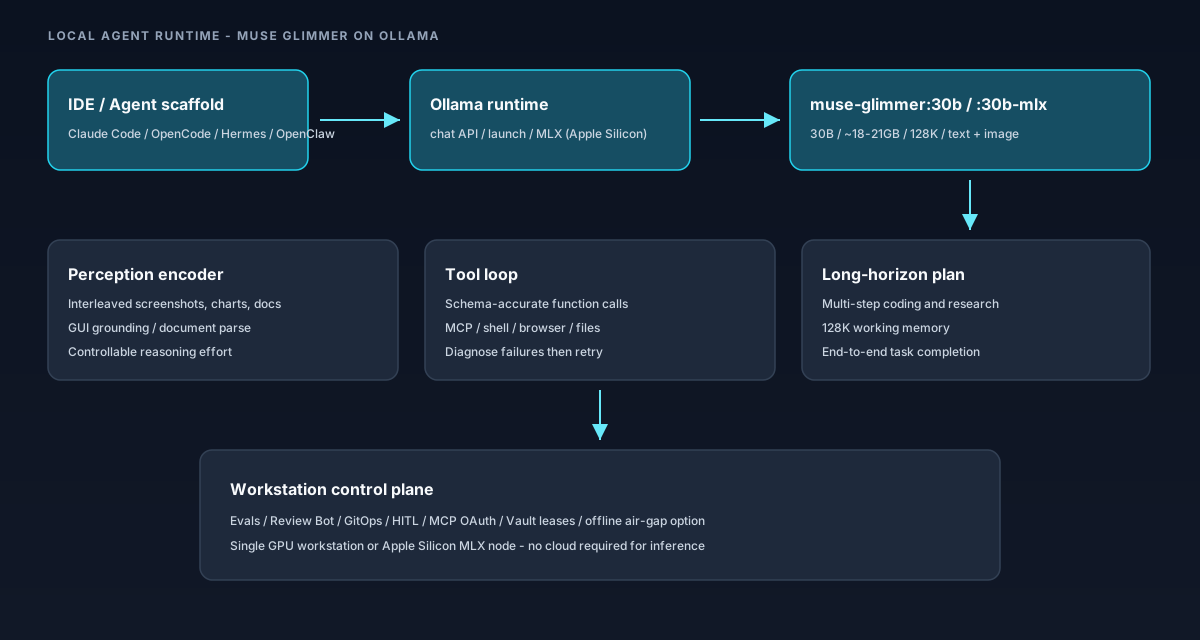
Muse Glimmer ไม่ได้อยู่ในตำแหน่ง MoE แชททั่วไป การกำหนดกรอบของ Meta คือ เสร็จสิ้นงานตัวแทนแบบ end-to-end บนฮาร์ดแวร์คุณสามารถซื้อโต๊ะหรือชั้นวางห้องปฏิบัติการขนาดเล็กได้:
- กระดูกสันหลัง LM เชิงสาเหตุ (30B) - การสร้างโทเค็นครั้งต่อไปพร้อมห่วงโซ่การให้เหตุผลแบบหลายขั้นตอนที่ยั่งยืนตลอดขั้นตอนการทำงานที่ยาวนาน
- ตัวเข้ารหัสการรับรู้โดยเฉพาะ — ยอมรับข้อความและรูปภาพที่แทรกเพื่อให้เจ้าหน้าที่สามารถให้เหตุผลผ่านภาพหน้าจอ แผนภูมิ และเอกสารในหน้าต่างบริบทเดียวกันกับการถอดเสียงเครื่องมือ
- การกลั่นจาก Muse Spark — ความสามารถถ่ายโอนไปสู่รอยเท้าที่กำหนดเป้าหมายการใช้งาน GPU เดียว / ระดับผู้บริโภค แทนที่จะให้บริการเฉพาะศูนย์ข้อมูลเท่านั้น
- พฤติกรรมการกู้คืนความล้มเหลว — เมื่อการเรียกเครื่องมือล้มเหลวหรือส่งคืนเพย์โหลดที่ไม่คาดคิด โมเดลจะได้รับการฝึก/ปรับแต่งเพื่อวินิจฉัยและลองใหม่อีกครั้ง แทนที่จะหยุดตอน
- ความพยายามที่ควบคุมได้ — สามารถเลือกความแข็งแกร่งของเหตุผลได้ เพื่อให้ผู้ปฏิบัติงานสามารถแลกเวลาแฝงกับคุณภาพต่อเส้นทางได้
- ครอบคลุมการฝึกอบรมหลายภาษา — Meta ระบุข้อมูลการฝึกอบรมจากมากกว่า 100 ภาษา
สำหรับสแต็ค Workstation ความหมายของผลิตภัณฑ์คือ: ถือว่า Glimmer เป็น สมองรันไทม์ของตัวแทน เบื้องหลังเครื่องมือ MCP, เชลล์, เบราว์เซอร์ และเครื่องมือแก้ไขไฟล์ — ไม่ใช่เป็นการแทนที่แบบดรอปอินสำหรับการเรียก API ชายแดนแบบปิดทุกครั้ง
2. การกระจาย Ollama (แท็ก, รอยเท้า, I/O)
ตามที่เผยแพร่บนการ์ดไลบรารี Ollama (ตรวจสอบขนาดจริง):
| แท็ก | ประมาณ ขนาด | บริบท | ป้อนข้อมูล | หมายเหตุ |
|---|---|---|---|---|
muse-glimmer:latest / :30b | ~18GB | 128K | ข้อความ รูปภาพ | เส้นทาง GPU เดียวเริ่มต้น |
muse-glimmer:30b-mlx | ~21GB | 128K | ข้อความ รูปภาพ | เครื่องยนต์ Ollama MLX; DFlash + รูปภาพบน Apple Silicon |
# Pull + interactive
ollama run muse-glimmer

# Apple Silicon (MLX)
ollama run muse-glimmer:30b-mlx

# HTTP chat (localhost Ollama)
curl http://localhost:11434/api/chat \
  -d '{"model":"muse-glimmer","messages":[{"role":"user","content":"Hello!"}]}'

# Scaffold launchers (from Ollama applications list)
ollama launch claude --model muse-glimmer
ollama launch opencode --model muse-glimmer
ollama launch hermes --model muse-glimmer
ollama launch openclaw --model muse-glimmer
ไคลเอนต์ Python / JS ควรปักหมุดแท็กที่คุณตรวจสอบแล้ว (muse-glimmer เทียบกับ :30b-mlx) ในการกำหนดค่า ไม่ใช่ฮาร์ดโค้ด latest ในตัวแทนการผลิต
3. พื้นผิวความสามารถ (การอ่านทางวิศวกรรม)
- การสำเร็จเอเจนต์แบบครบวงจร — Meta อ้างอิงผลลัพธ์ที่ชัดเจนในงาน DeepSearch QA, MCP-Atlas, τ3-Bench (การธนาคาร) และงานตระกูล SWE-Bench ที่วัดความสำเร็จแบบหลายเทิร์นแบบนั่งร้าน ไม่ใช่เกร็ดความรู้เรื่องเดียว
- การใช้เครื่องมือที่เชื่อถือได้ — ความครอบคลุมการเรียกใช้ฟังก์ชันที่กว้างขวางพร้อมความแม่นยำของสคีมาตลอดเวิร์กโฟลว์ที่ขยาย (สำคัญอย่างยิ่งสำหรับกลุ่มเครื่องมือ MCP)
- การใช้เหตุผลหลายขั้นตอน — วางแผนการเชื่อมโยงกันในขอบเขตอันยาวไกล จับคู่กับหน้าต่างบริบท 128K สำหรับการถอดเสียงและการเก็บรักษาเอกสาร
- การกู้คืนความล้มเหลว — วินิจฉัยผลลัพธ์ของเครื่องมือที่ไม่คาดคิดแล้วลองอีกครั้ง ลด "สารเปราะ" ยกเลิกงานข้ามคืน
- การใช้เหตุผลหลายรูปแบบ - ตัวเข้ารหัสการรับรู้เปิดใช้งานภาพหน้าจอ / แผนภูมิ / เอกสารที่แทรกด้วยข้อความ (การต่อสายดิน GUI และม้านั่งแยกวิเคราะห์เอกสารรวมอยู่ในเมทริกซ์ของ Meta)
- ความเข้ากันได้ของนั่งร้าน — OpenClaw, Hermes Agent และรูปแบบการเรียบเรียงที่คล้ายกัน Ollama แสดงรายการตัวเรียกใช้งาน Claude Code และ OpenCode ว่าเป็นแอปชั้นหนึ่ง
4. เมทริกซ์เกณฑ์มาตรฐาน (รายงาน Meta, ให้เหตุผลสูง)
Meta เปรียบเทียบ Muse Glimmer-30B (การให้เหตุผลสูง) กับ Gemma4-31B และ Qwen3.6-27B ในโหมดการคิด การอ่านพาดหัว Workstation: Glimmer เป็นผู้นำหลายอย่าง ตัวแทน ชุดสาธารณะ (MCP-Atlas, DeepSearch QA, WildClawBench, Gaia2, SWE-Bench Pro) ในขณะที่ติดตามหรือเชื่อมโยงเพียร์บนตัววัด desktop-agent และ GDP-val บางตัว เรียกใช้ใหม่เสมอ ของคุณ สายรัด
| หมวดหมู่ | เกณฑ์มาตรฐาน | กลิมเมอร์-30B | เจมม่า4-31B | คิวเวน3.6-27B |
|---|---|---|---|---|
| ตัวแทนทั่วไป | MCP-Atlas (สาธารณะ) | 75.5 | 54.2 | 62.5 |
| ดีพเสิร์ช QA | 74.6 | 61.7 | 71.1 | |
| τ3-การธนาคาร | 23.5 | 15.1 | 16.7 | |
| WildClawBench | 47.6 | 37.6 | 43.2 | |
| GDPVal-AA เวอร์ชัน 2 | 953 | 811 | 1141 | |
| ไกอา2 | 43.3 | 36.4 | 40.0 | |
| SkillsBench (พร้อมทักษะ) | 44.3 | 32.4 | 46.6 | |
| ตรวจสอบ OSWorld แล้ว | 65.9 | 58.5 | 75.6 | |
| การเข้ารหัสตัวแทน | SWE-Bench โปร | 51.2 | 36.9 | 50.2 |
| ตรวจสอบ SWE-Bench แล้ว | 76.0 | 66.6 | 77.2 | |
| เทอร์มินัลเบนช์ 2.1 | 51.7 | 43.4 | 60.7 | |
| ไซโค้ด | 43.6 | 43.4 | 39.8 | |
| ต่อเนื่องหลายรูปแบบ | การใช้เหตุผล CharXiv | 78.8 | 77.7 | 78.4 |
| สกรีนสปอตโปร | 75.4 | 75.9 | 76.1 | |
| OmniDocBench เวอร์ชัน 1.5 | 75.8 | 72.5 | 77.8 | |
| เอ็มเอ็มเอ็มยู โปร | 74 | 73 | 75 | |
| การใช้เหตุผล / LCR | ไอเอฟเบนช์ | 77.0 | 76.0 | 70.8 |
| จุดมุ่งหมาย 2026 | 94.7 | 89.2 | 94.1 | |
| GPQA ไดมอนด์ (AA) | 83.5 | 85.7 | 84.2 | |
| ข้อความ HLE (AA) | 22.0 | 23.6 | 23.1 | |
| AA-LCR | 80.0 | 68.3 | 73.3 | |
| บีม128K | 65.1 | 58.2 | 63.0 |
ม้านั่งนิรภัย (CI Memories, Siren AgentDojo) แสดงให้เห็นถึงข้อดีข้อเสีย: Glimmer รายงานว่ามีประโยชน์ใช้สอยสูงภายใต้การฉีด AgentDojo ด้วย ASR ในระดับกลาง; ถือว่าความปลอดภัยเป็นปัญหาในการควบคุมการใช้งาน (ไฟร์วอลล์แจ้ง รายการเครื่องมือที่อนุญาต HITL) ไม่ใช่คุณสมบัติของโมเดลที่แก้ไขแล้ว ดู PDF วิธีการของ Meta สำหรับแบบจำลองการตัดสิน จำนวนความพยายาม และการควบคุมคำเตือน
5. วิธีการประเมินผล (ตัวเลขหมายถึงอะไร)
หมายเหตุวิธีการของ Meta เป็นสิ่งสำคัญก่อนที่คุณจะเสนอราคาเซลล์ใด ๆ ในสำรับกระดาน:
- การเลือกเพื่อน: รุ่นเปิดระดับขนาด (Gamma4-31B, Qwen3.6-27B); เพื่อนร่วมงานอาจใช้คะแนนที่รายงานด้วยตนเองหรือทำซ้ำภายใน การวิเคราะห์เชิงประดิษฐ์ใช้เมื่อมีให้ทั้งสามแบบ
- การสุ่มตัวอย่าง: Glimmer รายงานด้วยความมีเหตุผลสูงโดยมีอุณหภูมิ=1.0 / top_p=0.95 / top_k=64; เพื่อนร่วมงานใช้การกำหนดค่าการคิดที่ผู้ขายแนะนำ (Qwen ใช้อุณหภูมิที่เย็นกว่าบนม้านั่งตัวแทนบางตัว)
- ข้อแม้อคติเทียม: Meta Notes โมเดลบุคคลที่สามอาจไม่สามารถปรับให้เข้ากับเครื่องมือ/ระบบของ Meta ได้ - อันดับสัมบูรณ์สามารถเปลี่ยนแปลงได้ภายใต้โครงแบบเพียร์เนทีฟ
- MCP-Atlas: การใช้เครื่องมือหลายรอบในเซิร์ฟเวอร์ MCP มากกว่า 20 เครื่อง อัตราการผ่านของผู้ตัดสิน LLM (เกณฑ์ 0.75) ในงานสาธารณะ 500 งาน เฉลี่ยมากกว่า 4 รอบ
- ดีพเสิร์ช QA: วนการสืบค้นอัตโนมัติ (ค้นหา/เปิด/ค้นหา) กับคำถามวิจัยยาก 900 ข้อ F1 ผ่านการสกัดผู้พิพากษา
- WildClawBench / Gaia2: งานตัวแทนเชื่อมต่อขอบฟ้ายาวภายใต้สายรัดสไตล์ OpenClaw พร้อมการฉีดเหตุการณ์และการให้คะแนนแบบกำหนดแบบผสม/LLM
- SWE-Bench: โครงเครื่องมือ bash + ไฟล์; ค่าเฉลี่ยแบบ Pro และ Verified สำหรับการรันหลายครั้ง — การเปรียบเทียบแบบ Pro จะหลีกเลี่ยงตัวแปรงานที่ปรับปรุงแล้วของ Qwen
- OSWorld ได้รับการยืนยันแล้ว: การควบคุม Ubuntu VM ของ GUI เท่านั้นจากภาพหน้าจอ (ไม่มีเชลล์โดยตรง); ความแตกต่างระหว่างพื้นที่ปฏิบัติการระหว่างโมเดลมีความสำคัญ
- บีม128K: โพรบหน่วยความจำบริบทยาวที่ไม่ใช่เอเจนต์ที่ 128K — เกี่ยวข้องหากคุณเก็บการถอดเสียงขนาดใหญ่ในบริบทโดยไม่มี RAG
นโยบาย Workstation: เผยแพร่เมทริกซ์ของ Meta สำหรับการวางแนว จากนั้นเกตการผลิตบนชุดทองภายใน (เครื่องมือ MCP ของคุณ repos ของคุณ SLO เวลาในการตอบสนองของคุณ)
6. ฮาร์ดแวร์และการให้บริการความเป็นจริง
- คลาส GPU เดี่ยว: ~18GB ฐานน้ำหนักแสดงถึงความทันสมัย 24GB+ Consumer/Pro GPU เป็นพื้น NVIDIA ที่ใช้งานได้จริงเมื่อพิจารณาการเปิดใช้งานแคช KV และการมองเห็น โปรไฟล์พร้อมบริบทสูงสุดและเซสชันที่เกิดขึ้นพร้อมกัน
- Apple Silicon: ชอบมากกว่า
:30b-mlx(~21GB) สำหรับเส้นทาง MLX ของ Ollama พร้อมการถอดรหัสเชิงคาดเดา DFlash และอินพุตรูปภาพเนทิฟ — การกำหนดค่า Mac Studio / Mac mini Max เป็นโหนด SME ชั้นนำ - ไม่ใช่คลาส Kimi-K3: นี่ไม่ใช่ MoE แบบหลายโหนด หากคุณต้องการตัวแทนแบบเปิดจำนวนล้านล้านพารามิเตอร์ โปรดดูของเรา คู่มือตุ้มน้ำหนักแบบเปิด; กลิมเมอร์เป็นเจ้าของ ด้านข้างโต๊ะเปิดตลอดเวลา ซอก.
- คูเบอร์เนทีส: แพ็คเกจ Ollama หรือรถเทียมข้างรถจักรยานยนต์ที่เข้ากันได้กับ OpenAI ต่อโหนด เก็บโมเดลไว้ในรีจิสตรี / แคชส่วนตัวของคุณ อย่าเปิดเผย Ollama ที่ไม่ได้ผูกไว้กับอินเทอร์เน็ต
7. การรักษาความปลอดภัยและการกำกับดูแลสำหรับตัวแทนที่ทำงานตลอดเวลา
น้ำหนักท้องถิ่นจะช่วยลดข้อมูลขาออก แต่เพิ่มรัศมีการระเบิดของโฮสต์ตัวแทนที่ถูกบุกรุก พื้นฐาน Workstation ขั้นต่ำ:
- MCP OAuth 2.1 + ความลับระยะสั้น (สัญญาเช่าห้องนิรภัย) — ดู บทความการรักษาความปลอดภัยตัวแทน.
- รายการเครื่องมือที่อนุญาตและนโยบายขาออกของเครือข่ายตามข้อมูลระบุตัวตนของตัวแทน
- HITL เปิดประตูสู่การดำเนินการที่ไม่สามารถย้อนกลับได้ (การชำระเงิน การใช้งานผลิตภัณฑ์ อีเมลจำนวนมาก)
- การตรวจสอบการแทรกทันทีในเนื้อหาที่ส่งคืนโดยเครื่องมือ (โมเดลภัยคุกคามสไตล์ Siren AgentDojo)
- โหมดออฟไลน์/ช่องว่างอากาศได้รับการทดสอบว่าเป็น Runbook ระดับเฟิร์สคลาส ไม่ใช่ความหวัง
8. รายการตรวจสอบการผลิต
- ปักหมุดแท็ก Ollama (
30bเทียบกับ30b-mlx) และบันทึกไดเจสต์/แฮชใน GitOps - สร้างชุดงานสีทอง 20–50 งานที่สะท้อนเครื่องมือ MCP ของคุณและเวิร์กโฟลว์การเขียนโค้ด ติดตาม pass@1 และ p95 latency ในแต่ละระดับความพยายาม
- โครงลวด (
ollama launch …หรือกำหนดเอง) พร้อมการบันทึกโครงสร้างการเรียกเครื่องมือและลองใหม่ - กำหนดเราเตอร์ไฮบริด: Glimmer local สำหรับ RAG/เอเจนต์ส่วนตัว การเฟลโอเวอร์บนคลาวด์สำหรับโอเวอร์โฟลว์ / พีคไอคิว
- เอกสาร VRAM/หน่วยความจำแบบรวมส่วนหัวที่ 32K / 64K / 128K พร้อมการมองเห็น
- ถูกกฎหมาย: การตรวจสอบ Apache 2.0 สำหรับโมเดลการจัดจำหน่ายของคุณ (โดยปกติจะเป็นแบบตรงไปตรงมาเทียบกับแบบ open-weight ที่จำกัด)
- จัดส่งบอทตรวจสอบ + ประตูตรวจประเมินก่อนที่จะเปิดใช้งานเจ้าหน้าที่ข้ามคืนแบบไม่ต้องดูแล
จัดพิมพ์โดย Workstation. การ์ดรุ่น: ollama.com/library/muse-gimmer.


