ร้านเปิดให้สั่งแล้ว

เราสร้างเครื่อง Workstation AI สำหรับเว็บไซต์ เอเจนต์ AI และการเทรน LLM — กำหนดค่าและซื้อออนไลน์

ดูราคาสำหรับคู่ค้า
ผลิตภัณฑ์ AI
AI LabsOpenAI AgentsClaude AgentsGrok BotCRM พื้นฐานของ Workstation AIการตลาดผลิตภัณฑ์ทั้งหมด
โซลูชัน AI
AI ประยุกต์เอเจนต์ AIAI เชิงสร้างระบบอัตโนมัติด้วย AIยกระดับทักษะ AIแพ็กเกจ AI สำหรับ SMEห้องปฏิบัติการ AI สำหรับองค์กรเวิร์กสเตชัน AIฮาร์ดแวร์และซอฟต์แวร์ NVIDIANVIDIA Accelerated ComputingAI ส่วนตัวคลัสเตอร์ GPUEdge AIAI ตามอุตสาหกรรม
บริการ AI
ปรับปรุงแพลตฟอร์มให้ทันสมัยวิศวกรรมดิจิทัลรากฐานข้อมูลและ AIการปฏิบัติงานอัตโนมัติที่ปรึกษา AIระบบอัตโนมัติ DevOpsความมั่นคงปลอดภัยไซเบอร์การพัฒนาซอฟต์แวร์การสร้างเอเจนต์การตั้งค่า MLOpsการเช่า GPU
เกี่ยวกับเรา
บริษัทเรื่องราวของเราพันธมิตรเรื่องราวของลูกค้า
ศูนย์ข้อมูล AI
ข้อมูลเชิงลึก AIชุด Jevแล็บเบนช์มาร์กการเลือกโมเดล
บันทึกทางเทคนิค
เอกสารประกอบ
ระบบปฏิบัติการ LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
แพลตฟอร์มคลาวด์ AIAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI Foundryคลาวด์และมาร์เก็ตเพลส GPU
ศูนย์ข้อมูล AI ส่วนตัวสำหรับสำนักงานกฎหมายสำหรับสำนักงานบัญชีแพลตฟอร์มภายในองค์กรคลาวด์ที่ปลอดภัยเต็มรูปแบบ
เครื่องมือRing PromoterJobshout
ข่าวสาร
บล็อก
ติดต่อเราลงชื่อเข้าใช้

เวิร์กสเตชัน AI ซอฟต์แวร์มัลติเอเจนต์ AI โครงสร้างพื้นฐาน GPU และโซลูชันเอเจนต์อัจฉริยะสำหรับธุรกิจยุคใหม่

ติดต่อเรา

โซลูชัน AI

AI ประยุกต์เอเจนต์ AIAI เชิงสร้างระบบอัตโนมัติด้วย AIยกระดับทักษะ AIแพ็กเกจ AI สำหรับ SMEห้องปฏิบัติการ AI สำหรับองค์กรAI ตามอุตสาหกรรม

ผลิตภัณฑ์

ผลิตภัณฑ์ทั้งหมดWorkstation AI native CRM และ ERPการตลาดOpenAI AgentsRing PromoterJobshout

บริษัท

เกี่ยวกับเราบริษัทศูนย์ข้อมูล AIทำไมต้อง Workstationพันธมิตรเรื่องราวของลูกค้าราคาติดต่อTenthMatrix

แหล่งข้อมูล

ข้อมูลเชิงลึก AIบันทึกทางเทคนิคเอกสารประกอบระบบปฏิบัติการ Linuxแพลตฟอร์มคลาวด์ AIศูนย์ข้อมูล AI ส่วนตัวบล็อกค้นหาแผนผังเว็บไซต์
สำนักงานสหราชอาณาจักร
77-79 Marlowes, Hemel Hempstead HP1 1LFเส้นทาง - ออกทางแยกที่ 20 จาก M25 Outer Londonเลขทะเบียนบริษัท: 11641870จ. - ศ.: 9:00 - 18:00 น. GMT
+44 7515 356 146
สำนักงานเบลเยียม
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683จ. - ศ.: 9:00 - 18:00 น. CET
+32 492 45 67 46
สำนักงานอินเดีย
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI สงวนลิขสิทธิ์

ความเป็นส่วนตัวการลบข้อมูลคุกกี้ข้อกำหนดในการให้บริการแผนผังเว็บไซต์

NVIDIA, the NVIDIA logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX and HGX are trademarks and/or registered trademarks of NVIDIA Corporation in the US and other countries. AMD, the AMD Arrow logo, EPYC, Instinct, Ryzen and Threadripper are trademarks of Advanced Micro Devices, Inc. Dell and PowerEdge are trademarks of Dell Inc. or its subsidiaries. Intel and Xeon are trademarks of Intel Corporation or its subsidiaries. AMAX, AceleMax and LiquidMax are trademarks of AMAX Engineering Corporation. All other product names, logos and brands are the property of their respective owners. We use them only to identify the products we describe, supply or support; their use does not mean their owners endorse us.

พันธมิตร NVIDIA · สหราชอาณาจักร

โซลูชัน NVIDIA Accelerated Computing

ตั้งแต่ GPU ดาต้าเซ็นเตอร์ตัวเดียวไปจนถึง AI factory ระดับแร็กระบายความร้อนด้วยของเหลว Workstation ประเมินขนาด จัดหา ประกอบ ติดตั้ง และสนับสนุนผลิตภัณฑ์ NVIDIA Accelerated Computing ครบทุกกลุ่มสำหรับองค์กรในสหราชอาณาจักร

ดูผลิตภัณฑ์ทั้งหมดพูดคุยกับวิศวกร
  • 34ผลิตภัณฑ์ระบบ, GPU, ระบบเครือข่าย และซอฟต์แวร์ของ NVIDIA
  • 5ขั้นตอน ตั้งแต่การประเมินขนาดจนถึงการสนับสนุนระยะยาว
  • UKงานวิศวกรรม การประกอบ และการทดสอบ Burn-in

Accelerated computing โดยไม่มีความเสี่ยงด้านการผสานระบบ

Accelerated computing ย้ายส่วนที่หนักที่สุดของเวิร์กโหลด เช่น การเทรน AI, inference, การจำลอง, การวิเคราะห์ข้อมูล และการเรนเดอร์ จาก CPU ทั่วไปไปยัง GPU และโปรเซสเซอร์เฉพาะทาง ผลที่ได้คือทำงานได้มากขึ้นต่อแร็กและต่อวัตต์ และได้ผลลัพธ์ในหลักชั่วโมงแทนที่จะเป็นหลายวัน

การไปถึงจุดนั้นต้องการมากกว่า GPU ตัวเร่งแต่ละตัวต้องมีเซิร์ฟเวอร์ที่จ่ายไฟและระบายความร้อนได้ เครือข่ายที่ป้อนข้อมูลได้ทัน และซอฟต์แวร์ที่มีไลเซนส์และได้รับการสนับสนุน ในฐานะพันธมิตร NVIDIA ที่มีวิศวกรของเราเอง เรารวมทุกส่วนเป็นระบบเดียวที่ผ่านการทดสอบ และอยู่เคียงข้างคุณหลังเริ่มใช้งานจริง

  • คำแนะนำที่เป็นกลางว่าแพลตฟอร์ม NVIDIA ใดเหมาะกับเวิร์กโหลดของคุณ
  • การกำหนดค่าแบบ NVIDIA-Certified ที่ครบถ้วน แทนชิ้นส่วนแยก
  • ประกอบ ลงอิมเมจ และทดสอบ Burn-in ในเวิร์กช็อปของเราในสหราชอาณาจักร
  • ติดตั้ง เดินสาย และส่งมอบใช้งาน ณ สถานที่ของคุณ
  • ผู้ติดต่อรายเดียวในสหราชอาณาจักรสำหรับการสนับสนุน การอัปเกรด และการรับประกัน

องค์ประกอบของระบบ accelerated computing

สี่ชั้นทำงานร่วมกัน เรากำหนดสเปกทั้งสี่ชั้นเพื่อไม่ให้ชั้นใดกลายเป็นคอขวด

GPU

ประมวลผลคณิตศาสตร์แบบขนานเบื้องหลัง AI การจำลอง และกราฟิก ขนาดและแบนด์วิดท์หน่วยความจำมักเป็นตัวตัดสินว่าคุณต้องใช้ GPU รุ่นใด

CPU และระบบ

ป้อนข้อมูลให้ GPU รันระบบปฏิบัติการ และเก็บข้อมูลในหน่วยความจำ แชสซีเป็นตัวกำหนดพลังงาน การระบายความร้อน และจำนวน GPU ที่ใส่ได้

ระบบเครือข่ายและ DPU

ส่งข้อมูลระหว่าง GPU เซิร์ฟเวอร์ และสตอเรจ DPU รับภาระงานด้านเครือข่าย สตอเรจ และความปลอดภัยแทน CPU

ซอฟต์แวร์

ไดรเวอร์ CUDA เฟรมเวิร์ก AI และเครื่องมือคลัสเตอร์ เปลี่ยนฮาร์ดแวร์ให้เป็นแพลตฟอร์มที่ทีมของคุณใช้งานได้

เหตุใดองค์กรจึงหันมาใช้ accelerated computing

เวิร์กโหลดเกินขีดความสามารถของ CPU

โมเดล AI และชุดข้อมูลเติบโตเร็วกว่าประสิทธิภาพของ CPU งานล่าช้า ระดับบริการลดลง และค่าไฟสูงขึ้น

เวิร์กโฟลว์ซับซ้อนขึ้น

การเตรียมข้อมูล การเทรน inference และการแสดงผลมักรันบนอุปกรณ์แยกกัน แพลตฟอร์ม accelerated เดียวช่วยให้ไปป์ไลน์เรียบง่ายขึ้น

แอปใหม่สร้างไซโลใหม่

การเพิ่ม AI ควบคู่กับแอปพลิเคชันเดิมอาจทำให้เกิดฮาร์ดแวร์ที่แยกเป็นเกาะ แพลตฟอร์มที่ใช้ร่วมกันและผ่านการรับรองช่วยให้ทุกอย่างจัดการได้

กลุ่มผลิตภัณฑ์

ผลิตภัณฑ์ NVIDIA Accelerated Computing

ระบบ, GPU, ผลิตภัณฑ์เครือข่าย และไลเซนส์ซอฟต์แวร์ทุกรายการด้านล่างสามารถจัดหาแยกหรือเป็นส่วนหนึ่งของระบบที่ประกอบครบชุด กรองตามประเภท เปรียบเทียบสเปกหลัก และขอใบเสนอราคา

ระบบและแพลตฟอร์ม

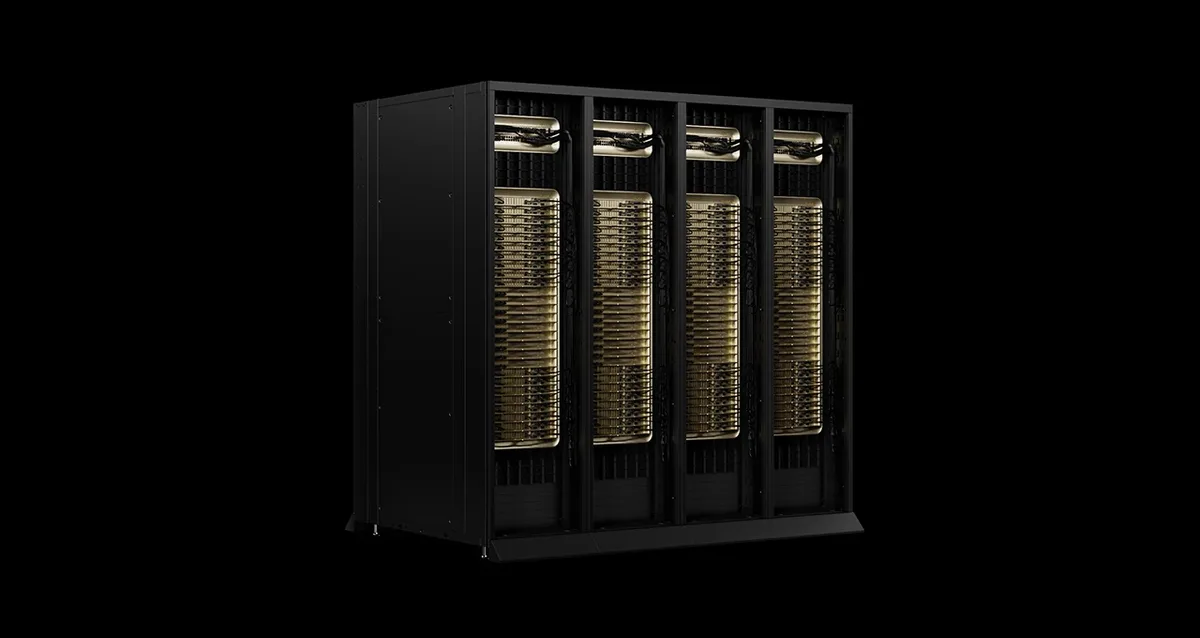
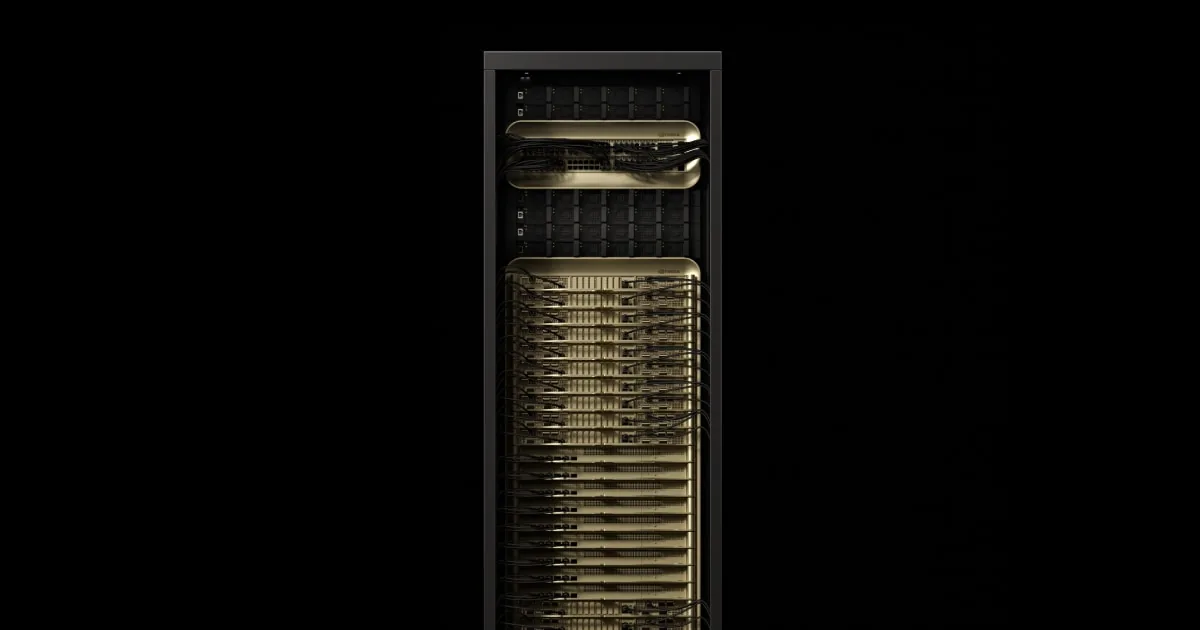
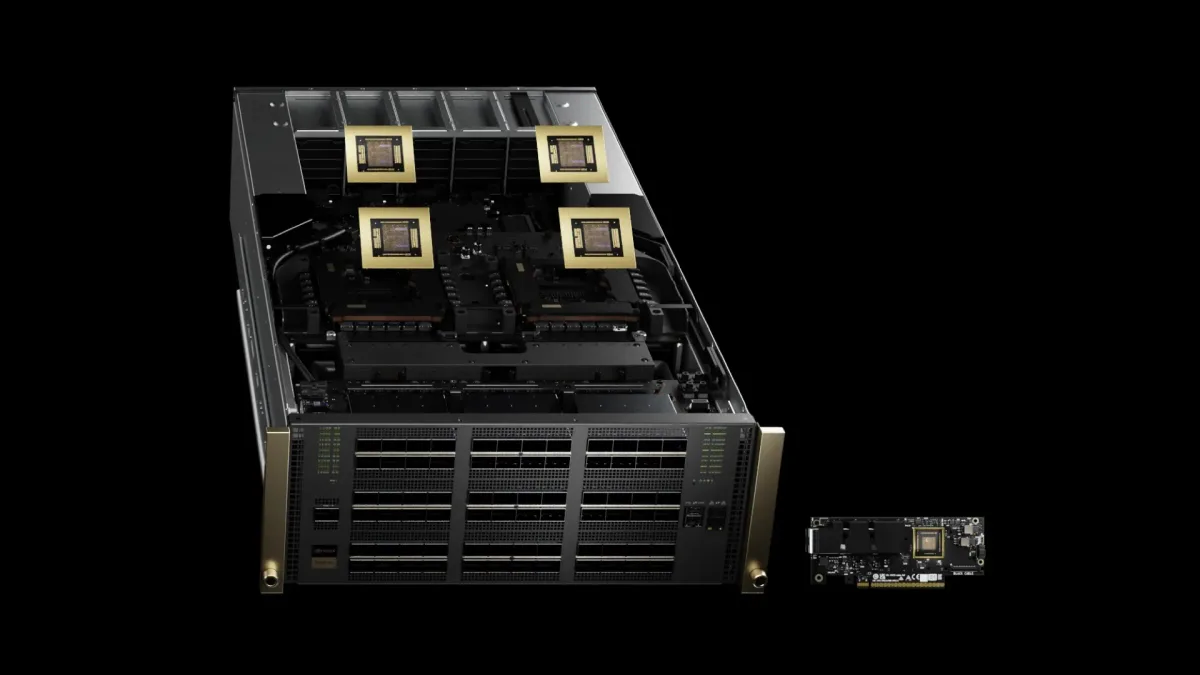
NVIDIA Vera Rubin NVL72

ระบบระดับแร็กสำหรับ agentic AI และโมเดลขนาดใหญ่ที่สุด

แร็กรุ่นใหม่ล่าสุดของ NVIDIA รวม Rubin GPU 72 ตัวและ Vera CPU 36 ตัวไว้ในโดเมน NVLink เดียว ทำให้แร็กเดียวทำงานเหมือนตัวเร่งขนาดใหญ่มากหนึ่งตัว

เหมาะกับใคร: AI factory ผู้พัฒนาโมเดล และผู้ให้บริการที่วางแผนการติดตั้งขนาดใหญ่ครั้งต่อไป

ประโยชน์

  • จำนวนโทเคนต่อเมกะวัตต์สูงกว่ารุ่น Grace Blackwell อย่างมาก ตามตัวเลขของ NVIDIA
  • หน่วยความจำ HBM4 ที่มีขนาดรองรับโมเดลระดับล้านล้านพารามิเตอร์และ long-context
  • ถาดแบบโมดูลาร์ไร้สายเคเบิล ทำให้การซ่อมบำรุงในแร็กง่ายขึ้น

สเปกหลัก

การกำหนดค่า72× Rubin GPU, 36× Vera CPU
หน่วยความจำ GPU20.7 TB HBM4 | 1,400 TB/s
NVFP4 inference3,600 PFLOPS (sparse)
แบนด์วิดท์ NVLink216 TB/s (sixth generation)
หน่วยความจำ CPUUp to 54 TB LPDDR5X
ฟอร์มแฟกเตอร์Rack, third-generation MGX NVL72

สิ่งที่ Workstation ทำให้: เราตรวจสอบพลังงาน การระบายความร้อน และการรับน้ำหนักพื้นของสถานที่ตั้งแต่เนิ่นๆ จองโควตาสินค้า และวางแผนการจัดส่ง ติดตั้ง และส่งมอบใช้งานให้สอดคล้องกับห้องดาต้าเซ็นเตอร์ของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

NVIDIA GB300 NVL72 (DGX GB300)

แร็ก Blackwell Ultra ระบายความร้อนด้วยของเหลวสำหรับ AI reasoning

Grace CPU 36 ตัวและ Blackwell Ultra GPU 72 ตัวใช้ NVLink fabric เดียวกันในแร็กระบายความร้อนด้วยของเหลวแร็กเดียว NVIDIA ยังจำหน่ายในชื่อ DGX GB300 ด้วย

เหมาะกับใคร: องค์กรที่ให้บริการโมเดล reasoning แก่ผู้ใช้จำนวนมาก และทีมที่เทรนในระดับ frontier

ประโยชน์

  • จำนวนโทเคนต่อวินาทีต่อผู้ใช้เพิ่มขึ้นอย่างมากเมื่อเทียบกับระบบที่ใช้ Hopper
  • หน่วยความจำความเร็วสูง 37 TB เก็บ long context และโมเดลขนาดใหญ่ไว้ในโดเมนเดียว
  • ConnectX-8 SuperNIC ให้ GPU ทุกตัวมีเส้นทาง 800 Gb/s สู่เครือข่าย

สเปกหลัก

GPU72× Blackwell Ultra
CPU36× Grace (2,592 Arm Neoverse V2 cores)
หน่วยความจำ GPU20 TB | up to 576 TB/s
หน่วยความจำความเร็วสูง37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
แบนด์วิดท์ NVLink130 TB/s

สิ่งที่ Workstation ทำให้: เราวางแผนการระบายความร้อนด้วยของเหลวและพลังงานร่วมกับทีมอาคารของคุณ ประสานการจัดส่งแร็กแบบครบชุด และส่งมอบใช้งานตามเกณฑ์มาตรฐานที่ผ่านการตรวจสอบ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

NVIDIA GB200 NVL72 (DGX GB200)

ระบบระดับแร็ก Grace Blackwell ในโดเมน NVLink เดียว

แร็ก Grace Blackwell รุ่นแรก: Blackwell GPU 72 ตัวและ Grace CPU 36 ตัวเชื่อมด้วย NVLink และระบายความร้อนด้วยของเหลว สำหรับการเทรนขนาดใหญ่มากและ inference แบบเรียลไทม์

เหมาะกับใคร: ทีมที่เทรนหรือให้บริการโมเดลระดับล้านล้านพารามิเตอร์ซึ่งต้องการพูลหน่วยความจำ GPU ขนาดใหญ่ที่ใช้ร่วมกัน

ประโยชน์

  • inference แบบเรียลไทม์บนโมเดลภาษาขนาดใหญ่มาก เร็วกว่า H100 หลายเท่า ตามตัวเลขของ NVIDIA
  • การระบายความร้อนด้วยของเหลวเพิ่มความหนาแน่นและประสิทธิภาพด้านพลังงาน
  • NVLink รุ่นที่ห้าให้แบนด์วิดท์ 1.8 TB/s ระหว่าง GPU สองตัวใดๆ

สเปกหลัก

การกำหนดค่า72× Blackwell GPU, 36× Grace CPU
หน่วยความจำ GPU13.4 TB HBM3E | 576 TB/s
NVFP4 Tensor Core1,440 PFLOPS sparse | 720 PFLOPS dense
แบนด์วิดท์ NVLink130 TB/s
หน่วยความจำ CPU17 TB LPDDR5X | 14 TB/s
ระบายความร้อนLiquid cooled

สิ่งที่ Workstation ทำให้: เราประเมินสถานที่ของคุณสำหรับการระบายความร้อนด้วยของเหลว จัดการการจัดส่งและการผสานรวมกับเครือข่ายและสตอเรจของคุณ และสนับสนุนแร็กหลังเริ่มใช้งานจริง

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

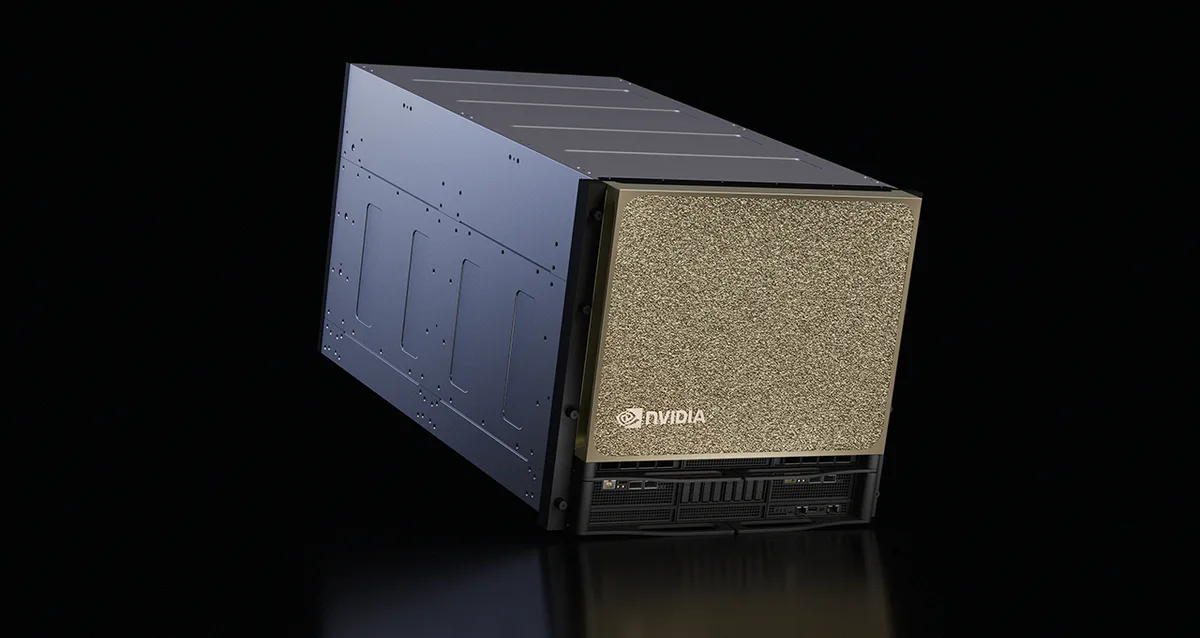
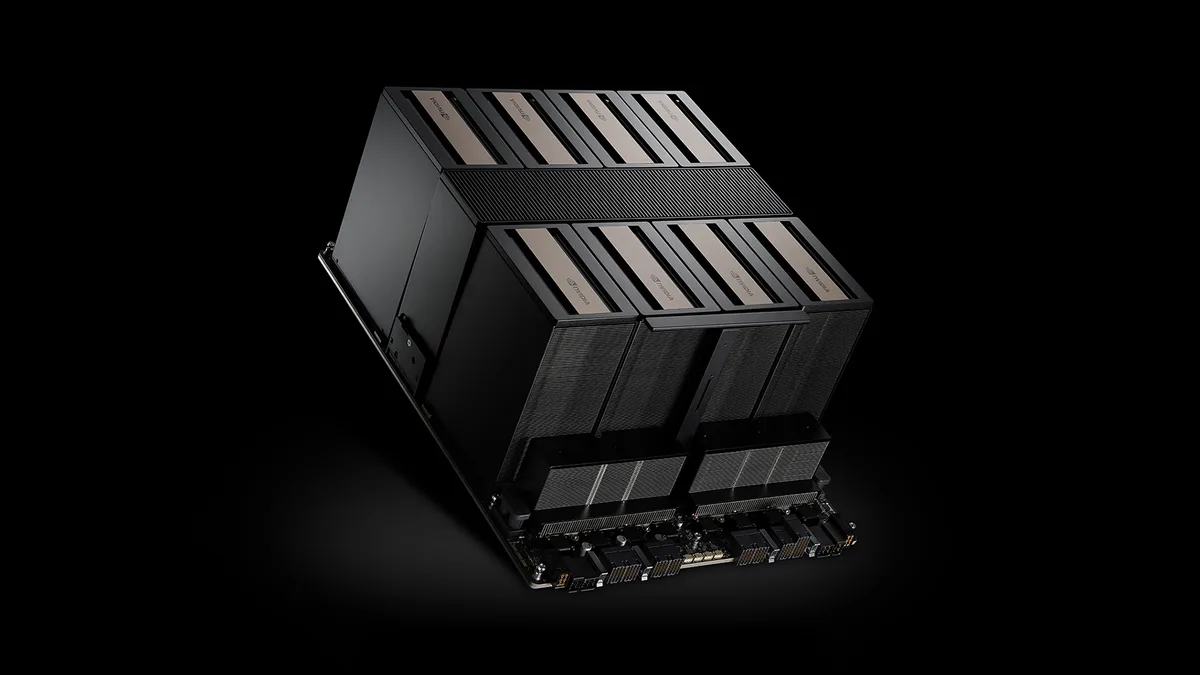
NVIDIA DGX B300

Blackwell Ultra GPU แปดตัวในระบบ DGX เดียว

เซิร์ฟเวอร์ DGX แบบครบในตัวพร้อม Blackwell Ultra GPU แปดตัว ระบบเครือข่าย NVIDIA และชุดซอฟต์แวร์ DGX เต็มรูปแบบ พร้อมใช้งานแบบเดี่ยวหรือเข้าร่วม BasePOD หรือ SuperPOD

เหมาะกับใคร: องค์กรที่กำลังสร้าง AI factory จริงจังแห่งแรก และทีมที่ต้องการดีไซน์อ้างอิงของ NVIDIA แทนการประกอบแบบกำหนดเอง

ประโยชน์

  • หน่วยความจำ GPU 2.3 TB ในโหนดเดียวสำหรับโมเดลขนาดใหญ่
  • ระบบเครือข่าย ConnectX-8 และ BlueField-3 ในตัวสำหรับการขยายระบบ
  • ซอฟต์แวร์ DGX ทำให้ทุกโหนดในคลัสเตอร์สอดคล้องกันตั้งแต่วันแรก

สเปกหลัก

GPU8× Blackwell Ultra
หน่วยความจำ GPU2.3 TB total
ประสิทธิภาพ AI72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
ระบบเครือข่าย8× ConnectX-8, 2× BlueField-3 DPU

สิ่งที่ Workstation ทำให้: เราตรวจสอบพลังงานและการไหลเวียนอากาศของแร็ก จัดส่งและติดตั้งระบบลงแร็ก เชื่อมต่อกับ fabric ของคุณ และส่งมอบพร้อม DGX OS และไดรเวอร์ที่ผ่านการตรวจสอบ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

NVIDIA DGX B200

DGX Blackwell ที่พิสูจน์แล้วสำหรับการเทรนและ inference

Blackwell GPU แปดตัวที่เชื่อมด้วย NVLink ในแชสซี DGX เดียว เป็นบล็อกพื้นฐานที่ใช้งานแพร่หลายสำหรับ AI ภายในองค์กร

เหมาะกับใคร: ทีมที่ย้ายจาก Hopper หรือ GPU บนคลาวด์มาสู่แพลตฟอร์ม Blackwell ที่เป็นเจ้าของเอง

ประโยชน์

  • แพลตฟอร์มเดียวสำหรับการเทรน การ fine-tune และ inference
  • หน่วยความจำ GPU 1,440 GB ใน GPU แปดตัวที่เชื่อมด้วย NVLink
  • รองรับดีไซน์อ้างอิง BasePOD และ SuperPOD เมื่อคุณขยายระบบ

สเปกหลัก

GPU8× Blackwell
หน่วยความจำ GPU1,440 GB total
ประสิทธิภาพ AI72 PFLOPS training, 144 PFLOPS inference
ระบบเครือข่าย8× ConnectX-7, 2× BlueField-3 DPU

สิ่งที่ Workstation ทำให้: เราประเมินขนาดให้เหมาะกับโมเดลของคุณ จัดส่งและติดตั้ง และตั้งค่าไดรเวอร์ CUDA และ NVIDIA AI Enterprise ก่อนส่งมอบ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

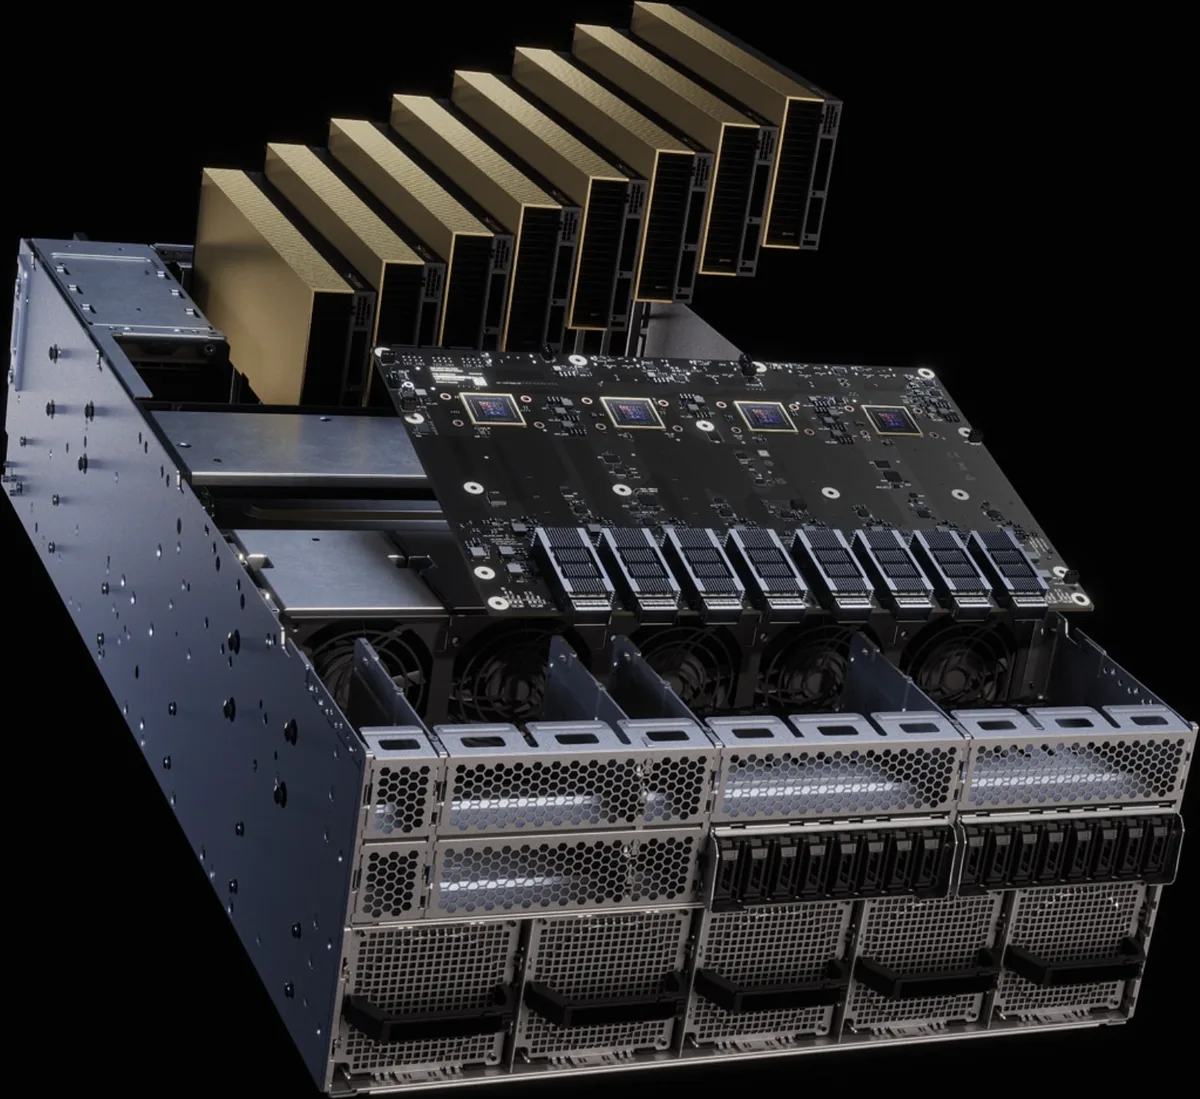
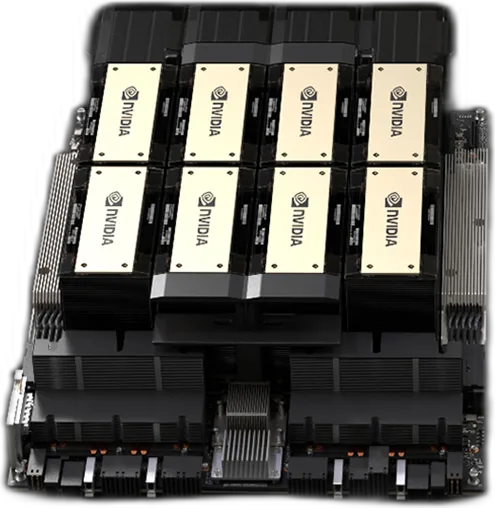
NVIDIA HGX

เบสบอร์ดแปด GPU ภายในเซิร์ฟเวอร์ของพันธมิตร

HGX คือเบสบอร์ด GPU ที่เชื่อมด้วย NVLink ของ NVIDIA ซึ่งผู้ผลิตเซิร์ฟเวอร์นำไปใช้ในระบบของตนเอง ให้คุณได้ GPU ระดับสูงสุดพร้อมเลือกแชสซี CPU และแบรนด์ผู้ให้การสนับสนุนได้เอง

เหมาะกับใคร: องค์กรที่ต้องการ GPU รุ่นเรือธงจากผู้จำหน่ายเซิร์ฟเวอร์ที่ตนเลือก

ประโยชน์

  • เลือกแบรนด์เซิร์ฟเวอร์ CPU และสตอเรจที่เหมาะกับระบบของคุณ
  • NVLink และ NVSwitch เชื่อม GPU ทั้งแปดตัวด้วยความเร็วเต็มที่
  • ครอบคลุมรุ่น Blackwell, Blackwell Ultra และ Rubin

สเปกหลัก

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
แบนด์วิดท์ NVLink14.4 TB/s total (HGX B300 and B200)

สิ่งที่ Workstation ทำให้: เราจัดหาเซิร์ฟเวอร์ HGX จากแบรนด์ที่คุณต้องการ ทดสอบ Burn-in ที่โหลดเต็มในเวิร์กช็อปของเรา และติดตั้งพร้อมระบบเครือข่ายของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

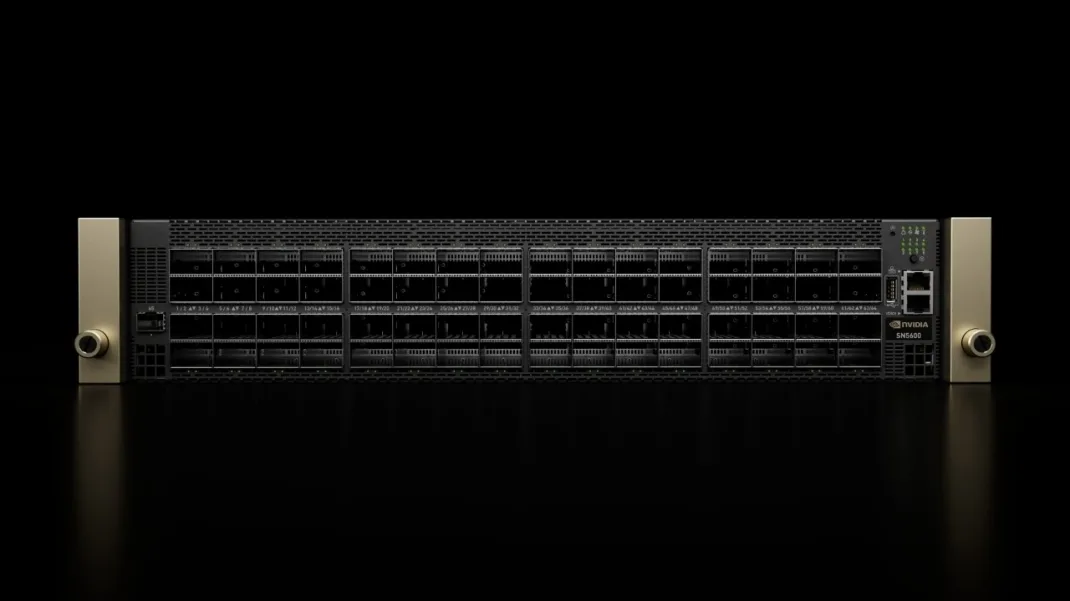
NVIDIA RTX PRO Server

เซิร์ฟเวอร์ Blackwell อเนกประสงค์สำหรับ AI และกราฟิกระดับองค์กร

เซิร์ฟเวอร์ดาต้าเซ็นเตอร์ที่มี RTX PRO 6000 Blackwell Server Edition GPU สูงสุดแปดตัว รัน AI การจำลอง การเรนเดอร์ และเวิร์กสเตชันเสมือนบนแพลตฟอร์มเดียว เป็นเซิร์ฟเวอร์ accelerated กระแสหลักของ NVIDIA และหน้า EGX ของ NVIDIA ก็ชี้มาที่ผลิตภัณฑ์นี้แล้ว

เหมาะกับใคร: องค์กรที่ย้ายเวิร์กโหลดดาต้าเซ็นเตอร์เดิมมาสู่ GPU ควบคู่กับบริการ AI ใหม่

ประโยชน์

  • เซิร์ฟเวอร์ประเภทเดียวสำหรับ AI inference, visual computing และ data science
  • ตัวเลือกระบายความร้อนด้วยอากาศเหมาะกับห้องเซิร์ฟเวอร์เดิมส่วนใหญ่
  • ผ่านการตรวจสอบร่วมกับ NVIDIA AI Enterprise และ Omniverse

สเปกหลัก

GPUUp to 8× RTX PRO 6000 Blackwell Server Edition
หน่วยความจำ GPU800 GB (8-GPU configuration)
แบนด์วิดท์หน่วยความจำ13 TB/s (8-GPU configuration)
กราฟิก RTX3 PFLOPS
การกำหนดค่าMGX 2U, 4U and 6U (6U liquid cooled)

สิ่งที่ Workstation ทำให้: เรากำหนดแชสซีและจำนวน GPU ตามเวิร์กโหลดของคุณ ตรวจสอบว่าเป็น NVIDIA-Certified จากนั้นประกอบ ทดสอบ Burn-in และติดตั้ง

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

NVIDIA DGX SuperPOD

พิมพ์เขียวแบบพร้อมใช้สำหรับ AI factory ขนาดใหญ่

สถาปัตยกรรมอ้างอิงแบบ full-stack ที่รวมระบบ DGX ระบบเครือข่าย NVIDIA สตอเรจที่ผ่านการรับรอง และซอฟต์แวร์บริหารจัดการ ในหน่วยที่ขยายได้และทำซ้ำได้

เหมาะกับใคร: ห้องปฏิบัติการวิจัย องค์กรขนาดใหญ่ และผู้ให้บริการ AI ที่สร้างคลัสเตอร์หลายร้อยหรือหลายพัน GPU

ประโยชน์

  • ดีไซน์ที่ผ่านการทดสอบช่วยลดความเสี่ยงด้านการผสานระบบได้มาก
  • ขยายได้ถึงหลายหมื่น GPU ด้วยหน่วยที่ทำซ้ำได้
  • มาพร้อม Mission Control และ Base Command Manager สำหรับงานปฏิบัติการ

สเปกหลัก

ประเภทReference architecture
บล็อกพื้นฐานScalable units of DGX systems
ขนาดUp to tens of thousands of GPUs
พื้นที่จัดเก็บNVIDIA-certified partner storage
ซอฟต์แวร์NVIDIA AI Enterprise, Base Command Manager, Mission Control

สิ่งที่ Workstation ทำให้: เรานำการออกแบบร่วมกับ NVIDIA และพันธมิตรด้านสตอเรจ บริหารแผนโครงการ ติดตั้งหน่วยที่ขยายได้ และเป็นผู้ติดต่อด้านการสนับสนุนของคุณต่อไป

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

NVIDIA DGX BasePOD

ดีไซน์อ้างอิงสำหรับคลัสเตอร์ DGX แรกของคุณ

ดีไซน์ที่พิสูจน์แล้วสำหรับระบบ DGX ตั้งแต่สองระบบขึ้นไป พร้อมระบบเครือข่าย สตอเรจ และซอฟต์แวร์คลัสเตอร์ที่เข้ากัน: เล็กกว่า SuperPOD แต่สร้างด้วยวิธีเดียวกัน

เหมาะกับใคร: ทีมที่ขยายจากระบบ DGX เดียวไปสู่คลัสเตอร์ขนาดเล็กที่ใช้ร่วมกัน

ประโยชน์

  • เริ่มต้นด้วยสองระบบและเพิ่มได้โดยไม่ต้องออกแบบใหม่
  • ระบบเครือข่ายและสตอเรจที่เข้ากับ GPU
  • มีซอฟต์แวร์คลัสเตอร์สำหรับการจัดตารางงานและการมอนิเตอร์

สเปกหลัก

ประเภทReference architecture
ขนาด2 or more DGX systems
ระบบเครือข่ายPer reference architecture
พื้นที่จัดเก็บPartner storage
ซอฟต์แวร์NVIDIA AI Enterprise, Base Command

สิ่งที่ Workstation ทำให้: เราประเมินขนาดคลัสเตอร์ จัดหาทุกชิ้นส่วน ติดตั้งลงแร็กและเดินสาย และตั้งค่าการจัดตารางงานเพื่อให้ทีมของคุณใช้งานร่วมกันได้ตั้งแต่วันแรก

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

NVIDIA Grace และ Vera CPU

CPU ดาต้าเซ็นเตอร์สถาปัตยกรรม Arm ที่สร้างมาเพื่อ AI factory

CPU ของ NVIDIA เองเชื่อมต่อกับ GPU ผ่าน NVLink-C2C ปัจจุบัน Grace CPU Superchip มีจำหน่ายในเซิร์ฟเวอร์ของพันธมิตร และรุ่นต่อไปคือ Vera มุ่งเป้าไปที่ agentic AI

เหมาะกับใคร: ศูนย์ HPC ผู้สร้างคลาวด์ และผู้ที่รันไปป์ไลน์ที่ใช้ CPU หนักควบคู่กับ GPU

ประโยชน์

  • แบนด์วิดท์หน่วยความจำสูงจาก LPDDR5X
  • ประสิทธิภาพสองเท่าที่กำลังไฟเท่ากันเมื่อเทียบกับ CPU แบบดั้งเดิมชั้นนำ ตามตัวเลขของ NVIDIA
  • การเชื่อมต่อความเร็วสูงแบบ coherent กับ NVIDIA GPU

สเปกหลัก

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
แบนด์วิดท์หน่วยความจำ GraceUp to 1 TB/s LPDDR5X
Vera CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

สิ่งที่ Workstation ทำให้: เราค้นหาเซิร์ฟเวอร์ของพันธมิตรที่เหมาะกับชุดซอฟต์แวร์ของคุณ ทดสอบแอปพลิเคชันบน Arm ร่วมกับคุณ จากนั้นประกอบและสนับสนุนระบบ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

NVIDIA OVX

เซิร์ฟเวอร์ L40S สำหรับ Omniverse และ digital twin

OVX คือดีไซน์เซิร์ฟเวอร์ที่ผ่านการตรวจสอบของ NVIDIA สำหรับ Omniverse ซึ่งรวม L40S GPU กับระบบเครือข่าย ConnectX-7 หรือ BlueField-3 สำหรับการจำลอง การเรนเดอร์ และ AI

เหมาะกับใคร: ผู้ผลิต สถาปนิก และทีมวิศวกรรมที่สร้าง digital twin เชิงอุตสาหกรรม

ประโยชน์

  • เซิร์ฟเวอร์เดียวสำหรับกราฟิก การจำลอง และ AI inference
  • ผ่านการตรวจสอบสำหรับ Omniverse และ NVIDIA AI Enterprise
  • ขยายได้หลายร้อยเซิร์ฟเวอร์บน fabric ความเร็วสูง

สเปกหลัก

GPU4× or 8× NVIDIA L40S
CPU2× Intel Xeon Gold or 2× AMD EPYC
หน่วยความจำโฮสต์384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
พื้นที่จัดเก็บ1 TB NVMe boot, 2× 4 TB NVMe
ระบบเครือข่ายConnectX-7 or BlueField-3

สิ่งที่ Workstation ทำให้: เราประกอบเซิร์ฟเวอร์ตามแบบ OVX จากพันธมิตรที่ผ่านการรับรอง ตั้งค่า Omniverse และไดรเวอร์ และเชื่อมต่อกับเครื่องมือออกแบบของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗
ระบบและแพลตฟอร์ม

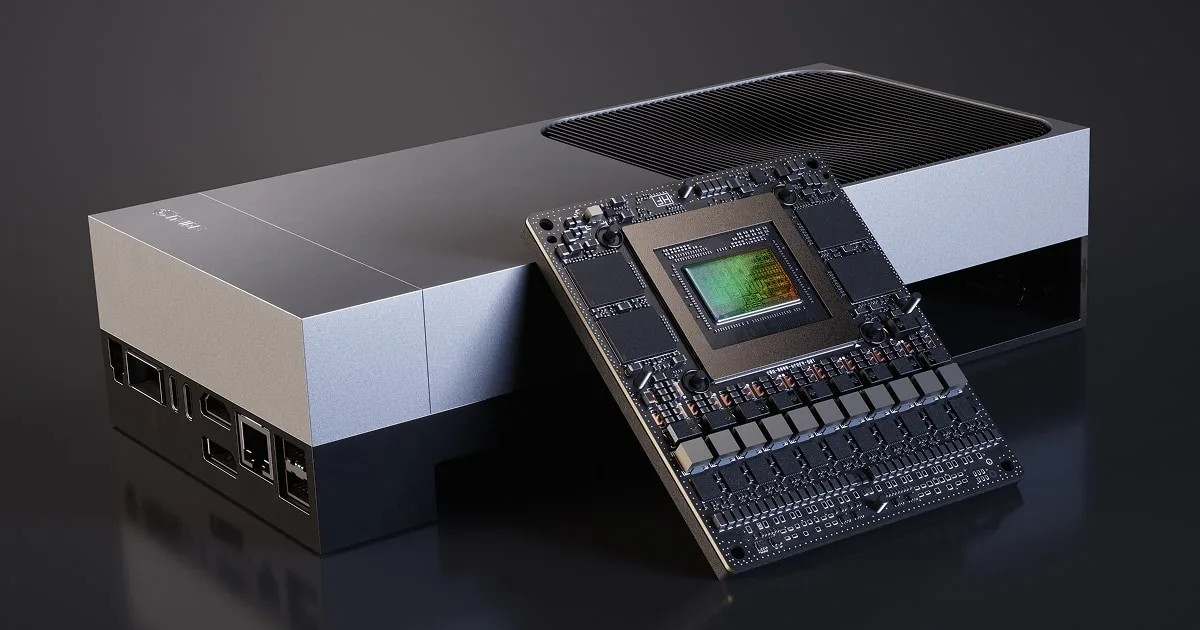
NVIDIA AGX (Jetson AGX Thor)

คอมพิวเตอร์ AI สำหรับหุ่นยนต์และเครื่องจักรอัตโนมัติ

AGX คือแพลตฟอร์มของ NVIDIA สำหรับเครื่องจักรอัตโนมัติ รุ่นเรือธงปัจจุบันคือ Jetson AGX Thor นำ Blackwell GPU มาสู่หุ่นยนต์ ยานยนต์ และเครื่องจักรอัจฉริยะ

เหมาะกับใคร: ทีมด้านหุ่นยนต์ ยานยนต์ และอุตสาหกรรมที่นำ AI ไปใส่ในเครื่องจักร

ประโยชน์

  • รันโมเดล perception และ generative AI บนตัวเครื่องจักรเอง
  • ใช้พลังงานต่ำ เหมาะกับดีไซน์แบบเคลื่อนที่และแบบฝังตัว
  • ใช้ซอฟต์แวร์ CUDA เดียวกับแพลตฟอร์มดาต้าเซ็นเตอร์ของ NVIDIA

สเปกหลัก

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
ประสิทธิภาพ AI2070 TFLOPS (FP4)
ตัวเลือกDeveloper kit, or T5000 and T4000 production modules

สิ่งที่ Workstation ทำให้: เราจัดหา developer kit และโมดูลสำหรับการผลิต ช่วยเลือก carrier board และตัวเครื่อง และสนับสนุนคุณตั้งแต่ต้นแบบจนถึงการใช้งานจริง

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ระบบและแพลตฟอร์ม

NVIDIA IGX Thor

Edge AI เชิงอุตสาหกรรมพร้อม functional safety

IGX คือแพลตฟอร์มระดับองค์กรของ NVIDIA สำหรับ physical AI ที่ edge ด้านอุตสาหกรรมและการแพทย์ มาพร้อม safety island เฉพาะและการสนับสนุนซอฟต์แวร์ระยะยาว

เหมาะกับใคร: ผู้ผลิตอุปกรณ์การแพทย์ โรงงาน และผู้ดำเนินการโครงสร้างพื้นฐานที่ต้องการการรับรองด้านความปลอดภัยและอายุการสนับสนุนที่ยาวนาน

ประโยชน์

  • ดีไซน์ด้าน functional safety ที่มุ่งสู่ ISO 26262 และ IEC 61508
  • การสนับสนุนซอฟต์แวร์ระดับองค์กรจาก NVIDIA สิบปี
  • RTX PRO Blackwell GPU เสริมสำหรับโมเดลที่หนักขึ้น

สเปกหลัก

ประสิทธิภาพ AIUp to 5,581 TFLOPS FP4 (sparse) with discrete GPU
GPU ในตัว2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
หน่วยความจำ128 GB LPDDR5X, 273 GB/s
กำลังไฟ40–130 W, up to 300 W for the discrete GPU

สิ่งที่ Workstation ทำให้: เราจัดหา developer kit และระบบสำหรับการผลิต ช่วยคุณวางแผนหลักฐานสำหรับการรับรอง และสนับสนุนการติดตั้งใช้งาน ณ สถานที่ของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ระบบและแพลตฟอร์ม

NVIDIA Groq 3 LPX

แร็ก inference ความหน่วงต่ำสำหรับ Vera Rubin

LPX คือแร็กของตัวเร่ง inference แบบ LPU 256 ตัวที่ทำงานร่วมกับ Vera Rubin NVL72 เพื่อสร้างโทเคนได้รวดเร็วและคาดการณ์ได้สำหรับ AI แบบโต้ตอบและ agentic AI

เหมาะกับใคร: ผู้ให้บริการ AI ที่ผู้ใช้ต้องการเวลาตอบสนองที่รวดเร็วและสม่ำเสมอ

ประโยชน์

  • การสร้างโทเคนแบบ deterministic และความหน่วงต่ำ
  • ปริมาณงานต่อเมกะวัตต์สูงขึ้นมากสำหรับโมเดลระดับล้านล้านพารามิเตอร์ ตามการคาดการณ์ของ NVIDIA
  • การเชื่อมต่อโดยตรงความหน่วงต่ำกับแร็ก NVL72

สเปกหลัก

ตัวเร่ง256 LPUs per rack
หน่วยความจำบนชิป128 GB SRAM per rack (500 MB per LPU)
แบนด์วิดท์ SRAM40 PB/s per rack
แบนด์วิดท์ scale-up640 TB/s per rack
ฟอร์มแฟกเตอร์NVIDIA MGX ETL rack

สิ่งที่ Workstation ทำให้: เราประเมินว่าระบบนี้เข้ากับแผน Vera Rubin ของคุณอย่างไร ยืนยันความพร้อมจำหน่ายกับ NVIDIA และวางแผนการติดตั้งควบคู่กับแร็กอื่นๆ ของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

GPU สำหรับดาต้าเซ็นเตอร์

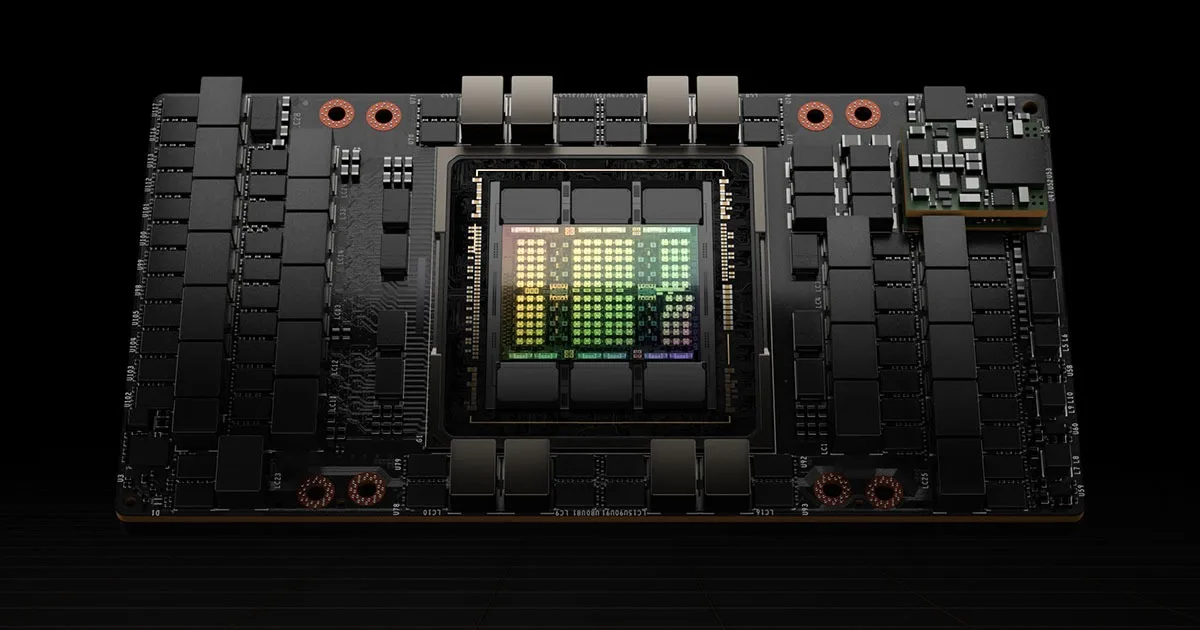
NVIDIA H200 (SXM)

Hopper GPU พร้อม HBM3e 141 GB

H200 ยังคงใช้สถาปัตยกรรม Hopper แต่เพิ่มหน่วยความจำที่มากขึ้นและเร็วขึ้นอย่างมาก ช่วยงาน inference โมเดลขนาดใหญ่และ HPC ที่ติดขีดจำกัดหน่วยความจำ รุ่น SXM ใช้ในเซิร์ฟเวอร์ HGX

เหมาะกับใคร: ทีมที่รันโมเดลภาษาขนาดใหญ่และโค้ด HPC บนเซิร์ฟเวอร์ HGX

ประโยชน์

  • 141 GB ต่อ GPU รองรับโมเดลที่ใหญ่ขึ้นโดยไม่ต้องแบ่ง
  • แบนด์วิดท์หน่วยความจำที่สูงขึ้นเร่งงานที่ติดขีดจำกัดหน่วยความจำ
  • รันซอฟต์แวร์ CUDA เดียวกับ H100

สเปกหลัก

สถาปัตยกรรมNVIDIA Hopper
หน่วยความจำ GPU141 GB HBM3e
ฟอร์มแฟกเตอร์SXM (HGX)
ระบายความร้อนPassive (server airflow)

สิ่งที่ Workstation ทำให้: เราจัดหา H200 ในเซิร์ฟเวอร์ HGX ที่ผ่านการรับรอง ทดสอบ Burn-in และติดตั้งพร้อมไดรเวอร์และชุดซอฟต์แวร์ของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

GPU สำหรับดาต้าเซ็นเตอร์

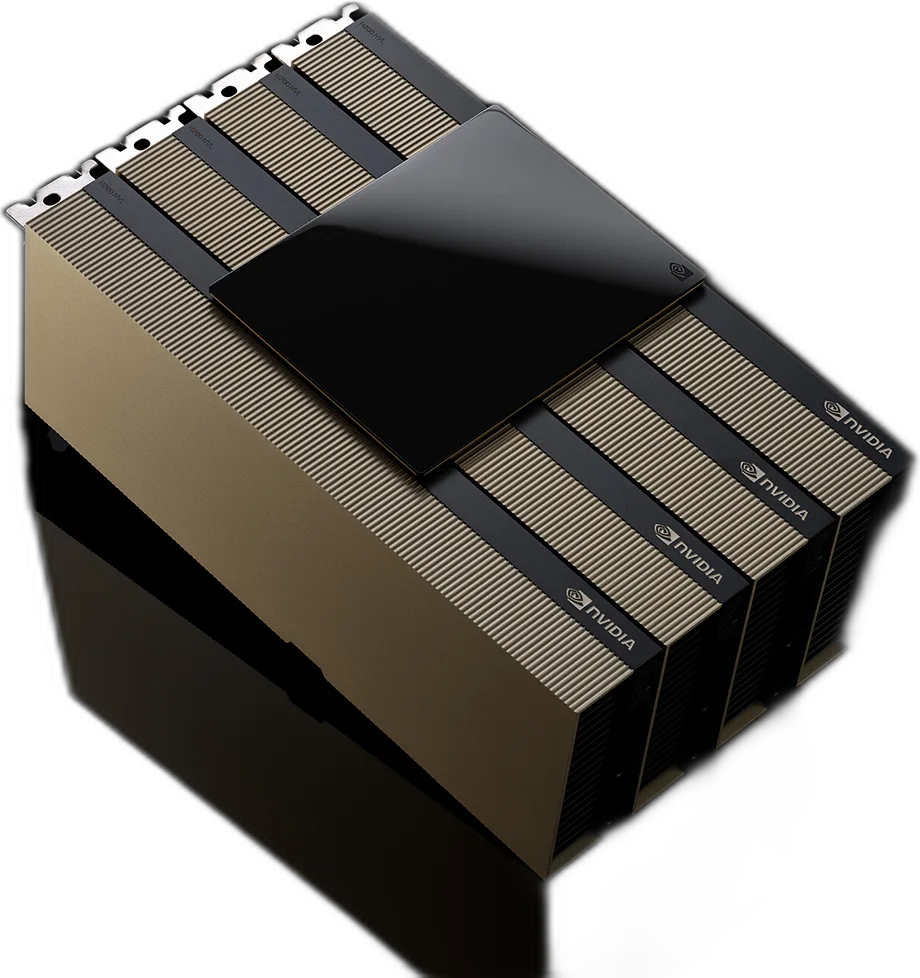
NVIDIA H200 NVL

Hopper GPU 141 GB สำหรับเซิร์ฟเวอร์ PCIe ระบายความร้อนด้วยอากาศ

H200 รุ่น PCIe สำหรับแร็กองค์กรมาตรฐาน NVLink bridge สามารถจับคู่การ์ดสำหรับโมเดลที่ต้องการหน่วยความจำมากขึ้น

เหมาะกับใคร: องค์กรที่เพิ่ม inference โมเดลขนาดใหญ่ในห้องเซิร์ฟเวอร์ระบายความร้อนด้วยอากาศเดิม

ประโยชน์

  • หน่วยความจำ GPU ขนาดใหญ่โดยไม่ต้องเปลี่ยนไปใช้การระบายความร้อนด้วยของเหลว
  • NVLink bridge เชื่อม GPU เข้าด้วยกันสำหรับโมเดลที่ใหญ่ขึ้น
  • ใช้ได้กับเซิร์ฟเวอร์ NVIDIA-Certified กระแสหลัก

สเปกหลัก

สถาปัตยกรรมNVIDIA Hopper
หน่วยความจำ GPU141 GB HBM3e
ฟอร์มแฟกเตอร์PCIe, dual slot
ระบายความร้อนPassive (server airflow)

สิ่งที่ Workstation ทำให้: เราตรวจสอบแชสซีของคุณด้านพลังงาน การไหลเวียนอากาศ และการจัดวางสล็อต จากนั้นติดตั้ง ทดสอบ และจัดส่งการ์ดหรือเซิร์ฟเวอร์ครบชุด

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

GPU สำหรับดาต้าเซ็นเตอร์

NVIDIA H100 PCIe 80 GB

Hopper GPU สำหรับการเทรนและ inference ในเซิร์ฟเวอร์ PCIe

H100 รุ่น PCIe นำ Transformer Engine และ confidential computing ของ Hopper มาสู่เซิร์ฟเวอร์มาตรฐาน

เหมาะกับใคร: ทีมที่มีเซิร์ฟเวอร์ GPU แบบ PCIe อยู่แล้วและต้องการประสิทธิภาพ Hopper ที่พิสูจน์แล้ว

ประโยชน์

  • Transformer Engine เร่งการเทรนและ inference ของโมเดลภาษา
  • Multi-Instance GPU แบ่งการ์ดหนึ่งใบเป็นอินสแตนซ์ที่แยกจากกัน
  • ฮาร์ดแวร์รองรับ confidential computing

สเปกหลัก

สถาปัตยกรรมNVIDIA Hopper
หน่วยความจำ GPU80 GB HBM2e
ฟอร์มแฟกเตอร์Dual-slot, full height, full length
ระบายความร้อนPassive (server airflow)
อินเทอร์เฟซPCIe

สิ่งที่ Workstation ทำให้: เราติดตั้ง H100 ในเซิร์ฟเวอร์ที่ได้รับการรับรอง ทดสอบ Burn-in และตั้งค่า CUDA ไดรเวอร์ และไลเซนส์ vGPU หรือ AI Enterprise ที่ต้องใช้

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

GPU สำหรับดาต้าเซ็นเตอร์

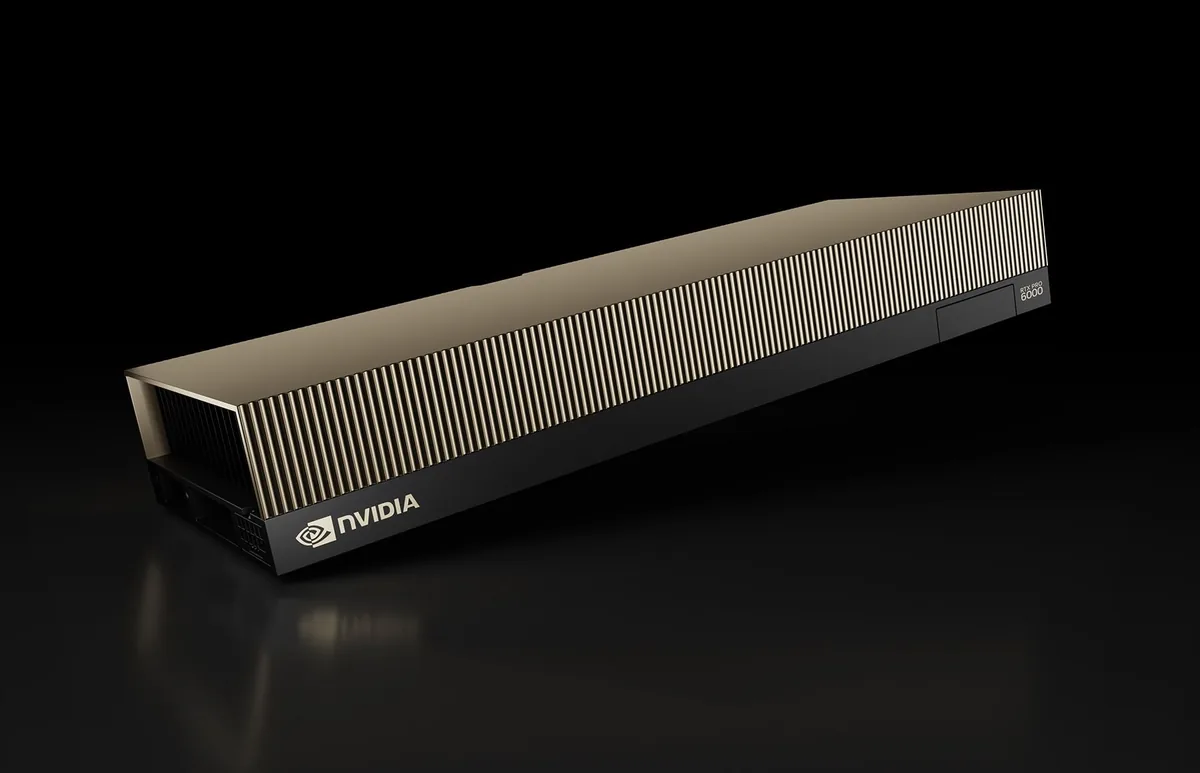
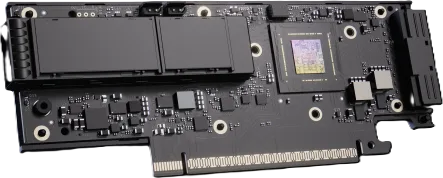
NVIDIA RTX PRO 6000 Blackwell Server Edition

Blackwell GPU 96 GB สำหรับเซิร์ฟเวอร์แบบแร็ก

การ์ด Blackwell ระบายความร้อนแบบพาสซีฟพร้อมหน่วยความจำ 96 GB สำหรับ AI inference การเรนเดอร์ การจำลอง และเวิร์กสเตชันเสมือนในดาต้าเซ็นเตอร์

เหมาะกับใคร: องค์กรที่รวมเวิร์กโหลด AI และกราฟิกไว้บน GPU ประเภทเดียว

ประโยชน์

  • 96 GB ต่อ GPU รองรับโมเดลขนาดใหญ่และฉากขนาดใหญ่
  • รันได้ทั้ง AI และกราฟิกระดับมืออาชีพ
  • ปรับกำลังไฟได้ให้เหมาะกับเซิร์ฟเวอร์

สเปกหลัก

สถาปัตยกรรมNVIDIA Blackwell
หน่วยความจำ GPU96 GB GDDR7 with ECC
กำลังไฟสูงสุดUp to 600 W (configurable)
อินเทอร์เฟซPCIe 5.0 x16
ฟอร์มแฟกเตอร์Dual-slot, passive (server airflow)

สิ่งที่ Workstation ทำให้: เราจัดหาการ์ดแบบแยกหรือใน RTX PRO Server และทดสอบที่โหลดเต็มก่อนจัดส่ง

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

GPU สำหรับดาต้าเซ็นเตอร์

NVIDIA RTX PRO 4500 Blackwell Server Edition

Blackwell GPU แบบสล็อตเดียวสำหรับเซิร์ฟเวอร์ความหนาแน่นสูง

Blackwell GPU 32 GB ขนาดกะทัดรัด ระบายความร้อนแบบพาสซีฟ ช่วยให้ใส่การ์ดได้หลายใบในเซิร์ฟเวอร์เดียวสำหรับ inference วิดีโอ และเดสก์ท็อปเสมือน

เหมาะกับใคร: ทีมที่ขยาย inference หรือเดสก์ท็อปเสมือนให้ผู้ใช้จำนวนมากด้วยต้นทุนต่อ GPU ที่ต่ำกว่า

ประโยชน์

  • ดีไซน์สล็อตเดียวใส่ GPU ได้มากขึ้นต่อเซิร์ฟเวอร์
  • GDDR7 32 GB สำหรับโมเดลขนาดกลาง
  • กำลังไฟต่ำกว่า เหมาะกับแร็กเดิม

สเปกหลัก

สถาปัตยกรรมNVIDIA Blackwell
หน่วยความจำ GPU32 GB GDDR7
ฟอร์มแฟกเตอร์Single slot, 4.4" H × 10.5" L
ระบายความร้อนPassive (server airflow)

สิ่งที่ Workstation ทำให้: เราคำนวณว่าเซิร์ฟเวอร์ของคุณจ่ายไฟและระบายความร้อนให้การ์ดได้กี่ใบ จากนั้นประกอบและทดสอบการกำหนดค่า

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

GPU สำหรับดาต้าเซ็นเตอร์

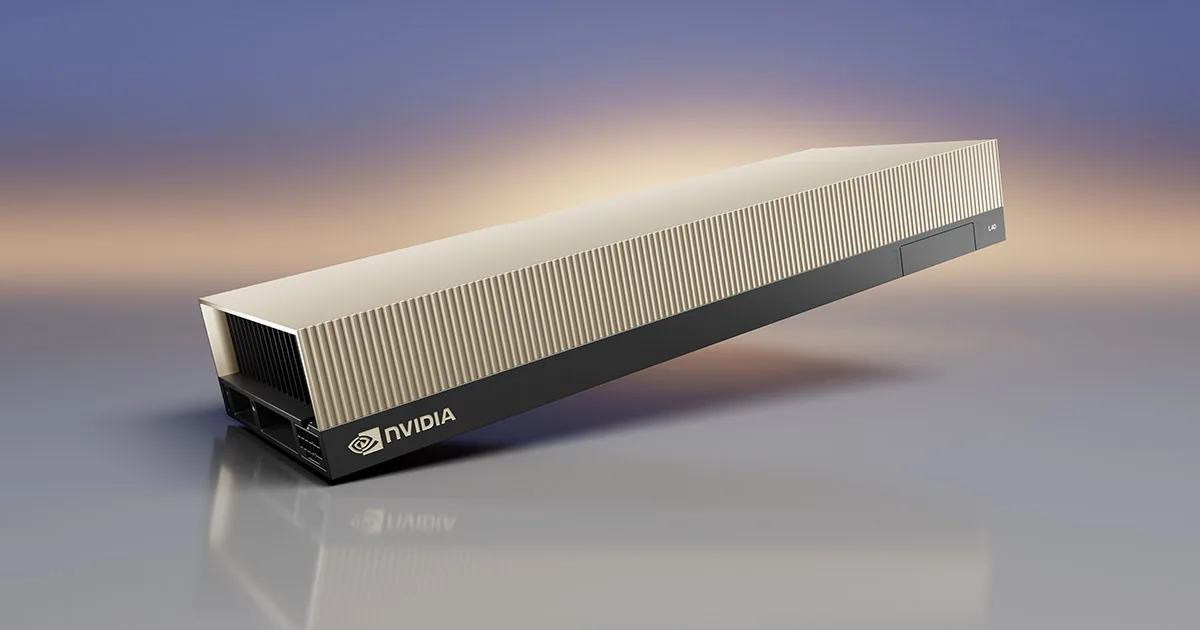
NVIDIA L40S

GPU อเนกประสงค์ 48 GB สำหรับ AI และกราฟิก

GPU ดาต้าเซ็นเตอร์ Ada Lovelace ที่สมดุลสำหรับ inference การ fine-tune และกราฟิก 3D และเป็น GPU ภายในดีไซน์ OVX ของ NVIDIA

เหมาะกับใคร: ทีมที่ต้องการ GPU ตัวเดียวสำหรับทั้งงาน AI และงานภาพ

ประโยชน์

  • ประสิทธิภาพ inference และ fine-tune ที่แข็งแกร่งเมื่อเทียบกับต้นทุน
  • Ray tracing ระดับฮาร์ดแวร์สำหรับการเรนเดอร์และ Omniverse
  • การ์ด PCIe มาตรฐานสำหรับเซิร์ฟเวอร์กระแสหลัก

สเปกหลัก

สถาปัตยกรรมNVIDIA Ada Lovelace
หน่วยความจำ GPU48 GB GDDR6 with ECC
ฟอร์มแฟกเตอร์Dual-slot, 4.4" H × 10.5" L
ระบายความร้อนPassive (server airflow)
อินเทอร์เฟซPCIe

สิ่งที่ Workstation ทำให้: เราจับคู่ L40S กับเซิร์ฟเวอร์ที่ผ่านการรับรอง ทดสอบ Burn-in และติดตั้งพร้อมตั้งค่าไดรเวอร์และไลเซนส์

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

GPU สำหรับดาต้าเซ็นเตอร์

NVIDIA L40

GPU 48 GB สำหรับการเรนเดอร์และเวิร์กสเตชันเสมือน

L40 เน้นงานกราฟิก: การเรนเดอร์ Omniverse และเวิร์กสเตชันเสมือนในดาต้าเซ็นเตอร์

เหมาะกับใคร: ทีมออกแบบและสื่อที่ย้ายเวิร์กสเตชันเข้าสู่ดาต้าเซ็นเตอร์

ประโยชน์

  • 48 GB สำหรับฉากและแอสเซ็ตขนาดใหญ่
  • รองรับซอฟต์แวร์ NVIDIA virtual GPU
  • ระบายความร้อนแบบพาสซีฟสำหรับเซิร์ฟเวอร์มาตรฐาน

สเปกหลัก

สถาปัตยกรรมNVIDIA Ada Lovelace
หน่วยความจำ GPU48 GB GDDR6 with ECC
ฟอร์มแฟกเตอร์Dual-slot, 4.4" H × 10.5" L
ระบายความร้อนPassive (server airflow)
อินเทอร์เฟซPCIe

สิ่งที่ Workstation ทำให้: เราตั้งค่าโปรไฟล์ vGPU และไลเซนส์เพื่อให้ผู้ใช้ได้เวิร์กสเตชันระยะไกลที่ใช้งานได้เหมือนเครื่องในพื้นที่

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

GPU สำหรับดาต้าเซ็นเตอร์

NVIDIA L4

GPU แบบ low-profile สำหรับ inference และวิดีโอที่มีประสิทธิภาพ

การ์ด Ada Lovelace ขนาดเล็กกำลังไฟต่ำสำหรับ video AI, inference และเดสก์ท็อปเสมือน ตั้งแต่ edge ไปจนถึงดาต้าเซ็นเตอร์

เหมาะกับใคร: องค์กรที่เพิ่ม AI ให้กับเซิร์ฟเวอร์จำนวนมาก หรือไซต์ edge ที่มีงบพลังงานจำกัด

ประโยชน์

  • กำลังไฟต่ำและการ์ดแบบ low-profile ใส่ได้กับเซิร์ฟเวอร์แทบทุกรุ่น
  • เหมาะอย่างยิ่งกับ video analytics และ inference
  • ขยายได้อย่างคุ้มค่าในหลายโหนด

สเปกหลัก

สถาปัตยกรรมNVIDIA Ada Lovelace
หน่วยความจำ GPU24 GB GDDR6
ฟอร์มแฟกเตอร์Single-slot, low profile
ระบายความร้อนPassive (server airflow)
อินเทอร์เฟซPCIe

สิ่งที่ Workstation ทำให้: เราตรวจสอบความเข้ากันได้กับเซิร์ฟเวอร์เดิมของคุณ จัดหาการ์ด และตั้งค่าไดรเวอร์และซอฟต์แวร์ inference

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ระบบเครือข่าย

แพลตฟอร์ม NVIDIA Spectrum-X Ethernet

Ethernet ที่ปรับแต่งสำหรับ AI factory

Spectrum-X จับคู่สวิตช์ Spectrum Ethernet กับ Spectrum-X SuperNIC เพื่อให้คลัสเตอร์ AI ได้ Ethernet ที่คาดการณ์ได้และมีปริมาณงานสูง

เหมาะกับใคร: องค์กรที่ต้องการ AI fabric ที่ทีมเครือข่ายรู้วิธีดูแลอยู่แล้ว

ประโยชน์

  • แบนด์วิดท์ที่ใช้ได้จริงสำหรับทราฟฟิก GPU-to-GPU สูงกว่า Ethernet มาตรฐาน
  • ใช้เครื่องมือและทักษะ Ethernet ที่คุ้นเคย
  • เป็นส่วนหนึ่งของดีไซน์ AI factory ที่ผ่านการตรวจสอบของ NVIDIA

สเปกหลัก

ประเภทEthernet networking platform
ส่วนประกอบNVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
กรณีการใช้งานAI clusters and AI factories

สิ่งที่ Workstation ทำให้: เราออกแบบ fabric จัดหาสวิตช์ SuperNIC และสายเคเบิล ติดตั้งและทดสอบ และจัดทำเอกสารให้ทีมของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ระบบเครือข่าย

แพลตฟอร์ม NVIDIA Quantum-X800 InfiniBand

InfiniBand ยุคใหม่สำหรับการเทรนขนาดใหญ่

สวิตช์ Quantum-X800 และ ConnectX-8 SuperNIC ประกอบกันเป็น InfiniBand fabric ประสิทธิภาพสูงสุดของ NVIDIA สำหรับการเทรน AI และ HPC

เหมาะกับใคร: ศูนย์ HPC และทีม AI ที่เทรนในระดับขนาดใหญ่

ประโยชน์

  • ความหน่วงต่ำมากสำหรับงานที่เชื่อมโยงกันแน่นหนา
  • ออกแบบมาสำหรับคลัสเตอร์การเทรนและ HPC ที่ใหญ่ที่สุด
  • บริหารจัดการและมอนิเตอร์ด้วย UFM

สเปกหลัก

ประเภทInfiniBand networking platform
ส่วนประกอบNVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
กรณีการใช้งานLarge-scale AI training and HPC

สิ่งที่ Workstation ทำให้: เราออกแบบโทโพโลยี จัดหาและเดินสายทุกลิงก์ และเปิดใช้งาน fabric พร้อมระบบมอนิเตอร์ UFM

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ระบบเครือข่าย

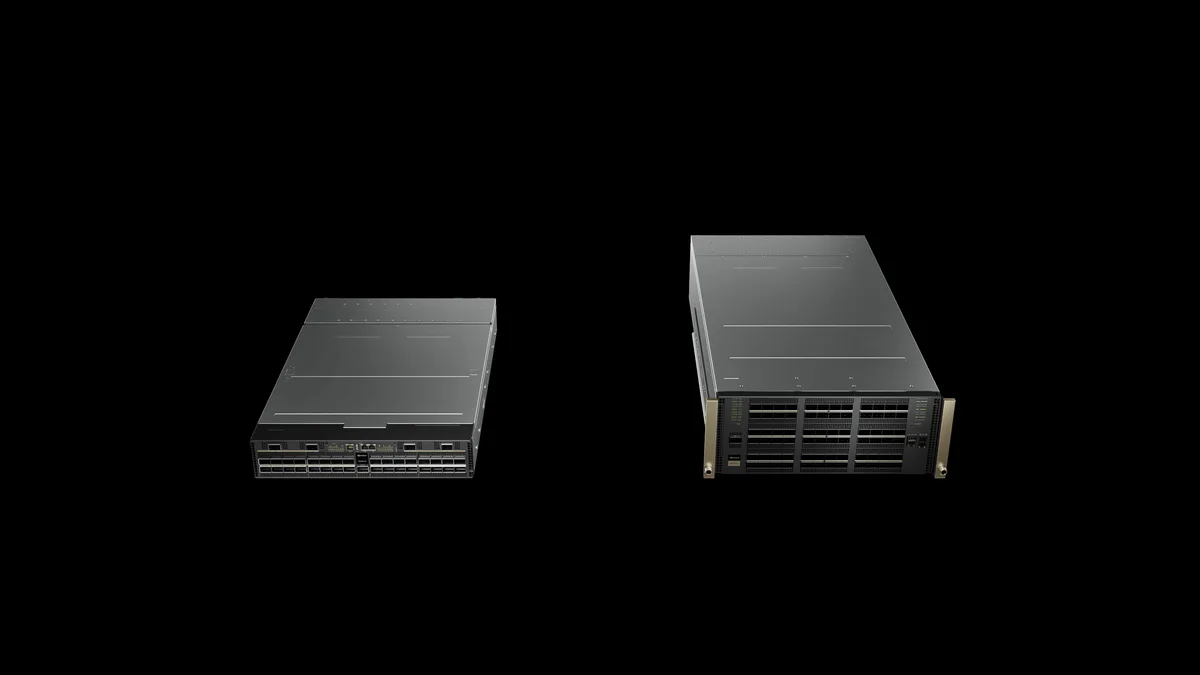
สวิตช์ NVIDIA Spectrum Ethernet

สวิตช์ Ethernet สำหรับดาต้าเซ็นเตอร์ความเร็วสูงสุด 800 Gb/s

สวิตช์ Spectrum รองรับทราฟฟิก AI สตอเรจ และคลาวด์ ทั้งแบบแยกหรือเป็นส่วนหนึ่งของ Spectrum-X

เหมาะกับใคร: ทีมดาต้าเซ็นเตอร์และเครือข่ายที่ปรับปรุงสวิตช์ leaf และ spine

ประโยชน์

  • ความเร็วพอร์ตสูงสุด 800 Gb/s
  • ใช้ได้ทั้งใน AI fabric และเครือข่ายดาต้าเซ็นเตอร์ทั่วไป
  • ใช้คู่กับ NetQ สำหรับงานปฏิบัติการเครือข่ายและ telemetry

สเปกหลัก

ประเภทEthernet switch family
ความเร็วพอร์ตUp to 800 Gb/s
การใช้งานAI and cloud data-centre fabrics

สิ่งที่ Workstation ทำให้: เราประเมินจำนวนพอร์ตและออปติก กำหนดค่าสวิตช์ และผสานรวมกับเครือข่ายเดิมของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ระบบเครือข่าย

สวิตช์ NVIDIA Quantum InfiniBand

การสวิตช์ความหน่วงต่ำสำหรับ HPC และ AI

สวิตช์ Quantum InfiniBand สร้าง fabric ความหน่วงต่ำที่คลัสเตอร์ HPC และ AI พึ่งพา

เหมาะกับใคร: ทีมคอมพิวติ้งเพื่อการวิจัยและทีม AI ที่มีเวิร์กโหลดเชื่อมโยงกันแน่นหนา

ประโยชน์

  • ความหน่วงต่ำมากระหว่างโหนด
  • พิสูจน์แล้วในคลัสเตอร์ HPC และ AI
  • บริหารจัดการจากส่วนกลางด้วย UFM

สเปกหลัก

ประเภทInfiniBand switch family
การใช้งานHPC and AI data centres

สิ่งที่ Workstation ทำให้: เราวางแผนโทโพโลยี จัดหาสายเคเบิลและออปติก และติดตั้งพร้อมตรวจสอบ fabric

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ระบบเครือข่าย

NVIDIA ConnectX NIC และ SuperNIC

อะแดปเตอร์เครือข่ายสำหรับ Ethernet และ InfiniBand

อะแดปเตอร์ ConnectX เชื่อมเซิร์ฟเวอร์เข้ากับ fabric ส่วน SuperNIC เช่น ConnectX-8 ได้รับการปรับแต่งสำหรับทราฟฟิก GPU-to-GPU ในคลัสเตอร์ AI

เหมาะกับใคร: ผู้ที่เชื่อมต่อเซิร์ฟเวอร์ GPU หรือสตอเรจเข้ากับเครือข่ายความเร็วสูง

ประโยชน์

  • ตระกูลเดียวครอบคลุมทั้ง Ethernet และ InfiniBand
  • SuperNIC ให้ GPU แต่ละตัวมีเส้นทางความเร็วสูงของตัวเอง
  • การ offload ด้วยฮาร์ดแวร์ช่วยลดภาระ CPU

สเปกหลัก

ประเภทNetwork adapter and SuperNIC family
FabricEthernet and InfiniBand
ความเร็วสูงสุด800 Gb/s per GPU (ConnectX-8 SuperNIC)

สิ่งที่ Workstation ทำให้: เราจับคู่อะแดปเตอร์ สายเคเบิล และทรานซีฟเวอร์ให้เข้ากับสวิตช์และเซิร์ฟเวอร์ของคุณ และติดตั้งเฟิร์มแวร์และไดรเวอร์

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ระบบเครือข่าย

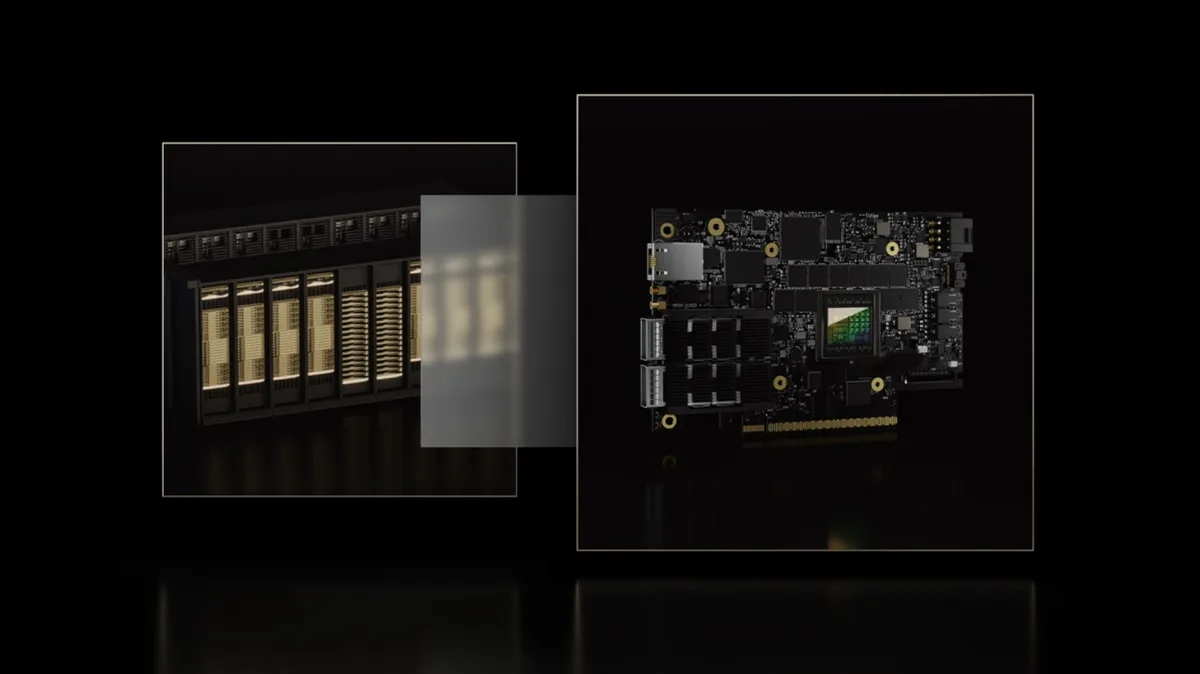
NVIDIA BlueField DPU

หน่วยประมวลผลข้อมูลสำหรับเครือข่าย สตอเรจ และความปลอดภัย

BlueField DPU รับภาระงานด้านเครือข่าย สตอเรจ และความปลอดภัยแทน CPU ของเซิร์ฟเวอร์ และแยกงานเหล่านั้นไว้ในฮาร์ดแวร์เฉพาะ

เหมาะกับใคร: ผู้สร้างคลาวด์ AI factory และองค์กรที่ให้ความสำคัญกับความปลอดภัย

ประโยชน์

  • คืนคอร์ CPU ให้แอปพลิเคชัน
  • แยกบริการโครงสร้างพื้นฐานออกจากเวิร์กโหลดของผู้เช่า
  • เขียนโปรแกรมได้ด้วย NVIDIA DOCA

สเปกหลัก

ประเภทData processing unit (DPU) family
รุ่นBlueField-3, BlueField-4
ซอฟต์แวร์NVIDIA DOCA

สิ่งที่ Workstation ทำให้: เราจัดหาและติดตั้งการ์ด BlueField และช่วยคุณใช้งานบริการ DOCA ที่ต้องการ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ซอฟต์แวร์

NVIDIA AI Enterprise

ซอฟต์แวร์ที่ได้รับการสนับสนุนสำหรับ AI ในการใช้งานจริง

ชุดเฟรมเวิร์ก AI, NIM microservices และเครื่องมือของ NVIDIA พร้อมการสนับสนุนระดับองค์กรและ release branch อายุยาว

เหมาะกับใคร: องค์กรใดก็ตามที่รัน AI ในการใช้งานจริงบน NVIDIA GPU

ประโยชน์

  • การสนับสนุนระดับองค์กรและ release branch ที่เสถียร
  • NIM microservices ทำให้ติดตั้งใช้งานโมเดลได้เร็วขึ้น
  • รันบนระบบ NVIDIA-Certified ทั้งภายในองค์กรหรือบนคลาวด์

สเปกหลัก

การให้สิทธิ์ใช้งานPer GPU subscription
ประกอบด้วยAI frameworks, NIM microservices, pretrained models
การสนับสนุนNVIDIA Enterprise Business Standard Support
ทดลองใช้90-day evaluation

สิ่งที่ Workstation ทำให้: เราเสนอราคาและเปิดใช้งานไลเซนส์ ติดตั้งซอฟต์แวร์พร้อมฮาร์ดแวร์ของคุณ และแจ้งเตือนก่อนถึงกำหนดต่ออายุ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ซอฟต์แวร์

NVIDIA Mission Control

ซอฟต์แวร์ปฏิบัติการสำหรับ AI factory

Mission Control ทำให้งานประจำวันของคลัสเตอร์ GPU ขนาดใหญ่เป็นอัตโนมัติ ตั้งแต่การ orchestrate เวิร์กโหลดไปจนถึงการตรวจสุขภาพระบบและการกู้คืน

เหมาะกับใคร: ผู้ดูแล DGX SuperPOD และคลัสเตอร์ AI ขนาดใหญ่อื่นๆ

ประโยชน์

  • ทำให้งานปฏิบัติการคลัสเตอร์ตามปกติเป็นอัตโนมัติ
  • เพิ่มความยืดหยุ่นด้วยการตรวจจับและกู้คืนจากความผิดพลาด
  • มุมมองเดียวของเวิร์กโหลดและโครงสร้างพื้นฐาน

สเปกหลัก

ประเภทAI-factory operations and cluster management software
ฟังก์ชันWorkload orchestration, infrastructure resiliency, cluster automation
รูปแบบไลเซนส์Confirmed on quote

สิ่งที่ Workstation ทำให้: เราติดตั้ง Mission Control พร้อมคลัสเตอร์ของคุณและฝึกอบรมผู้ดูแลระบบให้ใช้งาน

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ซอฟต์แวร์

NVIDIA Run:ai

การ orchestrate และจัดตารางงาน GPU

Run:ai รวม GPU จากหลายทีมเป็นพูลและจัดสรรตามความต้องการ เพื่อให้ฮาร์ดแวร์ราคาแพงถูกใช้งานอยู่เสมอแทนที่จะว่าง

เหมาะกับใคร: องค์กรที่ใช้ GPU ร่วมกันระหว่างนักวิทยาศาสตร์ข้อมูลหรือโครงการจำนวนมาก

ประโยชน์

  • อัตราการใช้งาน GPU สูงขึ้นด้วยการจัดพูลแบบไดนามิก
  • โควตา ลำดับความสำคัญ และการควบคุมสิทธิ์เข้าถึงเพื่อการแบ่งปันอย่างเป็นธรรม
  • ใช้งานได้ทั้งภายในองค์กร ไฮบริด และคลาวด์

สเปกหลัก

ประเภทGPU orchestration and scheduling platform
รันบนKubernetes
การติดตั้งใช้งานOn premises, hybrid or cloud
รูปแบบไลเซนส์Confirmed on quote

สิ่งที่ Workstation ทำให้: เราติดตั้ง Run:ai บนคลัสเตอร์ Kubernetes ของคุณ ตั้งค่าโควตาร่วมกับทีมของคุณ และให้การสนับสนุน

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ซอฟต์แวร์

NVIDIA Base Command Manager

การจัดเตรียมและมอนิเตอร์คลัสเตอร์

Base Command Manager จัดเตรียม มอนิเตอร์ และบริหารจัดการคลัสเตอร์ GPU ตั้งแต่ไม่กี่โหนดขึ้นไป

เหมาะกับใคร: ทีมไอทีที่ดูแลคลัสเตอร์ GPU ทุกขนาด

ประโยชน์

  • จัดเตรียมระบบอัตโนมัติบน Arm และ x86
  • แดชบอร์ดสุขภาพระบบและการมอนิเตอร์แบบเรียลไทม์
  • เว็บอินเทอร์เฟซ command line และ API

สเปกหลัก

ประเภทCluster management software
ไลเซนส์ฟรีUp to 8 accelerators per system
รุ่นปัจจุบันBase Command Manager 11
อินเทอร์เฟซBaseView web UI, CLI, API

สิ่งที่ Workstation ทำให้: เราติดตั้งและกำหนดค่า Base Command Manager เป็นส่วนหนึ่งของคลัสเตอร์ที่เราสร้าง

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ซอฟต์แวร์

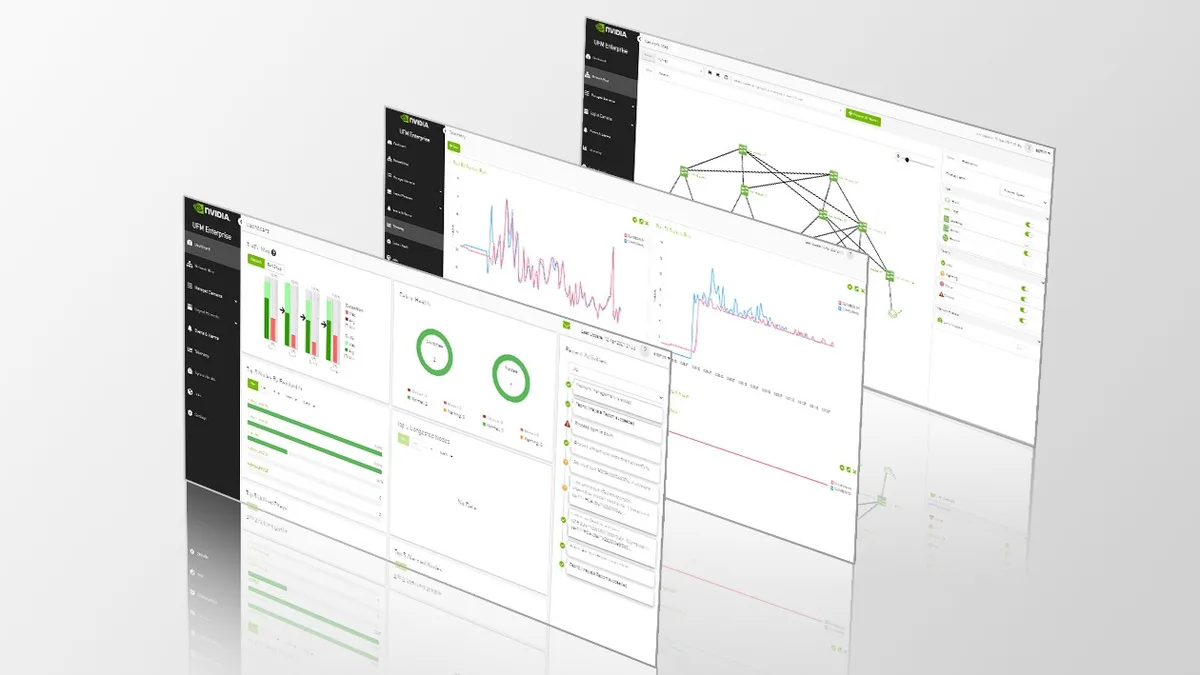
NVIDIA UFM

Unified Fabric Manager สำหรับ InfiniBand

UFM มอนิเตอร์ บริหารจัดการ และช่วยแก้ไขปัญหา InfiniBand fabric

เหมาะกับใคร: ทีมที่ดูแลคลัสเตอร์ InfiniBand

ประโยชน์

  • Telemetry ของ fabric แบบเรียลไทม์
  • ค้นหาจุดผิดพลาดได้เร็วขึ้น
  • บริหารจัดการสวิตช์และลิงก์จากส่วนกลาง

สเปกหลัก

ประเภทInfiniBand fabric management and telemetry software
ใช้งานร่วมกับNVIDIA Quantum InfiniBand switches

สิ่งที่ Workstation ทำให้: เราติดตั้ง UFM พร้อม fabric ของคุณ และตั้งค่าการแจ้งเตือนให้สอดคล้องกับขั้นตอนการปฏิบัติงานของคุณ

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

ซอฟต์แวร์

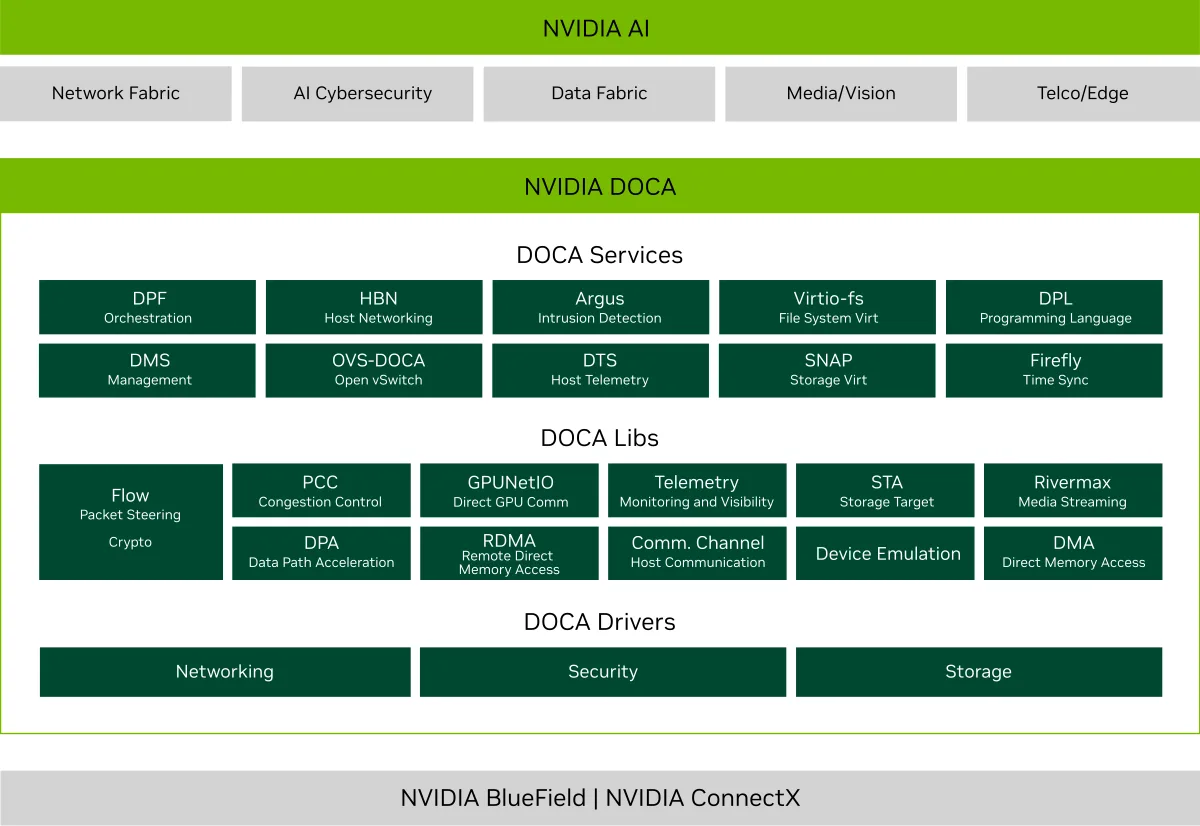
NVIDIA DOCA

เฟรมเวิร์กซอฟต์แวร์สำหรับ BlueField และ SuperNIC

DOCA คือ SDK และ runtime สำหรับสร้างบริการที่รันบน BlueField DPU และ SuperNIC

เหมาะกับใคร: นักพัฒนาและทีมแพลตฟอร์มที่พัฒนาบน BlueField

ประโยชน์

  • เฟรมเวิร์กเดียวครอบคลุม DPU และ SuperNIC ทุกรุ่น
  • เร่งการพัฒนาบริการแบบ offload
  • Runtime สำหรับติดตั้งใช้งานบริการเหล่านั้นในการใช้งานจริง

สเปกหลัก

ประเภทSDK and runtime framework
รันบนNVIDIA BlueField DPUs and SuperNICs

สิ่งที่ Workstation ทำให้: เราช่วยตั้งค่าสภาพแวดล้อม DOCA และติดตั้งบริการบนการ์ด BlueField ที่เราจัดหา

ราคาตามใบเสนอราคาขอใบเสนอราคา ↗
ดูบน NVIDIA.com ↗

สเปกสรุปจากข้อมูลที่ NVIDIA เผยแพร่และอาจเปลี่ยนแปลงได้ในแต่ละรุ่นปรับปรุง ตัวเลขที่ระบุว่า sparse คำนวณโดยใช้ sparsity เรายืนยันการกำหนดค่า ราคา และระยะเวลาจัดส่งที่แน่นอนในทุกใบเสนอราคา

สิ่งที่ Workstation ทำในทุกคำสั่งซื้อ

ห้าขั้นตอนเดียวกัน ไม่ว่าคุณจะซื้อ GPU ตัวเดียวหรือแร็กทั้งแถว

การประเมินขนาด

เราเริ่มจากโมเดล ข้อมูล ผู้ใช้ และสถานที่ของคุณ จากนั้นประเมินขนาดการประมวลผล หน่วยความจำ เครือข่าย พลังงาน และการระบายความร้อน

การจัดหา

เราจัดหาผ่าน NVIDIA และพันธมิตรด้านเซิร์ฟเวอร์ ยืนยันระยะเวลาจัดส่ง และแจ้งความคืบหน้าให้คุณทราบจนถึงวันส่งมอบ

การประกอบและ Burn-in

ระบบได้รับการประกอบ ลงอิมเมจ และทดสอบความเครียดที่โหลดเต็มในเวิร์กช็อปของเราในสหราชอาณาจักรก่อนจัดส่ง

การติดตั้ง

วิศวกรของเราจัดส่ง ติดตั้งลงแร็ก เดินสาย และส่งมอบใช้งาน ณ สถานที่ จากนั้นส่งมอบพร้อมเอกสาร

การสนับสนุน

ทีมเดียวกันดูแลปัญหาซอฟต์แวร์ การอัปเกรด การต่ออายุไลเซนส์ และการเคลมประกัน

หมวดหมู่ NVIDIA ทั้งหมด

สมาชิก Trade

สมาชิก Trade ได้รับการสนับสนุนทางเทคนิคฟรีในทุกคำสั่งซื้อและเวลาวิศวกรไม่จำกัด — ช่วยเรื่องการกำหนดค่า ไดรเวอร์ ซอฟต์แวร์ และการแก้ไขปัญหา ตลอดระยะเวลาที่คุณใช้งานอุปกรณ์

ดูรายละเอียดสมาชิก Trade

NVIDIA Blackwell จากชิปสู่ศูนย์ข้อมูล

NVIDIA Blackwell: The Journey From Die to Data Center. เล่นจากช่อง YouTube อย่างเป็นทางการของ NVIDIA ดูบน YouTubeNVIDIA, Blackwell, DGX, Grace และ RTX PRO เป็นเครื่องหมายการค้าและ/หรือเครื่องหมายการค้าจดทะเบียนของ NVIDIA Corporation แสดงไว้เพื่ออธิบายผลิตภัณฑ์ที่เราจัดหา โดยไม่ได้หมายความว่า NVIDIA ให้การรับรอง

See the NVIDIA RTX PRO 6000 Blackwell Server Edition

NVIDIA RTX PRO: AI and visual computing on the RTX PRO 6000 Blackwell Server Edition. Video: NVIDIA Corporation. เล่นจากช่อง YouTube อย่างเป็นทางการของ NVIDIA ดูบน YouTubeRead about the RTX PRO 6000 Server Edition →NVIDIA, RTX PRO and Blackwell are trademarks and/or registered trademarks of NVIDIA Corporation. Shown to describe the products we supply; no endorsement by NVIDIA is implied.

คำถามที่พบบ่อย

ทำไมทุกรายการจึงเป็นราคาตามใบเสนอราคา

ราคาและโควตาของ accelerated computing เปลี่ยนแปลงอย่างรวดเร็ว และคำสั่งซื้อส่วนใหญ่ขึ้นอยู่กับการกำหนดค่า สถานที่ และซอฟต์แวร์ที่แน่นอน ใบเสนอราคาช่วยให้เรายืนยันราคา ความพร้อมจำหน่าย และระยะเวลาจัดส่งปัจจุบันสำหรับสิ่งที่คุณต้องการจริงๆ

คุณจัดหา GPU ตัวเดียวแทนระบบครบชุดได้หรือไม่

ได้ เราจัดหา GPU ดาต้าเซ็นเตอร์แบบแยก แต่เราจะตรวจสอบเสมอว่าเซิร์ฟเวอร์ของคุณได้รับการรับรองให้จ่ายไฟและระบายความร้อนได้ และเราสามารถติดตั้งและทดสอบให้คุณได้

คุณติดตั้งระบบระดับแร็กและระบบระบายความร้อนด้วยของเหลวหรือไม่

ใช่ สำหรับระบบอย่าง GB300 NVL72 เราทำงานร่วมกับทีมอาคารของคุณเรื่องพลังงาน การระบายความร้อน และการรับน้ำหนักพื้นตั้งแต่ก่อนจัดส่งนาน จากนั้นติดตั้งและส่งมอบใช้งาน ณ สถานที่

เราควรเริ่มต้นด้วยแพลตฟอร์ม NVIDIA ใด

ขึ้นอยู่กับโมเดล ผู้ใช้ และสถานที่ของคุณ หลายทีมเริ่มต้นด้วย RTX PRO Server หรือ L40S สำหรับงาน AI และกราฟิกผสมกัน แล้วขยับไปสู่ HGX หรือ DGX สำหรับการเทรนขนาดใหญ่ พูดคุยกับวิศวกรแล้วเราจะแนะนำจุดเริ่มต้นที่เหมาะสม

วางแผนโครงการ NVIDIA accelerated computing ของคุณ

บอกเราว่าคุณต้องรันอะไรและต้องติดตั้งที่ไหน วิศวกรจะติดต่อกลับพร้อมการกำหนดค่าที่แนะนำและใบเสนอราคา

พูดคุยกับวิศวกร