Магазин открыт

Мы создаём машины Workstation AI для сайтов, ИИ-агентов и обучения LLM — настройте и купите онлайн.

Получить оптовые цены
AI-продукты
AI LabsАгенты OpenAIАгенты ClaudeGrok BotНативная CRM Workstation AIМаркетингВсе продукты
AI-решения
Прикладной ИИИИ-агентыГенеративный ИИАвтоматизация с ИИОбучение ИИ-навыкамИИ-пакеты для малого и среднего бизнесаКорпоративная AI-лабораторияAI-рабочие станцииОборудование и ПО NVIDIAУскоренные вычисления NVIDIAПриватный AIGPU-кластерыEdge AIAI по отраслям
AI-услуги
Модернизация платформЦифровая инженерияОснова данных и ИИАвтономные операцииИИ-консалтингАвтоматизация DevOpsКибербезопасностьРазработка ПОСоздание агентовНастройка MLOpsАренда GPU
О нас
КомпанияНаша историяПартнёрыИстории клиентов
ЦОД для ИИ
Материалы об ИИСерия JevЛаборатория бенчмарковВыбор моделей
Технические заметки
Документация
ОС LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
Облачные ИИ-платформыAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU-облака и маркетплейсы
Частные ЦОД для ИИДля юридических фирмДля бухгалтерских фирмЛокальные платформыПолностью защищённое облако
ИнструментыRing PromoterJobshout
Новости
Блог
Связаться с намиВойти

AI-рабочие станции, мультиагентное AI-ПО, GPU-инфраструктура и решения на базе интеллектуальных агентов для современного бизнеса.

Связаться с нами

AI-решения

Прикладной ИИИИ-агентыГенеративный ИИАвтоматизация с ИИОбучение ИИ-навыкамИИ-пакеты для малого и среднего бизнесаКорпоративная AI-лабораторияAI по отраслям

Продукты

Все продуктыWorkstation AI native CRM и ERPМаркетингАгенты OpenAIRing PromoterJobshout

Компания

О насКомпанияЦОД для ИИПочему WorkstationПартнёрыИстории клиентовЦеныКонтактыTenthMatrix

Ресурсы

Материалы об ИИТехнические заметкиДокументацияОС LinuxОблачные ИИ-платформыЧастные ЦОД для ИИБлогПоискКарта сайта
Офис в Великобритании
77-79 Marlowes, Hemel Hempstead HP1 1LFКак добраться: съезд 20 с трассы M25, Внешний ЛондонРег. номер компании: 11641870Пн - Пт: 9:00 - 18:00 GMT
+44 7515 356 146
Офис в Бельгии
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Пн - Пт: 9:00 - 18:00 CET
+32 492 45 67 46
Офис в Индии
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI. Все права защищены.

КонфиденциальностьУдаление данныхФайлы cookieУсловия обслуживанияКарта сайта

NVIDIA, the NVIDIA logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX and HGX are trademarks and/or registered trademarks of NVIDIA Corporation in the US and other countries. AMD, the AMD Arrow logo, EPYC, Instinct, Ryzen and Threadripper are trademarks of Advanced Micro Devices, Inc. Dell and PowerEdge are trademarks of Dell Inc. or its subsidiaries. Intel and Xeon are trademarks of Intel Corporation or its subsidiaries. AMAX, AceleMax and LiquidMax are trademarks of AMAX Engineering Corporation. All other product names, logos and brands are the property of their respective owners. We use them only to identify the products we describe, supply or support; their use does not mean their owners endorse us.

Партнёр NVIDIA · Великобритания

Решения NVIDIA для ускоренных вычислений

От одного GPU для центра обработки данных до «фабрики ИИ» стоечного масштаба с жидкостным охлаждением — Workstation подбирает, поставляет, собирает, устанавливает и поддерживает всю линейку решений NVIDIA для ускоренных вычислений для организаций Великобритании.

Смотреть линейкуПоговорить с инженером
  • 34системы, GPU, сетевые продукты и ПО NVIDIA
  • 5этапов — от подбора конфигурации до долгосрочной поддержки
  • UKпроектирование, сборка и стресс-тестирование

Ускоренные вычисления без рисков интеграции

Ускоренные вычисления переносят самые тяжёлые части рабочей нагрузки — обучение и инференс ИИ, моделирование, аналитику и рендеринг — с универсальных CPU на GPU и специализированные процессоры. В результате каждая стойка и каждый ватт выполняют больше работы, а результаты получаются за часы, а не за дни.

Для этого нужен не только GPU. Каждому ускорителю нужен сервер, способный его запитать и охладить, сеть, которая обеспечит его данными, и лицензированное ПО с поддержкой. Как партнёр NVIDIA с собственными инженерами, мы объединяем всё это в одну протестированную систему и остаёмся рядом после запуска.

  • Независимые рекомендации по выбору платформы NVIDIA под ваши задачи
  • Готовые конфигурации с сертификацией NVIDIA-Certified, а не отдельные компоненты
  • Сборка, установка образа и стресс-тестирование в нашей мастерской в Великобритании
  • Установка, кабельная разводка и ввод в эксплуатацию на вашей площадке
  • Единый контакт в Великобритании по поддержке, модернизации и гарантии

Из чего состоит ускоренная система

Четыре уровня работают вместе. Мы проектируем все четыре, чтобы ни один из них не стал узким местом.

GPU

Выполняют параллельные вычисления для ИИ, моделирования и графики. Выбор GPU обычно определяют объём и пропускная способность памяти.

CPU и системы

Обеспечивают GPU данными, запускают операционную систему и хранят данные в памяти. Шасси определяет питание, охлаждение и количество GPU.

Сети и DPU

Передают данные между GPU, серверами и системами хранения. DPU снимают с CPU задачи сети, хранения и безопасности.

Программное обеспечение

Драйверы, CUDA, фреймворки ИИ и инструменты для кластеров превращают оборудование в платформу, которой могут пользоваться ваши команды.

Почему организации переходят на ускоренные вычисления

Нагрузки перерастают CPU

Модели ИИ и наборы данных растут быстрее, чем производительность CPU. Задачи не укладываются в сроки, уровень сервиса падает, а счета за электроэнергию растут.

Рабочие процессы усложняются

Подготовка данных, обучение, инференс и визуализация часто выполняются на разном оборудовании. Единая ускоренная платформа упрощает конвейер.

Новые приложения создают новые изолированные островки

Внедрение ИИ рядом с существующими приложениями может привести к разрозненным островкам оборудования. Общая сертифицированная платформа сохраняет управляемость всей инфраструктуры.

Линейка

Продукты NVIDIA для ускоренных вычислений

Каждую систему, GPU, сетевой продукт и лицензию на ПО ниже можно приобрести отдельно или в составе готового решения. Отфильтруйте по типу, сравните ключевые характеристики и запросите коммерческое предложение.

Системы и платформы

NVIDIA Vera Rubin NVL72

Система стоечного масштаба для агентного ИИ и крупнейших моделей

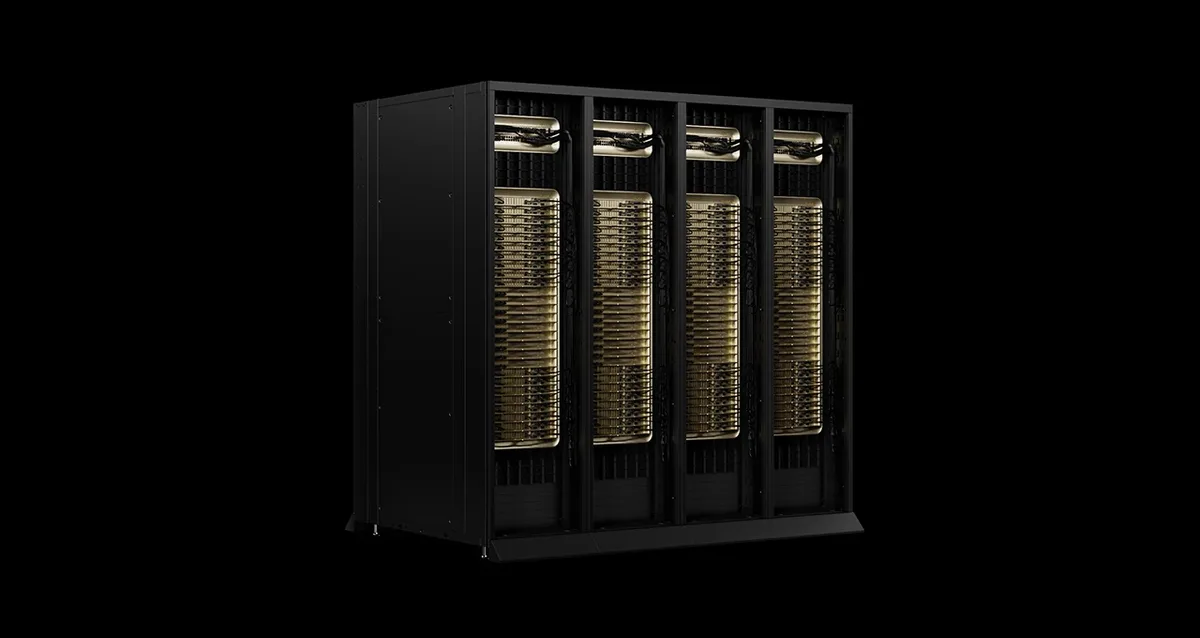
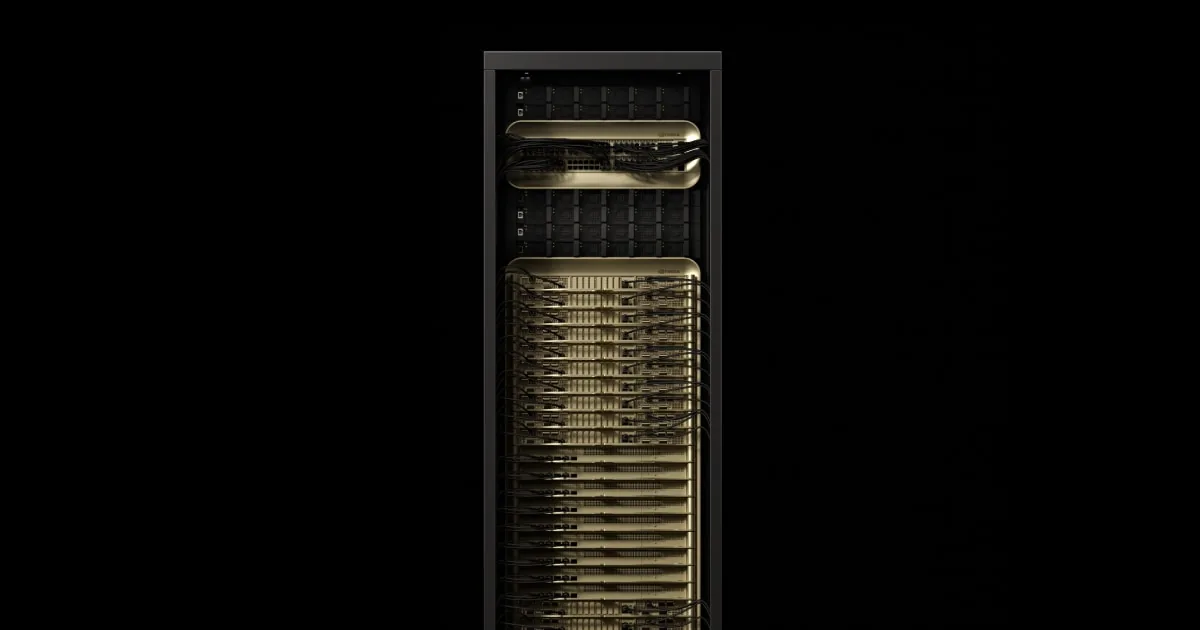
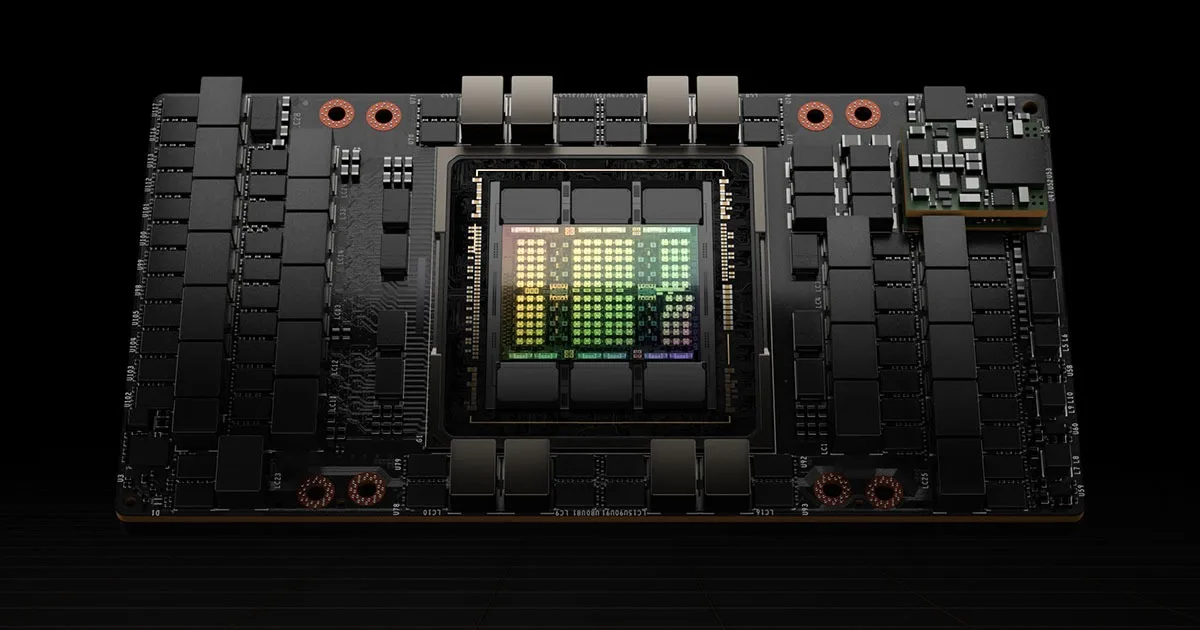
Новейшее поколение стоечных систем NVIDIA объединяет 72 GPU Rubin и 36 CPU Vera в одном домене NVLink, поэтому одна стойка работает как один очень большой ускоритель.

Кому подходит: «Фабрики ИИ», разработчики моделей и сервис-провайдеры, планирующие следующее крупное развёртывание

Преимущества

  • Значительно больше токенов на мегаватт, чем у поколения Grace Blackwell, по данным NVIDIA
  • Память HBM4, рассчитанная на модели с триллионами параметров и длинным контекстом
  • Модульные лотки без кабелей упрощают обслуживание прямо в стойке

Ключевые характеристики

Конфигурация72× Rubin GPU, 36× Vera CPU
Память GPU20.7 TB HBM4 | 1,400 TB/s
Инференс NVFP43,600 PFLOPS (sparse)
Пропускная способность NVLink216 TB/s (sixth generation)
Память CPUUp to 54 TB LPDDR5X
Форм-факторRack, third-generation MGX NVL72

Что делает Workstation: Мы заранее проверяем электропитание, охлаждение и допустимую нагрузку на пол, обеспечиваем квоту на поставку и планируем доставку, установку и ввод в эксплуатацию с учётом вашего машинного зала.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

NVIDIA GB300 NVL72 (DGX GB300)

Стойка Blackwell Ultra с жидкостным охлаждением для рассуждающего ИИ

Тридцать шесть CPU Grace и 72 GPU Blackwell Ultra используют одну фабрику NVLink в одной стойке с жидкостным охлаждением. NVIDIA также поставляет её как DGX GB300.

Кому подходит: Организации, предоставляющие рассуждающие модели множеству пользователей, и команды, обучающие модели передового масштаба

Преимущества

  • Значительный рост числа токенов в секунду на пользователя по сравнению с системами на базе Hopper
  • 37 TB быстрой памяти позволяют держать длинные контексты и крупные модели в одном домене
  • SuperNIC ConnectX-8 дают каждому GPU канал 800 Gb/s в сеть

Ключевые характеристики

GPU72× Blackwell Ultra
CPU36× Grace (2,592 Arm Neoverse V2 cores)
Память GPU20 TB | up to 576 TB/s
Быстрая память37 TB
Tensor Core FP41,440 PFLOPS (sparse)
Пропускная способность NVLink130 TB/s

Что делает Workstation: Мы планируем жидкостное охлаждение и электропитание вместе с вашей службой эксплуатации здания, координируем доставку интегрированной стойки и вводим её в эксплуатацию с проверенными базовыми показателями.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

NVIDIA GB200 NVL72 (DGX GB200)

Система Grace Blackwell стоечного масштаба в одном домене NVLink

Первая стойка Grace Blackwell: 72 GPU Blackwell и 36 CPU Grace, связанные NVLink и охлаждаемые жидкостью, для очень крупных циклов обучения и инференса в реальном времени.

Кому подходит: Команды, обучающие или обслуживающие модели с триллионами параметров, которым нужен единый большой общий пул памяти GPU

Преимущества

  • Инференс очень больших языковых моделей в реальном времени, во много раз быстрее, чем на H100, по данным NVIDIA
  • Жидкостное охлаждение повышает плотность и энергоэффективность
  • NVLink пятого поколения обеспечивает 1.8 TB/s между любыми двумя GPU

Ключевые характеристики

Конфигурация72× Blackwell GPU, 36× Grace CPU
Память GPU13.4 TB HBM3E | 576 TB/s
Tensor Core NVFP41,440 PFLOPS sparse | 720 PFLOPS dense
Пропускная способность NVLink130 TB/s
Память CPU17 TB LPDDR5X | 14 TB/s
ОхлаждениеLiquid cooled

Что делает Workstation: Мы оцениваем готовность вашей площадки к жидкостному охлаждению, управляем доставкой и интеграцией с вашей сетью и системами хранения и поддерживаем стойку после запуска.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

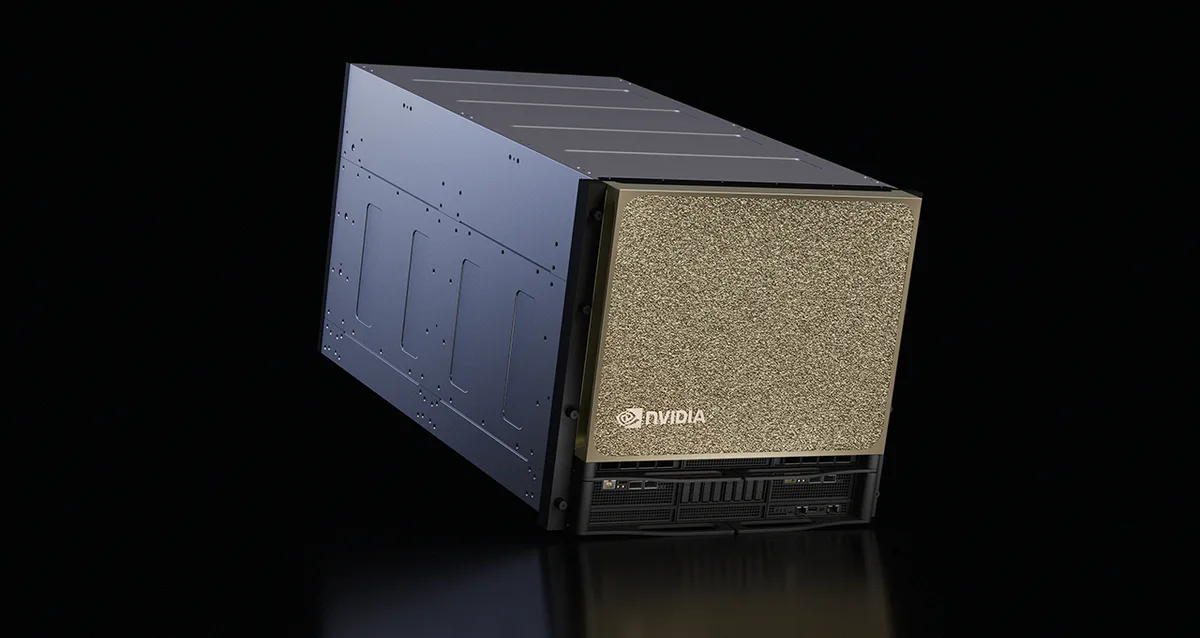
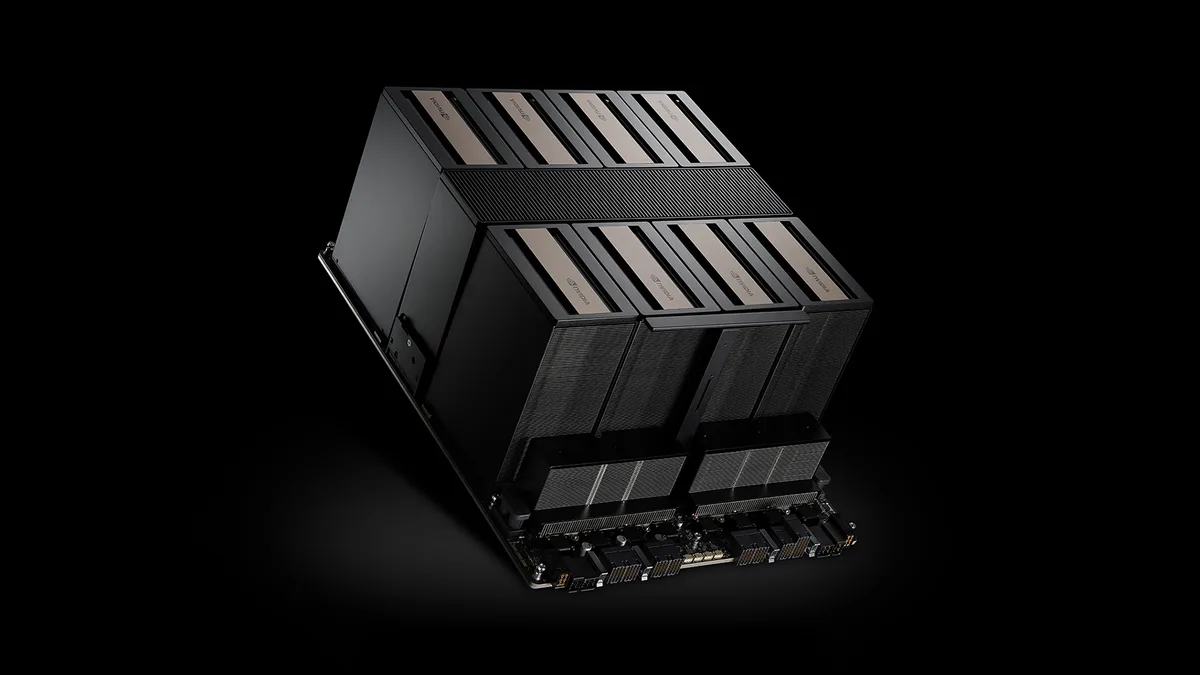
NVIDIA DGX B300

Восемь GPU Blackwell Ultra в одной системе DGX

Автономный сервер DGX с восемью GPU Blackwell Ultra, сетевыми решениями NVIDIA и полным программным стеком DGX — может работать самостоятельно или войти в BasePOD или SuperPOD.

Кому подходит: Предприятия, создающие свою первую полноценную «фабрику ИИ», и команды, которым нужен эталонный дизайн NVIDIA, а не индивидуальная сборка

Преимущества

  • 2.3 TB памяти GPU в одном узле для крупных моделей
  • Встроенные сетевые адаптеры ConnectX-8 и BlueField-3 для горизонтального масштабирования
  • ПО DGX обеспечивает единообразие всех узлов кластера с первого дня

Ключевые характеристики

GPU8× Blackwell Ultra
Память GPU2.3 TB total
Производительность ИИ72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
Сеть8× ConnectX-8, 2× BlueField-3 DPU

Что делает Workstation: Мы проверяем электропитание и воздушный поток в стойке, доставляем и монтируем систему, подключаем её к вашей сетевой фабрике и передаём с проверенными DGX OS и драйверами.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

NVIDIA DGX B200

Проверенная система DGX на Blackwell для обучения и инференса

Восемь GPU Blackwell, связанных NVLink, в одном шасси DGX — широко распространённый строительный блок для локальной инфраструктуры ИИ.

Кому подходит: Команды, переходящие с Hopper или облачных GPU на собственную платформу Blackwell

Преимущества

  • Одна платформа для обучения, дообучения и инференса
  • 1,440 GB памяти GPU на восемь GPU, связанных NVLink
  • Вписывается в эталонные архитектуры BasePOD и SuperPOD по мере роста

Ключевые характеристики

GPU8× Blackwell
Память GPU1,440 GB total
Производительность ИИ72 PFLOPS training, 144 PFLOPS inference
Сеть8× ConnectX-7, 2× BlueField-3 DPU

Что делает Workstation: Мы подбираем конфигурацию под ваши модели, доставляем и устанавливаем систему, а перед передачей настраиваем драйверы, CUDA и NVIDIA AI Enterprise.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
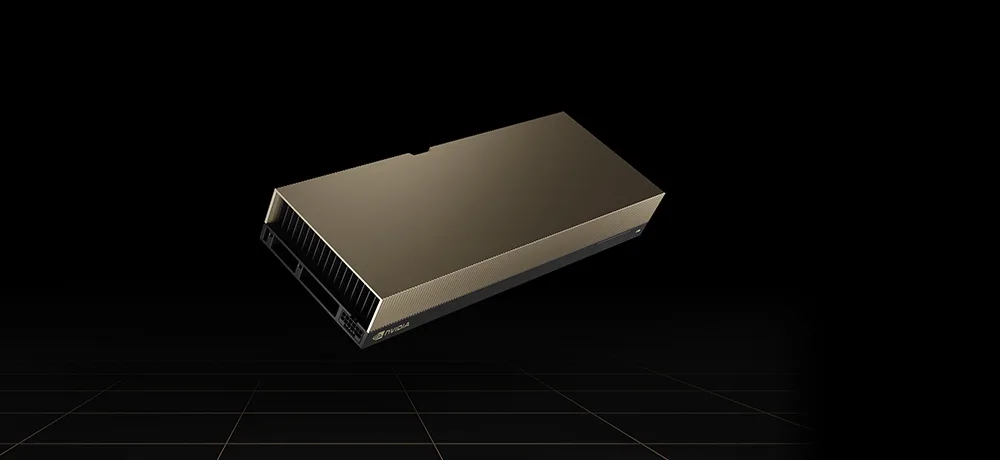
Системы и платформы

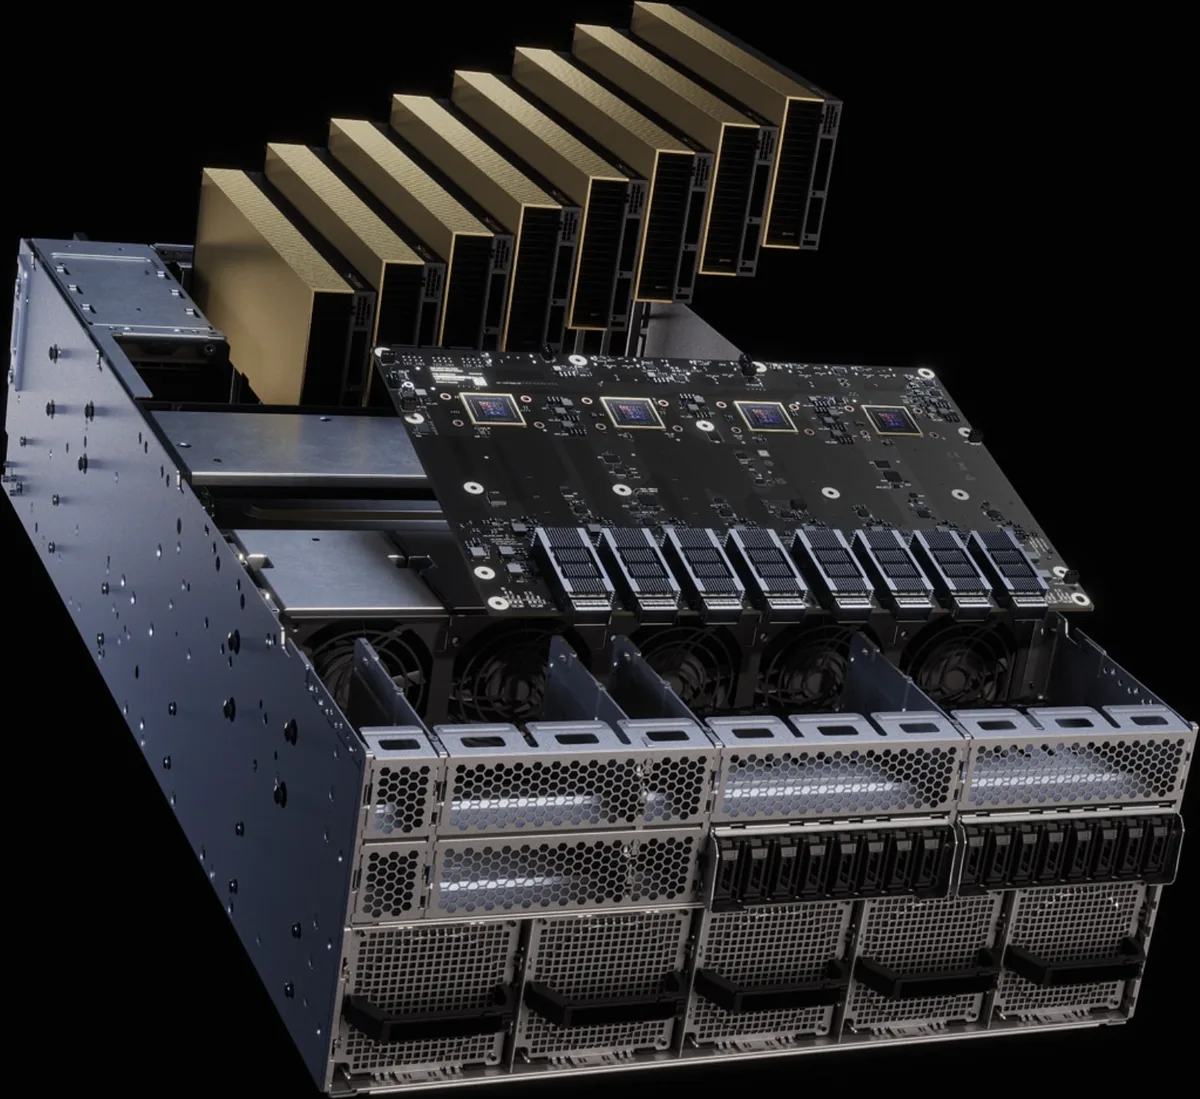
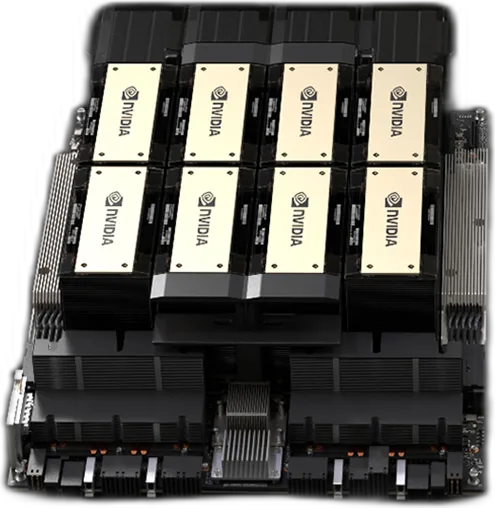
NVIDIA HGX

Восьмипроцессорная GPU-плата в серверах партнёров

HGX — это GPU-плата NVIDIA с соединением NVLink, которую производители серверов встраивают в свои системы: вы получаете топовые GPU с выбранным вами шасси, CPU и брендом поддержки.

Кому подходит: Организации, которым нужны флагманские GPU от предпочитаемого производителя серверов

Преимущества

  • Выбирайте бренд сервера, CPU и системы хранения, подходящие вашей инфраструктуре
  • NVLink и NVSwitch соединяют все восемь GPU на полной скорости
  • Охватывает поколения Blackwell, Blackwell Ultra и Rubin

Ключевые характеристики

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
Пропускная способность NVLink14.4 TB/s total (HGX B300 and B200)

Что делает Workstation: Мы закупаем сервер HGX у предпочитаемого вами бренда, проводим стресс-тестирование под полной нагрузкой в нашей мастерской и устанавливаем его вместе с вашей сетью.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
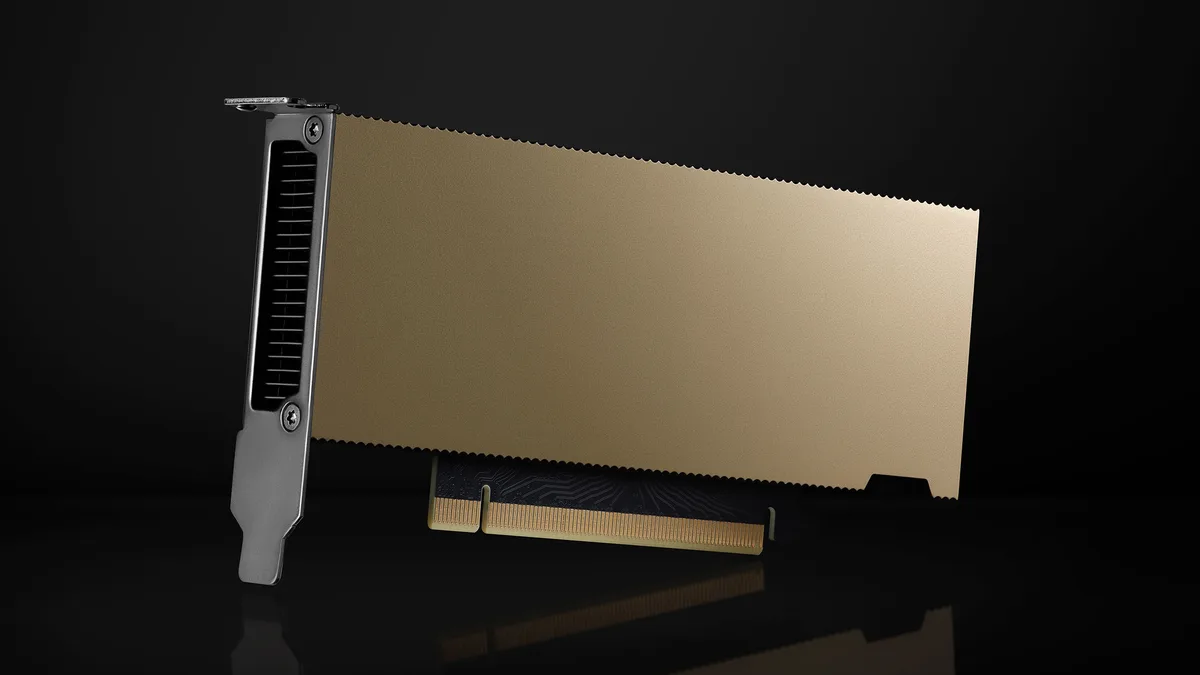
Системы и платформы

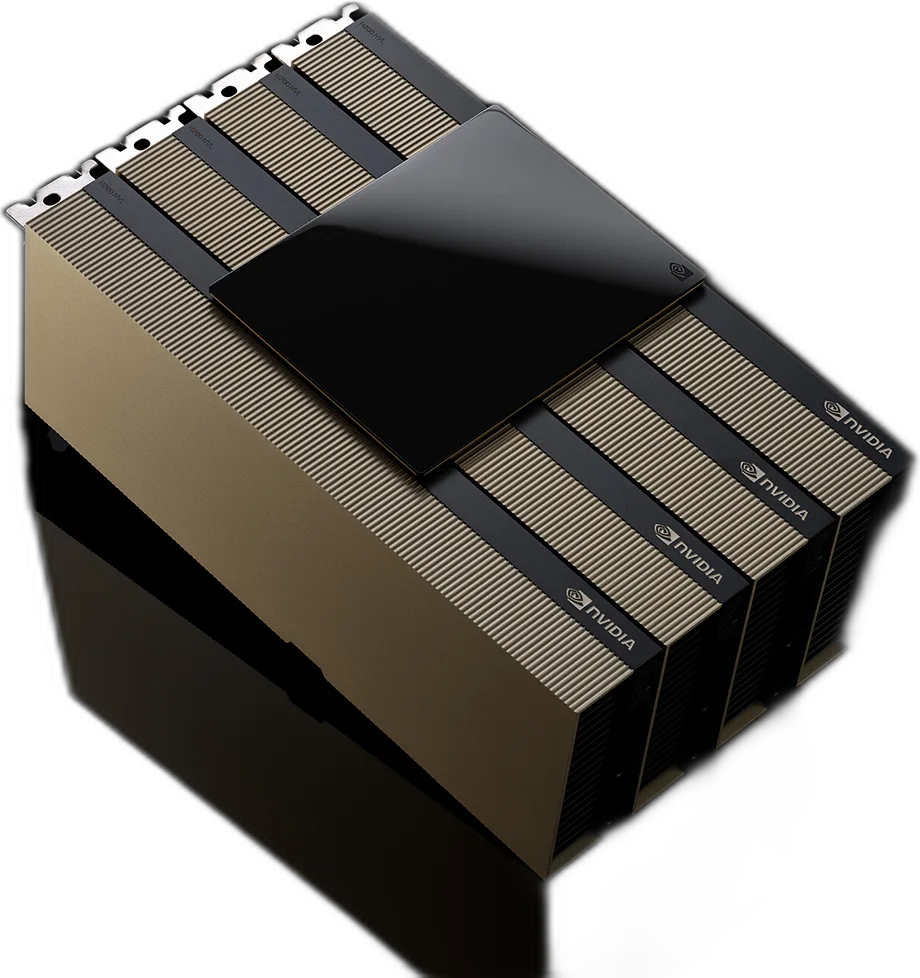
NVIDIA RTX PRO Server

Универсальный сервер Blackwell для корпоративного ИИ и графики

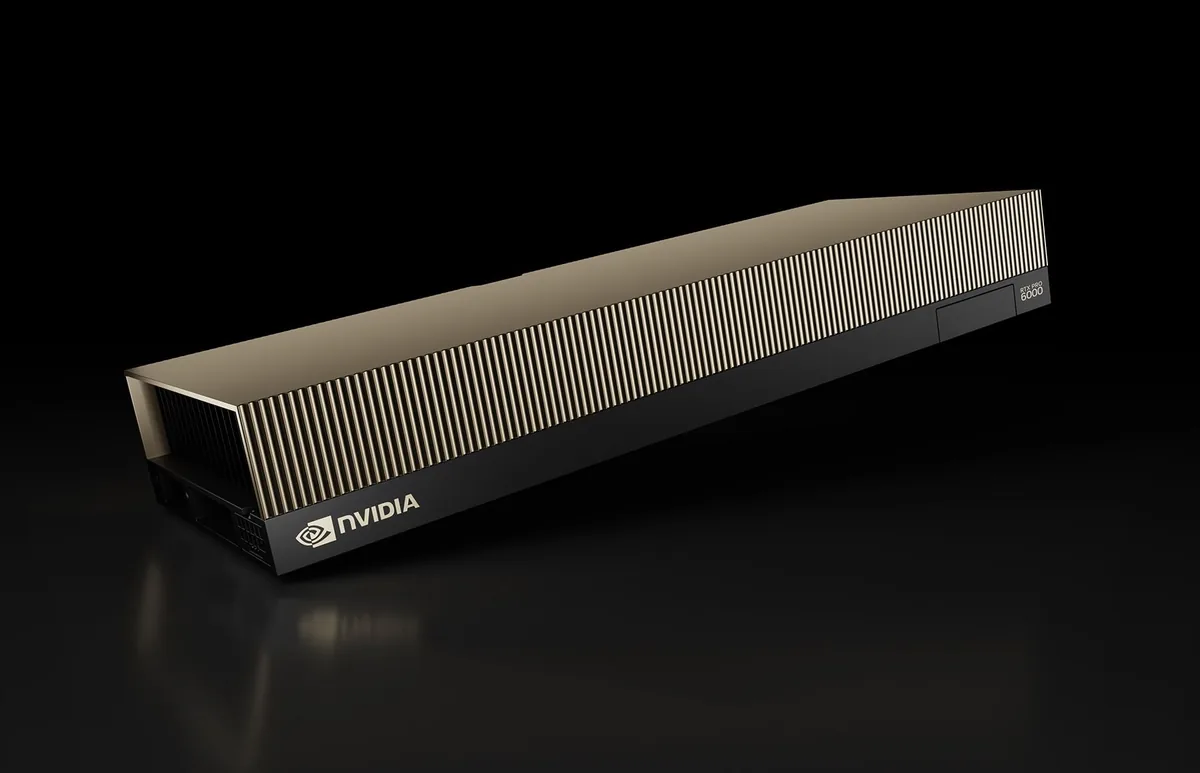
Сервер для центра обработки данных с GPU RTX PRO 6000 Blackwell Server Edition (до восьми), на одной платформе выполняющий задачи ИИ, моделирования, рендеринга и виртуальных рабочих станций. Это основной ускоренный сервер NVIDIA, и страница EGX теперь ведёт сюда.

Кому подходит: Предприятия, переносящие существующие нагрузки ЦОД на GPU параллельно с новыми сервисами ИИ

Преимущества

  • Один тип сервера для инференса ИИ, визуальных вычислений и науки о данных
  • Варианты с воздушным охлаждением подходят для большинства существующих серверных
  • Проверено с NVIDIA AI Enterprise и Omniverse

Ключевые характеристики

GPUUp to 8× RTX PRO 6000 Blackwell Server Edition
Память GPU800 GB (8-GPU configuration)
Пропускная способность памяти13 TB/s (8-GPU configuration)
Графика RTX3 PFLOPS
КонфигурацииMGX 2U, 4U and 6U (6U liquid cooled)

Что делает Workstation: Мы подбираем шасси и количество GPU под ваши нагрузки, проверяем наличие сертификации NVIDIA-Certified, затем собираем, тестируем и устанавливаем систему.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
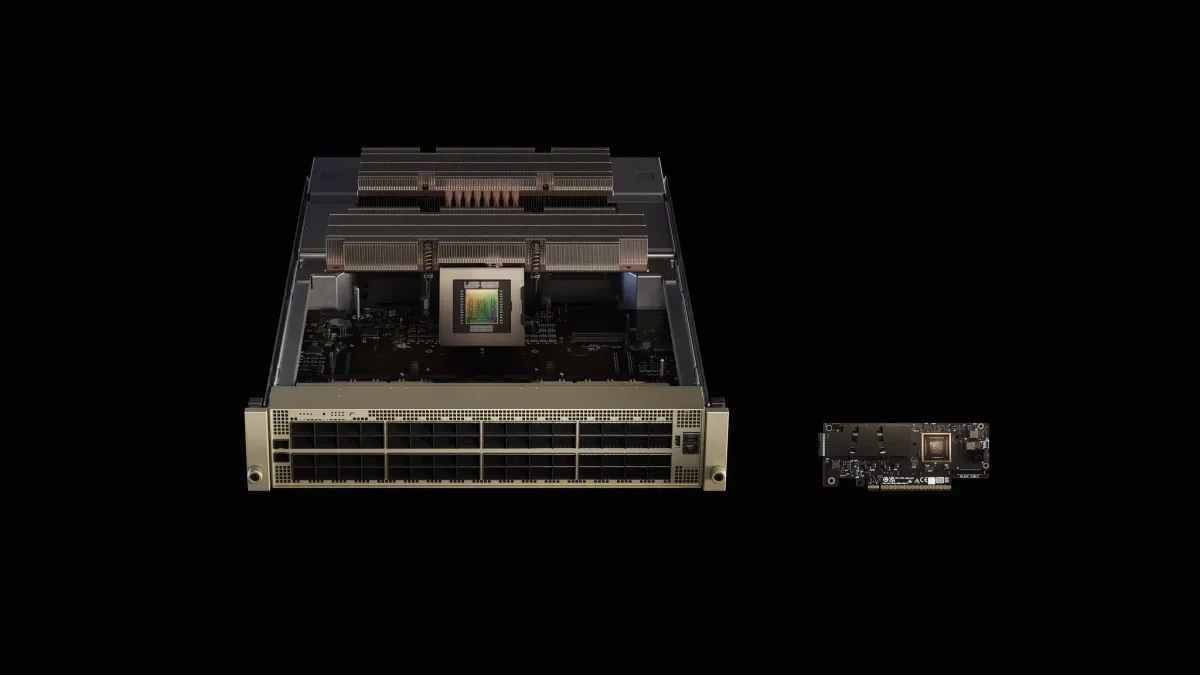
Системы и платформы

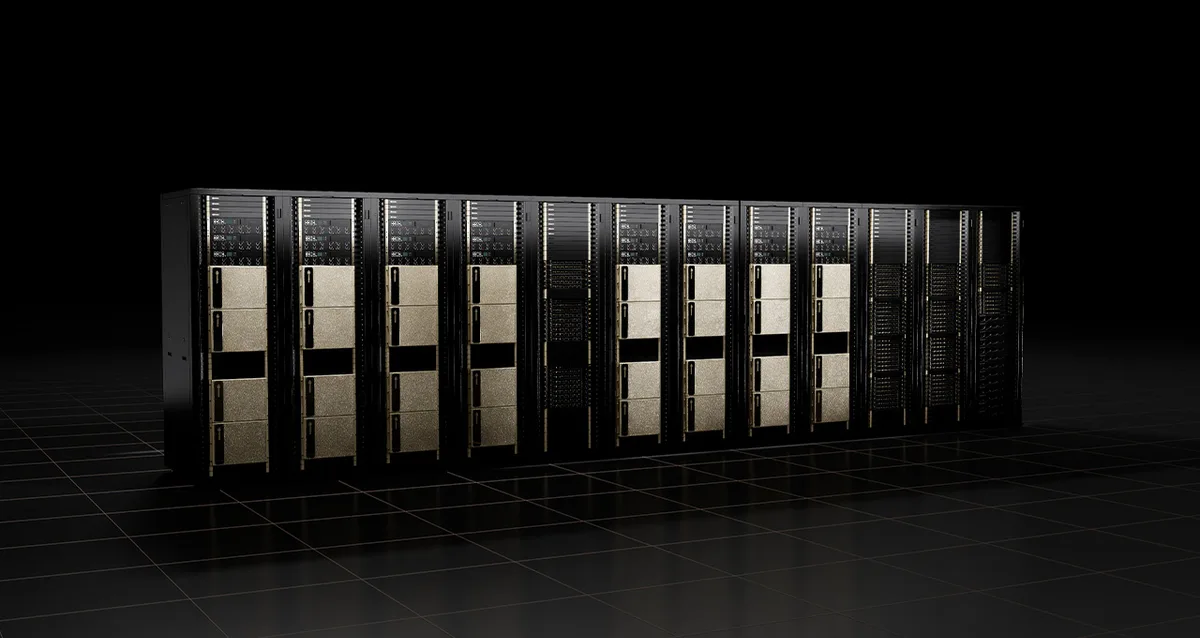
NVIDIA DGX SuperPOD

Готовый проект «фабрик ИИ» масштаба предприятия

Эталонная архитектура полного стека, объединяющая системы DGX, сетевые решения NVIDIA, сертифицированные системы хранения и ПО управления в повторяемые масштабируемые блоки.

Кому подходит: Исследовательские лаборатории, крупные предприятия и поставщики ИИ-сервисов, создающие кластеры из сотен или тысяч GPU

Преимущества

  • Проверенная архитектура в значительной мере устраняет риски интеграции
  • Масштабируется до десятков тысяч GPU повторяемыми блоками
  • Включает Mission Control и Base Command Manager для эксплуатации

Ключевые характеристики

ТипReference architecture
Строительный блокScalable units of DGX systems
МасштабUp to tens of thousands of GPUs
ХранилищеNVIDIA-certified partner storage
Программное обеспечениеNVIDIA AI Enterprise, Base Command Manager, Mission Control

Что делает Workstation: Мы руководим проектированием вместе с NVIDIA и партнёрами по системам хранения, ведём план проекта, устанавливаем масштабируемые блоки и остаёмся вашим контактом по поддержке.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
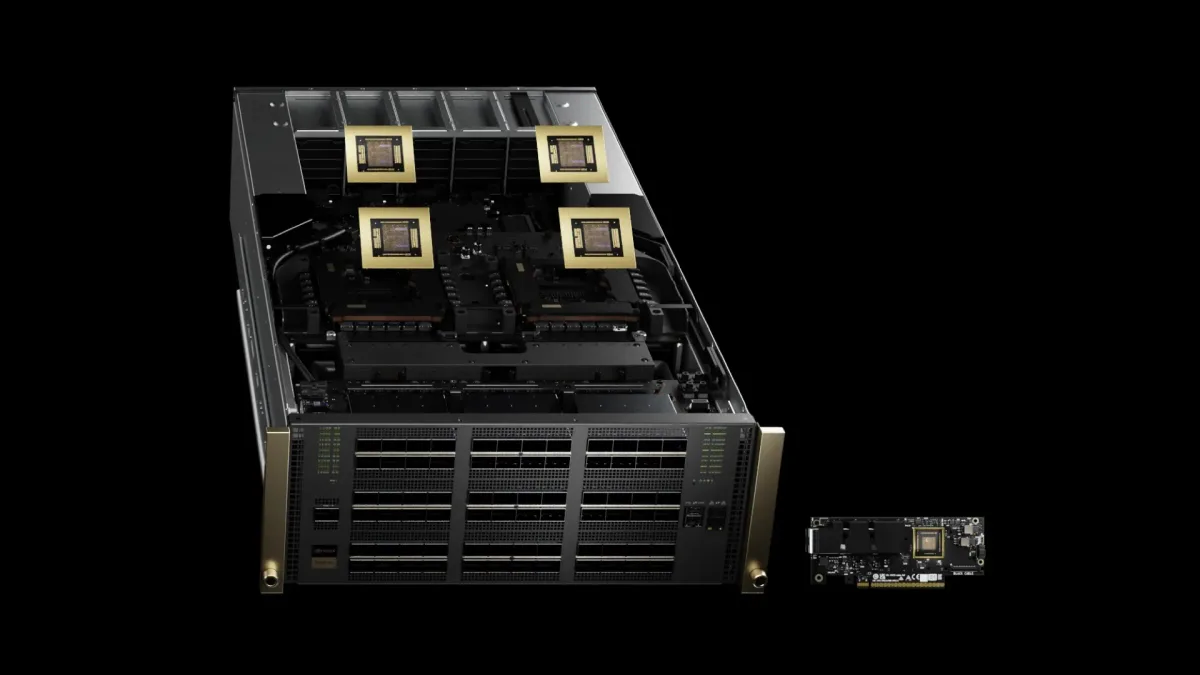
Системы и платформы

NVIDIA DGX BasePOD

Эталонная архитектура для вашего первого кластера DGX

Проверенная архитектура для двух и более систем DGX с согласованными сетями, системами хранения и кластерным ПО: меньше, чем SuperPOD, но построена по тем же принципам.

Кому подходит: Команды, переходящие от одной системы DGX к небольшому общему кластеру

Преимущества

  • Начните с двух систем и добавляйте новые без перепроектирования
  • Сети и системы хранения, согласованные с GPU
  • Кластерное ПО для планирования задач и мониторинга в комплекте

Ключевые характеристики

ТипReference architecture
Масштаб2 or more DGX systems
СетьPer reference architecture
ХранилищеPartner storage
Программное обеспечениеNVIDIA AI Enterprise, Base Command

Что делает Workstation: Мы подбираем конфигурацию кластера, поставляем все компоненты, монтируем и коммутируем оборудование и настраиваем планировщик, чтобы ваши команды могли совместно использовать кластер с первого дня.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

CPU NVIDIA Grace и Vera

Серверные CPU на Arm, созданные для «фабрик ИИ»

Собственные CPU NVIDIA соединяются с её GPU через NVLink-C2C. Grace CPU Superchip уже поставляется в серверах партнёров, а его преемник, Vera, ориентирован на агентный ИИ.

Кому подходит: HPC-центры, облачные провайдеры и все, кто выполняет ресурсоёмкие для CPU конвейеры наряду с GPU

Преимущества

  • Высокая пропускная способность памяти благодаря LPDDR5X
  • Вдвое выше производительность при том же энергопотреблении, чем у ведущих традиционных CPU, по данным NVIDIA
  • Когерентное высокоскоростное соединение с GPU NVIDIA

Ключевые характеристики

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Пропускная способность памяти GraceUp to 1 TB/s LPDDR5X
Vera CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

Что делает Workstation: Мы подбираем партнёрский сервер под ваш программный стек, вместе с вами тестируем приложения на Arm, а затем собираем и поддерживаем итоговое решение.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

NVIDIA OVX

Серверы L40S для Omniverse и цифровых двойников

OVX — проверенная архитектура серверов NVIDIA для Omniverse, сочетающая GPU L40S с сетевыми адаптерами ConnectX-7 или BlueField-3 для моделирования, рендеринга и ИИ.

Кому подходит: Производители, архитекторы и инженерные команды, создающие промышленные цифровые двойники

Преимущества

  • Один сервер для графики, моделирования и инференса ИИ
  • Проверено для Omniverse и NVIDIA AI Enterprise
  • Масштабируется на сотни серверов в высокоскоростной сетевой фабрике

Ключевые характеристики

GPU4× or 8× NVIDIA L40S
CPU2× Intel Xeon Gold or 2× AMD EPYC
Память хоста384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
Хранилище1 TB NVMe boot, 2× 4 TB NVMe
СетьConnectX-7 or BlueField-3

Что делает Workstation: Мы собираем серверы по схеме OVX у сертифицированных партнёров, настраиваем Omniverse и драйверы и подключаем их к вашим инструментам проектирования.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

NVIDIA AGX (Jetson AGX Thor)

ИИ-компьютеры для роботов и автономных машин

AGX — платформа NVIDIA для автономных машин. Её текущий флагман, Jetson AGX Thor, приносит GPU Blackwell в роботов, транспортные средства и интеллектуальные машины.

Кому подходит: Команды в робототехнике, автомобилестроении и промышленности, внедряющие ИИ в машины

Преимущества

  • Запускает модели восприятия и генеративного ИИ непосредственно на устройстве
  • Низкое энергопотребление подходит для мобильных и встраиваемых решений
  • Использует то же ПО CUDA, что и платформы NVIDIA для ЦОД

Ключевые характеристики

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
Производительность ИИ2070 TFLOPS (FP4)
ВариантыDeveloper kit, or T5000 and T4000 production modules

Что делает Workstation: Мы поставляем наборы для разработчиков и серийные модули, помогаем выбрать несущие платы и корпуса и поддерживаем вас от прототипа до массового внедрения.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

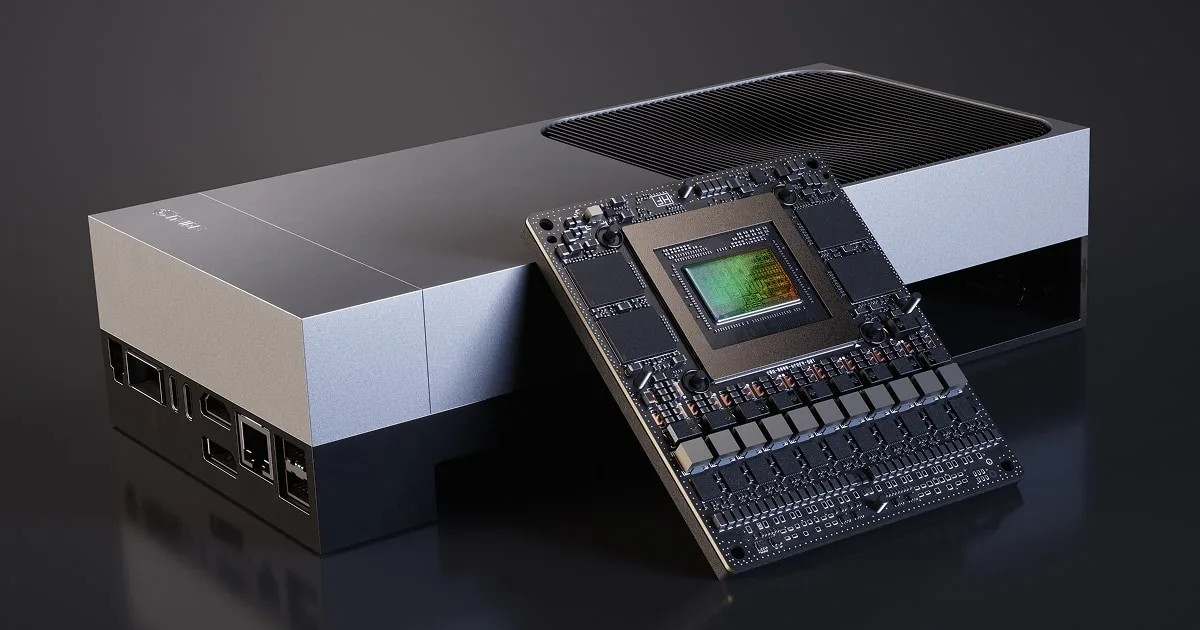
NVIDIA IGX Thor

Промышленный периферийный ИИ с функциональной безопасностью

IGX — корпоративная платформа NVIDIA для физического ИИ на промышленной и медицинской периферии, с выделенным островом безопасности и долгосрочной поддержкой ПО.

Кому подходит: Производители медицинских изделий, заводы и операторы инфраструктуры, которым нужны сертификация безопасности и длительный срок поддержки

Преимущества

  • Архитектура функциональной безопасности, ориентированная на ISO 26262 и IEC 61508
  • Десять лет поддержки корпоративного ПО NVIDIA
  • Опциональный GPU RTX PRO Blackwell для более тяжёлых моделей

Ключевые характеристики

Производительность ИИUp to 5,581 TFLOPS FP4 (sparse) with discrete GPU
Встроенный GPU2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
Память128 GB LPDDR5X, 273 GB/s
Энергопотребление40–130 W, up to 300 W for the discrete GPU

Что делает Workstation: Мы поставляем наборы для разработчиков и серийные системы, помогаем спланировать доказательную базу для сертификации и поддерживаем развёртывание на вашей площадке.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
Системы и платформы

NVIDIA Groq 3 LPX

Стойка для инференса с низкой задержкой для Vera Rubin

LPX — стойка из 256 ускорителей инференса LPU, работающая вместе с Vera Rubin NVL72 для быстрой и предсказуемой генерации токенов в интерактивном и агентном ИИ.

Кому подходит: Поставщики ИИ-сервисов, пользователям которых нужно быстрое и стабильное время отклика

Преимущества

  • Детерминированная генерация токенов с низкой задержкой
  • Значительно более высокая пропускная способность на мегаватт для моделей с триллионами параметров, по прогнозам NVIDIA
  • Прямое соединение с низкой задержкой со стойками NVL72

Ключевые характеристики

Ускорители256 LPUs per rack
Встроенная память на кристалле128 GB SRAM per rack (500 MB per LPU)
Пропускная способность SRAM40 PB/s per rack
Пропускная способность вертикального масштабирования640 TB/s per rack
Форм-факторNVIDIA MGX ETL rack

Что делает Workstation: Мы оцениваем, как система вписывается в ваши планы по Vera Rubin, подтверждаем наличие у NVIDIA и планируем установку рядом с вашими другими стойками.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
GPU для центров обработки данных

NVIDIA H200 (SXM)

GPU Hopper со 141 GB HBM3e

H200 сохраняет архитектуру Hopper, но получает значительно больший объём более быстрой памяти, что помогает при инференсе крупных моделей и HPC-задачах, ограниченных памятью. Версия SXM устанавливается в серверы HGX.

Кому подходит: Команды, запускающие большие языковые модели и HPC-приложения на серверах HGX

Преимущества

  • 141 GB на GPU позволяют размещать более крупные модели без разбиения
  • Более высокая пропускная способность памяти ускоряет задачи, ограниченные памятью
  • Работает с тем же ПО CUDA, что и H100

Ключевые характеристики

АрхитектураNVIDIA Hopper
Память GPU141 GB HBM3e
Форм-факторSXM (HGX)
ОхлаждениеPassive (server airflow)

Что делает Workstation: Мы поставляем H200 в составе сертифицированного сервера HGX, проводим стресс-тестирование и устанавливаем его с вашими драйверами и программным стеком.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
GPU для центров обработки данных

NVIDIA H200 NVL

GPU Hopper на 141 GB для серверов PCIe с воздушным охлаждением

PCIe-версия H200 для стандартных корпоративных стоек. Мосты NVLink позволяют объединять карты в пары для моделей, которым нужно больше памяти.

Кому подходит: Предприятия, добавляющие инференс крупных моделей в существующие серверные с воздушным охлаждением

Преимущества

  • Большой объём памяти GPU без перехода на жидкостное охлаждение
  • Мосты NVLink объединяют GPU для более крупных моделей
  • Подходит для массовых серверов с сертификацией NVIDIA-Certified

Ключевые характеристики

АрхитектураNVIDIA Hopper
Память GPU141 GB HBM3e
Форм-факторPCIe, dual slot
ОхлаждениеPassive (server airflow)

Что делает Workstation: Мы проверяем ваше шасси по питанию, воздушному потоку и расположению слотов, затем устанавливаем, тестируем и поставляем карты или готовый сервер.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
GPU для центров обработки данных

NVIDIA H100 PCIe 80 GB

GPU Hopper для обучения и инференса в серверах PCIe

H100 в исполнении PCIe приносит Transformer Engine и конфиденциальные вычисления Hopper в стандартные серверы.

Кому подходит: Команды с существующими GPU-серверами PCIe, которым нужна проверенная производительность Hopper

Преимущества

  • Transformer Engine ускоряет обучение и инференс языковых моделей
  • Multi-Instance GPU делит одну карту на изолированные экземпляры
  • Аппаратная поддержка конфиденциальных вычислений

Ключевые характеристики

АрхитектураNVIDIA Hopper
Память GPU80 GB HBM2e
Форм-факторDual-slot, full height, full length
ОхлаждениеPassive (server airflow)
ИнтерфейсPCIe

Что делает Workstation: Мы устанавливаем H100 в серверы, для которых он сертифицирован, проводим стресс-тестирование и настраиваем CUDA, драйверы и любые лицензии vGPU или AI Enterprise.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
GPU для центров обработки данных

NVIDIA RTX PRO 6000 Blackwell Server Edition

GPU Blackwell на 96 GB для стоечных серверов

Карта Blackwell с пассивным охлаждением и 96 GB памяти для инференса ИИ, рендеринга, моделирования и виртуальных рабочих станций в центре обработки данных.

Кому подходит: Предприятия, консолидирующие нагрузки ИИ и графики на одном типе GPU

Преимущества

  • 96 GB на GPU справляются с крупными моделями и большими сценами
  • Выполняет как задачи ИИ, так и профессиональную графику
  • Настраиваемое энергопотребление под конкретный сервер

Ключевые характеристики

АрхитектураNVIDIA Blackwell
Память GPU96 GB GDDR7 with ECC
Макс. мощностьUp to 600 W (configurable)
ИнтерфейсPCIe 5.0 x16
Форм-факторDual-slot, passive (server airflow)

Что делает Workstation: Мы поставляем карты отдельно или в составе RTX PRO Server и тестируем их под полной нагрузкой перед доставкой.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗
GPU для центров обработки данных

NVIDIA RTX PRO 4500 Blackwell Server Edition

Однослотовый GPU Blackwell для серверов высокой плотности

Компактный GPU Blackwell с пассивным охлаждением и 32 GB памяти, позволяющий установить в сервер много карт для инференса, видео и виртуальных рабочих столов.

Кому подходит: Команды, масштабирующие инференс или виртуальные рабочие столы на множество пользователей при меньшей стоимости на GPU

Преимущества

  • Однослотовая конструкция позволяет разместить больше GPU в сервере
  • 32 GB GDDR7 для моделей среднего размера
  • Меньшее энергопотребление подходит для существующих стоек

Ключевые характеристики

АрхитектураNVIDIA Blackwell
Память GPU32 GB GDDR7
Форм-факторSingle slot, 4.4" H × 10.5" L
ОхлаждениеPassive (server airflow)

Что делает Workstation: Мы рассчитываем, сколько карт ваши серверы могут запитать и охладить, затем собираем и тестируем конфигурацию.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

GPU для центров обработки данных

NVIDIA L40S

Универсальный GPU на 48 GB для ИИ и графики

GPU для центров обработки данных на архитектуре Ada Lovelace, сбалансированный для инференса, дообучения и 3D-графики, а также GPU в составе архитектуры OVX от NVIDIA.

Кому подходит: Команды, которым нужен один GPU и для ИИ, и для визуальных задач

Преимущества

  • Высокая производительность инференса и дообучения за свои деньги
  • Аппаратная трассировка лучей для рендеринга и Omniverse
  • Стандартная карта PCIe для массовых серверов

Ключевые характеристики

АрхитектураNVIDIA Ada Lovelace
Память GPU48 GB GDDR6 with ECC
Форм-факторDual-slot, 4.4" H × 10.5" L
ОхлаждениеPassive (server airflow)
ИнтерфейсPCIe

Что делает Workstation: Мы подбираем для L40S сертифицированные серверы, проводим стресс-тестирование сборки и устанавливаем её с настроенными драйверами и лицензиями.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

GPU для центров обработки данных

NVIDIA L40

GPU на 48 GB для рендеринга и виртуальных рабочих станций

L40 ориентирован на графику: рендеринг, Omniverse и виртуальные рабочие станции в центре обработки данных.

Кому подходит: Команды дизайна и медиа, переносящие рабочие станции в центр обработки данных

Преимущества

  • 48 GB для больших сцен и ассетов
  • Поддерживает ПО виртуальных GPU NVIDIA
  • Пассивное охлаждение для стандартных серверов

Ключевые характеристики

АрхитектураNVIDIA Ada Lovelace
Память GPU48 GB GDDR6 with ECC
Форм-факторDual-slot, 4.4" H × 10.5" L
ОхлаждениеPassive (server airflow)
ИнтерфейсPCIe

Что делает Workstation: Мы настраиваем профили и лицензии vGPU, чтобы удалённые рабочие станции ощущались пользователями как локальные.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

GPU для центров обработки данных

NVIDIA L4

Низкопрофильный GPU для эффективного инференса и видео

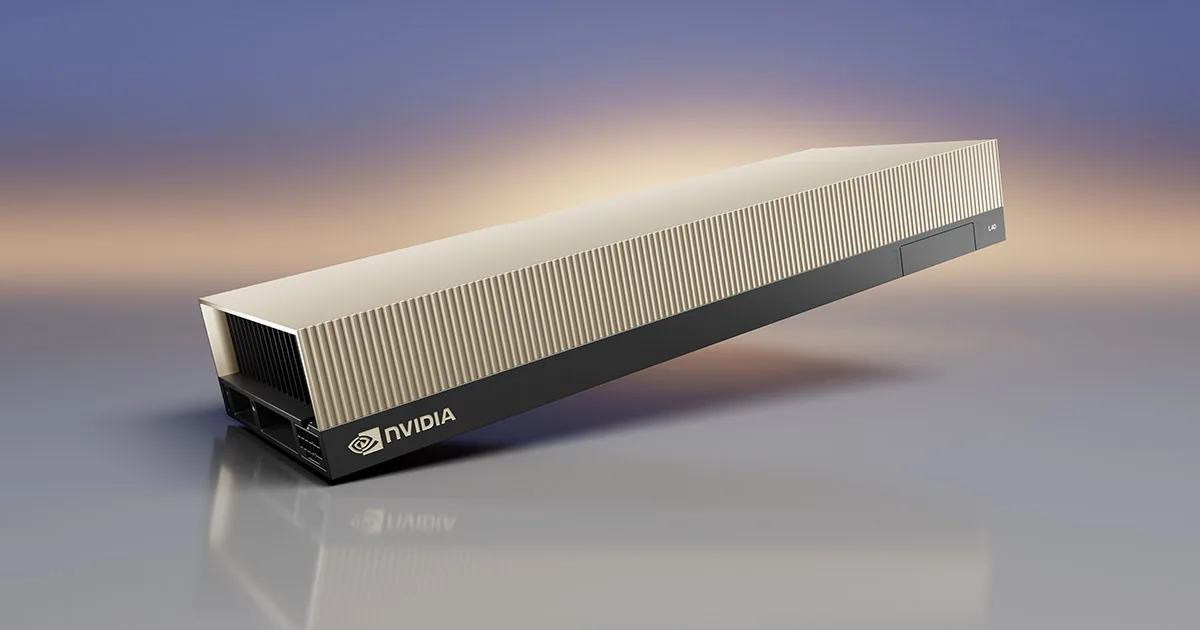
Небольшая энергоэффективная карта Ada Lovelace для видеоаналитики на базе ИИ, инференса и виртуальных рабочих столов — от периферии до центра обработки данных.

Кому подходит: Организации, добавляющие ИИ во множество серверов или на периферийные площадки с жёсткими ограничениями по питанию

Преимущества

  • Низкое энергопотребление и низкопрофильная карта подходят почти для любого сервера
  • Хорошо подходит для видеоаналитики и инференса
  • Экономично масштабируется на множество узлов

Ключевые характеристики

АрхитектураNVIDIA Ada Lovelace
Память GPU24 GB GDDR6
Форм-факторSingle-slot, low profile
ОхлаждениеPassive (server airflow)
ИнтерфейсPCIe

Что делает Workstation: Мы проверяем совместимость с вашими существующими серверами, поставляем карты и настраиваем драйверы и ПО для инференса.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Сеть

Платформа Ethernet NVIDIA Spectrum-X

Ethernet, оптимизированный для «фабрик ИИ»

Spectrum-X объединяет коммутаторы Spectrum Ethernet с SuperNIC Spectrum-X, обеспечивая ИИ-кластерам предсказуемый Ethernet с высокой пропускной способностью.

Кому подходит: Организации, которым нужна сетевая фабрика для ИИ, знакомая их сетевой команде

Преимущества

  • Более высокая эффективная пропускная способность для трафика между GPU, чем у стандартного Ethernet
  • Использует привычные инструменты и навыки работы с Ethernet
  • Входит в проверенные архитектуры «фабрик ИИ» NVIDIA

Ключевые характеристики

ТипEthernet networking platform
КомпонентыNVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
Сценарий использованияAI clusters and AI factories

Что делает Workstation: Мы проектируем сетевую фабрику, поставляем коммутаторы, SuperNIC и кабели, устанавливаем и тестируем её и документируем для вашей команды.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Сеть

Платформа NVIDIA Quantum-X800 InfiniBand

InfiniBand нового поколения для крупномасштабного обучения

Коммутаторы Quantum-X800 и SuperNIC ConnectX-8 образуют самую производительную фабрику InfiniBand от NVIDIA для обучения ИИ и HPC.

Кому подходит: HPC-центры и команды ИИ, ведущие обучение в крупном масштабе

Преимущества

  • Очень низкая задержка для тесно связанных задач
  • Создана для крупнейших кластеров обучения и HPC
  • Управление и мониторинг с помощью UFM

Ключевые характеристики

ТипInfiniBand networking platform
КомпонентыNVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
Сценарий использованияLarge-scale AI training and HPC

Что делает Workstation: Мы проектируем топологию, поставляем и прокладываем каждое соединение и запускаем фабрику с настроенным мониторингом UFM.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Сеть

Коммутаторы NVIDIA Spectrum Ethernet

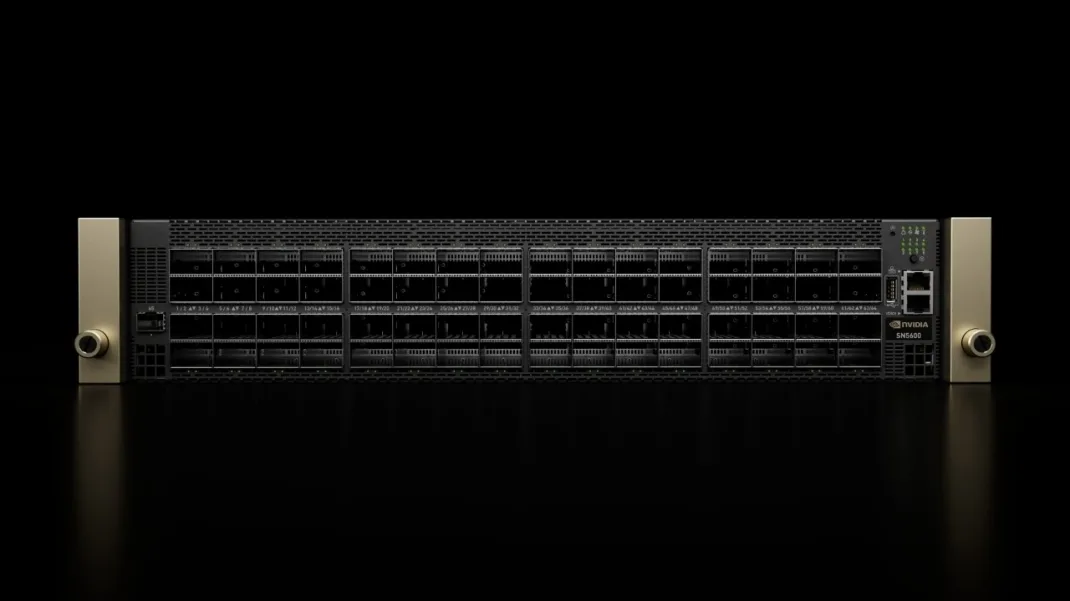
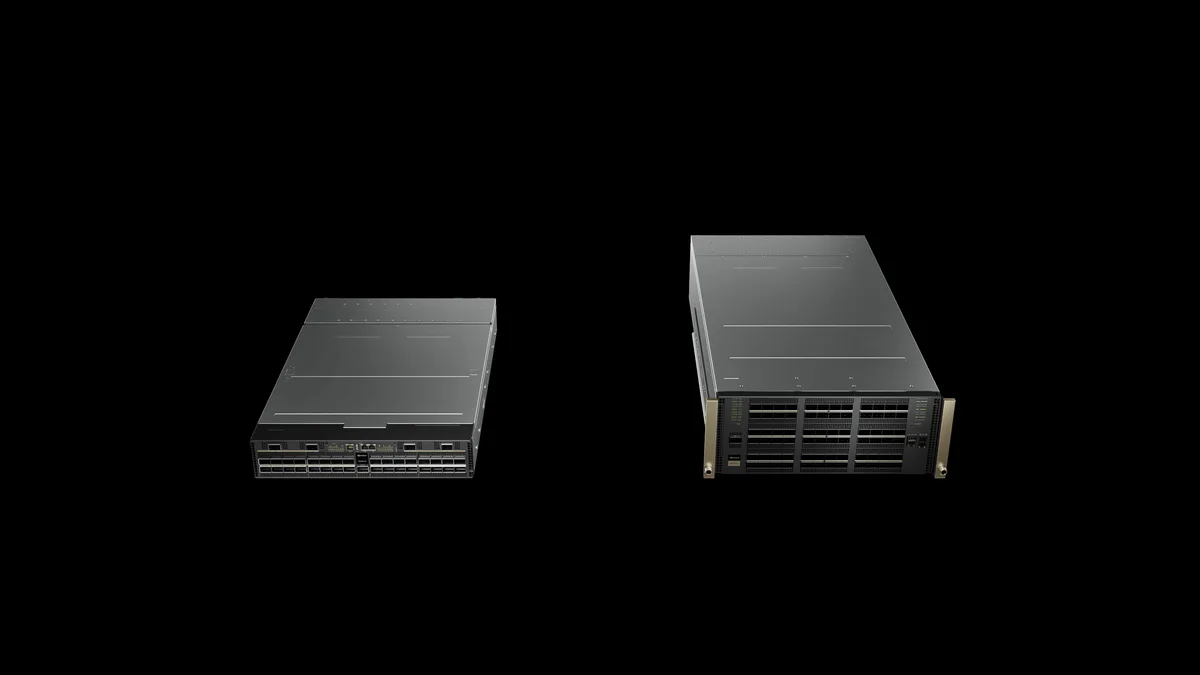
Коммутаторы Ethernet для ЦОД со скоростью до 800 Gb/s

Коммутаторы Spectrum передают трафик ИИ, систем хранения и облака — самостоятельно или в составе Spectrum-X.

Кому подходит: Команды ЦОД и сетевые команды, обновляющие коммутацию уровней leaf и spine

Преимущества

  • Скорость портов до 800 Gb/s
  • Работают как в сетевых фабриках ИИ, так и в обычных сетях ЦОД
  • Работают в связке с NetQ для эксплуатации и телеметрии сети

Ключевые характеристики

ТипEthernet switch family
Скорость портаUp to 800 Gb/s
ПрименениеAI and cloud data-centre fabrics

Что делает Workstation: Мы подбираем порты и оптику, настраиваем коммутаторы и интегрируем их с вашей существующей сетью.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Сеть

Коммутаторы NVIDIA Quantum InfiniBand

Коммутация с низкой задержкой для HPC и ИИ

Коммутаторы Quantum InfiniBand формируют фабрики с низкой задержкой, на которые опираются кластеры HPC и ИИ.

Кому подходит: Команды научных вычислений и ИИ с тесно связанными нагрузками

Преимущества

  • Очень низкая задержка между узлами
  • Проверены в кластерах HPC и ИИ
  • Централизованное управление с помощью UFM

Ключевые характеристики

ТипInfiniBand switch family
ПрименениеHPC and AI data centres

Что делает Workstation: Мы планируем топологию, поставляем кабели и оптику, устанавливаем и проверяем фабрику.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Сеть

Сетевые адаптеры и SuperNIC NVIDIA ConnectX

Сетевые адаптеры для Ethernet и InfiniBand

Адаптеры ConnectX подключают серверы к сетевой фабрике. SuperNIC, такие как ConnectX-8, оптимизированы для трафика между GPU в ИИ-кластерах.

Кому подходит: Все, кто подключает GPU-серверы или системы хранения к высокоскоростной сети

Преимущества

  • Одно семейство охватывает Ethernet и InfiniBand
  • SuperNIC дают каждому GPU собственный высокоскоростной канал
  • Аппаратная разгрузка снижает нагрузку на CPU

Ключевые характеристики

ТипNetwork adapter and SuperNIC family
ФабрикиEthernet and InfiniBand
Максимальная скорость800 Gb/s per GPU (ConnectX-8 SuperNIC)

Что делает Workstation: Мы подбираем адаптеры, кабели и трансиверы под ваши коммутаторы и серверы и устанавливаем прошивки и драйверы.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Сеть

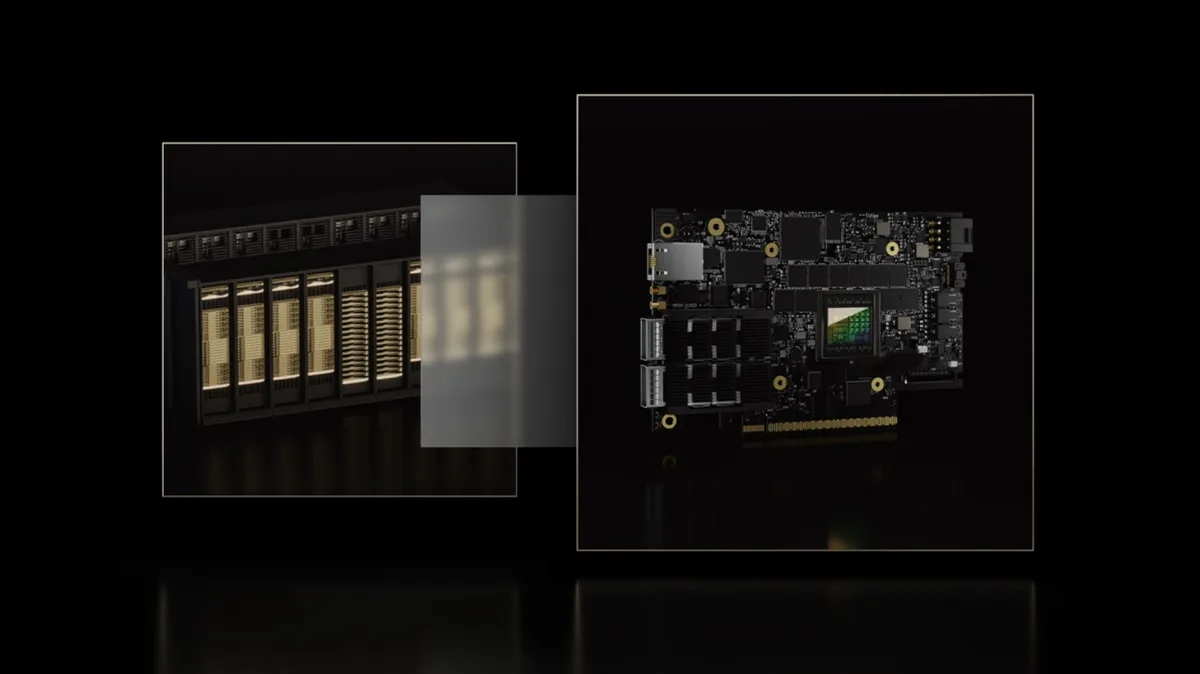
DPU NVIDIA BlueField

Процессоры обработки данных для сетей, хранения и безопасности

DPU BlueField снимают с серверного CPU задачи сети, хранения и безопасности и изолируют их на выделенном оборудовании.

Кому подходит: Облачные провайдеры, «фабрики ИИ» и организации, уделяющие особое внимание безопасности

Преимущества

  • Освобождает ядра CPU для приложений
  • Изолирует инфраструктурные сервисы от нагрузок клиентов
  • Программируется с помощью NVIDIA DOCA

Ключевые характеристики

ТипData processing unit (DPU) family
ПоколенияBlueField-3, BlueField-4
Программное обеспечениеNVIDIA DOCA

Что делает Workstation: Мы поставляем и устанавливаем карты BlueField и помогаем развернуть нужные вам сервисы DOCA.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Программное обеспечение

NVIDIA AI Enterprise

Поддерживаемое ПО для промышленной эксплуатации ИИ

Набор фреймворков ИИ, микросервисов NIM и инструментов NVIDIA с корпоративной поддержкой и ветками выпусков с длительным сроком поддержки.

Кому подходит: Любая организация, эксплуатирующая ИИ в продуктивной среде на GPU NVIDIA

Преимущества

  • Корпоративная поддержка и стабильные ветки выпусков
  • Микросервисы NIM ускоряют развёртывание моделей
  • Работает на системах NVIDIA-Certified локально или в облаке

Ключевые характеристики

ЛицензированиеPer GPU subscription
ВключаетAI frameworks, NIM microservices, pretrained models
ПоддержкаNVIDIA Enterprise Business Standard Support
Пробная версия90-day evaluation

Что делает Workstation: Мы готовим предложение и активируем лицензии, устанавливаем ПО вместе с вашим оборудованием и напоминаем о продлении заранее.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Программное обеспечение

NVIDIA Mission Control

ПО для эксплуатации «фабрик ИИ»

Mission Control автоматизирует повседневную эксплуатацию крупных GPU-кластеров — от оркестрации нагрузок до проверок работоспособности и восстановления.

Кому подходит: Операторы DGX SuperPOD и других крупных ИИ-кластеров

Преимущества

  • Автоматизирует рутинные операции с кластером
  • Повышает отказоустойчивость за счёт обнаружения сбоев и восстановления после них
  • Единое представление нагрузок и инфраструктуры

Ключевые характеристики

ТипAI-factory operations and cluster management software
ФункцииWorkload orchestration, infrastructure resiliency, cluster automation
Основа лицензированияConfirmed on quote

Что делает Workstation: Мы развёртываем Mission Control вместе с вашим кластером и обучаем ваших операторов работе с ним.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Программное обеспечение

NVIDIA Run:ai

Оркестрация и планирование GPU

Run:ai объединяет GPU разных команд в пул и распределяет их по запросу, чтобы дорогое оборудование работало, а не простаивало.

Кому подходит: Организации, в которых GPU совместно используют многие специалисты по данным или проекты

Преимущества

  • Более высокая загрузка GPU благодаря динамическому пулу
  • Квоты, приоритеты и управление доступом для справедливого распределения
  • Работает в локальных, гибридных и облачных средах

Ключевые характеристики

ТипGPU orchestration and scheduling platform
Работает наKubernetes
РазвёртываниеOn premises, hybrid or cloud
Основа лицензированияConfirmed on quote

Что делает Workstation: Мы устанавливаем Run:ai в ваш кластер Kubernetes, настраиваем квоты вместе с вашими командами и обеспечиваем поддержку.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Программное обеспечение

NVIDIA Base Command Manager

Развёртывание и мониторинг кластеров

Base Command Manager развёртывает, отслеживает и управляет GPU-кластерами — начиная с нескольких узлов.

Кому подходит: ИТ-команды, эксплуатирующие GPU-кластеры любого размера

Преимущества

  • Автоматизирует развёртывание на Arm и x86
  • Панели состояния и мониторинг в реальном времени
  • Веб-интерфейс, командная строка и API

Ключевые характеристики

ТипCluster management software
Бесплатная лицензияUp to 8 accelerators per system
Текущая версияBase Command Manager 11
ИнтерфейсыBaseView web UI, CLI, API

Что делает Workstation: Мы устанавливаем и настраиваем Base Command Manager в составе собираемых нами кластеров.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Программное обеспечение

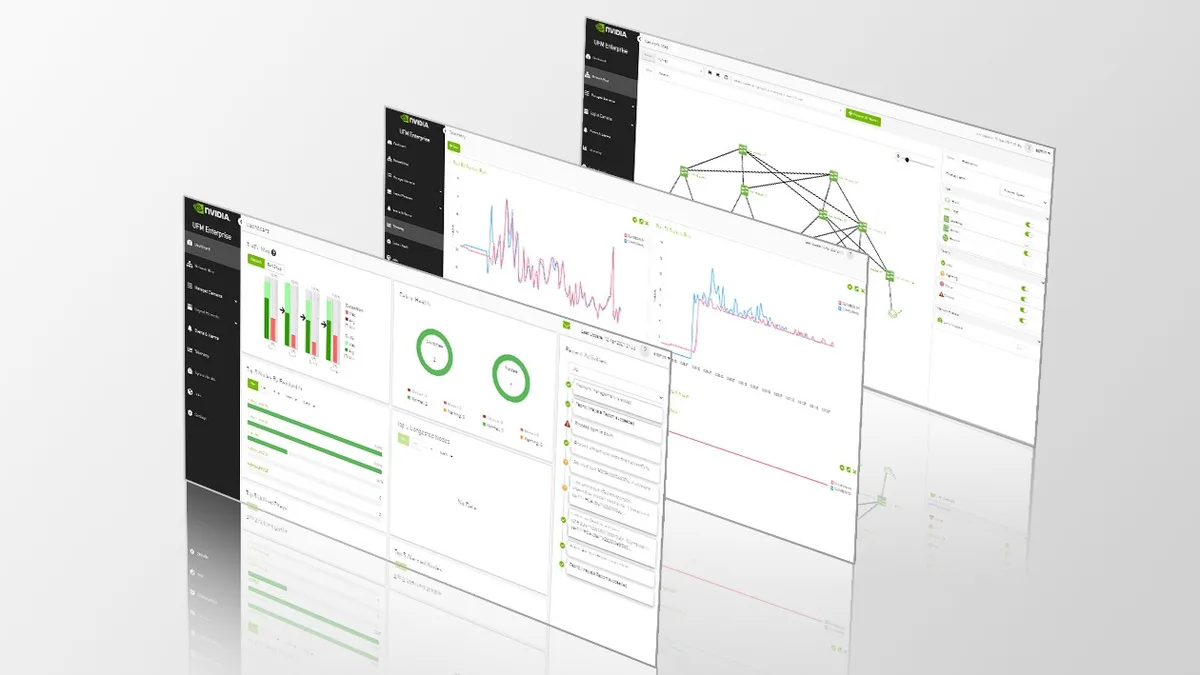
NVIDIA UFM

Unified Fabric Manager для InfiniBand

UFM отслеживает и управляет фабриками InfiniBand и помогает устранять в них неполадки.

Кому подходит: Команды, эксплуатирующие кластеры InfiniBand

Преимущества

  • Телеметрия фабрики в реальном времени
  • Более быстрый поиск неисправностей
  • Централизованное управление коммутаторами и каналами

Ключевые характеристики

ТипInfiniBand fabric management and telemetry software
Работает сNVIDIA Quantum InfiniBand switches

Что делает Workstation: Мы развёртываем UFM вместе с вашей фабрикой и настраиваем оповещения в соответствии с вашими эксплуатационными процедурами.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Программное обеспечение

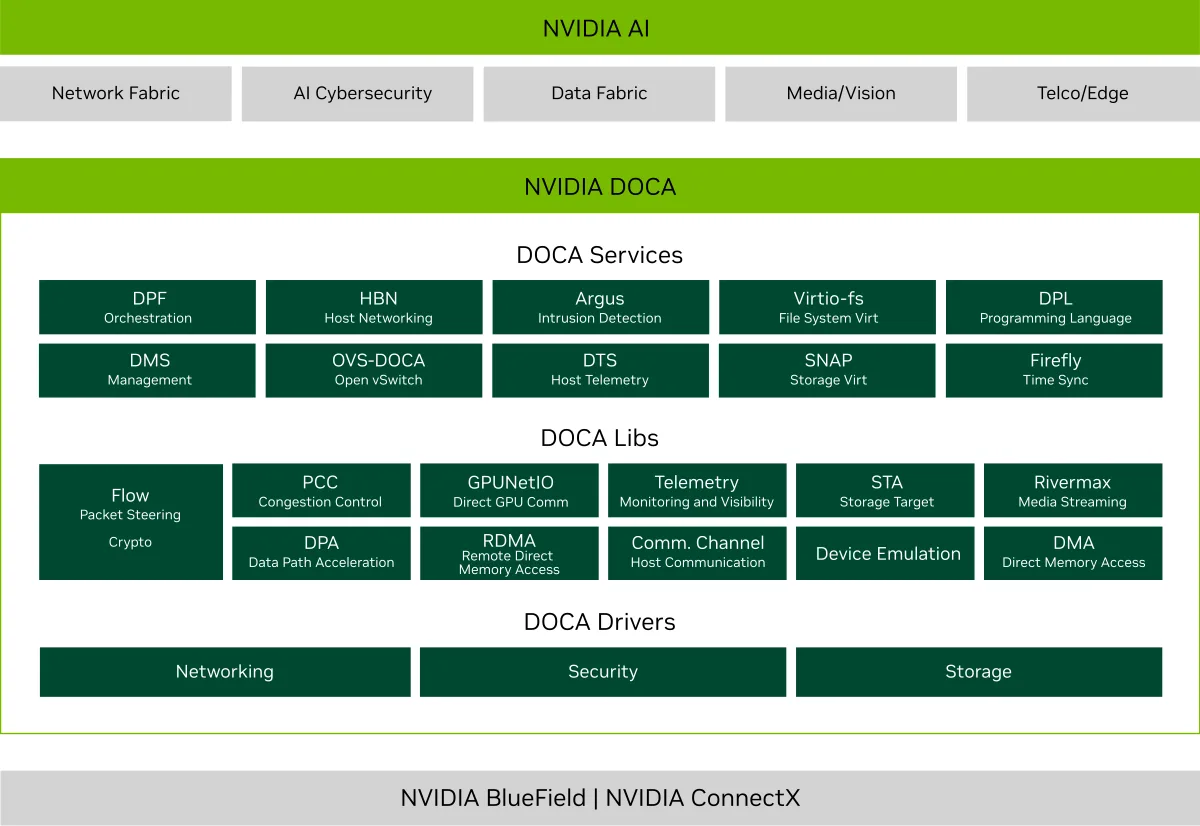
NVIDIA DOCA

Программный фреймворк для BlueField и SuperNIC

DOCA — это SDK и среда выполнения для создания сервисов, работающих на DPU BlueField и SuperNIC.

Кому подходит: Разработчики и платформенные команды, создающие решения на BlueField

Преимущества

  • Единый фреймворк для всех поколений DPU и SuperNIC
  • Ускоряет разработку сервисов с разгрузкой
  • Среда выполнения для развёртывания этих сервисов в продуктивной среде

Ключевые характеристики

ТипSDK and runtime framework
Работает наNVIDIA BlueField DPUs and SuperNICs

Что делает Workstation: Мы помогаем настроить среды DOCA и развернуть сервисы на поставляемых нами картах BlueField.

Цена по запросуЗапросить коммерческое предложение ↗
Смотреть на NVIDIA.com ↗

Характеристики приведены по опубликованным данным NVIDIA и могут меняться от ревизии к ревизии. Значения с пометкой sparse указаны с учётом разреженности. Точную конфигурацию, цену и срок поставки мы подтверждаем в каждом коммерческом предложении.

Что Workstation делает по каждому заказу

Одни и те же пять этапов — покупаете ли вы один GPU или целый ряд стоек

Подбор конфигурации

Мы начинаем с ваших моделей, данных, пользователей и площадки, а затем рассчитываем вычислительные ресурсы, память, сеть, электропитание и охлаждение.

Поставка

Мы закупаем оборудование через NVIDIA и её серверных партнёров, подтверждаем сроки поставки и держим вас в курсе до самой доставки.

Сборка и стресс-тестирование

Перед отправкой системы собираются, получают образ ПО и проходят стресс-тестирование под полной нагрузкой в нашей мастерской в Великобритании.

Установка

Наши инженеры доставляют, монтируют в стойку, прокладывают кабели и вводят систему в эксплуатацию на месте, а затем передают её вместе с документацией.

Поддержка

Та же команда занимается проблемами ПО, модернизацией, продлением лицензий и гарантийными случаями.

Все категории NVIDIA

Торговое членство

Торговые участники получают бесплатную техническую поддержку по каждому заказу и неограниченное время инженеров — помощь с конфигурацией, драйверами, ПО и устранением неполадок на весь срок владения оборудованием.

Подробнее о торговом членстве

NVIDIA Blackwell: от кристалла до дата-центра

NVIDIA Blackwell: The Journey From Die to Data Center. Воспроизводится с официального YouTube-канала NVIDIA. Смотреть на YouTubeNVIDIA, Blackwell, DGX, Grace и RTX PRO являются товарными знаками и/или зарегистрированными товарными знаками NVIDIA Corporation. Они указаны для описания поставляемых нами продуктов и не означают одобрения со стороны NVIDIA.

See the NVIDIA RTX PRO 6000 Blackwell Server Edition

NVIDIA RTX PRO: AI and visual computing on the RTX PRO 6000 Blackwell Server Edition. Video: NVIDIA Corporation. Воспроизводится с официального YouTube-канала NVIDIA. Смотреть на YouTubeRead about the RTX PRO 6000 Server Edition →NVIDIA, RTX PRO and Blackwell are trademarks and/or registered trademarks of NVIDIA Corporation. Shown to describe the products we supply; no endorsement by NVIDIA is implied.

Часто задаваемые вопросы

Почему цены на всё указываются по запросу?

Цены и квоты на оборудование для ускоренных вычислений быстро меняются, а большинство заказов зависит от точной конфигурации, площадки и ПО. Коммерческое предложение позволяет нам подтвердить актуальную цену, наличие и срок поставки именно того, что вам нужно.

Можете ли вы поставить один GPU, а не всю систему?

Да. Мы поставляем отдельные GPU для центров обработки данных, но всегда проверяем, что ваш сервер сертифицирован для их питания и охлаждения, и можем установить и протестировать их для вас.

Устанавливаете ли вы системы стоечного масштаба и системы с жидкостным охлаждением?

Да. Для таких систем, как GB300 NVL72, мы задолго до поставки прорабатываем с вашей службой эксплуатации здания электропитание, охлаждение и нагрузку на пол, а затем выполняем установку и ввод в эксплуатацию на месте.

С какой платформы NVIDIA нам начать?

Это зависит от ваших моделей, пользователей и площадки. Многие команды начинают с RTX PRO Server или L40S для смешанных задач ИИ и графики и переходят на HGX или DGX для крупномасштабного обучения. Поговорите с инженером, и мы порекомендуем оптимальную отправную точку.

Спланируйте свой проект ускоренных вычислений NVIDIA

Расскажите, какие задачи вам нужно выполнять и где должно размещаться оборудование. Инженер свяжется с вами с рекомендуемой конфигурацией и коммерческим предложением.

Поговорить с инженером