Workstation ਤਕਨੀਕੀ ਸੰਖੇਪ: LLM ਸਰਵਿੰਗ ਅਤੇ ਏਜੰਟਾਂ ਨਾਲ ਟਰਬੋਚਾਰਜ ਕਿਵੇਂ ਕਰੀਏ PagedAttention, vLLM, Self-Debugging, PowerInfer, ਅਤੇ EG-MLA. ਸਾਥੀ: ਬਲੌਗ · ਪ੍ਰਾਈਮਰ: ਕੁਬਰਨੇਟਸ ਲੇਖ 'ਤੇ LLMs · ਪ੍ਰਯੋਗਸ਼ਾਲਾ: ਐਂਟਰਪ੍ਰਾਈਜ਼ ਏਆਈ ਲੈਬ.
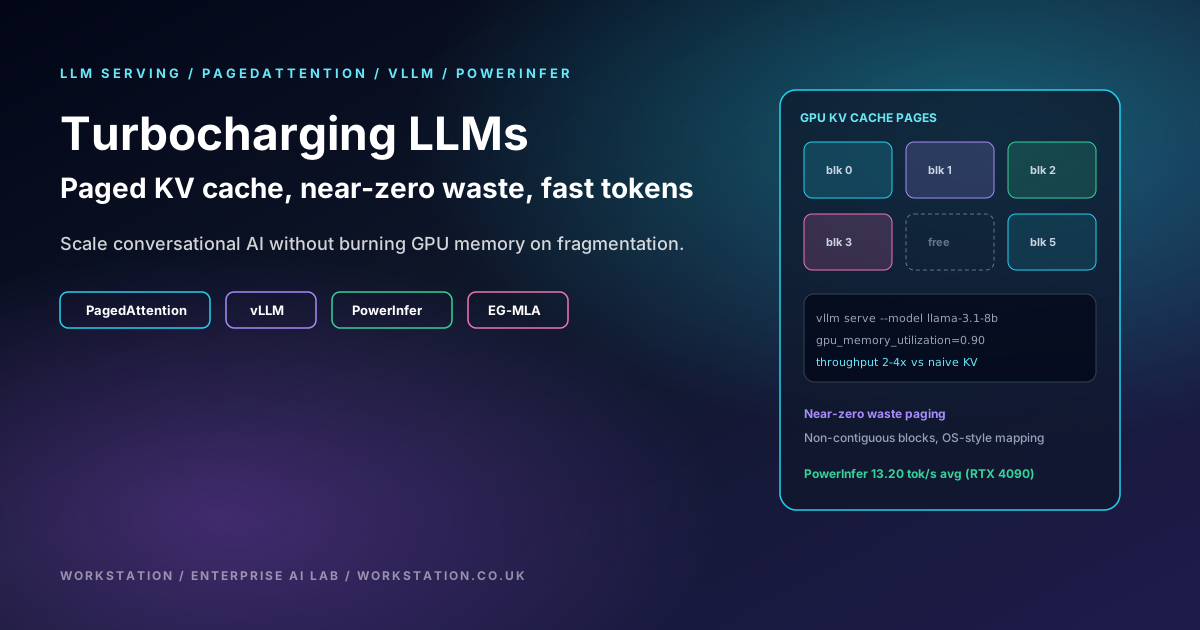
- ਰੁਕਾਵਟ: ਕੇਵੀ ਕੈਚ ਵਾਧਾ ਅਤੇ ਵਿਖੰਡਨ, ਐਬਸਟਰੈਕਟ ਵਿੱਚ "ਮਾਡਲ ਹੌਲੀ ਹੈ" ਨਹੀਂ।
- PagedAttention: ਕੇਵੀ ਬਲਾਕਾਂ ਦੀ OS-ਸ਼ੈਲੀ ਪੇਜਿੰਗ; ਟਿਊਨ ਬਲਾਕ ਆਕਾਰ ਅਤੇ ਕੈਸ਼ ਲੜੀ.
- vLLM: ਨੇੜੇ-ਜ਼ੀਰੋ ਕੇਵੀ ਵੇਸਟ + ਲਗਾਤਾਰ ਬੈਚਿੰਗ ਦੇ ਨਾਲ ਸਰਵਿੰਗ ਇੰਜਣ; TTFT ਬਨਾਮ ਟੋਕਨ/s ਦੇਖੋ।
- Self-Debugging: ਕੁਝ-ਸ਼ਾਟ ਪ੍ਰੋਗਰਾਮ ਦੀ ਮੁਰੰਮਤ ਵੱਡੇ ਉਮੀਦਵਾਰ ਸੈੱਟਾਂ ਨੂੰ ਹਰਾਉਂਦੀ ਹੈ; ਉਤਪਾਦ ਵਿੱਚ ਕੈਪ ਦੌਰ।
- PowerInfer: ਗਰਮ/ਠੰਡੇ ਵੰਡ; RTX 4090 (ਪੇਪਰ/ਰੇਪੋ ਅੰਕੜੇ) 'ਤੇ 13.20 ਟੋਕ/ਸੈਕੰਡ ਔਸਤ / 29.08 ਸਿਖਰ।
- EG-MLA: ਆਰਕੀਟੈਕਚਰ-ਪੱਧਰ ਕੇਵੀ ਕੰਪਰੈਸ਼ਨ (~91.6% ਬਨਾਮ MHA); ਸਵੈਪ ਤੋਂ ਪਹਿਲਾਂ ਮੁੜ-ਮੁਲਾਂਕਣ ਕਰੋ।
1. ਸੇਵਾ ਕਿਉਂ ਕਰਨੀ, ਸਿਖਲਾਈ ਨਹੀਂ, ਸੰਕਟ ਹੈ
ਵੱਡੇ ਭਾਸ਼ਾ ਮਾਡਲਾਂ ਨੇ NLP ਨੂੰ ਬਦਲ ਦਿੱਤਾ ਹੈ: ਚੈਟ, ਪੀੜ੍ਹੀ, ਔਜ਼ਾਰ। ਸਿਖਲਾਈ ਇੱਕ ਵਾਰ ਮਹਿੰਗਾ ਹੈ; ਸੇਵਾ ਕਰਨਾ ਹਰ ਸਕਿੰਟ ਮਹਿੰਗਾ ਹੈ। ਡੀਕੋਡ ਆਟੋਰੀਗਰੈਸਿਵ ਹੈ। ਹਰੇਕ ਨਵੇਂ ਟੋਕਨ ਨੂੰ ਪਿਛਲੀਆਂ ਕੁੰਜੀਆਂ ਅਤੇ ਮੁੱਲਾਂ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ। ਉਸ KV ਕੈਸ਼ ਲਈ ਮੈਮੋਰੀ ਲੇਅਰ × ਹੈੱਡ × ਹਿਡਨ × ਕ੍ਰਮ × ਬੈਚ ਦੇ ਅਨੁਪਾਤੀ ਹੈ। ਪ੍ਰੀਫਿਲ ਗਣਨਾ-ਭਾਰੀ ਹੈ; ਡੀਕੋਡ ਮੈਮੋਰੀ-ਬੈਂਡਵਿਡਥ-ਭਾਰੀ ਹੈ। ਜੇਕਰ ਤੁਸੀਂ ਪ੍ਰਤੀ ਬੇਨਤੀ ਇੱਕ ਅਨੁਕੂਲ ਅਧਿਕਤਮ-ਲੰਬਾਈ KV ਟੈਂਸਰ ਨਿਰਧਾਰਤ ਕਰਦੇ ਹੋ, ਤਾਂ ਇਸਦਾ ਜ਼ਿਆਦਾਤਰ ਹਿੱਸਾ ਉਦੋਂ ਤੱਕ ਖਾਲੀ ਹੁੰਦਾ ਹੈ ਜਦੋਂ ਤੱਕ ਕਿ ਕ੍ਰਮ ਅਸਲ ਵਿੱਚ ਨਹੀਂ ਵਧਦਾ — ਕਲਾਸਿਕ ਅੰਦਰੂਨੀ ਫ੍ਰੈਗਮੈਂਟੇਸ਼ਨ। ਸਮਕਾਲੀ ਬੇਨਤੀਆਂ ਉਹਨਾਂ ਛੇਕਾਂ ਨੂੰ ਚੋਰੀ ਨਹੀਂ ਕਰ ਸਕਦੀਆਂ। ਬੈਚ ਦਾ ਆਕਾਰ ਘਟਦਾ ਹੈ. ਟੋਕਨ ਪ੍ਰਤੀ ਸਕਿੰਟ ਡਰਾਪ। GPU ਵਿਅਸਤ ਅਤੇ ਅਜੇ ਵੀ ਵਿਹਲੇ ਲੱਗਦੇ ਹਨ।
ਇਹ ਸਮੱਸਿਆ ਹੈ PagedAttention ਅਤੇ vLLM 2023 ਵਿੱਚ ਹਮਲਾ ਕੀਤਾ ਗਿਆ ਸੀ, ਅਤੇ ਸਮੱਸਿਆ PowerInfer ਅਤੇ ਬਾਅਦ ਵਿੱਚ ਧਿਆਨ ਦੇਣ ਵਾਲੇ ਰੂਪ ਅਜੇ ਵੀ ਵੱਖ-ਵੱਖ ਕੋਣਾਂ ਤੋਂ ਹਮਲਾ ਕਰਦੇ ਹਨ।
ਦੇਖੋ: LLM ਮਾਨਸਿਕ ਮਾਡਲ
ਸੰਦਰਭ ਵੀਡੀਓ: ਵੱਡੀ ਭਾਸ਼ਾ ਦੇ ਮਾਡਲਾਂ ਦੀ ਜਾਣ-ਪਛਾਣ. Workstation ਵਿਆਖਿਆਕਾਰ: LLMs ਕਿਵੇਂ ਕੰਮ ਕਰਦੇ ਹਨ ਅਤੇ ਉਹਨਾਂ ਨੂੰ Kubernetes 'ਤੇ ਕਿਵੇਂ ਚਲਾਉਣਾ ਹੈ.
2. PagedAttention: ਕੇਵੀ ਕੈਸ਼ ਲਈ ਪੇਜਿੰਗ
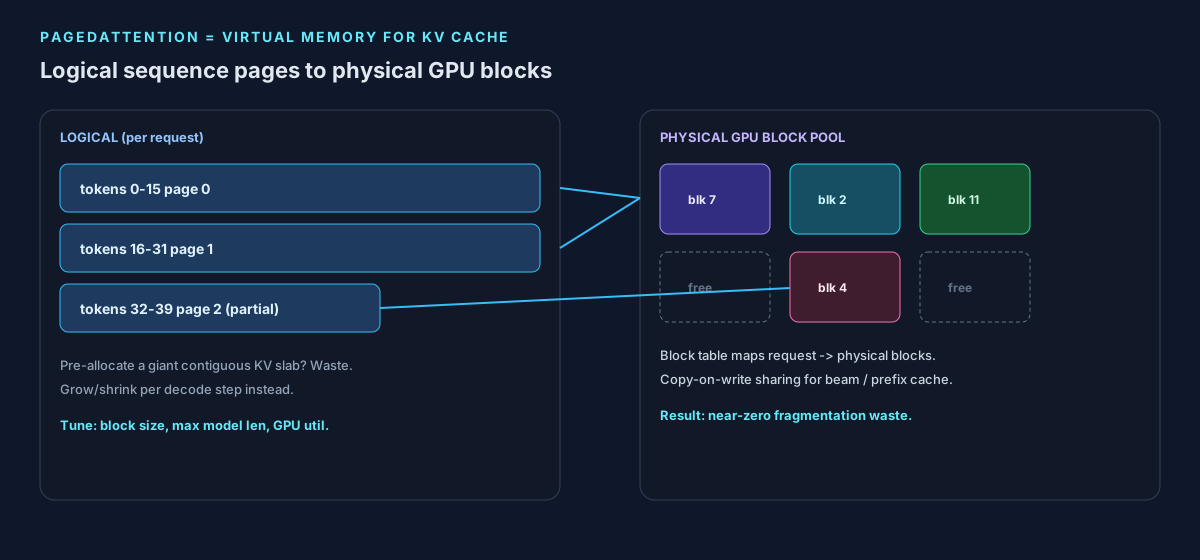
Kwon, Li, Zhuang, Sheng, Zheng, Yu, Gonzalez, Zhang, ਅਤੇ Stoica ਨੇ PagedAttention ਨੂੰ ਵਰਚੁਅਲ ਮੈਮੋਰੀ ਅਤੇ OS ਪੇਜਿੰਗ ਦੁਆਰਾ ਪ੍ਰੇਰਿਤ ਧਿਆਨ ਐਲਗੋਰਿਦਮ ਵਜੋਂ ਪੇਸ਼ ਕੀਤਾ, ਅਤੇ ਇਸਦੇ ਸਿਖਰ 'ਤੇ vLLM ਬਣਾਇਆ। [arXiv:2309.06180]. ਵਿਚਾਰ:
- ਕੇਵੀ ਨੂੰ ਵਿੱਚ ਵੰਡੋ ਸਥਿਰ ਆਕਾਰ ਦੇ ਬਲਾਕ (ਪ੍ਰਤੀ ਬਲਾਕ ਟੋਕਨਾਂ ਦੀ ਇੱਕ ਛੋਟੀ ਜਿਹੀ ਗਿਣਤੀ)
- ਰੱਖੋ ਏ ਬਲਾਕ ਸਾਰਣੀ ਲਾਜ਼ੀਕਲ ਟੋਕਨ ਪੋਜੀਸ਼ਨਾਂ ਤੋਂ ਭੌਤਿਕ GPU ਬਲਾਕਾਂ ਤੱਕ (ਸੰਭਵ ਤੌਰ 'ਤੇ ਗੈਰ-ਸੰਬੰਧਿਤ)।
- ਕ੍ਰਮ ਵਧਣ ਜਾਂ ਸਮਾਪਤ ਹੋਣ 'ਤੇ ਬਲਾਕ/ਮੁਫ਼ਤ ਬਲਾਕ ਅਲਾਟ ਕਰੋ — ਜਿਵੇਂ ਕਿ ਪੰਨਾ ਵੰਡ, ਨਾ ਕਿ ਇੱਕ ਵਿਸ਼ਾਲ ਐਰੇ ਦੇ ਮੈਲੋਕ ਵਾਂਗ।
- ਅਗੇਤਰ ਦੀ ਮੁੜ ਵਰਤੋਂ, ਬੀਮ ਖੋਜ, ਅਤੇ ਸਮਾਨਾਂਤਰ ਨਮੂਨੇ ਲਈ ਬਲਾਕ (ਕਾਪੀ-ਆਨ-ਰਾਈਟ) ਨੂੰ ਸਾਂਝਾ ਕਰੋ ਤਾਂ ਜੋ ਤੁਸੀਂ ਇੱਕੋ ਜਿਹੇ ਅਗੇਤਰਾਂ ਦੀ ਡੁਪਲੀਕੇਟ ਨਾ ਕਰੋ।
ਲਾਗੂ ਕਰਨਾ "BERT 'ਤੇ ਝੰਡਾ ਸੈੱਟ ਨਹੀਂ ਕੀਤਾ ਗਿਆ ਹੈ।" ਧਿਆਨ ਕਰਨਲ ਨੂੰ ਖਿੰਡੇ ਹੋਏ ਬਲਾਕ ਇਕੱਠੇ ਕਰਨੇ ਚਾਹੀਦੇ ਹਨ। ਸ਼ਡਿਊਲਰ ਨੂੰ ਪਤਾ ਹੋਣਾ ਚਾਹੀਦਾ ਹੈ ਕਿ ਕਿਹੜੇ ਬਲਾਕ ਮੁਫ਼ਤ ਹਨ। ਕੈਸ਼ ਲੜੀ ਮਾਇਨੇ ਰੱਖਦੀ ਹੈ: HBM-ਨਿਵਾਸੀ ਬਲਾਕ ਬਨਾਮ CPU ਆਫਲੋਡ ਬਨਾਮ NVLink ਪੀਅਰਜ਼। ਬਫਰ (ਬਲਾਕ) ਦਾ ਆਕਾਰ ਇੱਕ ਅਸਲੀ ਨੋਬ ਹੈ। ਬਹੁਤ ਛੋਟਾ: ਹੋਰ ਟੇਬਲ ਲੁੱਕਅੱਪ ਅਤੇ ਕਰਨਲ ਓਵਰਹੈੱਡ। ਬਹੁਤ ਵੱਡਾ: ਆਖਰੀ ਅੰਸ਼ਕ ਬਲਾਕ ਦੇ ਅੰਦਰ ਬਰਬਾਦ ਸਲਾਟ। ਨਾਲ ਬਲਾਕ ਆਕਾਰ ਜੋੜੋ max_model_len ਅਤੇ ਤੁਹਾਡੇ ਟ੍ਰੈਫਿਕ ਦਾ ਅਸਲ ਪ੍ਰੋਂਪਟ/ਪੂਰਨਤਾ ਮਿਸ਼ਰਣ।
ਅਭਿਆਸ: ਪ੍ਰੋਫਾਈਲ ਫ੍ਰੈਗਮੈਂਟੇਸ਼ਨ (ਅਣਵਰਤੇ KV ਬਾਈਟ / ਰਾਖਵੇਂ KV ਬਾਈਟ) ਅਤੇ ਟੋਕਨ/s ਇਕੱਠੇ। ਥ੍ਰੁਪੁੱਟ ਤੋਂ ਬਿਨਾਂ ਮੈਮੋਰੀ ਗ੍ਰਾਫ ਵਿਅਰਥ ਹਨ।
3. vLLM: ਪੇਜਰ ਦੇ ਦੁਆਲੇ ਸਰਵਿੰਗ ਸਿਸਟਮ
vLLM ਦਾ ਦਾਅਵਾ KV ਕੈਸ਼ ਮੈਮੋਰੀ ਵਿੱਚ ਅਤੇ ਬੇਨਤੀਆਂ ਦੇ ਅੰਦਰ ਲਚਕੀਲਾ ਸ਼ੇਅਰਿੰਗ ਵਿੱਚ ਜ਼ੀਰੋ ਦੇ ਨੇੜੇ ਹੈ। ਪੇਪਰ ਵਿੱਚ ਮੁਲਾਂਕਣ ਮੋਟੇ ਤੌਰ 'ਤੇ ਦਿਖਾਇਆ ਗਿਆ ਹੈ 2–4× ਥ੍ਰੋਪੁੱਟ ਬਨਾਮ ਫਿਰ-ਸੋਟਾ ਸਿਸਟਮ (ਫਾਸਟਰ ਟਰਾਂਸਫਾਰਮਰ, ਓਰਕਾ) ਸਮਾਨ ਲੇਟੈਂਸੀ 'ਤੇ, ਲੰਬੇ ਕ੍ਰਮ ਅਤੇ ਫੈਨਸੀਅਰ ਡੀਕੋਡਿੰਗ 'ਤੇ ਵੱਡੇ ਲਾਭਾਂ ਦੇ ਨਾਲ। ਅੱਜ ਇੰਜਣ ਮਲਟੀ-GPU ਲਈ ਲਗਾਤਾਰ ਬੈਚਿੰਗ, ਚੰਕਡ ਪ੍ਰੀਫਿਲ, ਪ੍ਰੀਫਿਕਸ ਕੈਚਿੰਗ, ਅਤੇ ਟੈਂਸਰ/ਪਾਈਪਲਾਈਨ ਸਮਾਨਾਂਤਰ ਵੀ ਭੇਜਦਾ ਹੈ।
ਕਾਰਜਸ਼ੀਲ ਚੈਕਲਿਸਟ:
- ਸੈੱਟ ਕਰੋ
gpu_memory_utilizationਭਾਰ ਰੱਖਣ ਲਈ ਕਾਫ਼ੀ ਉੱਚਾ + KV, CUDA ਵਰਕਸਪੇਸ ਛੱਡਣ ਲਈ ਕਾਫ਼ੀ ਘੱਟ। - ਤੁਹਾਡੇ ਵੱਲੋਂ eval ਸਕੋਰਾਂ ਦੀ ਪੁਸ਼ਟੀ ਕਰਨ ਅਤੇ p95 TTFT ਚਾਲੂ ਕਰਨ ਤੋਂ ਬਾਅਦ ਹੀ ਪ੍ਰੀਫਿਕਸ ਕੈਸ਼ਿੰਗ ਨੂੰ ਸਮਰੱਥ ਬਣਾਓ ਤੁਹਾਡਾ ਪੁੱਛਦਾ ਹੈ।
- ਜੇਕਰ ਮਿਸ਼ਰਤ ਟ੍ਰੈਫਿਕ SLO (ਵਿਸਥਾਰਿਤ ਸਰਵਿੰਗ) ਨੂੰ ਤਬਾਹ ਕਰ ਦਿੰਦਾ ਹੈ ਤਾਂ ਪ੍ਰੀਫਿਲ-ਹੈਵੀ ਅਤੇ ਡੀਕੋਡ-ਹੈਵੀ ਪੂਲ ਨੂੰ ਵੱਖ ਕਰੋ।
- ਤੁਹਾਡੇ ਗੇਟਵੇ ਦੇ ਪਿੱਛੇ ਓਪਨਏਆਈ-ਅਨੁਕੂਲ ਅੰਤਮ ਬਿੰਦੂਆਂ ਦਾ ਪਰਦਾਫਾਸ਼ ਕਰੋ (Workstation ਅਸਟੇਟ ਅਕਸਰ ਇਸਨੂੰ ਪਿੱਛੇ ਰੱਖਦੇ ਹਨ WSL Proxy / API ਗੇਟਵੇ ਪੈਟਰਨ).
from vllm import LLM, SamplingParams

llm = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    gpu_memory_utilization=0.90,
    max_model_len=8192,
    enable_prefix_caching=True,
)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Summarise PagedAttention for a platform engineer."], params)
print(outs[0].outputs[0].text)
ਐਂਟੀ-ਪੈਟਰਨ (ਇਹ ਹੈ ਨਹੀਂ PagedAttention):
# Classifier forward pass — logits, not paged KV serving
import torch
from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
out = model(torch.tensor([[1, 2, 3]]), attention_mask=torch.tensor([[1, 1, 1]]))
print(out.logits)
ਦੇਖੋ: ਜੰਗਲੀ ਵਿੱਚ ਸੇਵਾ ਕਰਨ ਵਾਲੇ ਸਿਸਟਮ
ਪ੍ਰਸੰਗਿਕ ਪਰੋਸਣ ਵਾਲੀ ਗੱਲ। ਕੈਨੋਨੀਕਲ ਲਿਖਣਾ: vLLM ਬਲੌਗ (PagedAttention) · ਇੰਜਣ: vllm-project/vllm.
4. Self-Debugging: ਪ੍ਰਤੀ ਉਮੀਦਵਾਰ ਵਧੇਰੇ ਗੁਣਵੱਤਾ, ਹੋਰ ਉਮੀਦਵਾਰ ਨਹੀਂ
ਚੇਨ, ਲਿਨ, ਕਲੇਨ, ਆਦਿ। ਨੇ ਦਿਖਾਇਆ ਕਿ ਇੱਕ LLM ਨੂੰ ਕੁਝ-ਸ਼ਾਟ ਪ੍ਰਦਰਸ਼ਨਾਂ ਦੇ ਨਾਲ ਇਸਦੇ ਪੂਰਵ-ਅਨੁਮਾਨਿਤ ਪ੍ਰੋਗਰਾਮ ਨੂੰ ਡੀਬੱਗ ਕਰਨ ਲਈ ਸਿਖਾਉਣਾ ਬੇਸਲਾਈਨ ਨਾਲ ਮੇਲ ਜਾਂ ਹਰਾ ਸਕਦਾ ਹੈ ਜੋ 10× ਤੋਂ ਵੱਧ ਉਮੀਦਵਾਰਾਂ ਨੂੰ ਉਤਪੰਨ ਕਰਦੇ ਹਨ। [arXiv:2304.05128]. ਲੂਪ ਹੈ: ਜਨਰੇਟ → ਐਗਜ਼ੀਕਿਊਟ ਜਾਂ ਯੂਨਿਟ-ਟੈਸਟ → ਫੀਡ ਟਰੇਸ ਬੈਕ → ਮੁਰੰਮਤ।
ਉਤਪਾਦਨ ਵਪਾਰ-ਬੰਦ: ਹਰੇਕ ਫੀਡਬੈਕ ਸੁਨੇਹਾ ਇੱਕ ਹੋਰ ਪ੍ਰੀਫਿਲ + ਡੀਕੋਡ (ਜਾਂ ਇੱਕ ਲੰਮਾ ਸੰਦਰਭ ਜੋੜ) ਹੁੰਦਾ ਹੈ। ਸ਼ੁੱਧਤਾ ਅਕਸਰ ਹੋਰ ਦੌਰ ਦੇ ਨਾਲ ਵੱਧਦੀ ਹੈ; ਇਸ ਤਰ੍ਹਾਂ ਲੇਟੈਂਸੀ ਅਤੇ ਲਾਗਤ ਵੀ ਹੈ। ਏਜੰਟਾਂ ਲਈ Workstation ਮਾਰਗਦਰਸ਼ਨ (ਇਹ ਵੀ ਦੇਖੋ Muse Glimmer / ਸਥਾਨਕ ਏਜੰਟ):
- ਡੀਬੱਗ ਦੌਰ (ਉਦਾਹਰਨ ਲਈ 2–4) ਪ੍ਰਤੀ ਟੂਲ ਕਾਲ 'ਤੇ ਹਾਰਡ ਕੈਪ।
- ਬਜਟ ਟੋਕਨ ਉਪਭੋਗਤਾ ਦੁਆਰਾ ਦਿਖਾਈ ਦੇਣ ਵਾਲੀ ਗੱਲਬਾਤ ਤੋਂ ਵੱਖਰੇ ਤੌਰ 'ਤੇ।
- ਅਨੰਤ ਮੁੜ-ਕੋਸ਼ਿਸ਼ ਦੀ ਬਜਾਏ ਇੱਕ ਮਨੁੱਖੀ ਜਾਂ ਮਾਹਰ ਮਾਡਲ ਵੱਲ ਵਧੋ।
- ਈਵਲ ਲਈ ਲੌਗ ਟਰੇਸ — ਟੈਲੀਮੈਟਰੀ ਤੋਂ ਬਿਨਾਂ Self-Debugging ਲੋਕਧਾਰਾ ਹੈ।
5. PowerInfer: ਇਲਾਕਾ-ਜਾਣੂ ਟੋਕਨ ਜਨਰੇਸ਼ਨ
PowerInfer (SJTU IPADS / ਸੰਬੰਧਿਤ ਰੀਪੋਜ਼) ਇੱਕ ਟੋਕਨ ਜਨਰੇਸ਼ਨ ਸਿਸਟਮ ਹੈ ਜੋ ਐਕਟੀਵੇਸ਼ਨ ਸਥਾਨ ਦਾ ਸ਼ੋਸ਼ਣ ਕਰਦਾ ਹੈ: GPU 'ਤੇ ਇੱਕ ਛੋਟਾ "ਗਰਮ" ਨਿਊਰੋਨ ਸੈੱਟ, CPU 'ਤੇ ਠੰਡੇ ਵਜ਼ਨ ਨੂੰ ਸਟ੍ਰੀਮ ਕੀਤਾ ਜਾਂ ਚਲਾਇਆ ਗਿਆ। ਪ੍ਰਕਾਸ਼ਿਤ ਓਪਰੇਟਿੰਗ ਪੁਆਇੰਟਸ ਵਿੱਚ ਸ਼ਾਮਲ ਹਨ 13.20 ਟੋਕਨ/ਸ ਔਸਤ ਅਤੇ 29.08 ਟੋਕਨ/s ਸਿਖਰ ਇੱਕ ਸਿੰਗਲ NVIDIA RTX 4090 'ਤੇ, ਅਤੇ ਇਸ ਤੱਕ 11.69× llama.cpp ਬਨਾਮ ਬਰਕਰਾਰ ਸ਼ੁੱਧਤਾ ਦੇ ਨਾਲ [PowerInfer GitHub]. (ਉਪਭੋਗਤਾ ਦਾ ਸਾਹਮਣਾ ਕਰਨ ਵਾਲੇ ਫੋਰਕ ਜਿਵੇਂ ਕਿ Tiiny-AI/PowerInfer ਕੰਮ ਦੀ ਇੱਕੋ ਲਾਈਨ ਨੂੰ ਟਰੈਕ ਕਰਦੇ ਹਨ।)
ਸਕੇਲ-ਆਊਟ ਔਖਾ ਹਿੱਸਾ ਹੈ। ਇੱਕ ਸਿੰਗਲ 4090 ਲੋਕਲਿਟੀ ਪ੍ਰੋਫਾਈਲ ਆਪਣੇ ਆਪ ਇੱਕ ਸਿਹਤਮੰਦ ਕੁਬਰਨੇਟਸ ਤੈਨਾਤੀ ਨਹੀਂ ਬਣ ਜਾਂਦੀ ਹੈ। ਤੁਹਾਨੂੰ ਲੋੜ ਹੈ:
- ਈਮਾਨਦਾਰ GPU ਬੇਨਤੀਆਂ/ਸੀਮਾਵਾਂ ਅਤੇ NUMA-ਜਾਗਰੂਕ CPU ਪਿਨਿੰਗ ਜੇਕਰ CPU ਮਾਹਰ ਚਲਾਉਂਦੇ ਹਨ।
- ਇੱਕ ਵੰਡੀ ਯੋਜਨਾ ਜੇਕਰ ਮਾਡਲ ਹੁਣ ਫਿੱਟ ਨਹੀਂ ਬੈਠਦਾ ਹੈ: ਟੈਂਸਰ ਪੈਰਲਲ ਬਨਾਮ ਪਾਈਪਲਾਈਨ ਬਨਾਮ ਮਾਹਰ ਸਮਾਨਾਂਤਰ।
- SLO ਸਪਲਿਟ: ਇੰਟਰਐਕਟਿਵ ਚੈਟ ਬਨਾਮ ਬੈਚ ਸੰਪੂਰਨਤਾ ਬਨਾਮ ਏਜੰਟ ਟੂਲ ਲੂਪਸ।
ਵਰਕਸਟੇਸ਼ਨਾਂ ਅਤੇ ਕਿਨਾਰੇ ਵਾਲੇ ਬਕਸੇ 'ਤੇ PowerInfer (ਜਾਂ llama.cpp, ਜਾਂ MLX) ਦੀ ਵਰਤੋਂ ਕਰੋ; vLLM (ਜਾਂ TensorRT-LLM, ਜਾਂ SGLang) ਦੀ ਵਰਤੋਂ ਕਰੋ ਜਦੋਂ ਤੁਸੀਂ ਸਮਕਾਲੀ OpenAI-ਸ਼ੈਲੀ ਟ੍ਰੈਫਿਕ ਨਾਲ ਡੇਟਾਸੈਂਟਰ GPU ਨੂੰ ਭਰ ਰਹੇ ਹੋ। ਦੋਵਾਂ ਨੂੰ ਮਾਪੋ. ਸਾਡਾ ਐਂਟਰਪ੍ਰਾਈਜ਼ ਏਆਈ ਲੈਬ ਸਥਿਤੀ Polyglot Benchmarks ਦੇ ਸਮਾਨ ਹੈ: ਸਬੂਤ, ਫਿਰ ADR।
6. EG-MLA: ਆਰਕੀਟੈਕਚਰ 'ਤੇ ਧਿਆਨ ਨੂੰ ਸੰਕੁਚਿਤ ਕਰੋ
ਸਰਵਿੰਗ ਟ੍ਰਿਕਸ ਇੱਕ ਮਾਡਲ ਨੂੰ ਠੀਕ ਨਹੀਂ ਕਰ ਸਕਦੀਆਂ ਜਿਸਦਾ KV ਅੰਦਰੂਨੀ ਤੌਰ 'ਤੇ ਵਿਸ਼ਾਲ ਹੈ। EG-MLA (ਏਮਬੈਡਿੰਗ-ਗੇਟਿਡ ਮਲਟੀ-ਹੈੱਡ ਲੇਟੈਂਟ ਅਟੈਨਸ਼ਨ) ਰਿਪੋਰਟਾਂ 91.6% ਤੋਂ ਵੱਧ ਕੇਵੀ ਕੈਸ਼ ਆਕਾਰ ਵਿੱਚ ਕਮੀ ਬਨਾਮ ਮਲਟੀ-ਹੈੱਡ ਅਟੈਨਸ਼ਨ (MHA) ਨਾ-ਮਾਤਰ ਪਤਨ ਦੇ ਨਾਲ, ਵਾਧੂ ਬੱਚਤਾਂ ਬਨਾਮ MLA (59.9% ਤੱਕ), ਅਤੇ ਤਰਕ-ਬੈਂਚਮਾਰਕ ਸ਼ੁੱਧਤਾ ਵਿੱਚ ਸੁਧਾਰ ਕੀਤਾ ਗਿਆ ਹੈ। ਲੇਖਕ ਦਲੀਲ ਦਿੰਦੇ ਹਨ ਕਿ ਏਮਬੈਡਿੰਗ ਗੇਟਿੰਗ ਉੱਚ-ਆਰਡਰ ਇੰਟਰੈਕਸ਼ਨਾਂ ਨੂੰ ਪ੍ਰੇਰਿਤ ਕਰਦੀ ਹੈ ਅਤੇ 1B ਪੈਰਾਮੀਟਰਾਂ ਦੇ ਪਿਛਲੇ ਸਕੇਲਿੰਗ ਨੂੰ ਦਿਖਾਉਂਦੀ ਹੈ [EG-MLA, arXiv].
ਇੰਜੀਨੀਅਰਿੰਗ ਅਰਥ: ਇਹ ਏ ਸਿਖਲਾਈ / ਆਰਕੀਟੈਕਚਰ ਫੈਸਲਾ। ਤੁਸੀਂ Llama-3 ਦੇ ਇੱਕ ਬੇਤਰਤੀਬੇ vLLM ਰਾਤ ਨੂੰ EG-MLA ਨੂੰ ਫਲਿੱਪ ਨਹੀਂ ਕਰ ਸਕਦੇ ਅਤੇ ਪੇਪਰ ਦੇ ਪ੍ਰਤੀਸ਼ਤ ਦੀ ਉਮੀਦ ਕਰ ਸਕਦੇ ਹੋ। ਜੇਕਰ ਤੁਸੀਂ ਪ੍ਰੀਟ੍ਰੇਨ ਜਾਂ ਜਾਰੀ ਪ੍ਰੀਟ੍ਰੇਨ ਨੂੰ ਨਿਯੰਤਰਿਤ ਕਰਦੇ ਹੋ, ਤਾਂ EG-MLA ਇੱਕ ਹੋਰ GPU ਖਰੀਦਣ ਤੋਂ ਪਹਿਲਾਂ HBM ਨੂੰ ਕੱਟਣ ਲਈ ਉਮੀਦਵਾਰ ਹੈ। ਜੇਕਰ ਤੁਸੀਂ ਸਿਰਫ਼ ਜਨਤਕ ਵਜ਼ਨ ਦੀ ਸੇਵਾ ਕਰਦੇ ਹੋ, ਤਾਂ PagedAttention + ਕੁਆਂਟਾਈਜ਼ੇਸ਼ਨ + MLA ਵੇਰੀਐਂਟ 'ਤੇ ਰਹੋ ਜੋ ਇੰਜਣ ਪਹਿਲਾਂ ਤੋਂ ਹੀ ਸਪੋਰਟ ਕਰਦਾ ਹੈ, ਅਤੇ EG-MLA ਚੈਕਪੁਆਇੰਟਾਂ ਨੂੰ ਟ੍ਰੈਕ ਕਰੋ ਜਦੋਂ ਉਹ ਉਤਰਦੇ ਹਨ।
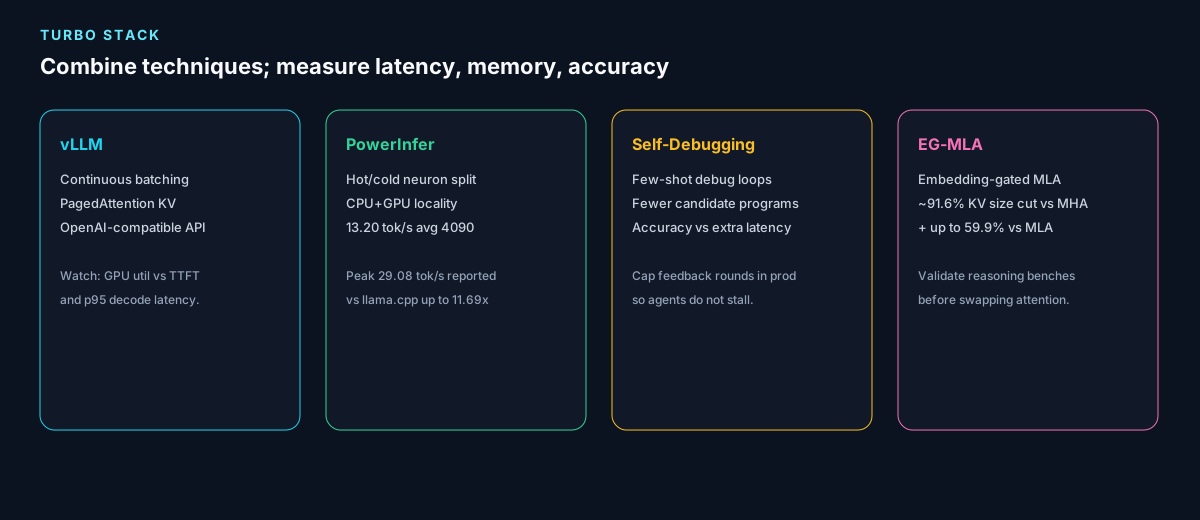
7. ਬਿਨਾਂ ਕਾਰਗੋ-ਕਲਿੰਗ ਦੇ ਸਟੈਕ ਨੂੰ ਜੋੜਨਾ
| ਪਰਤ | ਜਦੋਂ ਵਰਤੋ | ਵੇਖ ਕੇ |
|---|---|---|
| PagedAttention / vLLM | ਸਮਕਾਲੀ API ਸਰਵਿੰਗ, ਲੰਬੇ ਸੰਦਰਭ, ਸਾਂਝੇ ਅਗੇਤਰ | ਅਗੇਤਰ ਕੈਸ਼ ਬਨਾਮ ਸ਼ੁੱਧਤਾ; ਉੱਚ ਉਪਯੋਗਤਾ 'ਤੇ OOM |
| PowerInfer | ਸਿੰਗਲ ਫੈਟ GPU / ਵਰਕਸਟੇਸ਼ਨ ਟੋਕਨ ਰੇਟ | ਸਥਾਨਕਤਾ ਬੇਮੇਲ; ਗੜਬੜ ਸਕੇਲ-ਆਊਟ |
| Self-Debugging | ਕੋਡ/ਏਜੰਟ ਲੂਪਸ ਜੋ ਟੈਸਟ ਚਲਾ ਸਕਦੇ ਹਨ | ਬੇਅੰਤ ਦੌਰ; ਵਾਧੂ ਪ੍ਰੀਫਿਲ ਲਾਗਤ |
| EG-MLA | ਤੁਸੀਂ ਰੀੜ੍ਹ ਦੀ ਹੱਡੀ ਨੂੰ ਸਿਖਲਾਈ ਦਿੰਦੇ ਹੋ ਜਾਂ ਠੀਕ ਕਰਦੇ ਹੋ | ਸੇਵਾ ਕਰਨ ਵਾਲਾ ਝੰਡਾ ਨਹੀਂ; ਪੂਰੀ eval ਮੁੜ-ਚਲਾਓ |
8. ਕੁਬਰਨੇਟਸ 'ਤੇ ਸਕੇਲੇਬਿਲਟੀ
ਇੱਕ ਚੰਗੀ ਤਰ੍ਹਾਂ ਡਿਜ਼ਾਇਨ ਕੀਤਾ ਡਿਸਟ੍ਰੀਬਿਊਟ ਆਰਕੀਟੈਕਚਰ ਥ੍ਰੁਪੁੱਟ ਨੂੰ ਵਧਾਉਂਦਾ ਹੈ ਅਤੇ ਅਸਫਲਤਾ ਮੋਡਾਂ ਨੂੰ ਵੀ ਵਧਾਉਂਦਾ ਹੈ: ਸਟ੍ਰਾਗਲਰ, ਕੇਵੀ ਕੈਸ਼ ਟ੍ਰਾਂਸਫਰ, ਟੋਕਨਾਈਜ਼ਰ ਸਕਿਊ, ਅਤੇ ਆਟੋਸਕੇਲਰ ਜੋ ਗਰਮ ਅਗੇਤਰਾਂ ਨੂੰ ਮਾਰਦੇ ਹਨ। ਵਿਹਾਰਕ ਪੈਟਰਨ (ਸਾਡੇ ਨਾਲ ਇਕਸਾਰ ਕੁਬਰਨੇਟਸ 'ਤੇ Ollama / vLLM ਲਿਖਣਾ):
- ਸਮਰਪਿਤ GPU ਨੋਡ ਪੂਲ; ਕਦੇ ਵੀ ਬੇਤਰਤੀਬ CPU ਨੌਕਰੀਆਂ ਨਾਲ ਡੀਕੋਡ ਪੌਡਾਂ ਨੂੰ ਪੈਕ ਨਾ ਕਰੋ।
- ਜੇਕਰ TTFT SLO ਅਤੇ ਟੋਕਨ/s SLO ਲੜਦੇ ਹਨ ਤਾਂ ਵੱਖਰਾ ਪ੍ਰੀਫਿਲ ਅਤੇ ਡੀਕੋਡ ਕਰੋ।
- ਕਤਾਰ ਦੀ ਡੂੰਘਾਈ 'ਤੇ HPA ਜਾਂ GPU KV ਆਕੂਪੈਂਸੀ, ਨਾ ਸਿਰਫ਼ CPU।
- ਰਿੰਗਾਂ ਰਾਹੀਂ ਸਰਵਿੰਗ ਸਟੈਕ ਨੂੰ ਉਤਸ਼ਾਹਿਤ ਕਰੋ (Ring Promoter) ਇਸ ਲਈ ਇੱਕ ਖਰਾਬ ਇੰਜਣ ਬਿਲਡ ਟੈਸਟ ਨੂੰ ਛੱਡ ਨਹੀਂ ਸਕਦਾ।
9. ਸਿੱਟਾ
ਟਰਬੋਚਾਰਜਿੰਗ LLMs ਇੱਕ ਐਲਗੋਰਿਦਮ ਨਹੀਂ ਹੈ। ਇਹ ਕੇਵੀ ਕੈਸ਼ (PagedAttention) ਨੂੰ ਪੇਜ ਕਰ ਰਿਹਾ ਹੈ, ਇੱਕ ਸਰਵਿੰਗ ਇੰਜਣ ਜੋ ਉਹਨਾਂ ਪੰਨਿਆਂ (vLLM) ਨੂੰ ਬਰਬਾਦ ਨਹੀਂ ਕਰਦਾ, ਸਥਾਨਕਤਾ-ਜਾਗਰੂਕ ਪੀੜ੍ਹੀ ਜਦੋਂ ਹਾਰਡਵੇਅਰ ਇੱਕ ਵਰਕਸਟੇਸ਼ਨ GPU (PowerInfer), ਏਜੰਟ ਲੂਪ ਜੋ ਉਮੀਦਵਾਰਾਂ ਨੂੰ ਛਿੜਕਣ ਦੀ ਬਜਾਏ ਡੀਬੱਗ ਕਰਦਾ ਹੈ (Self-Debugging), ਅਤੇ - ਜਦੋਂ ਤੁਸੀਂ ਵਜ਼ਨ ਦੇ ਮਾਲਕ ਹੁੰਦੇ ਹੋ — ਧਿਆਨ ਜੋ ਸਿਰਫ਼ ਘੱਟ ਸਟੋਰ ਕਰਦਾ ਹੈ (XPR2)। ਹਰ ਪਰਤ ਮੈਮੋਰੀ, ਲੇਟੈਂਸੀ, ਅਤੇ ਸ਼ੁੱਧਤਾ ਦਾ ਵਪਾਰ ਕਰਦੀ ਹੈ। ਆਪਣੇ ਆਵਾਜਾਈ ਨੂੰ ਮਾਪੋ. ADR ਪ੍ਰਕਾਸ਼ਿਤ ਕਰੋ। ਜਹਾਜ਼.
ਹਵਾਲੇ
- Kwon et al. - PagedAttention ਦੇ ਨਾਲ ਵੱਡੀ ਭਾਸ਼ਾ ਦੇ ਮਾਡਲ ਦੀ ਸੇਵਾ ਲਈ ਕੁਸ਼ਲ ਮੈਮੋਰੀ ਪ੍ਰਬੰਧਨ (arXiv:2309.06180, 14 ਸਤੰਬਰ 2023)।
- ਚੇਨ ਐਟ ਅਲ. - ਸਵੈ-ਡੀਬੱਗ ਲਈ ਵੱਡੀ ਭਾਸ਼ਾ ਦੇ ਮਾਡਲਾਂ ਨੂੰ ਸਿਖਾਉਣਾ (arXiv:2304.05128, 12 ਅਪ੍ਰੈਲ 2023)।
- PowerInfer — SJTU-IPADS/PowerInfer (ਅਤੇ ਸੰਬੰਧਿਤ Tiiny-AI ਫੋਰਕਸ)।
- EG-MLA — ਏਮਬੈਡਿੰਗ-ਗੇਟਿਡ ਮਲਟੀ-ਹੈੱਡ ਲੇਟੈਂਟ ਧਿਆਨ (arXiv, 20 ਸਤੰਬਰ 2025)।
- vLLM ਬਲੌਗ — PagedAttention ਨਾਲ ਆਸਾਨ, ਤੇਜ਼ ਅਤੇ ਸਸਤੀ LLM ਸੇਵਾ.
ਦੁਆਰਾ ਪ੍ਰਕਾਸ਼ਿਤ Workstation. ਅਸਲ ਲੇਖਕਾਂ ਦੁਆਰਾ ਪ੍ਰਕਾਸ਼ਿਤ ਕੀਤੇ ਗਏ ਕਾਗਜ਼ੀ ਅੰਕੜੇ; ਤੁਹਾਡੇ ਕਲੱਸਟਰ 'ਤੇ ਉਤਪਾਦਨ ਨੰਬਰ ਵੱਖਰੇ ਹੋਣਗੇ।


