ਟਰਬੋਚਾਰਜਿੰਗ LLMs
PagedAttention, vLLM, Self-Debugging, PowerInfer, ਅਤੇ EG-MLA — GPU ਕੇਵੀ ਕੈਚ ਨੂੰ ਬਰਬਾਦ ਕੀਤੇ ਬਿਨਾਂ LLM ਏਜੰਟਾਂ ਨੂੰ ਕਿਵੇਂ ਸਕੇਲ ਕਰਨਾ ਹੈ
 Balinder Walia30 ਅਗਸਤ 20264 min read
Workstationਉਤਪਾਦਨ ਵਿੱਚ ਵੱਡੇ ਭਾਸ਼ਾ ਮਾਡਲਾਂ ਨੂੰ ਕਿਵੇਂ ਟਰਬੋਚਾਰਜ ਕਰਨਾ ਹੈ: PagedAttention, vLLM, Self-Debugging, PowerInfer, ਅਤੇ EG-MLA — ਅਸਲ ਵਿੱਚ GPUs 'ਤੇ ਦਿਖਾਈ ਦੇਣ ਵਾਲੇ ਟ੍ਰੇਡ-ਆਫ ਦੇ ਨਾਲ। ਡੂੰਘੀ ਗੋਤਾਖੋਰੀ:ਲੰਬਾ ਲੇਖ। ਪ੍ਰਾਈਮਰ:LLMs ਸਮਝਾਇਆ + Kubernetes।
ਵਾਚ: ਇੱਕ LLM ਅਸਲ ਵਿੱਚ
ਕੀ ਹੈਸੰਦਰਭ, ਉਤਪਾਦ ਡੈਮੋ ਨਹੀਂ:ਵੱਡੀ ਭਾਸ਼ਾ ਦੇ ਮਾਡਲਾਂ ਲਈ(ਐਂਡਰੇਜ ਕਾਰਪੈਥੀ) ਦੀ ਪਛਾਣ। ਸਾਡੀਪਲੇਨ-ਅੰਗਰੇਜ਼ੀ LLM + Kubernetes ਗਾਈਡਨਾਲ ਜੋੜਾ ਬਣਾਓ।
ਸਕੇਲਿੰਗ ਸਮੱਸਿਆ
LLMs ਨੇ ਗੱਲਬਾਤ ਵਾਲੀ AI ਅਤੇ ਪੀੜ੍ਹੀ ਨੂੰ ਅਨਲੌਕ ਕੀਤਾ, ਫਿਰ ਤੁਰੰਤ ਇੱਕ ਸੇਵਾ ਸਮੱਸਿਆ ਬਣ ਗਈ। ਹਰੇਕ ਡੀਕੋਡ ਪਗ ਇੱਕ KV ਕੈਸ਼ ਵਿੱਚ ਕੁੰਜੀਆਂ ਅਤੇ ਮੁੱਲ ਜੋੜਦਾ ਹੈ ਜੋ ਕ੍ਰਮ ਦੀ ਲੰਬਾਈ ਅਤੇ ਬੈਚ ਆਕਾਰ ਨਾਲ ਵਧਦਾ ਹੈ। ਭੋਲੇ-ਭਾਲੇ ਇੰਜਣ ਵੱਡੀਆਂ ਸੰਗਠਿਤ ਸਲੈਬਾਂ ਨੂੰ ਪੂਰਵ-ਰਿਜ਼ਰਵ ਰੱਖਦੇ ਹਨ। ਉਸ ਵਿੱਚੋਂ ਜ਼ਿਆਦਾਤਰ ਮੈਮੋਰੀ ਵਿਹਲੀ ਰਹਿੰਦੀ ਹੈ ਜਦੋਂ ਕਿ ਹੋਰ ਬੇਨਤੀਆਂ ਉਡੀਕ ਕਰਦੀਆਂ ਹਨ। GPU "ਪੂਰਾ" ਦਿਸਣ ਦੇ ਬਾਵਜੂਦ ਥ੍ਰੂਪੁੱਟ ਸਮੇਟਦਾ ਹੈ।
PagedAttention: ਧਿਆਨ
ਲਈ ਵਰਚੁਅਲ ਮੈਮੋਰੀ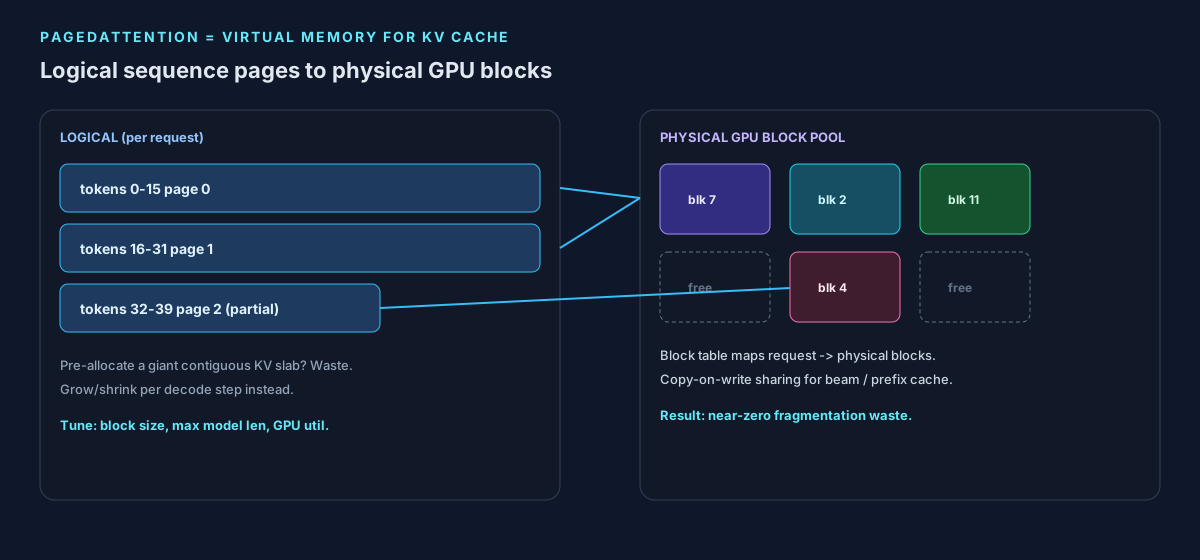
PagedAttention (Kwon et al., SOSP 2023) KV ਕੈਸ਼ ਨੂੰ OS ਪੇਜਿੰਗ ਵਾਂਗ ਵਰਤਦਾ ਹੈ: ਫਿਕਸਡ-ਸਾਈਜ਼ ਬਲਾਕ, ਪ੍ਰਤੀ ਬੇਨਤੀ ਇੱਕ ਬਲਾਕ ਟੇਬਲ, ਗੈਰ-ਸੰਬੰਧਿਤ ਭੌਤਿਕ ਪੰਨੇ[arXiv:2309.06180]। ਕਰਨਲ ਧਿਆਨ ਦੇ ਸਮੇਂ ਬਲਾਕਾਂ ਨੂੰ ਇਕੱਠਾ ਕਰਦਾ ਹੈ। ਤੁਹਾਨੂੰ ਅਜੇ ਵੀਬਲਾਕ ਆਕਾਰ,ਅਧਿਕਤਮ ਮਾਡਲ ਲੰਬਾਈ, ਅਤੇਕੈਸ਼ ਲੜੀ(GPU HBM ਬਨਾਮ CPU ਆਫਲੋਡ ਬਨਾਮ ਪ੍ਰੀਫਿਕਸ ਕੈਸ਼) ਨੂੰ ਟਿਊਨ ਕਰਨਾ ਚਾਹੀਦਾ ਹੈ। ਬਹੁਤ ਛੋਟੇ ਬਲਾਕ ਮੈਪਿੰਗ ਓਵਰਹੈੱਡ ਜੋੜਦੇ ਹਨ; ਬਹੁਤ ਵੱਡੇ ਬਲਾਕ ਕੂੜੇ ਨੂੰ ਦੁਬਾਰਾ ਪੇਸ਼ ਕਰਦੇ ਹਨ।
vLLM:
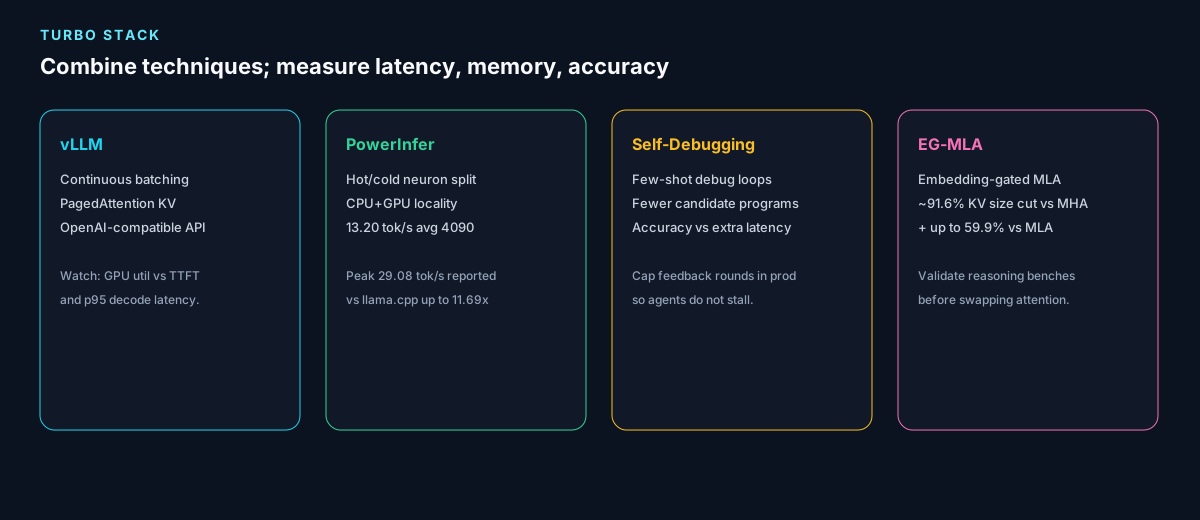
ਦੀ ਸੇਵਾ ਕਰਨ ਵਾਲਾ ਲਗਭਗ-ਜ਼ੀਰੋ ਵੇਸਟvLLM PagedAttention ਦੇ ਆਲੇ-ਦੁਆਲੇ ਬਣਾਇਆ ਸਰਵਿੰਗ ਸਿਸਟਮ ਹੈ। ਇਹ ਨੇੜੇ-ਜ਼ੀਰੋ ਕੇਵੀ ਰਹਿੰਦ-ਖੂੰਹਦ, ਨਿਰੰਤਰ ਬੈਚਿੰਗ, ਅਤੇ ਇੱਕ OpenAI- ਅਨੁਕੂਲ HTTP ਸਤਹ ਨੂੰ ਨਿਸ਼ਾਨਾ ਬਣਾਉਂਦਾ ਹੈ। ਉਤਪਾਦਨ ਵਿੱਚ, ਤਿੰਨ ਚੀਜ਼ਾਂ ਦੇਖੋ: (1)gpu_memory_utilizationਬਨਾਮ OOM, (2) ਟਾਈਮ-ਟੂ-ਫਸਟ-ਟੋਕਨ ਬਨਾਮ ਡੀਕੋਡ ਟੋਕਨ/s, (3) ਕੀ ਪ੍ਰੀਫਿਕਸ / ਪ੍ਰੋਂਪਟ ਕੈਚਿੰਗ ਤੁਹਾਡੇ ਈਵਲ ਸੈੱਟ ਲਈ ਜਵਾਬ ਬਦਲਦੀ ਹੈ। ਕੈਚਿੰਗ ਇੱਕ ਥ੍ਰੋਪੁੱਟ ਜਿੱਤ ਹੈ; ਇਹ ਸ਼ੁੱਧਤਾ ਅਤੇ ਟੇਲ-ਲੇਟੈਂਸੀ ਪ੍ਰਭਾਵਾਂ ਤੋਂ ਮੁਕਤ ਨਹੀਂ ਹੈ।
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)
ਇਹ ਅਸਲ vLLM ਵਰਤੋਂ ਹੈ। ਇੱਕ ਹੱਗਿੰਗ ਫੇਸ BERTforward()ਕਾਲਹੈPagedAttention ਨਹੀਂ — ਪੇਜਡ KV ਸਰਵਿੰਗ ਨਾਲ ਕਲਾਸੀਫਾਇਰ ਲੌਗਿਟਸ ਨੂੰ ਉਲਝਾਓ ਨਾ।
Self-Debugging: ਲੇਟੈਂਸੀ ਬਜਟ
ਦੇ ਨਾਲ ਕੁਆਲਿਟੀ ਲੂਪਸSelf-Debugging (ਚੇਨ ਐਟ ਅਲ.) ਇੱਕ ਮਾਡਲ ਨੂੰ ਕੁਝ-ਸ਼ੌਟ ਟਰੇਸ, ਮੇਲ ਖਾਂਦੀਆਂ ਜਾਂ ਬੇਸਲਾਈਨਾਂ ਤੋਂ ਆਪਣੇ ਖੁਦ ਦੇ ਪੂਰਵ-ਅਨੁਮਾਨਿਤ ਪ੍ਰੋਗਰਾਮਾਂ ਨੂੰ ਠੀਕ ਕਰਨ ਲਈ ਸਿਖਾਉਂਦਾ ਹੈ ਜੋ 10 ਗੁਣਾ ਜ਼ਿਆਦਾ ਉਮੀਦਵਾਰਾਂ ਨੂੰ ਛੱਡਦਾ ਹੈ[arXiv:2304.05128]। ਏਜੰਟਾਂ ਲਈ, ਇਹ ਸੋਨਾ ਹੈ - ਜਦੋਂ ਤੱਕ ਫੀਡਬੈਕ ਰਾਊਂਡ ਸਟੈਕ ਨਹੀਂ ਹੁੰਦਾ। ਡੀਬੱਗ ਸੁਨੇਹਿਆਂ ਦੀ ਸੰਖਿਆ ਨੂੰ ਕੈਪ ਕਰੋ, ਹਰੇਕ ਗੇੜ ਨੂੰ ਲੌਗ ਕਰੋ, ਅਤੇ ਬਜਟ ਖਤਮ ਹੋਣ 'ਤੇ ਮਨੁੱਖੀ ਜਾਂ ਕਿਸੇ ਛੋਟੇ ਮਾਹਰ ਮਾਡਲ ਲਈ ਫੇਲ ਹੋਵੋ।
ਵਾਚ: ਸਰਵਿੰਗ ਅਤੇ ਅਨੁਮਾਨ ਸੰਦਰਭ
ਤੇਜ਼ LLM ਸਰਵਿੰਗ 'ਤੇ ਸੰਦਰਭੀ ਗੱਲਬਾਤ — ਅਧਿਕਾਰਤ Workstation ਡੈਮੋ ਨਹੀਂ। vLLM ਪੇਪਰ ਅਤੇdocs.vllm.aiਨਾਲ ਜੋੜਾ ਬਣਾਓ।
PowerInfer: ਸਿੰਗਲ ਫੈਟ GPU
'ਤੇ ਟੋਕਨPowerInfer ਗਰਮ/ਠੰਡੇ ਨਿਊਰੋਨਸ ਨੂੰ ਵੰਡਦਾ ਹੈ ਤਾਂ ਕਿ ਇੱਕ ਖਪਤਕਾਰ GPU ਪਲੱਸ CPU ਤੇਜ਼ੀ ਨਾਲ ਟੋਕਨ ਤਿਆਰ ਕਰ ਸਕੇ। ਰਿਪੋਰਟ ਕੀਤੇ ਅੰਕੜੇ:13.20 ਟੋਕਨ/s ਔਸਤ, ਇੱਕ NVIDIA RTX 4090 'ਤੇ ਸਿਖਰ29.08 ਟੋਕਨ/s, ਸ਼ੁੱਧਤਾ ਰੱਖਦੇ ਹੋਏ11.69xਬਨਾਮ llama.cpp ਤੱਕ। ਫਲੀਟ ਪੈਮਾਨੇ 'ਤੇ ਤੁਹਾਨੂੰ ਅਜੇ ਵੀ ਪਲੇਸਮੈਂਟ ਦੀ ਲੋੜ ਹੈ: GPU 'ਤੇ ਕਿਹੜੀਆਂ ਲੇਅਰਾਂ ਰਹਿੰਦੀਆਂ ਹਨ, ਤੁਸੀਂ ਨੋਡਾਂ ਵਿੱਚ ਕਿਵੇਂ ਸ਼ਾਰਡ ਕਰਦੇ ਹੋ, ਅਤੇ ਕੀਦਾ ਸਥਾਨਕ ਪ੍ਰੋਫਾਈਲ ਤੁਹਾਡੇਪ੍ਰੋਂਪਟ ਪੇਪਰ ਦੇ ਮਾਡਲਾਂ ਨਾਲ ਮੇਲ ਖਾਂਦਾ ਹੈ।
EG-MLA: ਬੈਂਚ ਨੂੰ ਖਰਾਬ ਕੀਤੇ ਬਿਨਾਂ KV ਨੂੰ ਸੁੰਗੜੋ
EG-MLA (ਏਮਬੈਡਿੰਗ-ਗੇਟਿਡ ਮਲਟੀ-ਹੈੱਡ ਲੇਟੈਂਟ ਅਟੈਨਸ਼ਨ) ਰਿਪੋਰਟ ਕਰਦਾ ਹੈਵੱਧ 91.6% KV ਕੈਸ਼ ਕਟੌਤੀਬਨਾਮ ਮਲਟੀ-ਹੈੱਡ ਅਟੈਨਸ਼ਨ ਨਾ-ਮਾਤਰ ਗਿਰਾਵਟ ਦੇ ਨਾਲ, ਵਾਧੂ ਬੱਚਤ ਬਨਾਮ MLA (59.9% ਤੱਕ), ਅਤੇ ਤਰਕ ਸੂਈਟਾਂ 'ਤੇ ਬਿਹਤਰ ਸਕੋਰ, XTAGX9 ਪੈਰਾਮੀਟਰ ਪਿਛਲੇ XTAGX9 ਪੇਪਰ ਸਕੇਲ. ਇਸਨੂੰ ਇੱਕ ਆਰਕੀਟੈਕਚਰ ਵਿਕਲਪ ਦੇ ਰੂਪ ਵਿੱਚ ਸਮਝੋ, ਨਾ ਕਿ ਇੱਕ ਜੰਮੇ ਹੋਏ vLLM ਚੈਕਪੁਆਇੰਟ 'ਤੇ ਡ੍ਰੌਪ-ਇਨ ਫਲੈਗ - ਮੈਮੋਰੀ ਗ੍ਰਾਫ ਦਾ ਜਸ਼ਨ ਮਨਾਉਣ ਤੋਂ ਪਹਿਲਾਂ ਆਪਣੇ ਈਵਲ ਹਾਰਨੇਸ ਨੂੰ ਪ੍ਰਮਾਣਿਤ ਕਰੋ।
ਇਸਨੂੰ ਇਕੱਠੇ ਰੱਖਣਾ
ਕਲੱਸਟਰ ਸਰਵਿੰਗ ਲਈ PagedAttention + vLLM, PowerInfer ਜਦੋਂ ਬਾਕਸ ਇੱਕ ਵਰਕਸਟੇਸ਼ਨ GPU, Self-Debugging ਇੱਕ ਹਾਰਡ ਗੋਲ ਸੀਮਾ ਵਾਲੇ ਕੋਡਿੰਗ ਏਜੰਟਾਂ ਦੇ ਅੰਦਰ, ਅਤੇ EG-MLA ਨੂੰ ਜੋੜੋ ਜਦੋਂ ਤੁਸੀਂ ਮਾਡਲ ਪਰਿਵਾਰ ਨੂੰ ਨਿਯੰਤਰਿਤ ਕਰਦੇ ਹੋ। ਡਿਸਟ੍ਰੀਬਿਊਟਡ ਸਰਵਿੰਗ ਗੁੰਝਲਦਾਰਤਾ ਨੂੰ ਜੋੜਦੀ ਹੈ: KV ਸਮਾਨਤਾ, ਪ੍ਰੀਫਿਲ/ਡੀਕੋਡ ਸਪਲਿਟ, ਅਤੇ ਆਟੋਸਕੇਲਿੰਗ ਜੋ ਪੇਜ ਟੇਬਲ ਨੂੰ ਨਹੀਂ ਥਰੈਸ਼ ਕਰਦਾ ਹੈ। ਮਾਪ. ਫਿਰ ADR ਲਿਖੋ।
ਅਗਲਾ
ਪੜ੍ਹੋ- ਲੰਮਾ ਲੇਖ— ਨੋਬਸ, ਫੇਲ ਮੋਡ, Kubernetes ਨੋਟਸ।
- LLMs ਸਮਝਾਇਆ + Kubernetes 'ਤੇ ਆਪਣਾ ਖੁਦ ਚਲਾਓ
- Muse Glimmer / ਸਥਾਨਕ ਏਜੰਟ·ਐਂਟਰਪ੍ਰਾਈਜ਼ AI ਲੈਬ
Workstationਦੁਆਰਾ ਪ੍ਰਕਾਸ਼ਿਤ।