Workstation ਤਕਨੀਕੀ ਬ੍ਰੀਫ: OpenTelemetry, Prometheus/Grafana/Thanos, ਅਤੇ Langfuse / LMNR ਵਰਗੇ LLM ਪਲੇਟਫਾਰਮਾਂ ਨਾਲ LLM ਅਤੇ ਮਲਟੀ-ਏਜੰਟ ਰੁਕਾਵਟਾਂ ਦਾ ਪਰਦਾਫਾਸ਼ — ਸਪੈਨ ਸਕੀਮਾ, ਲਾਗਤ ਐਟ੍ਰਿਬਿਊਸ਼ਨ, ਸੈਂਪਲਿੰਗ ਅਤੇ ਸਖ਼ਤ ਵਰਤੋਂ ਕੈਪ ਸਮੇਤ। ਸਾਥੀ: ਬਿਜ਼ਨਸ ਬਲੌਗ · ਸਰਵਿੰਗ: Turbocharging LLMs · ਲੈਬ: Enterprise AI Lab.
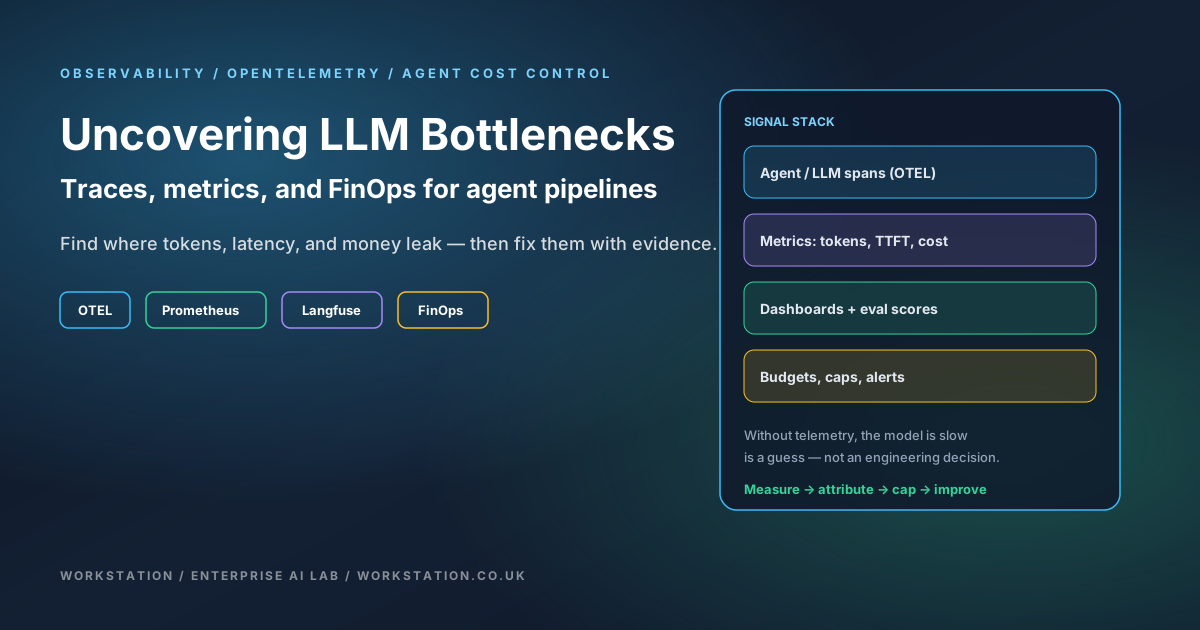
- ਸਮੱਸਿਆ: ਏਜੰਟ ਲਾਗਤ ਅਤੇ ਲੈਟੈਂਸੀ ਹੌਪਾਂ ਵਿੱਚ ਲੁਕਦੀ ਹੈ (LLM → ਟੂਲ → RAG → ਰੀਟ੍ਰਾਈ), ਇੱਕੋ “ਮਾਡਲ ਹੌਲੀ ਹੈ” ਮੈਟ੍ਰਿਕ ਵਿੱਚ ਨਹੀਂ।
- ਮਿਆਰ: OpenTelemetry ਨਾਲ ਇੰਸਟ੍ਰੂਮੈਂਟ ਕਰੋ; tokens, model, tenant, route, estimated_cost_usd ਲਈ ਇੱਕ ਐਟ੍ਰਿਬਿਊਟ ਸਕੀਮਾ।
- ਮੈਟ੍ਰਿਕਸ ਰਾਹ: ਗੋਲਡਨ ਸਿਗਨਲ ਲਈ Prometheus (+ Thanos); SLOs ਅਤੇ FinOps ਬੋਰਡ ਲਈ Grafana।
- LLM ਰਾਹ: ਟ੍ਰੇਸ, ਸਕੋਰ, ਡਾਟਾਸੈੱਟ, ਪ੍ਰਾਂਪਟ ਵਰਜਨ ਲਈ Langfuse/LMNR।
- ਨਿਯੰਤਰਣ: ਟੋਕਨ, ਟੂਲ ਕਾਲਾਂ ਅਤੇ ਡੀਬੱਗ ਰਾਊਂਡ ਕੈਪ ਕਰੋ; ਕਦਮ ਦੀ ਔਖਾਈ ਮੁਤਾਬਕ ਮਾਡਲ ਰੂਟ ਕਰੋ।
- ਜਿੱਤ: ਹੋਰ GPUs ਖਰੀਦਣ ਜਾਂ API ਕੋਟਾ ਵਧਾਉਣ ਤੋਂ ਪਹਿਲਾਂ cost-per-successful-task ਮਾਪੋ।
1. LLM ਏਜੰਟਾਂ ਲਈ “ਰੁਕਾਵਟ” ਦਾ ਅਰਥ
ਟ੍ਰੇਨਿੰਗ-ਟਾਈਮ ਰੁਕਾਵਟਾਂ (ਡਾਟਾ, FLOPs) ਸਰਵਿੰਗ-ਟਾਈਮ ਅਤੇ ਏਜੰਟ-ਟਾਈਮ ਰੁਕਾਵਟਾਂ ਤੋਂ ਵੱਖਰੀਆਂ ਹਨ। ਪ੍ਰੋਡਕਸ਼ਨ ਏਜੰਟਾਂ ਵਿੱਚ ਮੁੱਖ ਰਹਿੰਦ-ਖੂੰਹਦ ਇਹ ਹਨ:
- ਪ੍ਰਾਂਪਟ ਬਲੋਟ — ਵੱਡੇ ਸਿਸਟਮ ਪ੍ਰਾਂਪਟ, ਬਿਨਾਂ ਮੁੜ-ਵਰਤੋਂ ਵਾਲਾ ਕਾਂਟੈਕਸਟ, ਗੁੰਮ ਪ੍ਰੀਫਿਕਸ/ਕੈਸ਼ ਹਿਟ।
- ਮਾਡਲ ਓਵਰਕਿਲ — classify/route ਲਈ ਫਰੰਟੀਅਰ ਮਾਡਲ ਜਿੱਥੇ ਛੋਟਾ ਮਾਡਲ ਕਾਫ਼ੀ ਹੈ।
- ਬਿਨਾਂ ਹੱਦ ਦੇ ਲੂਪ — ਸਖ਼ਤ ਬਜਟ ਤੋਂ ਬਿਨਾਂ ਟੂਲ ਰੀਟ੍ਰਾਈ ਅਤੇ ਸੈਲਫ-ਡੀਬੱਗ ਚੱਕਰ (Turbocharging LLMs ਵਿੱਚ Self-Debugging ਟ੍ਰੇਡ-ਆਫ ਵੇਖੋ)।
- ਬਾਹਰੀ ਉਡੀਕ — ਵੈਕਟਰ DB, SaaS APIs, ਅਤੇ human-in-the-loop ਗੇਟ ਗਲਤ ਤਰੀਕੇ ਨਾਲ “LLM ਲੈਟੈਂਸੀ” ਨਾਲ ਜੋੜੇ ਜਾਂਦੇ ਹਨ।
- ਸਰਵਿੰਗ ਖੰਡਣ — ਏਜੰਟ ਗ੍ਰਾਫ ਠੀਕ ਹੋਣ ਤੋਂ ਬਾਅਦ ਵੀ GPU ’ਤੇ KV ਕੈਸ਼ ਰਹਿੰਦ-ਖੂੰਹਦ (PagedAttention/vLLM ਖੇਤਰ)।
ਡਿਸਟ੍ਰਿਬਿਊਟਡ ਟ੍ਰੇਸ ਤੋਂ ਬਿਨਾਂ ਇਹਨਾਂ ਨੂੰ ਵੱਖ ਨਹੀਂ ਕੀਤਾ ਜਾ ਸਕਦਾ। ਇਸ ਲਈ ਔਬਜ਼ਰਵੇਬਿਲਟੀ ਸਿਰਫ਼ ਸੁੰਦਰ ਡੈਸ਼ਬੋਰਡ ਨਹੀਂ — ਇਹ AI ਉਤਪਾਦਾਂ ’ਤੇ FinOps ਅਤੇ SRE ਲਈ ਕੰਟਰੋਲ ਪਲੇਨ ਹੈ।
2. ਰੈਫਰੈਂਸ ਆਰਕੀਟੈਕਚਰ
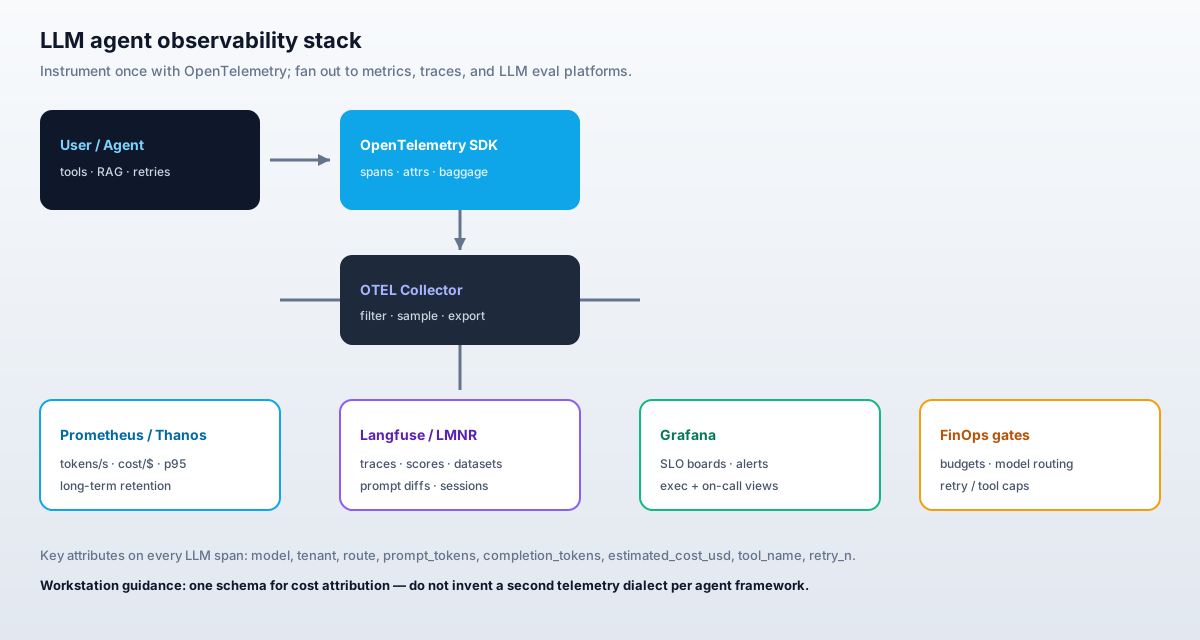
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. LLM ਕਾਲਾਂ ਲਈ OpenTelemetry ਸਪੈਨ ਸਕੀਮਾ
ਫਰੇਮਵਰਕਾਂ ਵਿੱਚ ਇੱਕੋ ਕਨਵੈਨਸ਼ਨ ਅਪਣਾਓ (LangChain, ਕਸਟਮ Go/Python ਏਜੰਟ, Bedrock SDKs)। ਜਿੱਥੇ ਮੌਜੂਦ ਹੋਣ ਸੈਮੈਂਟਿਕ ਕਨਵੈਨਸ਼ਨ ਤਰਜੀਹ ਦਿਓ, ਅਤੇ ਸਥਿਰ Workstation ਐਟ੍ਰਿਬਿਊਟਸ ਨਾਲ ਵਧਾਓ:
| ਐਟ੍ਰਿਬਿਊਟ | ਉਦਾਹਰਨ | ਕਿਉਂ |
|---|---|---|
gen_ai.system | openai / anthropic / bedrock / vllm | ਪ੍ਰੋਵਾਈਡਰ ਰੋਲਅੱਪ |
gen_ai.request.model | claude-sonnet-4 / llama-3.1-8b | ਮਾਡਲ ਮੁਤਾਬਕ ਲਾਗਤ ਅਤੇ ਕੁਆਲਿਟੀ |
gen_ai.usage.input_tokens | 1820 | ਪ੍ਰਾਂਪਟ ਲਾਗਤ ਡ੍ਰਾਈਵਰ |
gen_ai.usage.output_tokens | 410 | ਕੰਪਲੀਸ਼ਨ ਲਾਗਤ ਡ੍ਰਾਈਵਰ |
wsw.estimated_cost_usd | 0.0124 | ਬਾਅਦ ਵਿੱਚ ਪ੍ਰਾਈਸ ਸ਼ੀਟ ਜੋੜੇ ਬਿਨਾਂ FinOps |
wsw.tenant_id | acme-prod | ਚਾਰਜਬੈਕ |
wsw.route | support.triage | ਉਤਪਾਦ ਫੀਚਰ ਐਟ੍ਰਿਬਿਊਸ਼ਨ |
wsw.agent_step | plan / tool / critique | ਮਹਿੰਗੇ ਕਦਮ ਲੱਭੋ |
wsw.retry_n | 2 | ਲੂਪ ਖੋਜ |
wsw.prompt_version | triage@v17 | ਰਿਗ੍ਰੈਸ਼ਨ ਲਿੰਕੇਜ |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
ਅਭਿਆਸ: ਸਪੈਨ ’ਤੇ ਹੀ estimated_cost_usd ਗਿਣੋ। ਟੋਕਨ ਗਿਣਤੀ ਨੂੰ ਪ੍ਰਾਈਸ ਸ਼ੀਟ ਨਾਲ ਜੋੜਨ ਲਈ ਰਾਤ ਦੀ ਜੌਬ ਦੀ ਉਡੀਕ ਨਾ ਕਰੋ — ਆਨ-ਕਾਲ ਅਤੇ ਉਤਪਾਦ ਮਾਲਕਾਂ ਨੂੰ ਲਾਈਵ FinOps ਚਾਹੀਦਾ ਹੈ।
3b. ਮਲਟੀ-ਏਜੰਟ ਸਪੈਨ ਹਾਇਰਾਰਕੀ ਅਤੇ ਬੈਗੇਜ
ਏਜੰਟ ਗ੍ਰਾਫਾਂ ਨੂੰ ਸਥਿਰ parent/child ਮਾਡਲ ਚਾਹੀਦਾ ਹੈ ਤਾਂ ਜੋ ਲਾਗਤ ਸਹੀ ਰੋਲ-ਅੱਪ ਹੋਵੇ:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- ਪ੍ਰਤੀ ਯੂਜ਼ਰ ਟਾਸਕ ਇੱਕ ਰੂਟ — ਪ੍ਰਤੀ LLM ਕਾਲ ਨਹੀਂ। ਸੈਸ਼ਨ ਲਾਗਤ = ਬੱਚਿਆਂ ਦੇ
wsw.estimated_cost_usdਦਾ ਜੋੜ। - ਬੈਗੇਜ —
wsw.tenant_idਅਤੇwsw.routeਨੂੰ async ਵਰਕਰ / ਕਿਊ ਵਿੱਚ ਫੈਲਾਓ ਤਾਂ ਜੋ ਟੂਲ ਸਪੈਨ ਬਿਨਾਂ ਹਰ ਕਾਲ-ਸਾਈਟ ਮੁੜ-ਵਾਇਰ ਕੀਤੇ ਚਾਰਜਬੈਕ ਲੇਬਲ ਵਿਰਾਸਤ ਵਿੱਚ ਲੈਣ। - ਲਿੰਕ — ਜਦੋਂ ਸਬ-ਏਜੰਟ ਨਵਾਂ ਟ੍ਰੇਸ ਸ਼ੁਰੂ ਕਰੇ (ਜਿਵੇਂ ਵੱਖਰਾ ਕਿਊ ਕੰਜ਼ਿਊਮਰ), ਪੇਰੈਂਟ ਸੈਸ਼ਨ ਵੱਲ ਸਪੈਨ ਲਿੰਕ ਵਰਤੋ ਤਾਂ ਜੋ Langfuse/Grafana ਗ੍ਰਾਫ ਜੋੜ ਸਕਣ।
- ਉੱਚ ਲਾਗਤ ਹਮੇਸ਼ਾ ਸੈਂਪਲ — ਖੁਸ਼ ਰਾਹਾਂ ਲਈ 5–20% ਹੈੱਡ ਸੈਂਪਲਿੰਗ ਠੀਕ ਹੈ; ਸੈਸ਼ਨ ਖਰਚ ਥ੍ਰੈਸ਼ਹੋਲਡ ਤੋਂ ਵੱਧ ਜਾਂ status=ERROR ’ਤੇ ਫੋਰਸ ਸੈਂਪਲ ਕਰੋ।
4. ਮਹੱਤਵਪੂਰਨ ਮੈਟ੍ਰਿਕਸ (Prometheus)
ਹਿਸਟੋਗ੍ਰਾਮ ਅਤੇ ਕਾਊਂਟਰ ਐਕਸਪੋਰਟ ਕਰੋ (OTEL ਮੈਟ੍ਰਿਕਸ ਜਾਂ Prometheus ਕਲਾਇੰਟ ਰਾਹੀਂ)। ਘੱਟੋ-ਘੱਟ ਲੋੜੀਂਦਾ ਸੈੱਟ:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}where direction ∈ {input,output}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_secondshistogramsagent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}— denominator for cost-per-success
ਡੈਰਿਵਡ FinOps ਕੁਐਰੀਆਂ (PromQL ਸਕੈਚ):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
ਜਦੋਂ ਫਾਈਨੈਂਸ ਤਿਮਾਹੀ-ਦਰ-ਤਿਮਾਹੀ ਮਾਡਲ ਖਰਚ ਮੰਗਦਾ ਹੈ ਤਾਂ Thanos (ਜਾਂ Mimir/Cortex) ਮਹੱਤਵਪੂਰਨ ਹੈ। ਲੋਕਲ Prometheus ਆਨ-ਕਾਲ ਲਈ ਠੀਕ ਹੈ; ਇਹ FinOps ਆਰਕਾਈਵ ਨਹੀਂ।
5. Grafana ਬੋਰਡ ਅਤੇ ਅਲਰਟ
ਇੱਕ ਡਾਟਾਸੋਰਸ ਤੋਂ ਤਿੰਨ ਦਰਸ਼ਕਾਂ ਲਈ ਸ਼ਿਪ ਕਰੋ:
- ਆਨ-ਕਾਲ: ਐਰਰ ਰੇਟ, p95 e2e, ਡਿਪੈਂਡੈਂਸੀ ਫੇਲ੍ਹੀਆਂ (ਵੈਕਟਰ DB / ਟੂਲ)।
- ਪਲੇਟਫਾਰਮ: tokens/s, GPU util (ਜੇ ਸੈਲਫ-ਹੋਸਟਡ), ਕਿਊ ਡੂੰਘਾਈ, TTFT।
- FinOps / ਉਤਪਾਦ: tenant ਅਤੇ route ਮੁਤਾਬਕ $/success, ਸਭ ਤੋਂ ਮਹਿੰਗੇ ਪ੍ਰਾਂਪਟ, ਮਾਡਲ ਮਿਕਸ।
ਵੈਨਿਟੀ ’ਤੇ ਨਹੀਂ, ਬਰਨ ’ਤੇ ਅਲਰਟ ਕਰੋ:
- 30 ਮਿੰਟ ਲਈ cost-per-success > ਬਜਟ SLO
- ਕਿਸੇ ਰੂਟ ਲਈ ਰੀਟ੍ਰਾਈ ਰੇਟ > 15%
- ਵਧਦੇ ਇਨਪੁੱਟ ਟੋਕਨ ਨਾਲ p95 e2e ਭੰਗ (ਪ੍ਰਾਂਪਟ ਰਿਗ੍ਰੈਸ਼ਨ)
6. LLM-ਨੇਟਿਵ ਪਲੇਟਫਾਰਮ: Langfuse, LMNR ਅਤੇ ਸਾਥੀ
ਮੈਟ੍ਰਿਕਸ ਦੱਸਦੇ ਹਨ ਕਿ ਲਾਗਤ ਵਧੀ; LLM ਪਲੇਟਫਾਰਮ ਦੱਸਦੇ ਹਨ ਕਿਹੜੇ ਪ੍ਰਾਂਪਟ ਵਰਜਨ ਅਤੇ ਕਿਹੜੇ ਟੂਲ ਸਪੈਨ ਨੇ ਇਹ ਕੀਤਾ। Langfuse ਅਤੇ LMNR ਇਸ ਵਰਗ ਦੇ ਓਪਨ-ਸੋਰਸ ਉਦਾਹਰਨ ਹਨ:
- ਹਾਇਰਾਰਕੀਕਲ ਟ੍ਰੇਸ (ਸੈਸ਼ਨ → ਏਜੰਟ → LLM / ਟੂਲ ਸਪੈਨ)
- ਮਨੁੱਖੀ ਅਤੇ LLM-as-judge ਸਕੋਰ
- ਪ੍ਰਾਂਪਟ ਬਦਲਣ ’ਤੇ ਆਫਲਾਈਨ ਇਵੈਲ ਲਈ ਡਾਟਾਸੈੱਟ
- ਉਤਪਾਦ ਸੁਧਾਰ ਲਈ ਵਿਕਲਪਿਕ ਵਰਤੋਂ ਟੈਲੀਮੈਟਰੀ (ਪਰਾਈਵੇਸੀ ਨੀਤੀਆਂ ਦਾ ਆਦਰ)
ਇੰਟੀਗ੍ਰੇਸ਼ਨ ਪੈਟਰਨ: SRE ਲਈ OTEL ਨੂੰ ਸਿਸਟਮ ਆਫ਼ ਰਿਕਾਰਡ ਰੱਖੋ; ਪ੍ਰਾਂਪਟ ਇੰਜੀਨੀਅਰਿੰਗ ਲਈ Langfuse ਵਿੱਚ ਡਿਊਲ-ਐਕਸਪੋਰਟ ਜਾਂ ਬ੍ਰਿਜ ਕਰੋ। ਦੂਜੀ, ਅਸੰਗਤ ਐਟ੍ਰਿਬਿਊਟ ਡਿਕਸ਼ਨਰੀ ਨਾ ਬਣਾਓ।
ਫੰਕਸ਼ਨ-ਫਸਟ ਏਜੰਟ ਰਨਟਾਈਮ ਵਰਗੇ ਫਰੇਮਵਰਕ ਪ੍ਰਯੋਗ ਬੋਇਲਰਪਲੇਟ ਘਟਾ ਸਕਦੇ ਹਨ, ਪਰ ਨੀਚ ਫਰੇਮਵਰਕਾਂ ਨੂੰ ਵਿਕਲਪਿਕ ਸਮਝੋ — ਔਬਜ਼ਰਵੇਬਿਲਟੀ ਮਿਆਰ ਉਨ੍ਹਾਂ ਤੋਂ ਲੰਮੇ ਜੀਉਂਦੇ ਹਨ।
7. ਸਕੋਰਿੰਗ ਪਾਈਪਲਾਈਨ: ਮੈਨੂਅਲ ਬਨਾਮ ਆਟੋਮੈਟਿਕ
| ਵਿਧੀ | ਲਾਗੂਕਰਨ | ਫੇਲ੍ਹੀ ਮੋਡ |
|---|---|---|
| ਮੈਨੂਅਲ | Langfuse UI ਵਿੱਚ ਥੰਬਸ / ਰੂਬਰਿਕ; ਗੋਲਡ ਸੈੱਟ ਸਮੀਖਿਆ। | ਸਕੇਲ ਨਹੀਂ ਹੁੰਦਾ; ਕੈਲੀਬਰੇਸ਼ਨ ਲਈ ਅਜੇ ਵੀ ਲੋੜੀਂਦਾ। |
| ਆਟੋਮੈਟਿਕ | LLM-as-judge, ਯੂਨਿਟ ਚੈੱਕ, ਸਕੀਮਾ ਵੈਲੀਡੇਟਰ, ਰਿਟਰੀਵਲ ਰੀਕਾਲ। | ਜੱਜ ਡ੍ਰਿਫਟ; ਸਿਰਫ਼ ਜੱਜ ਲਈ ਆਪਟੀਮਾਈਜ਼ ਕਰਨ ’ਤੇ ਗੇਮਿੰਗ। |
ਸਕੋਰ ਨੂੰ ਸਪੈਨ ਇਵੈਂਟ ਜਾਂ wsw.prompt_version ਨਾਲ ਕੀਡ Langfuse ਸਕੋਰ ਵਜੋਂ ਜੋੜੋ। ਪ੍ਰਾਂਪਟ ਪ੍ਰੋਮੋਸ਼ਨ ਨੂੰ ਐਪ ਵਰਜਨ ਵਾਂਗ ਗੇਟ ਕਰੋ — ਕੋਡ ਲਈ Ring Promoter; ਪ੍ਰਾਂਪਟ ਲਈ ਇਵੈਲ ਗੇਟ।
8. ਲਾਗਤ-ਬਚਤ ਪ੍ਰਕਿਰਿਆ (ਵਿਸਥਾਰ)
- ਬੇਸਲਾਈਨ ਹਫ਼ਤਾ: ਵਿਹਾਰ ਨਾ ਬਦਲੋ; ਸਿਰਫ਼ ਇੰਸਟ੍ਰੂਮੈਂਟੇਸ਼ਨ। $/success, tokens/success, ਰੀਟ੍ਰਾਈ ਰੇਟ ਕੈਪਚਰ ਕਰੋ।
- ਐਟ੍ਰਿਬਿਊਸ਼ਨ: ਖਰਚ × ਵਾਲੀਅਮ ਨਾਲ ਰੂਟ ਰੈਂਕ ਕਰੋ। ਚੋਟੀ ਦੇ ਤਿੰਨ ਚੁਣੋ।
- ਮਾਡਲ ਰੂਟਿੰਗ: classify/extract ਛੋਟੇ/ਲੋਕਲ ਮਾਡਲਾਂ ’ਤੇ; ਸਿੰਥੈਸਿਸ ਲਈ ਫਰੰਟੀਅਰ ਰੱਖੋ। ਕੁਆਲਿਟੀ ਸਕੋਰ ਮੁੜ ਮਾਪੋ।
- ਪ੍ਰਾਂਪਟ ਸਰਜਰੀ: ਅਣਵਰਤੇ ਟੂਲ ਸਕੀਮਾ ਹਟਾਓ; few-shot ਛੋਟੇ ਕਰੋ; ਜਿੱਥੇ ਸੁਰੱਖਿਅਤ ਹੋਵੇ ਪ੍ਰੀਫਿਕਸ ਕੈਸ਼ ਚਾਲੂ ਕਰੋ।
- ਲੂਪ ਕੈਪ: ਵੱਧ ਤੋਂ ਵੱਧ ਟੂਲ ਕਾਲਾਂ, ਸੈਲਫ-ਡੀਬੱਗ ਰਾਊਂਡ, ਸਰਕਟ ਬ੍ਰੇਕਰ ਨਾਲ ਐਕਸਪੋਨੈਂਸ਼ੀਅਲ ਬੈਕਆਫ।
- ਸੈਂਪਲਿੰਗ: 100% ਮੈਟ੍ਰਿਕਸ ਰੱਖੋ; ਟ੍ਰੇਸ ਸੈਂਪਲ (ਜਿਵੇਂ 5–20%) ਪਲੱਸ ਐਰਰ ਅਤੇ ਉੱਚ-ਲਾਗਤ ਸੈਸ਼ਨ ਲਈ ਹਮੇਸ਼ਾ-ਆਨ ਸੈਂਪਲਿੰਗ।
- ਰਿਡੈਕਸ਼ਨ: ਐਕਸਪੋਰਟ ਤੋਂ ਪਹਿਲਾਂ ਸਪੈਨ ਐਟ੍ਰਿਬਿਊਟਸ ਤੋਂ PII ਹਟਾਓ; ਪੂਰੇ ਪ੍ਰਾਂਪਟ ਸਿਰਫ਼ ਮਨਜ਼ੂਰ ਸਟੋਰ ਵਿੱਚ TTL ਨਾਲ ਰੱਖੋ।
- ਸਮੀਖਿਆ ਤਾਲ: ਹਫ਼ਤਾਵਾਰੀ FinOps ਬੋਰਡ; ਮਹੀਨਾਵਾਰ ਮਨੁੱਖਾਂ ਨਾਲ ਜੱਜ ਕੈਲੀਬਰੇਸ਼ਨ।
8b. ਲਾਈਵ ਬਜਟ ਨਾਲ ਏਜੰਟ ਵਰਤੋਂ ਦਾ ਪ੍ਰਬੰਧ
ਸਿਰਫ਼ ਡੈਸ਼ਬੋਰਡ ਰਨਅਵੇ ਏਜੰਟ ਨਹੀਂ ਰੋਕਦੇ। ਰਨਟਾਈਮ ਵਿੱਚ ਬਜਟ ਲਾਗੂ ਕਰੋ, ਫੈਸਲੇ ਨੂੰ ਸਪੈਨ ਇਵੈਂਟ ਵਜੋਂ ਭੇਜੋ, ਅਤੇ ਜਦੋਂ ਸੈਸ਼ਨ ਅਕਸਰ ਸੀਲਿੰਗ ਛੂਹਣ ਤਾਂ ਅਲਰਟ ਕਰੋ:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- ਪ੍ਰਤੀ-ਸੈਸ਼ਨ ਕੈਪ — USD, LLM ਕਾਲਾਂ, ਟੂਲ ਕਾਲਾਂ (ਉੱਪਰ)।
- ਪ੍ਰਤੀ-tenant ਰੋਜ਼ਾਨਾ ਕੋਟਾ —
wsw.tenant_idਨਾਲ Redis/counter; ਖਤਮ ਹੋਣ ’ਤੇ ਨਿਯੰਤਰਿਤ ਘਟਿਆ ਰਾਹ ਵਾਪਸ ਕਰੋ। - ਪ੍ਰਤੀ-ਰੂਟ ਮਾਡਲ ਨੀਤੀ —
support.triageਬਨਾਮlegal.draftਲਈ ਮਾਡਲ ਅਲਾਉਲਿਸਟ; ਨੀਤੀ ਮਿਸ ’ਤੇ ਰੱਦ ਜਾਂ ਡਾਊਨਸ਼ਿਫਟ ਕਰੋ ਅਤੇwsw.policy_action=downshiftਰਿਕਾਰਡ ਕਰੋ। - ਆਈਡੈਮਪੋਟੈਂਟ ਟੂਲ ਕੁੰਜੀਆਂ — ਟੂਲ ਆਰਗਸ ਹੈਸ਼ ਕਰੋ ਤਾਂ ਜੋ ਰੀਟ੍ਰਾਈ ਬਾਹਰੀ APIs ਨੂੰ ਦੋਹਰਾ ਬਿੱਲ ਨਾ ਕਰਨ।
- ਲਾਗਤ ਫਾਰਮੂਲਾ —
cost = in_tokens × p_in + out_tokens × p_out + tool_fees; ਵਰਜਨਡ ਪ੍ਰਾਈਸ ਸ਼ੀਟ ਤੋਂp_in/p_outਰਿਫਰੈਸ਼ ਕਰੋ ਤਾਂ ਜੋ ਇਤਿਹਾਸਕ Thanos ਡਾਟਾ ਤੁਲਨਾਯੋਗ ਰਹੇ।
ਕੈਪ ਲੱਗਣ ਤੋਂ ਬਾਅਦ ਵੇਖਣ ਵਾਲਾ ਮੈਟ੍ਰਿਕ: agent_budget_exhausted_total{route,reason}। ਸਪਾਈਕ ਦਾ ਅਰਥ ਹੈ ਦੁਰਵਰਤੋਂ, ਟੁੱਟਿਆ ਟੂਲ ਲੂਪ, ਜਾਂ ਅਸਲ ਵਰਕਲੋਡ ਲਈ ਬਹੁਤ ਤੰਗ ਬਜਟ।
9. ਕਲੈਕਟਰ ਕਨਫਿਗਰੇਸ਼ਨ ਸਕੈਚ
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. ਫਾਇਦੇ, ਨੁਕਸਾਨ, ਅਤੇ ਕਦੋਂ ਛੱਡੋ
ਫਾਇਦੇ: ਚਾਰਜਬੈਕ, ਤੇਜ਼ ਇੰਸੀਡੈਂਟ ਟ੍ਰਾਈਏਜ, ਪ੍ਰਾਂਪਟ/ਮਾਡਲ ਬਦਲਾਅ ’ਤੇ ਮਾਪਯੋਗ ROI, ਅਨੁਪਾਲਨ-ਅਨੁਕੂਲ ਆਡਿਟ ਟ੍ਰੇਲ, ML ਅਤੇ ਪਲੇਟਫਾਰਮ ਟੀਮਾਂ ਵਿਚਾਲੇ ਸਾਂਝੀ ਭਾਸ਼ਾ।
ਨੁਕਸਾਨ: ਇੰਸਟ੍ਰੂਮੈਂਟੇਸ਼ਨ ਕਰਜ਼ਾ; ਹਰ ਪ੍ਰਾਂਪਟ ਸਦਾ ਰੱਖਣ ’ਤੇ ਸਟੋਰੇਜ ਲਾਗਤ; ਗਲਤ ਬੈਕਐਂਡ ਵਿੱਚ PII ਭੇਜਣ ਦਾ ਖਤਰਾ; ਇੰਜੀਨੀਅਰਾਂ ਲਈ ਇੱਕ ਹੋਰ ਕੰਸੋਲ।
ਹੁਣ ਲਈ ਛੱਡੋ ਜੇ: ਤੁਹਾਡੇ ਕੋਲ ਫਿਕਸਡ ਰੋਜ਼ਾਨਾ ਖਰਚ ਵਾਲੀ ਇੱਕ ਆਫਲਾਈਨ ਬੈਚ ਜੌਬ ਹੈ ਅਤੇ ਕੋਈ ਇੰਟਰਐਕਟਿਵ ਏਜੰਟ ਨਹੀਂ। ਫਿਰ ਵੀ ਟੋਕਨ ਲੌਗ ਕਰੋ; ਕਨਕਰੰਸੀ ਆਉਣ ਤੱਕ ਪੂਰਾ ਮਲਟੀ-ਬੈਕਐਂਡ ਸਟੈਕ ਛੱਡੋ।
11. ਮਾਈਗ੍ਰੇਸ਼ਨ ਚੈੱਕਲਿਸਟ
- ☐ ਏਜੰਟ ਰਨਟਾਈਮ ਵਿੱਚ OTEL SDK; ਕਲੱਸਟਰ ਵਿੱਚ ਕਲੈਕਟਰ
- ☐ ਸਪੈਨ ਐਟ੍ਰਿਬਿਊਟਸ ਵਿੱਚ model, tokens, cost, tenant, route
- ☐ Prometheus ਮੈਟ੍ਰਿਕਸ + Grafana FinOps ਬੋਰਡ
- ☐ ਘੱਟੋ-ਘੱਟ ਇੱਕ ਨਾਜ਼ੁਕ ਪਾਥ ਲਈ Langfuse (ਜਾਂ LMNR) ਵਾਇਰਡ
- ☐ ਟੋਕਨ / ਟੂਲ / ਰੀਟ੍ਰਾਈ ’ਤੇ ਸਖ਼ਤ ਕੈਪ
- ☐ ਸੁਰੱਖਿਆ ਵੱਲੋਂ ਰਿਡੈਕਸ਼ਨ ਨੀਤੀ ਦੀ ਸਮੀਖਿਆ
- ☐ ਚੋਟੀ ਦੇ ਰੂਟਾਂ ਲਈ $/success ਦੀ ਹਫ਼ਤਾਵਾਰੀ ਸਮੀਖਿਆ
- ☐ ਔਬਜ਼ਰਵੇਬਿਲਟੀ → ਸਰਵਿੰਗ (vLLM) → ਪ੍ਰੋਮੋਸ਼ਨ (Ring Promoter) ਨੂੰ ਜੋੜਦਾ ADR ਦਸਤਾਵੇਜ਼
12. ਸੰਬੰਧਿਤ Workstation ਸਮੱਗਰੀ
- ਬਿਜ਼ਨਸ ਬਲੌਗ ਸਾਥੀ
- Turbocharging LLMs — ਰੁਕਾਵਟ ਦੇਖਣ ਤੋਂ ਬਾਅਦ ਸਰਵਿੰਗ ਠੀਕ ਕਰੋ
- Ring Promoter — ਹੈਲਥ ਗੇਟਾਂ ਨਾਲ ਏਜੰਟ ਸਰਵਿਸਾਂ ਪ੍ਰੋਮੋਟ ਕਰੋ
- Muse Glimmer / ਲੋਕਲ ਏਜੰਟ
- Enterprise AI Lab ਐਂਗੇਜਮੈਂਟ ਲਈ Workstation ਨਾਲ ਸੰਪਰਕ
ਹਵਾਲੇ
Workstation ਵੱਲੋਂ ਪ੍ਰਕਾਸ਼ਿਤ।


