De shop is live

Wij bouwen Workstation AI-machines voor websites, AI-agents en LLM-training — configureer en koop online.

Naar de shop
AI-producten
AI LabsOpenAI-agentsClaude AgentsGrok BotWorkstation AI native CRMMarketingAlle producten
AI-oplossingen
Toegepaste AIAI-agentsGeneratieve AIAI-automatiseringAI-bijscholingAI-pakketten voor het mkbEnterprise AI LabAI-werkstationsNVIDIA-hardware en -softwareNVIDIA Accelerated ComputingPrivate AIGPU-clustersEdge AIAI per sector
AI-diensten
PlatformmoderniseringDigitale engineeringDatafundamenten en AIAutonome operatiesAI-adviesDevOps-automatiseringCybersecuritySoftwareontwikkelingAgentontwikkelingMLOps-opzet
Over ons
BedrijfOns verhaalPartnersKlantverhalen
AI-datacenters
AI-inzichtenJev-reeksBenchmarklabModelkeuze
Artikelen
Documentatie
Linux-OSUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
AI-cloudplatformsAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU-clouds en -marktplaatsen
Private AI-datacentersVoor advocatenkantorenVoor accountantskantorenOn-premises platformsVolledig beveiligde cloud
ToolsRing PromoterJobshout
Nieuws
Blog
Neem contact opInloggen

AI-werkstations, AI multi-agent software, GPU-infrastructuur en intelligente agentoplossingen voor moderne bedrijven.

Neem contact op

AI-oplossingen

Toegepaste AIAI-agentsGeneratieve AIAI-automatiseringAI-bijscholingAI-pakketten voor het mkbEnterprise AI LabAI per sector

Producten

Alle productenWorkstation AI native CRM & ERPMarketingOpenAI-agentsRing PromoterJobshout

Bedrijf

Over onsBedrijfAI-datacentersWaarom WorkstationPartnersKlantverhalenPrijzenContactTenthMatrix

Bronnen

AI-inzichtenArtikelenDocumentatieLinux-OSAI-cloudplatformsPrivate AI-datacentersBlogZoekenSitemap
Kantoor Verenigd Koninkrijk
77-79 Marlowes, Hemel Hempstead HP1 1LFRoute: neem afrit 20 van de M25, Outer LondonBedrijfsnummer: 11641870Ma - Vr: 9:00 - 18:00 GMT
+44 7515 356 146
Kantoor België
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Ma - Vr: 9:00 - 18:00 CET
+32 492 45 67 46
Kantoor India
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI. Alle rechten voorbehouden.

PrivacyGegevensverwijderingCookiesServicevoorwaardenWebsite-sitemap

NVIDIA Partner · VK

NVIDIA Accelerated Computing-oplossingen

Van één datacenter-GPU tot een vloeistofgekoelde AI-fabriek op rackschaal: Workstation dimensioneert, levert, bouwt, installeert en ondersteunt het volledige NVIDIA accelerated computing-assortiment voor Britse organisaties.

Bekijk het assortimentSpreek met een engineer
  • 34NVIDIA-systemen, GPU's, netwerk- en softwareproducten
  • 5stappen, van dimensionering tot langdurige ondersteuning
  • UKengineering, assemblage en burn-in-tests

Accelerated computing, zonder integratierisico

Accelerated computing verplaatst de zwaarste onderdelen van een workload, zoals AI-training, inferentie, simulatie, analytics en rendering, van algemene CPU's naar GPU's en gespecialiseerde processors. Het resultaat: meer werk per rack en per watt, en resultaten in uren in plaats van dagen.

Daarvoor is meer nodig dan een GPU. Elke accelerator heeft een server nodig die hem van stroom en koeling voorziet, een netwerk dat hem van data voorziet en software met licentie en ondersteuning. Als NVIDIA Partner met eigen engineers brengen wij die onderdelen samen tot één getest systeem, en we blijven betrokken nadat het live is gegaan.

  • Onafhankelijk advies over welk NVIDIA-platform bij uw workloads past
  • Complete, NVIDIA-Certified configuraties in plaats van losse onderdelen
  • Gebouwd, van een image voorzien en met burn-in getest in onze Britse werkplaats
  • Op uw locatie geïnstalleerd, bekabeld en in bedrijf gesteld
  • Eén Brits aanspreekpunt voor ondersteuning, upgrades en garantie

Waaruit een versneld systeem bestaat

Vier lagen werken samen. Wij specificeren ze alle vier, zodat geen ervan de bottleneck wordt.

GPU's

Voeren de parallelle berekeningen uit achter AI, simulatie en graphics. Geheugengrootte en bandbreedte bepalen meestal welke GPU u nodig hebt.

CPU's en systemen

Voorzien de GPU's van data, draaien het besturingssysteem en houden data in het geheugen. Het chassis bepaalt stroom, koeling en hoeveel GPU's erin passen.

Netwerken en DPU's

Verplaatsen data tussen GPU's, servers en opslag. DPU's nemen netwerk-, opslag- en beveiligingstaken over van de CPU.

Software

Drivers, CUDA, AI-frameworks en clustertools maken van hardware een platform dat uw teams kunnen gebruiken.

Waarom organisaties overstappen op accelerated computing

Workloads ontgroeien CPU's

AI-modellen en datasets groeien sneller dan CPU-prestaties. Taken lopen uit, serviceniveaus dalen en de energierekening stijgt.

Workflows worden complex

Datavoorbereiding, training, inferentie en visualisatie draaien vaak op aparte apparatuur. Eén versneld platform vereenvoudigt de pipeline.

Nieuwe apps creëren nieuwe silo's

AI toevoegen naast bestaande applicaties kan leiden tot losse hardware-eilanden. Een gedeeld, gecertificeerd platform houdt alles beheersbaar.

Het assortiment

NVIDIA accelerated computing-producten

Elk systeem, elke GPU, elk netwerkproduct en elke softwarelicentie hieronder is los leverbaar of als onderdeel van een complete build. Filter op type, vergelijk de belangrijkste specificaties en vraag een offerte aan.

Systemen en platforms

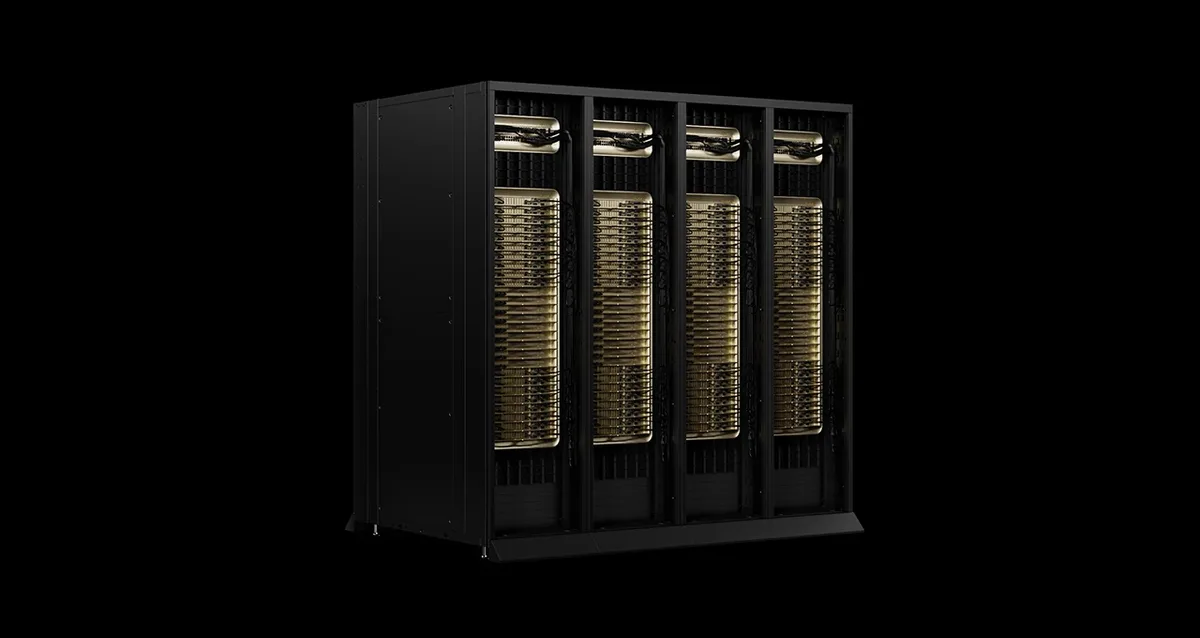
NVIDIA Vera Rubin NVL72

Rack-scale systeem voor agentic AI en de grootste modellen

NVIDIA's nieuwste rack-scale generatie verenigt 72 Rubin-GPU's en 36 Vera-CPU's in één NVLink-domein, zodat één rack zich gedraagt als één zeer grote accelerator.

Voor wie het geschikt is: AI-fabrieken, modelbouwers en serviceproviders die hun volgende grote uitrol plannen

Voordelen

  • Volgens NVIDIA veel meer tokens per megawatt dan de Grace Blackwell-generatie
  • HBM4-geheugen gedimensioneerd voor modellen met biljoenen parameters en lange context
  • Modulaire, kabelloze trays die onderhoud in het rack eenvoudiger maken

Belangrijkste specificaties

Configuratie72× Rubin GPU, 36× Vera CPU
GPU-geheugen20.7 TB HBM4 | 1,400 TB/s
NVFP4-inferentie3,600 PFLOPS (sparse)
NVLink-bandbreedte216 TB/s (sixth generation)
CPU-geheugenUp to 54 TB LPDDR5X
VormfactorRack, third-generation MGX NVL72

Wat Workstation doet: We controleren vroegtijdig stroomvoorziening, koeling en vloerbelasting van de locatie, regelen de allocatie en plannen levering, installatie en inbedrijfstelling rond uw datahal.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Systemen en platforms

NVIDIA GB300 NVL72 (DGX GB300)

Vloeistofgekoeld Blackwell Ultra-rack voor AI-reasoning

Zesendertig Grace-CPU's en 72 Blackwell Ultra-GPU's delen één NVLink-fabric in één vloeistofgekoeld rack. NVIDIA levert het ook als de DGX GB300.

Voor wie het geschikt is: Organisaties die reasoning-modellen aan veel gebruikers aanbieden, en teams die op frontier-schaal trainen

Voordelen

  • Een grote stap vooruit in tokens per seconde per gebruiker ten opzichte van Hopper-systemen
  • 37 TB snel geheugen houdt lange contexten en grote modellen binnen één domein
  • ConnectX-8 SuperNICs geven elke GPU een pad van 800 Gb/s naar het netwerk

Belangrijkste specificaties

GPU's72× Blackwell Ultra
CPU's36× Grace (2,592 Arm Neoverse V2 cores)
GPU-geheugen20 TB | up to 576 TB/s
Snel geheugen37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
NVLink-bandbreedte130 TB/s

Wat Workstation doet: We plannen vloeistofkoeling en stroom samen met uw facilitaire team, coördineren de levering van het geïntegreerde rack en stellen het in bedrijf volgens een gevalideerde baseline.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Systemen en platforms

NVIDIA GB200 NVL72 (DGX GB200)

Grace Blackwell rack-scale systeem in één NVLink-domein

Het eerste Grace Blackwell-rack: 72 Blackwell-GPU's en 36 Grace-CPU's, verbonden via NVLink en vloeistofgekoeld, voor zeer grote trainingsruns en realtime inferentie.

Voor wie het geschikt is: Teams die modellen met biljoenen parameters trainen of aanbieden en één grote, gedeelde GPU-geheugenpool nodig hebben

Voordelen

  • Realtime inferentie op zeer grote taalmodellen, volgens NVIDIA vele malen sneller dan H100
  • Vloeistofkoeling verhoogt dichtheid en energie-efficiëntie
  • Vijfde generatie NVLink biedt 1,8 TB/s tussen elke twee GPU's

Belangrijkste specificaties

Configuratie72× Blackwell GPU, 36× Grace CPU
GPU-geheugen13.4 TB HBM3E | 576 TB/s
NVFP4 Tensor Core1,440 PFLOPS sparse | 720 PFLOPS dense
NVLink-bandbreedte130 TB/s
CPU-geheugen17 TB LPDDR5X | 14 TB/s
KoelingLiquid cooled

Wat Workstation doet: We beoordelen uw locatie op vloeistofkoeling, verzorgen levering en integratie met uw netwerk en opslag, en ondersteunen het rack na de livegang.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Systemen en platforms

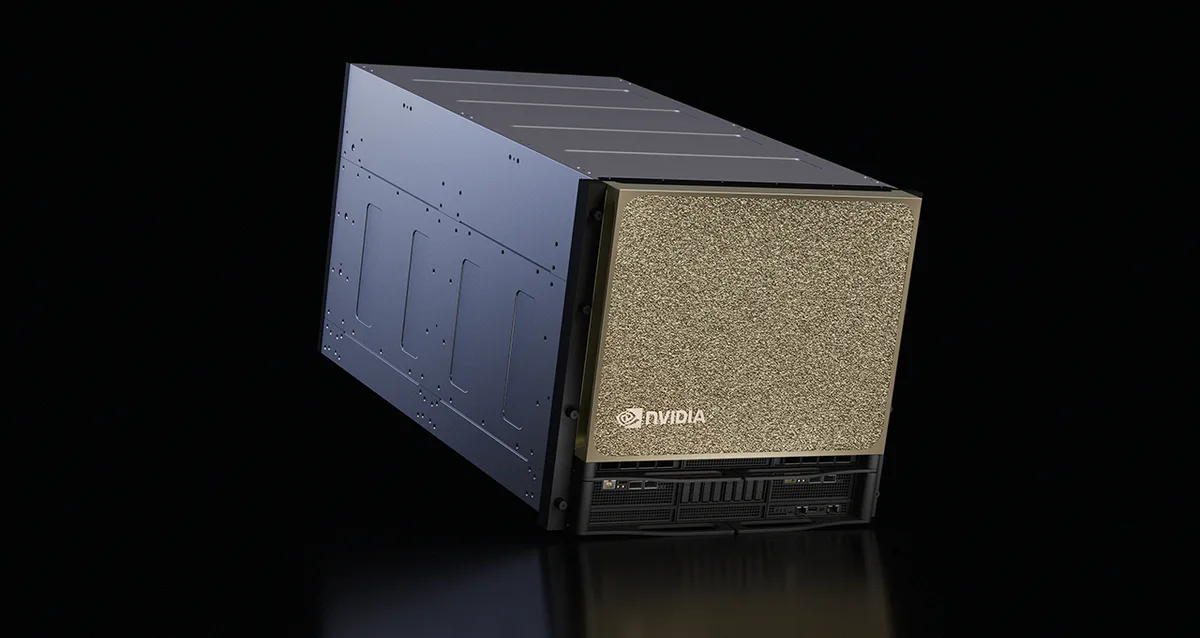
NVIDIA DGX B300

Acht Blackwell Ultra-GPU's in één DGX-systeem

Een zelfstandige DGX-server met acht Blackwell Ultra-GPU's, NVIDIA-netwerken en de volledige DGX-softwarestack, klaar om alleen te draaien of deel te worden van een BasePOD of SuperPOD.

Voor wie het geschikt is: Ondernemingen die hun eerste serieuze AI-fabriek bouwen, en teams die het referentieontwerp van NVIDIA willen in plaats van een maatwerkbuild

Voordelen

  • 2,3 TB GPU-geheugen in één node voor grote modellen
  • Ingebouwde ConnectX-8- en BlueField-3-netwerken voor scale-out
  • DGX-software houdt elke node in een cluster vanaf dag één consistent

Belangrijkste specificaties

GPU's8× Blackwell Ultra
GPU-geheugen2.3 TB total
AI-prestaties72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
Netwerken8× ConnectX-8, 2× BlueField-3 DPU

Wat Workstation doet: We controleren rackstroom en luchtstroom, leveren en monteren het systeem in het rack, sluiten het aan op uw fabric en dragen het over met gevalideerde DGX OS en drivers.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Systemen en platforms

NVIDIA DGX B200

Beproefde Blackwell DGX voor training en inferentie

Acht via NVLink verbonden Blackwell-GPU's in één DGX-chassis, een veelgebruikte bouwsteen voor on-premises AI.

Voor wie het geschikt is: Teams die overstappen van Hopper of cloud-GPU's naar een eigen Blackwell-platform

Voordelen

  • Eén platform voor training, fine-tuning en inferentie
  • 1.440 GB GPU-geheugen verdeeld over acht via NVLink verbonden GPU's
  • Past in de BasePOD- en SuperPOD-referentieontwerpen naarmate u groeit

Belangrijkste specificaties

GPU's8× Blackwell
GPU-geheugen1,440 GB total
AI-prestaties72 PFLOPS training, 144 PFLOPS inference
Netwerken8× ConnectX-7, 2× BlueField-3 DPU

Wat Workstation doet: We dimensioneren het op basis van uw modellen, leveren en installeren het, en richten drivers, CUDA en NVIDIA AI Enterprise in vóór de overdracht.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
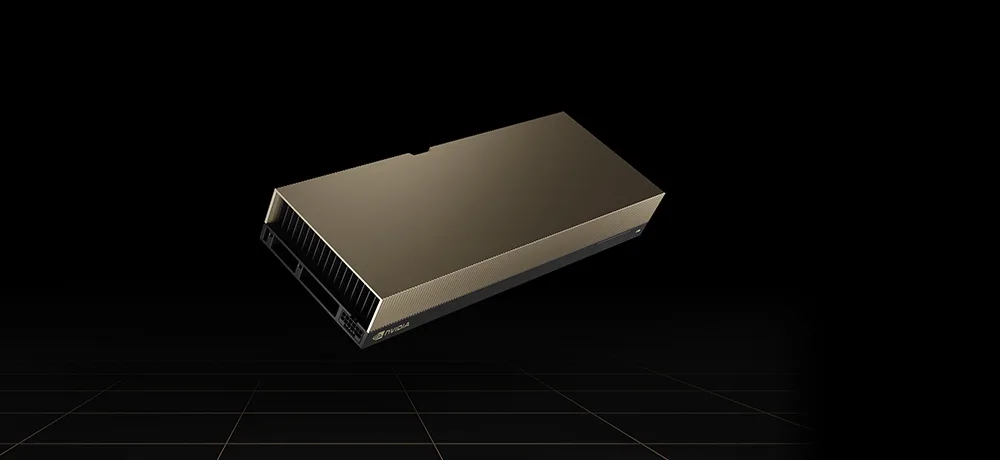
Systemen en platforms

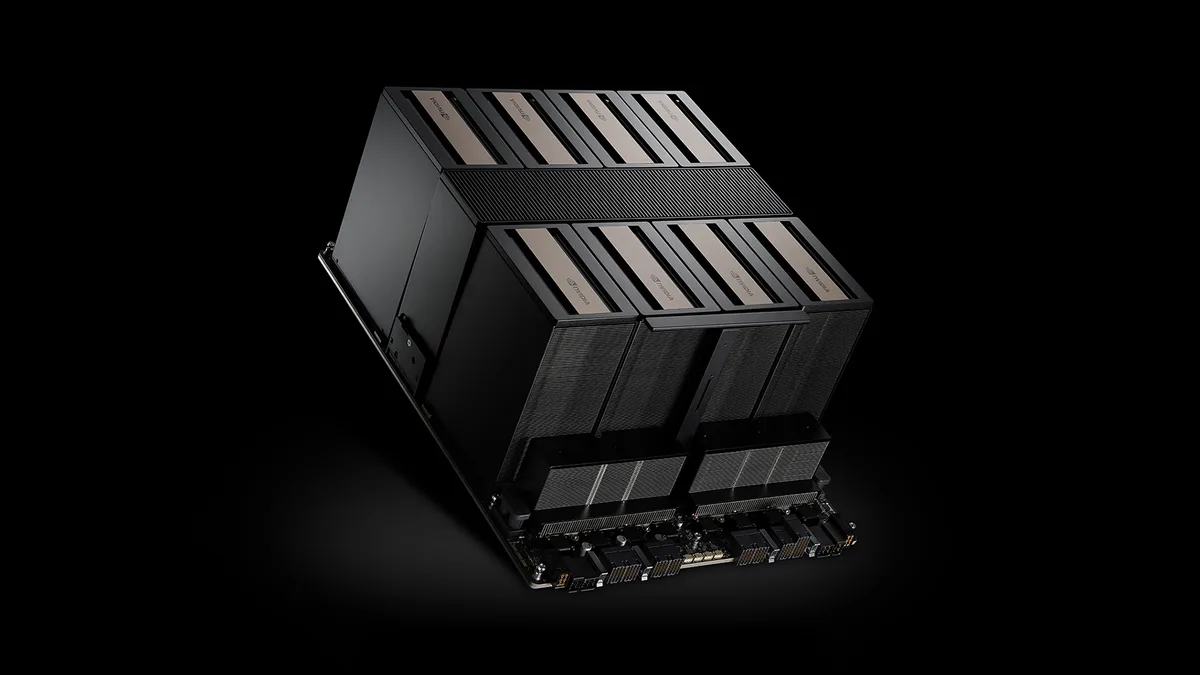
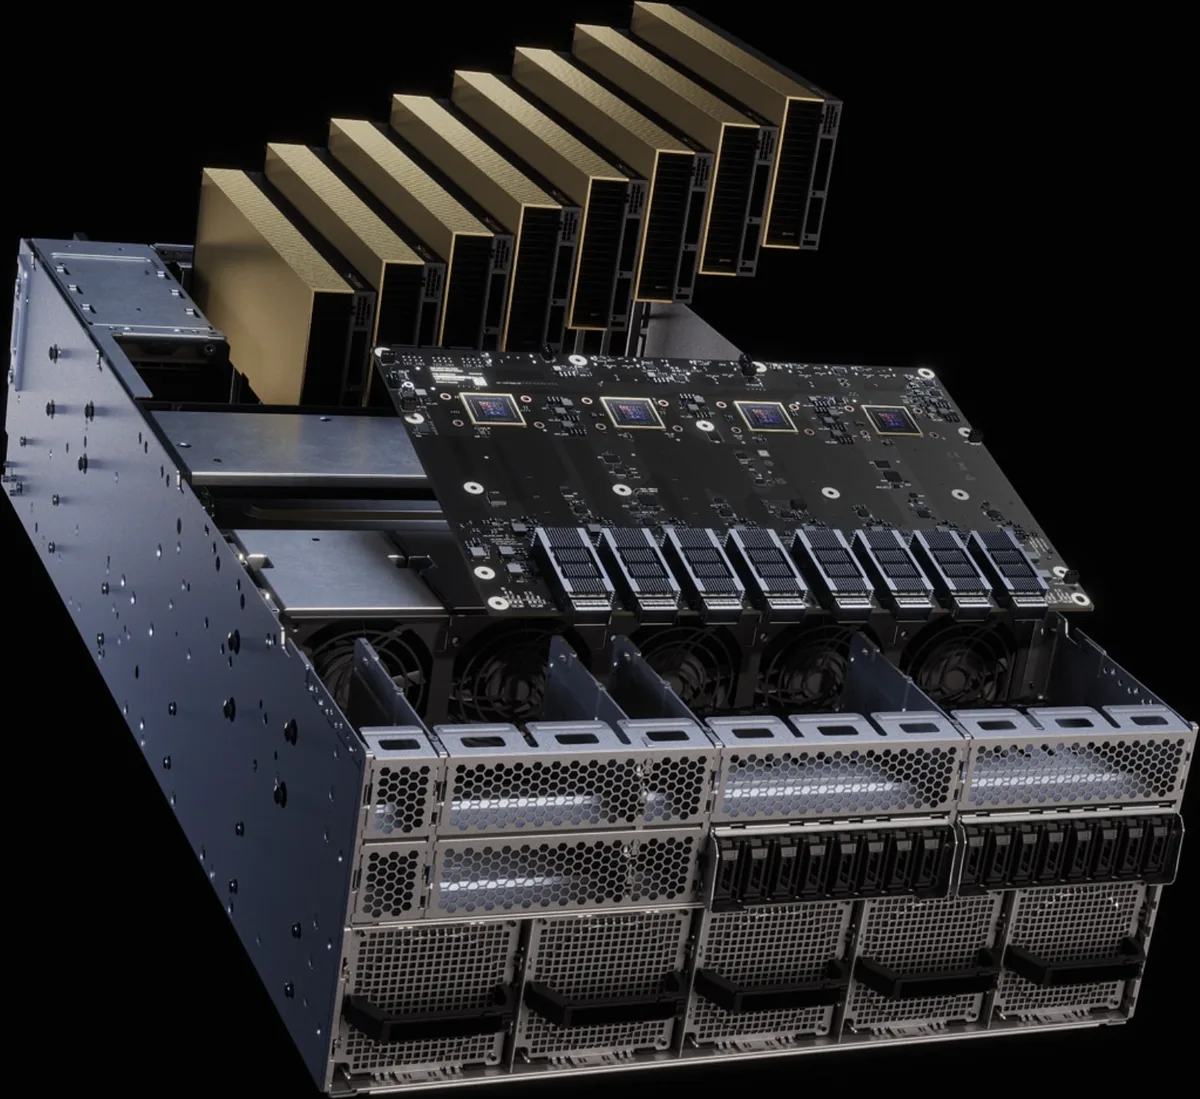
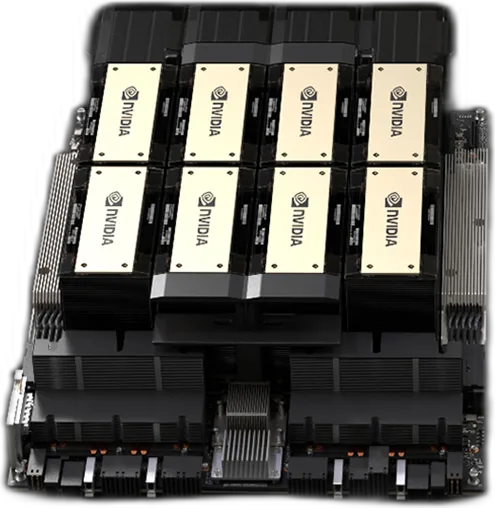
NVIDIA HGX

Baseboard met acht GPU's in servers van partners

HGX is NVIDIA's via NVLink verbonden GPU-baseboard dat serverfabrikanten in hun eigen systemen inbouwen. Zo krijgt u topklasse GPU's met uw keuze van chassis, CPU en supportmerk.

Voor wie het geschikt is: Organisaties die vlaggenschip-GPU's willen van hun favoriete serverleverancier

Voordelen

  • Kies het servermerk, de CPU en de opslag die bij uw omgeving passen
  • NVLink en NVSwitch verbinden alle acht GPU's op volle snelheid
  • Omvat de Blackwell-, Blackwell Ultra- en Rubin-generaties

Belangrijkste specificaties

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
NVLink-bandbreedte14.4 TB/s total (HGX B300 and B200)

Wat Workstation doet: We betrekken de HGX-server van het merk van uw voorkeur, voeren in onze werkplaats een burn-in op volle belasting uit en installeren hem met uw netwerk.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
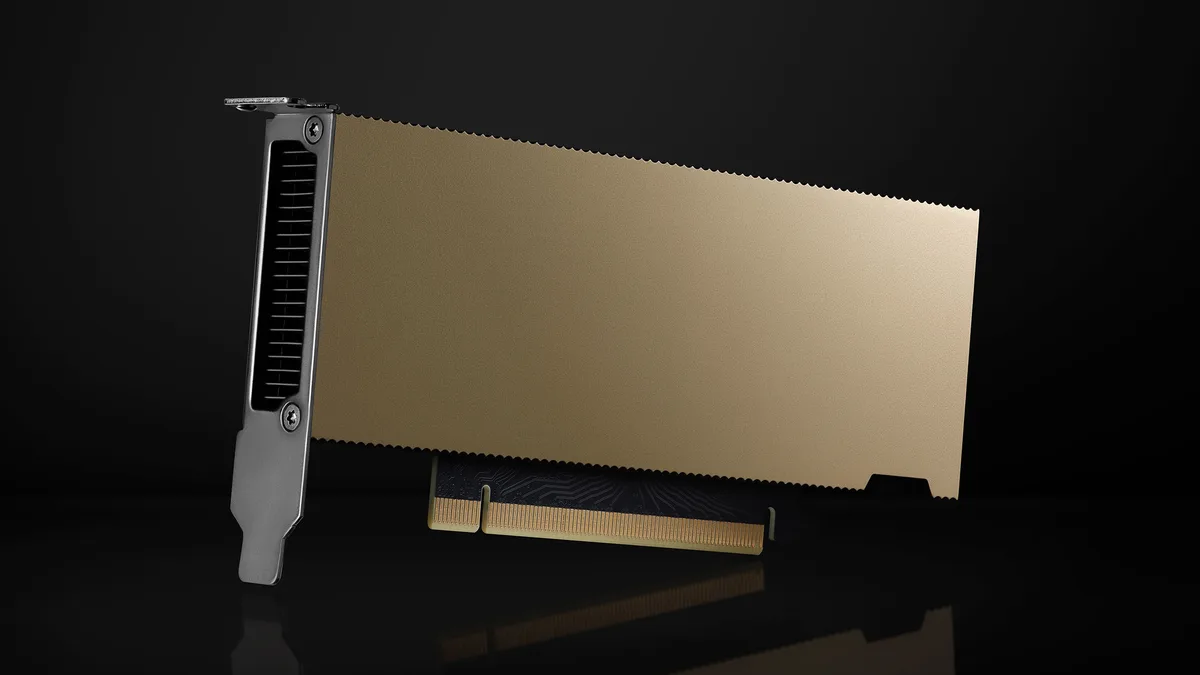
Systemen en platforms

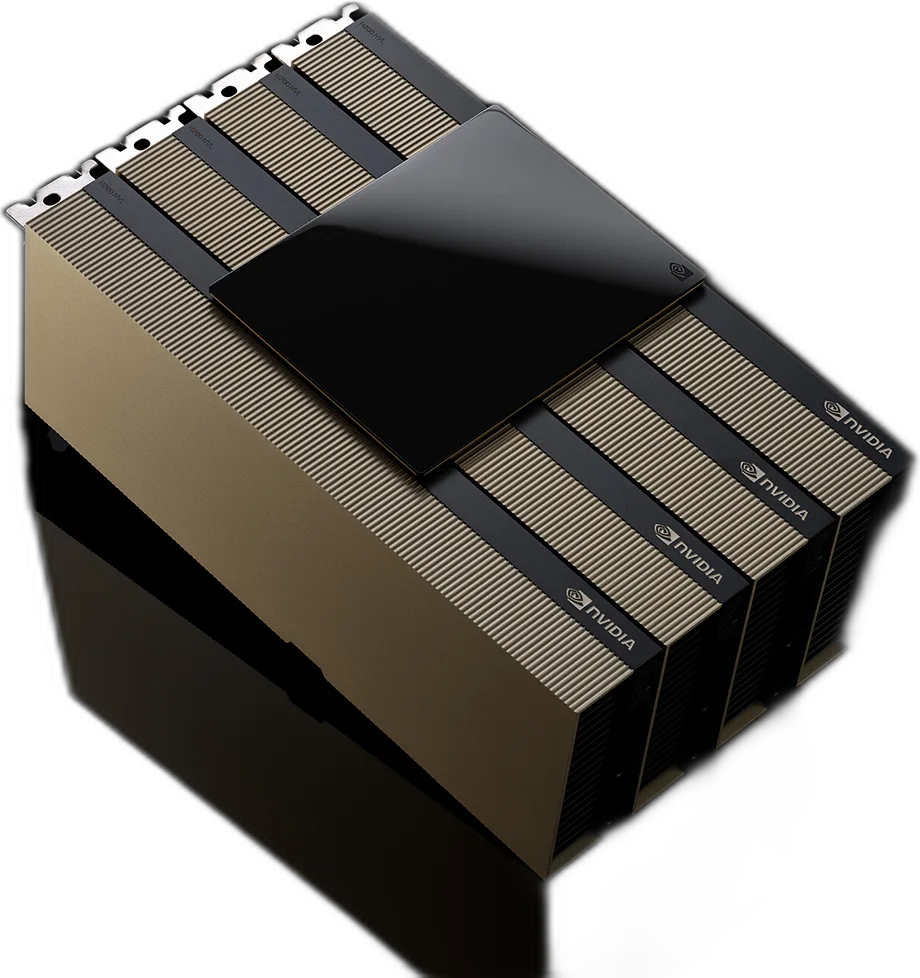
NVIDIA RTX PRO Server

Universele Blackwell-server voor zakelijke AI en graphics

Een datacenterserver met maximaal acht RTX PRO 6000 Blackwell Server Edition-GPU's die AI, simulatie, rendering en virtuele workstations op één platform draait. Het is NVIDIA's mainstream versnelde server, en de EGX-pagina verwijst nu hierheen.

Voor wie het geschikt is: Ondernemingen die bestaande datacenterworkloads naar GPU's verplaatsen, naast nieuwe AI-diensten

Voordelen

  • Eén servertype voor AI-inferentie, visual computing en data science
  • Luchtgekoelde opties passen in de meeste bestaande serverruimtes
  • Gevalideerd met NVIDIA AI Enterprise en Omniverse

Belangrijkste specificaties

GPU'sUp to 8× RTX PRO 6000 Blackwell Server Edition
GPU-geheugen800 GB (8-GPU configuration)
Geheugenbandbreedte13 TB/s (8-GPU configuration)
RTX-graphics3 PFLOPS
ConfiguratiesMGX 2U, 4U and 6U (6U liquid cooled)

Wat Workstation doet: We specificeren het chassis en het aantal GPU's op basis van uw workloads, controleren of het NVIDIA-Certified is, en bouwen, testen met burn-in en installeren het vervolgens.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
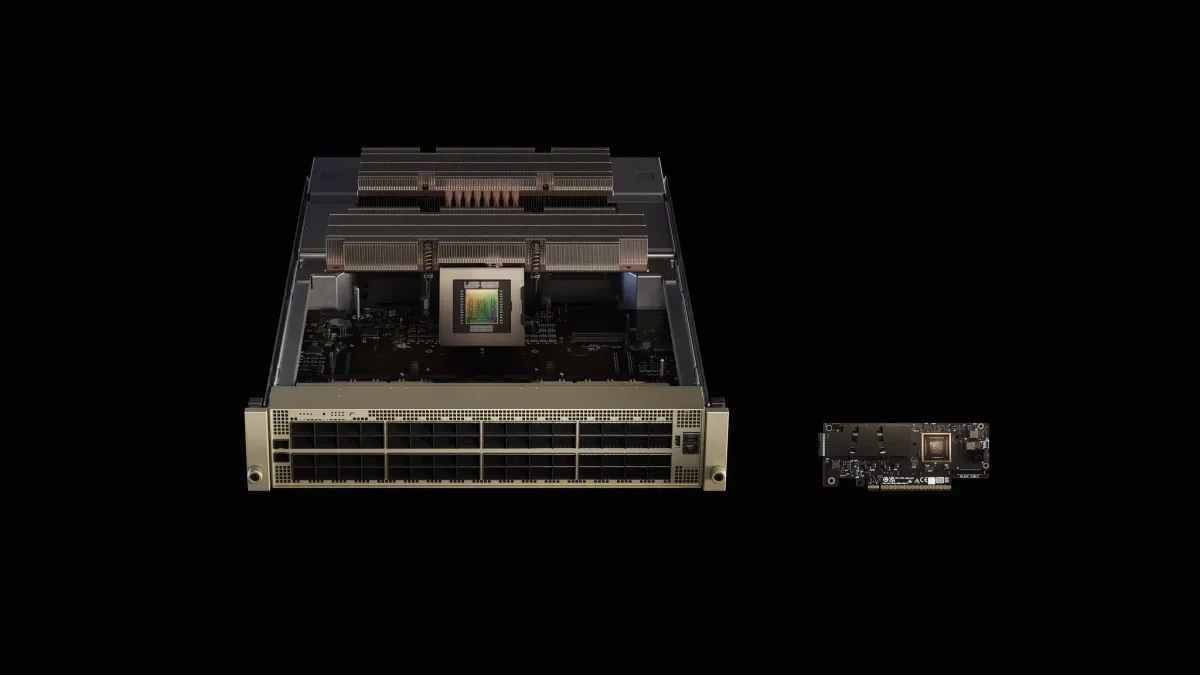
Systemen en platforms

NVIDIA DGX SuperPOD

Turnkey-blauwdruk voor AI-fabrieken op schaal

Een full-stack referentiearchitectuur die DGX-systemen, NVIDIA-netwerken, gecertificeerde opslag en beheersoftware combineert in herhaalbare schaalbare eenheden.

Voor wie het geschikt is: Onderzoekslabs, grote ondernemingen en AI-serviceproviders die clusters van honderden of duizenden GPU's bouwen

Voordelen

  • Een getest ontwerp neemt een groot deel van het integratierisico weg
  • Schaalt naar tienduizenden GPU's in herhaalbare eenheden
  • Inclusief Mission Control en Base Command Manager voor operations

Belangrijkste specificaties

TypeReference architecture
BouwsteenScalable units of DGX systems
SchaalUp to tens of thousands of GPUs
OpslagNVIDIA-certified partner storage
SoftwareNVIDIA AI Enterprise, Base Command Manager, Mission Control

Wat Workstation doet: We leiden het ontwerp samen met NVIDIA en opslagpartners, voeren het projectplan uit, installeren de schaalbare eenheden en blijven uw aanspreekpunt voor ondersteuning.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
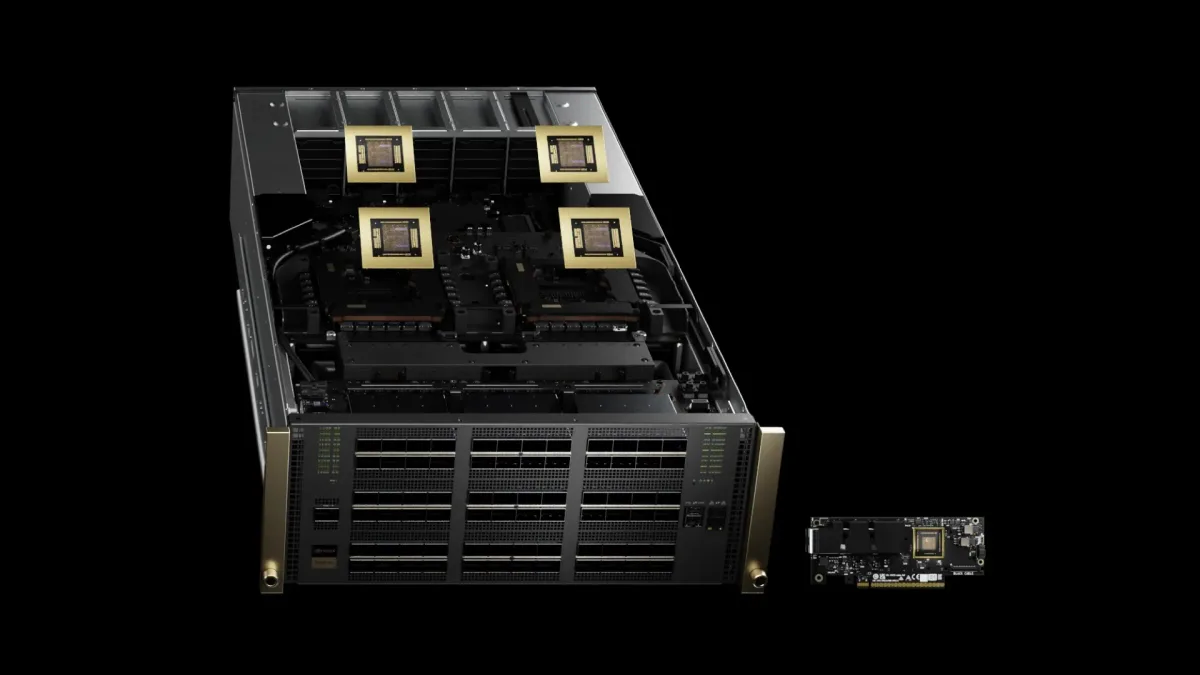
Systemen en platforms

NVIDIA DGX BasePOD

Referentieontwerp voor uw eerste DGX-cluster

Een beproefd ontwerp voor twee of meer DGX-systemen met bijpassende netwerken, opslag en clustersoftware: kleiner dan een SuperPOD, maar op dezelfde manier gebouwd.

Voor wie het geschikt is: Teams die van één DGX-systeem doorgroeien naar een klein gedeeld cluster

Voordelen

  • Begin met twee systemen en breid uit zonder opnieuw te ontwerpen
  • Netwerken en opslag afgestemd op de GPU's
  • Clustersoftware voor planning en monitoring inbegrepen

Belangrijkste specificaties

TypeReference architecture
Schaal2 or more DGX systems
NetwerkenPer reference architecture
OpslagPartner storage
SoftwareNVIDIA AI Enterprise, Base Command

Wat Workstation doet: We dimensioneren het cluster, leveren elk onderdeel, monteren en bekabelen het, en richten de planning in zodat uw teams het vanaf dag één kunnen delen.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
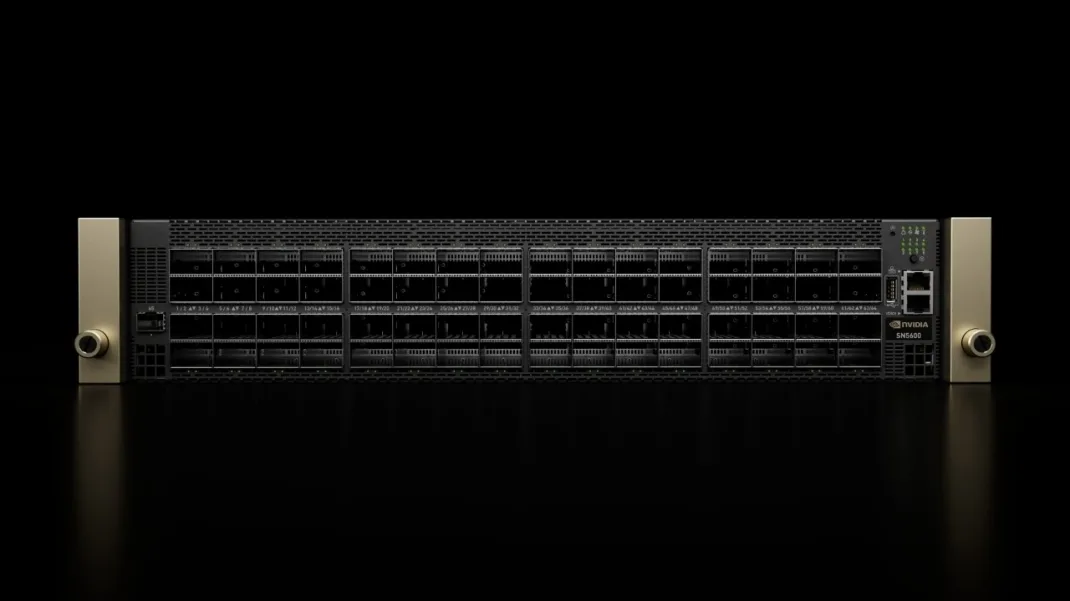
Systemen en platforms

NVIDIA Grace- en Vera-CPU's

Arm-datacenter-CPU's gebouwd voor AI-fabrieken

NVIDIA's eigen CPU's zijn via NVLink-C2C met de GPU's verbonden. De Grace CPU Superchip wordt nu al in partnerservers geleverd, en de opvolger, Vera, is gericht op agentic AI.

Voor wie het geschikt is: HPC-centra, cloudbouwers en iedereen die CPU-intensieve pipelines naast GPU's draait

Voordelen

  • Hoge geheugenbandbreedte dankzij LPDDR5X
  • Volgens NVIDIA twee keer de prestaties bij hetzelfde vermogen als toonaangevende traditionele CPU's
  • Een coherente, snelle verbinding met NVIDIA-GPU's

Belangrijkste specificaties

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Grace-geheugenbandbreedteUp to 1 TB/s LPDDR5X
Vera-CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

Wat Workstation doet: We zoeken de partnerserver die bij uw softwarestack past, testen samen met u uw applicaties op Arm, en bouwen en ondersteunen vervolgens het resultaat.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
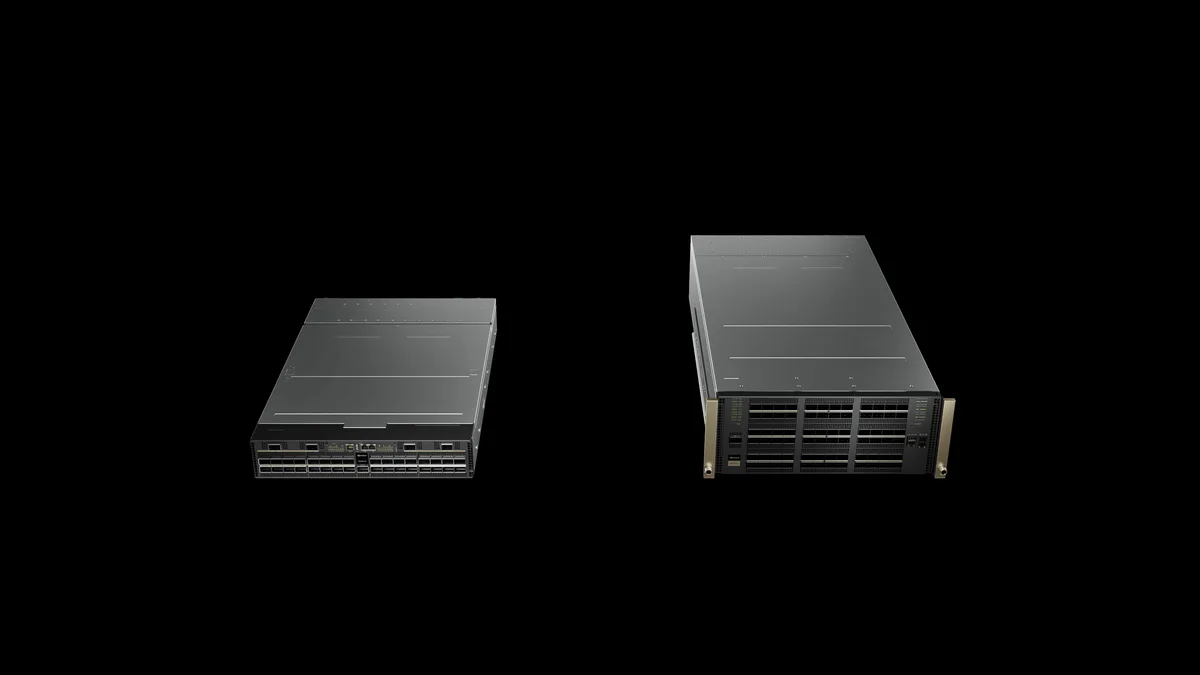
Systemen en platforms

NVIDIA OVX

L40S-servers voor Omniverse en digital twins

OVX is NVIDIA's gevalideerde serverontwerp voor Omniverse, dat L40S-GPU's combineert met ConnectX-7- of BlueField-3-netwerken voor simulatie, rendering en AI.

Voor wie het geschikt is: Fabrikanten, architecten en engineeringteams die industriële digital twins bouwen

Voordelen

  • Eén server voor graphics, simulatie en AI-inferentie
  • Gevalideerd voor Omniverse en NVIDIA AI Enterprise
  • Schaalt over honderden servers op een snelle fabric

Belangrijkste specificaties

GPU's4× or 8× NVIDIA L40S
CPU's2× Intel Xeon Gold or 2× AMD EPYC
Hostgeheugen384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
Opslag1 TB NVMe boot, 2× 4 TB NVMe
NetwerkenConnectX-7 or BlueField-3

Wat Workstation doet: We bouwen servers volgens het OVX-patroon van gecertificeerde partners, richten Omniverse en drivers in en koppelen ze aan uw ontwerptools.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Systemen en platforms

NVIDIA AGX (Jetson AGX Thor)

AI-computers voor robots en autonome machines

AGX is NVIDIA's platform voor autonome machines. Het huidige vlaggenschip, Jetson AGX Thor, brengt een Blackwell-GPU naar robots, voertuigen en slimme machines.

Voor wie het geschikt is: Robotica-, automotive- en industriële teams die AI in machines inbouwen

Voordelen

  • Draait perceptie- en generatieve AI-modellen op de machine zelf
  • Laag stroomverbruik past bij mobiele en embedded ontwerpen
  • Gebruikt dezelfde CUDA-software als NVIDIA's datacenterplatforms

Belangrijkste specificaties

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
AI-prestaties2070 TFLOPS (FP4)
OptiesDeveloper kit, or T5000 and T4000 production modules

Wat Workstation doet: We leveren developer kits en productiemodules, helpen bij het kiezen van carrier boards en behuizingen, en ondersteunen u van prototype tot uitrol.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Systemen en platforms

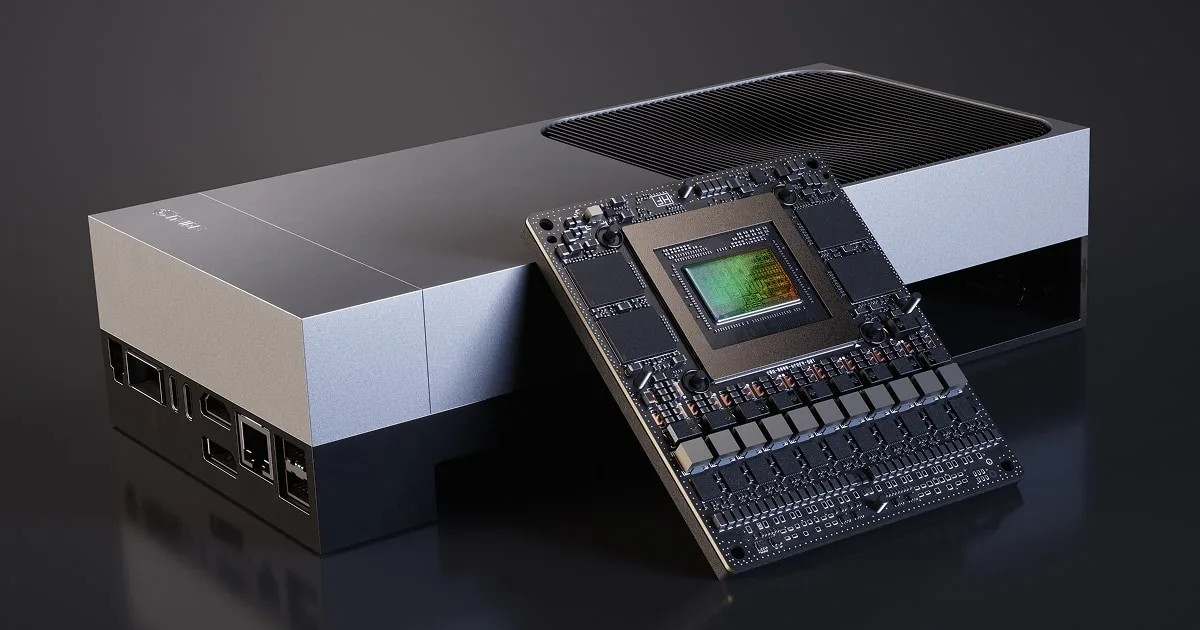
NVIDIA IGX Thor

Industriële edge-AI met functionele veiligheid

IGX is NVIDIA's zakelijke platform voor fysieke AI aan de industriële en medische edge, met een speciaal safety island en langdurige softwareondersteuning.

Voor wie het geschikt is: Fabrikanten van medische apparatuur, fabrieken en infrastructuurbeheerders die veiligheidscertificering en een lange ondersteuningsduur nodig hebben

Voordelen

  • Ontwerp voor functionele veiligheid gericht op ISO 26262 en IEC 61508
  • Tien jaar NVIDIA-ondersteuning voor enterprise-software
  • Optionele RTX PRO Blackwell-GPU voor zwaardere modellen

Belangrijkste specificaties

AI-prestatiesUp to 5,581 TFLOPS FP4 (sparse) with discrete GPU
Geïntegreerde GPU2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
Geheugen128 GB LPDDR5X, 273 GB/s
Vermogen40–130 W, up to 300 W for the discrete GPU

Wat Workstation doet: We leveren developer kits en productiesystemen, helpen u bij het plannen van certificeringsbewijs en ondersteunen de uitrol op uw locatie.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Systemen en platforms

NVIDIA Groq 3 LPX

Inferentierack met lage latentie voor Vera Rubin

LPX is een rack met 256 LPU-inferentieaccelerators dat samenwerkt met Vera Rubin NVL72 om snel en voorspelbaar tokens te genereren voor interactieve en agentic AI.

Voor wie het geschikt is: AI-serviceproviders van wie de gebruikers snelle, consistente responstijden nodig hebben

Voordelen

  • Deterministische tokengeneratie met lage latentie
  • Volgens NVIDIA's prognoses veel hogere doorvoer per megawatt voor modellen met biljoenen parameters
  • Een directe verbinding met lage latentie naar NVL72-racks

Belangrijkste specificaties

Accelerators256 LPUs per rack
On-chip geheugen128 GB SRAM per rack (500 MB per LPU)
SRAM-bandbreedte40 PB/s per rack
Scale-up-bandbreedte640 TB/s per rack
VormfactorNVIDIA MGX ETL rack

Wat Workstation doet: We beoordelen hoe het in uw Vera Rubin-plannen past, bevestigen de beschikbaarheid bij NVIDIA en plannen de installatie naast uw andere racks.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Datacenter-GPU's

NVIDIA H200 (SXM)

Hopper-GPU met 141 GB HBM3e

De H200 behoudt de Hopper-architectuur, maar voegt veel meer en sneller geheugen toe, wat inferentie op grote modellen en geheugengebonden HPC ten goede komt. De SXM-versie gaat in HGX-servers.

Voor wie het geschikt is: Teams die grote taalmodellen en HPC-code draaien op HGX-servers

Voordelen

  • 141 GB per GPU biedt ruimte aan grotere modellen zonder ze op te splitsen
  • Hogere geheugenbandbreedte versnelt geheugengebonden werk
  • Draait dezelfde CUDA-software als de H100

Belangrijkste specificaties

ArchitectuurNVIDIA Hopper
GPU-geheugen141 GB HBM3e
VormfactorSXM (HGX)
KoelingPassive (server airflow)

Wat Workstation doet: We leveren de H200 in een gecertificeerde HGX-server, voeren de burn-in uit en installeren hem met uw drivers en softwarestack.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Datacenter-GPU's

NVIDIA H200 NVL

Hopper-GPU van 141 GB voor luchtgekoelde PCIe-servers

De PCIe-versie van de H200 voor standaard zakelijke racks. Met NVLink-bridges kunnen kaarten worden gekoppeld voor modellen die meer geheugen nodig hebben.

Voor wie het geschikt is: Ondernemingen die inferentie op grote modellen toevoegen aan bestaande luchtgekoelde serverruimtes

Voordelen

  • Veel GPU-geheugen zonder over te stappen op vloeistofkoeling
  • NVLink-bridges koppelen GPU's voor grotere modellen
  • Past in gangbare NVIDIA-Certified servers

Belangrijkste specificaties

ArchitectuurNVIDIA Hopper
GPU-geheugen141 GB HBM3e
VormfactorPCIe, dual slot
KoelingPassive (server airflow)

Wat Workstation doet: We controleren uw chassis op stroom, luchtstroom en slotindeling, en monteren, testen en leveren vervolgens de kaarten of een complete server.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Datacenter-GPU's

NVIDIA H100 PCIe 80 GB

Hopper-GPU voor training en inferentie in PCIe-servers

De PCIe H100 brengt de Transformer Engine en confidential computing van Hopper naar standaardservers.

Voor wie het geschikt is: Teams met bestaande PCIe-GPU-servers die beproefde Hopper-prestaties nodig hebben

Voordelen

  • De Transformer Engine versnelt training en inferentie van taalmodellen
  • Multi-Instance GPU verdeelt één kaart in geïsoleerde instances
  • Hardwareondersteuning voor confidential computing

Belangrijkste specificaties

ArchitectuurNVIDIA Hopper
GPU-geheugen80 GB HBM2e
VormfactorDual-slot, full height, full length
KoelingPassive (server airflow)
InterfacePCIe

Wat Workstation doet: We plaatsen de H100 in servers waarvoor hij gecertificeerd is, voeren de burn-in uit en richten CUDA, drivers en eventuele vGPU- of AI Enterprise-licenties in.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
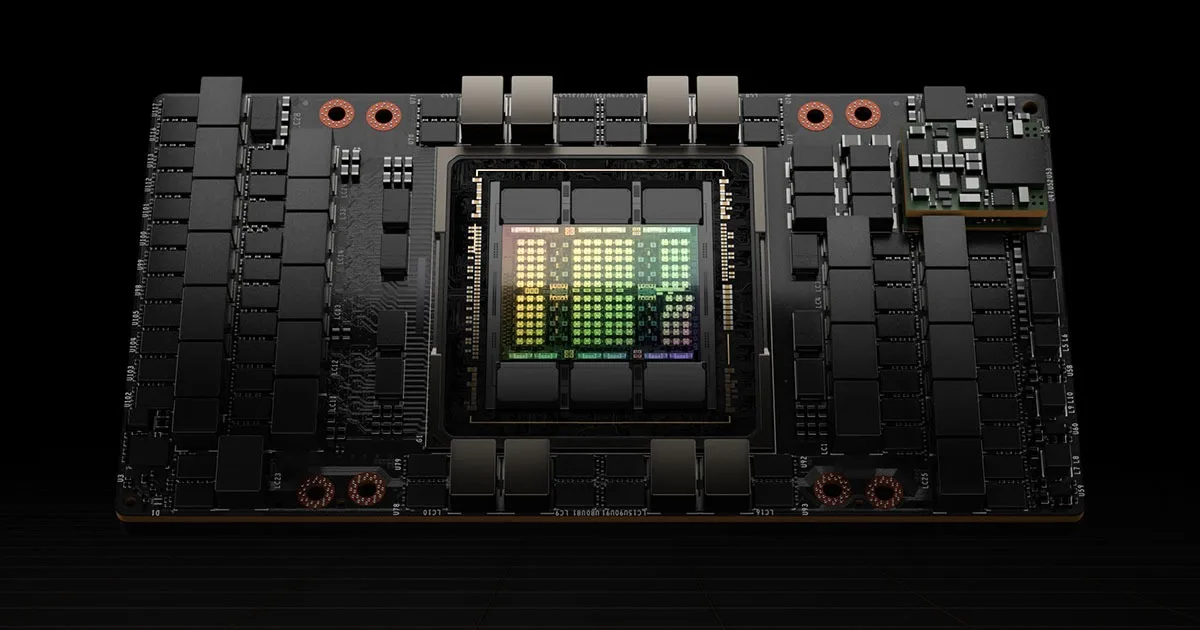
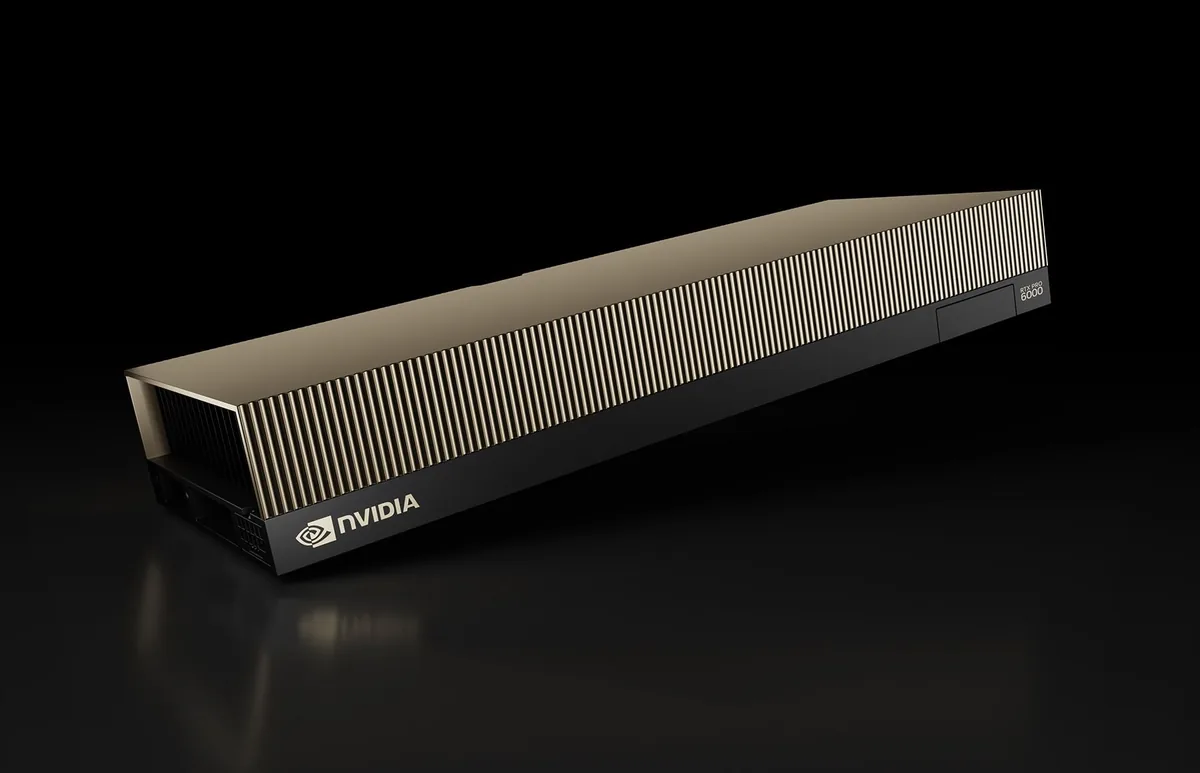
Datacenter-GPU's

NVIDIA RTX PRO 6000 Blackwell Server Edition

Blackwell-GPU van 96 GB voor rackservers

Een passief gekoelde Blackwell-kaart met 96 GB geheugen voor AI-inferentie, rendering, simulatie en virtuele workstations in het datacenter.

Voor wie het geschikt is: Ondernemingen die AI- en graphicsworkloads consolideren op één GPU-type

Voordelen

  • 96 GB per GPU kan grote modellen en omvangrijke scènes aan
  • Draait zowel AI als professionele graphics
  • Configureerbaar vermogen afgestemd op de server

Belangrijkste specificaties

ArchitectuurNVIDIA Blackwell
GPU-geheugen96 GB GDDR7 with ECC
Max. vermogenUp to 600 W (configurable)
InterfacePCIe 5.0 x16
VormfactorDual-slot, passive (server airflow)

Wat Workstation doet: We leveren de kaarten los of in een RTX PRO Server, en testen ze vóór levering op volle belasting.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗
Datacenter-GPU's

NVIDIA RTX PRO 4500 Blackwell Server Edition

Single-slot Blackwell-GPU voor compacte servers

Een compacte, passief gekoelde Blackwell-GPU van 32 GB waarmee u veel kaarten in een server kwijt kunt voor inferentie, video en virtuele desktops.

Voor wie het geschikt is: Teams die inferentie of virtuele desktops opschalen voor veel gebruikers tegen lagere kosten per GPU

Voordelen

  • Single-slot ontwerp past meer GPU's per server
  • 32 GB GDDR7 voor middelgrote modellen
  • Lager vermogen past in bestaande racks

Belangrijkste specificaties

ArchitectuurNVIDIA Blackwell
GPU-geheugen32 GB GDDR7
VormfactorSingle slot, 4.4" H × 10.5" L
KoelingPassive (server airflow)

Wat Workstation doet: We berekenen hoeveel kaarten uw servers van stroom en koeling kunnen voorzien, en bouwen en testen vervolgens de configuratie.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

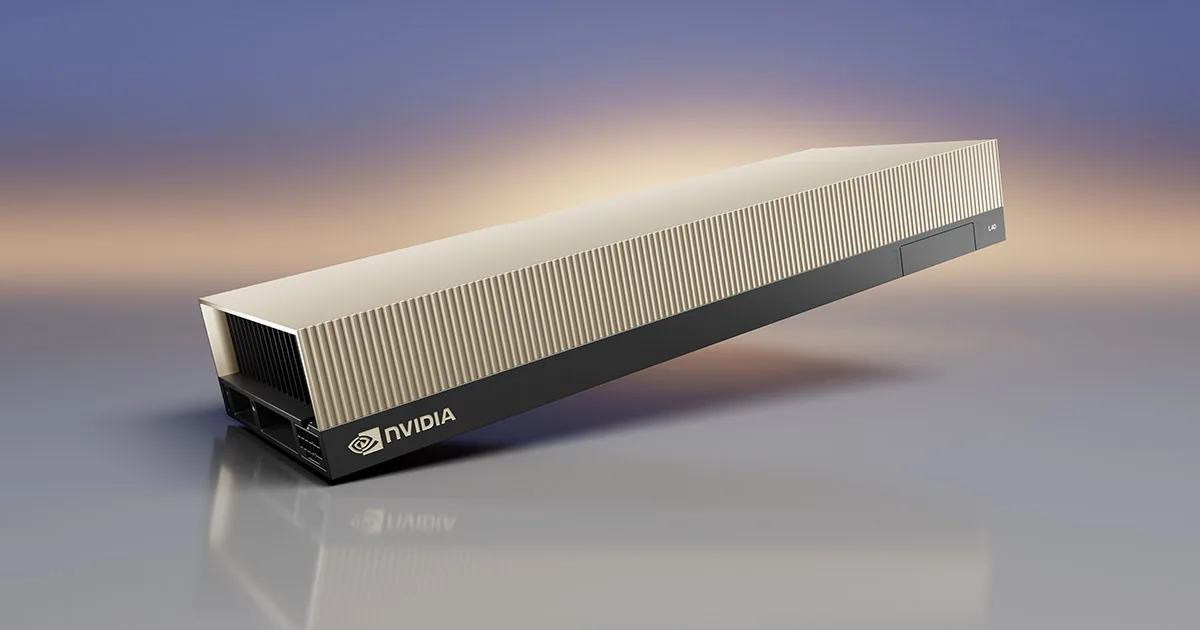
Datacenter-GPU's

NVIDIA L40S

Allrounder van 48 GB voor AI en graphics

Een Ada Lovelace-datacenter-GPU in balans voor inferentie, fine-tuning en 3D-graphics, en de GPU in NVIDIA's OVX-ontwerp.

Voor wie het geschikt is: Teams die één GPU nodig hebben voor zowel AI- als visuele workloads

Voordelen

  • Sterke inferentie- en fine-tuningprestaties voor de prijs
  • Hardwarematige ray tracing voor rendering en Omniverse
  • Een standaard PCIe-kaart voor gangbare servers

Belangrijkste specificaties

ArchitectuurNVIDIA Ada Lovelace
GPU-geheugen48 GB GDDR6 with ECC
VormfactorDual-slot, 4.4" H × 10.5" L
KoelingPassive (server airflow)
InterfacePCIe

Wat Workstation doet: We koppelen de L40S aan gecertificeerde servers, voeren de burn-in van de build uit en installeren hem met drivers en licenties ingericht.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Datacenter-GPU's

NVIDIA L40

GPU van 48 GB voor rendering en virtuele workstations

De L40 richt zich op graphics: rendering, Omniverse en virtuele workstations in het datacenter.

Voor wie het geschikt is: Design- en mediateams die workstations naar het datacenter verplaatsen

Voordelen

  • 48 GB voor grote scènes en assets
  • Ondersteunt NVIDIA virtual GPU-software
  • Passieve koeling voor standaardservers

Belangrijkste specificaties

ArchitectuurNVIDIA Ada Lovelace
GPU-geheugen48 GB GDDR6 with ECC
VormfactorDual-slot, 4.4" H × 10.5" L
KoelingPassive (server airflow)
InterfacePCIe

Wat Workstation doet: We richten vGPU-profielen en licenties in, zodat uw gebruikers externe workstations krijgen die aanvoelen als lokaal.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Datacenter-GPU's

NVIDIA L4

Low-profile GPU voor efficiënte inferentie en video

Een kleine, zuinige Ada Lovelace-kaart voor video-AI, inferentie en virtuele desktops, van de edge tot het datacenter.

Voor wie het geschikt is: Organisaties die AI toevoegen aan veel servers, of aan edge-locaties met een krap stroombudget

Voordelen

  • Laag vermogen en een low-profile kaart passen in vrijwel elke server
  • Zeer geschikt voor videoanalyse en inferentie
  • Schaalt voordelig uit over veel nodes

Belangrijkste specificaties

ArchitectuurNVIDIA Ada Lovelace
GPU-geheugen24 GB GDDR6
VormfactorSingle-slot, low profile
KoelingPassive (server airflow)
InterfacePCIe

Wat Workstation doet: We controleren de compatibiliteit met uw bestaande servers, leveren de kaarten en richten drivers en inferentiesoftware in.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Netwerken

NVIDIA Spectrum-X Ethernet-platform

Ethernet afgestemd op AI-fabrieken

Spectrum-X combineert Spectrum Ethernet-switches met Spectrum-X SuperNICs om AI-clusters voorspelbaar Ethernet met hoge doorvoer te bieden.

Voor wie het geschikt is: Organisaties die een AI-fabric willen dat hun netwerkteam al weet te beheren

Voordelen

  • Hogere effectieve bandbreedte voor GPU-naar-GPU-verkeer dan standaard Ethernet
  • Gebruikt vertrouwde Ethernet-tools en -vaardigheden
  • Onderdeel van NVIDIA's gevalideerde AI-fabriekontwerpen

Belangrijkste specificaties

TypeEthernet networking platform
ComponentenNVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
ToepassingAI clusters and AI factories

Wat Workstation doet: We ontwerpen het fabric, leveren switches, SuperNICs en kabels, installeren en testen het, en documenteren het voor uw team.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Netwerken

NVIDIA Quantum-X800 InfiniBand-platform

Next-generation InfiniBand voor grootschalige training

Quantum-X800-switches en ConnectX-8 SuperNICs vormen NVIDIA's krachtigste InfiniBand-fabric voor AI-training en HPC.

Voor wie het geschikt is: HPC-centra en AI-teams die op grote schaal trainen

Voordelen

  • Zeer lage latentie voor sterk gekoppelde taken
  • Ontworpen voor de grootste trainings- en HPC-clusters
  • Beheerd en gemonitord met UFM

Belangrijkste specificaties

TypeInfiniBand networking platform
ComponentenNVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
ToepassingLarge-scale AI training and HPC

Wat Workstation doet: We ontwerpen de topologie, leveren en bekabelen elke link en brengen het fabric in bedrijf met UFM-monitoring ingericht.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Netwerken

NVIDIA Spectrum Ethernet-switches

Datacenter-Ethernet-switches tot 800 Gb/s

Spectrum-switches verwerken AI-, opslag- en cloudverkeer, zelfstandig of als onderdeel van Spectrum-X.

Voor wie het geschikt is: Datacenter- en netwerkteams die hun leaf- en spine-switching vernieuwen

Voordelen

  • Poortsnelheden tot 800 Gb/s
  • Werkt in AI-fabrics en algemene datacenternetwerken
  • Te combineren met NetQ voor netwerkbeheer en telemetrie

Belangrijkste specificaties

TypeEthernet switch family
PoortsnelheidUp to 800 Gb/s
GebruikAI and cloud data-centre fabrics

Wat Workstation doet: We dimensioneren poorten en optiek, configureren de switches en integreren ze met uw bestaande netwerk.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Netwerken

NVIDIA Quantum InfiniBand-switches

Switching met lage latentie voor HPC en AI

Quantum InfiniBand-switches vormen de fabrics met lage latentie waarop HPC- en AI-clusters vertrouwen.

Voor wie het geschikt is: Research computing- en AI-teams met sterk gekoppelde workloads

Voordelen

  • Zeer lage latentie tussen nodes
  • Beproefd in HPC- en AI-clusters
  • Centraal beheer met UFM

Belangrijkste specificaties

TypeInfiniBand switch family
GebruikHPC and AI data centres

Wat Workstation doet: We plannen de topologie, leveren kabels en optiek, en installeren en verifiëren het fabric.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Netwerken

NVIDIA ConnectX NICs en SuperNICs

Netwerkadapters voor Ethernet en InfiniBand

ConnectX-adapters verbinden servers met het fabric. SuperNICs zoals ConnectX-8 zijn afgestemd op GPU-naar-GPU-verkeer in AI-clusters.

Voor wie het geschikt is: Iedereen die GPU-servers of opslag aansluit op een snel netwerk

Voordelen

  • Eén productfamilie voor Ethernet en InfiniBand
  • SuperNICs geven elke GPU een eigen snel pad
  • Hardware-offloads verlagen de CPU-belasting

Belangrijkste specificaties

TypeNetwork adapter and SuperNIC family
FabricsEthernet and InfiniBand
Topsnelheid800 Gb/s per GPU (ConnectX-8 SuperNIC)

Wat Workstation doet: We stemmen adapters, kabels en transceivers af op uw switches en servers, en installeren firmware en drivers.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Netwerken

NVIDIA BlueField DPU's

Data processing units voor netwerken, opslag en beveiliging

BlueField DPU's nemen netwerk-, opslag- en beveiligingstaken over van de server-CPU en isoleren die in speciale hardware.

Voor wie het geschikt is: Cloudbouwers, AI-fabrieken en beveiligingsbewuste organisaties

Voordelen

  • Maakt CPU-cores vrij voor applicaties
  • Isoleert infrastructuurdiensten van tenant-workloads
  • Programmeerbaar met NVIDIA DOCA

Belangrijkste specificaties

TypeData processing unit (DPU) family
GeneratiesBlueField-3, BlueField-4
SoftwareNVIDIA DOCA

Wat Workstation doet: We leveren en plaatsen BlueField-kaarten en helpen u de DOCA-diensten uit te rollen die u nodig hebt.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Software

NVIDIA AI Enterprise

Ondersteunde software voor AI in productie

NVIDIA's suite van AI-frameworks, NIM-microservices en tools, met enterprise-ondersteuning en release branches met lange levensduur.

Voor wie het geschikt is: Elke organisatie die AI in productie draait op NVIDIA-GPU's

Voordelen

  • Enterprise-ondersteuning en stabiele release branches
  • NIM-microservices maken modellen sneller inzetbaar
  • Draait op NVIDIA-Certified systemen on-premises of in de cloud

Belangrijkste specificaties

LicentiesPer GPU subscription
InclusiefAI frameworks, NIM microservices, pretrained models
OndersteuningNVIDIA Enterprise Business Standard Support
Proefversie90-day evaluation

Wat Workstation doet: We maken offertes voor licenties en activeren ze, installeren de software met uw hardware en herinneren u vóór de verlenging.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Software

NVIDIA Mission Control

Operationele software voor AI-fabrieken

Mission Control automatiseert het dagelijkse beheer van grote GPU-clusters, van workload-orkestratie tot health checks en herstel.

Voor wie het geschikt is: Beheerders van DGX SuperPOD en andere grote AI-clusters

Voordelen

  • Automatiseert routinematige clusteroperaties
  • Verbetert de veerkracht door storingen te detecteren en ervan te herstellen
  • Eén overzicht van workloads en infrastructuur

Belangrijkste specificaties

TypeAI-factory operations and cluster management software
FunctiesWorkload orchestration, infrastructure resiliency, cluster automation
LicentiebasisConfirmed on quote

Wat Workstation doet: We rollen Mission Control uit met uw cluster en trainen uw beheerders in het gebruik ervan.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Software

NVIDIA Run:ai

GPU-orkestratie en -planning

Run:ai bundelt GPU's over teams heen en wijst ze op aanvraag toe, zodat dure hardware bezig blijft in plaats van stil te staan.

Voor wie het geschikt is: Organisaties die GPU's delen tussen veel data scientists of projecten

Voordelen

  • Hogere GPU-benutting dankzij dynamische pooling
  • Quota, prioriteiten en toegangsbeheer voor eerlijk delen
  • Werkt in on-premises, hybride en cloudomgevingen

Belangrijkste specificaties

TypeGPU orchestration and scheduling platform
Draait opKubernetes
ImplementatieOn premises, hybrid or cloud
LicentiebasisConfirmed on quote

Wat Workstation doet: We installeren Run:ai op uw Kubernetes-cluster, stellen samen met uw teams quota in en bieden ondersteuning.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Software

NVIDIA Base Command Manager

Clusterprovisioning en -monitoring

Base Command Manager richt GPU-clusters in, monitort en beheert ze, vanaf een handvol nodes.

Voor wie het geschikt is: IT-teams die GPU-clusters van elke omvang beheren

Voordelen

  • Automatiseert provisioning op Arm en x86
  • Health-dashboards en realtime monitoring
  • Webinterface, command line en API

Belangrijkste specificaties

TypeCluster management software
Gratis licentieUp to 8 accelerators per system
Huidige releaseBase Command Manager 11
InterfacesBaseView web UI, CLI, API

Wat Workstation doet: We installeren en configureren Base Command Manager als onderdeel van de clusters die we bouwen.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Software

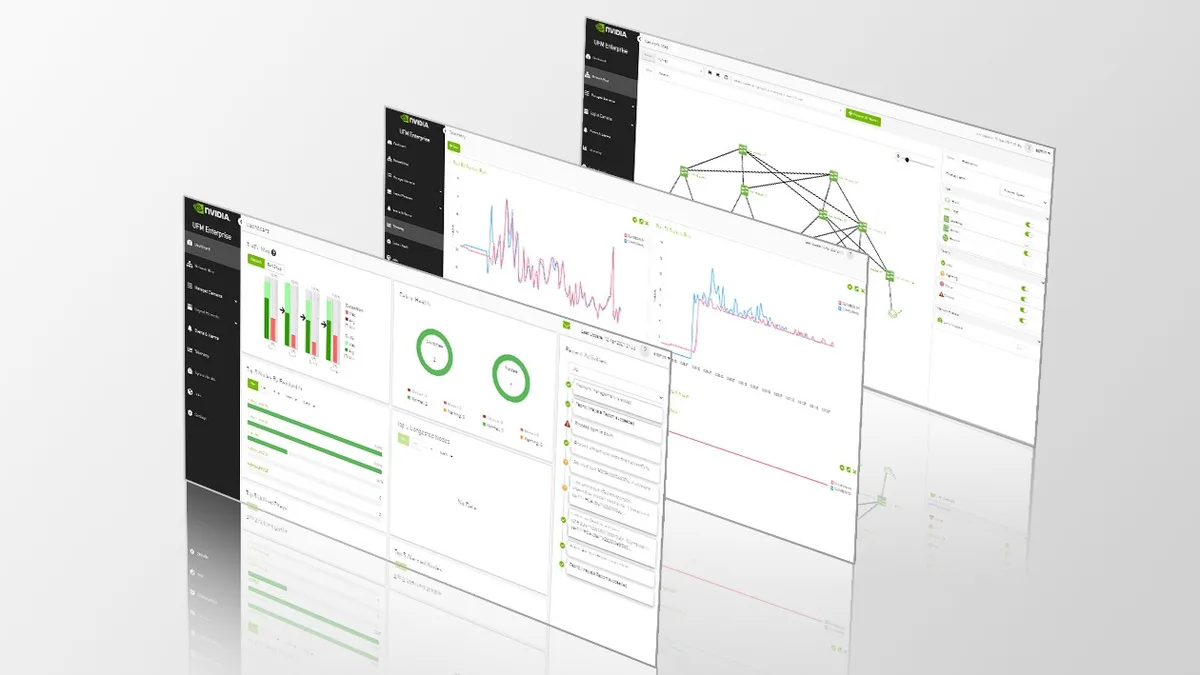
NVIDIA UFM

Unified Fabric Manager voor InfiniBand

UFM monitort en beheert InfiniBand-fabrics en helpt bij probleemoplossing.

Voor wie het geschikt is: Teams die InfiniBand-clusters beheren

Voordelen

  • Realtime fabric-telemetrie
  • Sneller storingen opsporen
  • Centraal beheer van switches en links

Belangrijkste specificaties

TypeInfiniBand fabric management and telemetry software
Werkt metNVIDIA Quantum InfiniBand switches

Wat Workstation doet: We rollen UFM uit met uw fabric en stellen meldingen in die aansluiten op uw operationele procedures.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Software

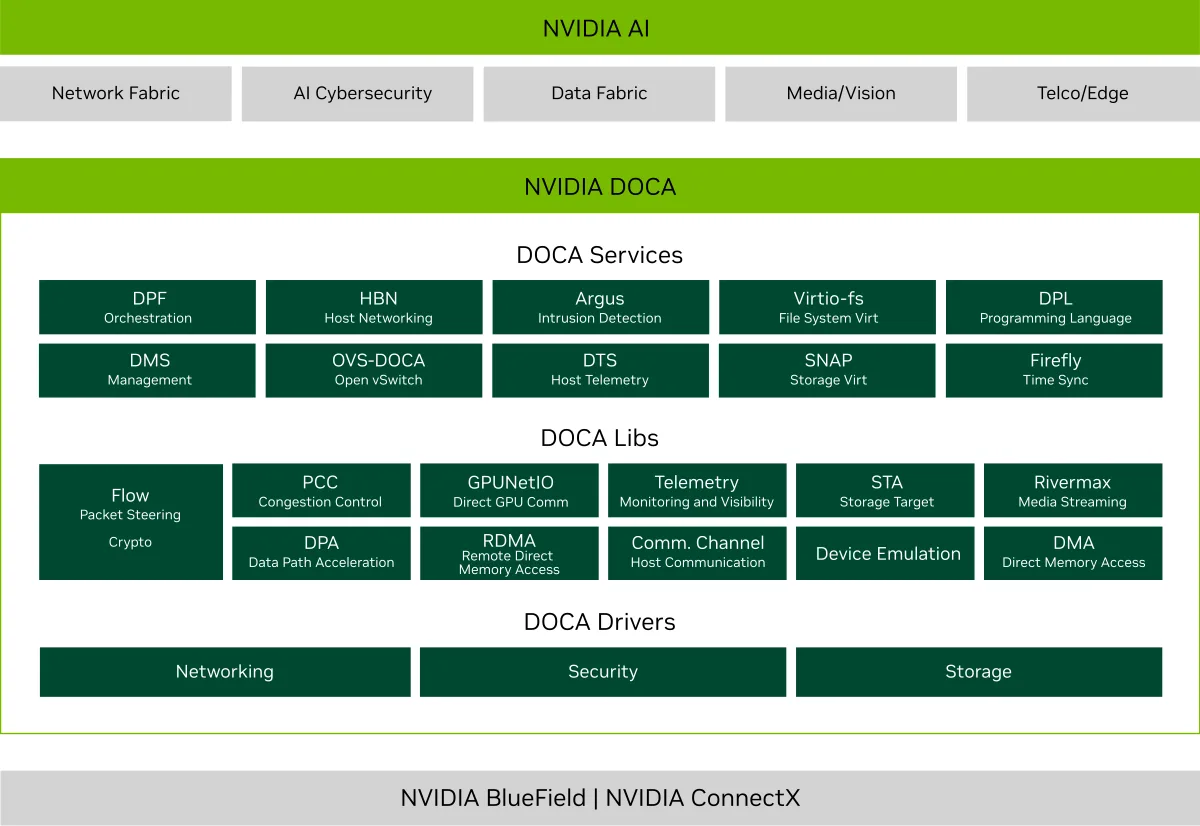
NVIDIA DOCA

Softwareframework voor BlueField en SuperNICs

DOCA is de SDK en runtime voor het bouwen van diensten die draaien op BlueField DPU's en SuperNICs.

Voor wie het geschikt is: Ontwikkelaars en platformteams die op BlueField bouwen

Voordelen

  • Eén framework voor alle DPU- en SuperNIC-generaties
  • Versnelt de ontwikkeling van offloaded diensten
  • Een runtime om die diensten in productie uit te rollen

Belangrijkste specificaties

TypeSDK and runtime framework
Draait opNVIDIA BlueField DPUs and SuperNICs

Wat Workstation doet: We helpen bij het inrichten van DOCA-omgevingen en rollen diensten uit op de BlueField-kaarten die we leveren.

Prijs op offerteOfferte aanvragen ↗
Bekijken op NVIDIA.com ↗

Specificaties zijn samengevat uit de door NVIDIA gepubliceerde informatie en kunnen per revisie verschillen. Waarden gemarkeerd als sparse gaan uit van sparsity. Bij elke offerte bevestigen we de exacte configuratie, prijs en levertijd.

Wat Workstation bij elke bestelling doet

Dezelfde vijf stappen, of u nu één GPU koopt of een hele rij racks

Dimensionering

We beginnen bij uw modellen, data, gebruikers en locatie, en dimensioneren vervolgens rekenkracht, geheugen, netwerk, stroom en koeling.

Levering

We kopen in via NVIDIA en zijn serverpartners, bevestigen levertijden en houden u op de hoogte tot aan de levering.

Bouw en burn-in

Systemen worden in onze Britse werkplaats geassembleerd, van een image voorzien en op volle belasting stressgetest voordat ze worden verzonden.

Installatie

Onze engineers leveren, monteren, bekabelen en stellen in bedrijf op locatie, en dragen over met documentatie.

Ondersteuning

Hetzelfde team behandelt softwareproblemen, upgrades, licentieverlengingen en garantieclaims.

Alle NVIDIA-categorieën

Trade-lidmaatschap

Trade-leden krijgen bij elke bestelling gratis technische ondersteuning en onbeperkt engineertijd — hulp bij configuratie, drivers, software en probleemoplossing, zolang u de apparatuur in bezit hebt.

Ontdek het Trade-lidmaatschap

Veelgestelde vragen

Waarom is alles op offerte geprijsd?

Prijzen en allocaties voor accelerated computing veranderen snel, en de meeste bestellingen hangen af van de exacte configuratie, locatie en software. Met een offerte kunnen we de actuele prijs, beschikbaarheid en levertijd bevestigen voor wat u echt nodig hebt.

Kunt u één GPU leveren in plaats van een volledig systeem?

Ja. We leveren losse datacenter-GPU's, maar controleren altijd of uw server gecertificeerd is om ze van stroom en koeling te voorzien, en we kunnen ze voor u plaatsen en testen.

Installeert u rack-scale en vloeistofgekoelde systemen?

Ja. Voor systemen zoals GB300 NVL72 werken we ruim vóór de levering samen met uw facilitaire team aan stroom, koeling en vloerbelasting, en installeren en stellen we op locatie in bedrijf.

Met welk NVIDIA-platform kunnen we het beste beginnen?

Dat hangt af van uw modellen, gebruikers en locatie. Veel teams beginnen met RTX PRO Server of L40S voor gemengde AI en graphics, en stappen over op HGX of DGX voor grootschalige training. Spreek met een engineer en wij adviseren een startpunt.

Plan uw NVIDIA accelerated computing-project

Vertel ons wat u moet draaien en waar het moet staan. Een engineer komt bij u terug met een aanbevolen configuratie en een offerte.

Spreek met een engineer