Dit is de diepe duik in lange vorm. Voor een snellere, vlot leesbare versie, zie de begeleidende blogpost.
1. Inleiding: waarom een Mac Studio voor lokale AI?
Lokale AI is niet langer de nieuwsgierigheid van een hobbyist. Nu de modellen met open gewichten van Meta, Mistral, Qwen en Microsoft snel volwassen worden, en het uniforme geheugen van Apple Silicon de drempel van 128 GB overschrijdt, kunt u nu capabele grote taalmodellen, inbeddingspijplijnen en volledige RAG-stacks uitvoeren op een enkele machine aan de bureauzijde - stil, en tegen een fractie van het energiebudget van een typisch GPU-werkstation.
Dit artikel beschrijft het uitpakken van een Mac Studio met de M4 Max-chip, de eerste keer opstarten, de echte metingen op het apparaat van mactop, en een praktisch pad van "de doos staat op mijn bureau" naar "Ik ben aan het chatten met Llama 3 die lokaal draait en vraag mijn eigen documenten op met RAG". Elke aanbeveling hier is gebaseerd op wat ik feitelijk op de machine heb waargenomen. Geen verzonnen benchmarkcijfers, geen marketingpluisjes - alleen de workflow.
Als u een ingenieur, een AI-bouwer, een SRE of een technisch leider bent die beslist of een Mac Studio thuishoort in de hardwaremix van uw team, dan is deze gids iets voor u.

2. De Mac Studio M4 Max uitpakken
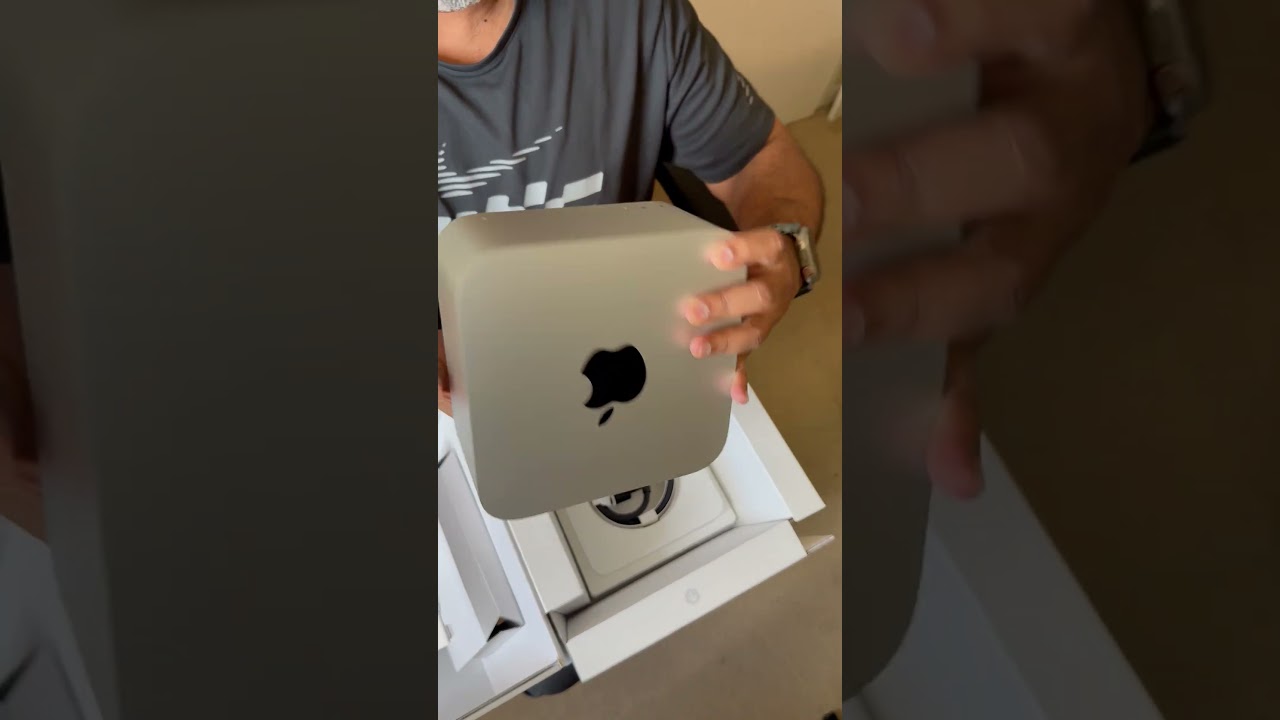
De uitpakervaring is klassiek Apple: minimaal karton, de machine in een gegoten uitsparing, een korte zwarte voedingskabel, en dat is alles. Geen opgeblazen accessoirebundel. De Mac Studio zelf is dezelfde compacte behuizing van geëxtrudeerd aluminium die werd geïntroduceerd bij de originele M1 Ultra: ongeveer 19,7 cm in het vierkant, compact in de hand, met de bekende lattenbodem aan de onderkant en een reeks poorten aan de achterkant.
Bekijk de unboxing-short op YouTube: https://youtube.com/shorts/HUlUoHNsyNM
Ik heb een korte clip gemaakt van het uitpakken - bekijk de YouTube Short hierboven. De reden dat een Short zo goed werkt voor dit formaat is dat de daadwerkelijke installatie echt snel is. Eerst plug-in, monitor wake-up, Apple ID inloggen, taal en regio, FileVault, en je staat binnen een paar minuten op een bruikbare desktop.
2.1 Eerste keer opstarten - echte metingen van mactop
Het eerste dat ik deed nadat het systeem de eerste synchronisatie had voltooid, was installeren mactop - een uitstekend open-source TUI-dashboard dat de interne tellers van Apple Silicon in realtime weergeeft. Hier is hoe dat dashboard met nieuwe installatie eruit zag na 37 minuten uptime:

/img/mac-studio-mactop-firstboot.png om het later in te wisselen.De cijfers in die schermafbeelding zijn de enige harde cijfers die ik in dit artikel zal noemen. Ze zijn de grondwaarheid voor mijn machine die inactief is en een nieuwe installatie heeft:
- Apple Silicon: M4 Max
- CPU: 16 kernen in totaal - 4 efficiëntiekernen + 12 prestatiekernen; E-cluster op 1,6 GHz, P-cluster op 0,2 GHz; pakket bij 37 C
- GPU: 40 kernen op 784 MHz, 30 C
- Neurale motor (ANE): 16-core, trekt 0,00 W bij inactiviteit
- Uniform geheugen: 128,00 GB totaal, 16,62 GB in gebruik (ongeveer 13%) bij inactiviteit
- Stroom: 6,48 W totaal - CPU 0,10 W, GPU 0,02 W, ANE 0 W, DRAM 0,36 W, Systeem 6,01 W. Het maximale waargenomen tijdens de sessie was 46,33 W. Thermische eigenschappen: nominaal.
- Opslag: 2,0 TB Mac HD, 1,9 TB vrij; 53.9 GB gebruikt door het besturingssysteem en de eerste installatie
- Netwerk: Wi-Fi 6, met een voorbeeldwaarde van 19,0 KB/s upload en 156,8 KB/s download tijdens achtergrondsynchronisatie
Twee dingen vallen op. Eerst, 6,48 W bij inactiviteit voor een desktop met 128 GB bruikbaar geheugen is opmerkelijk - dat is minder dan veel laptops verbruiken als het scherm uitgeschakeld is. Ten tweede zit de GPU op 784 MHz met 40 beschikbare cores; die pool is klaar om het echte werk te doen zodra je er een LLM voor zet.
3. Waarom de Mac Studio M4 Max geweldig is voor lokale AI
Om te begrijpen waarom deze hardware zo goed past bij lokale AI – en waarom ‘unified memory’ meer is dan een marketinglijn – helpt het om het rechtstreeks te vergelijken met het canonieke alternatief: een discrete GPU-kaart in een pc, die communiceert met systeem-RAM via PCIe.

3.1 Uniform geheugen in duidelijke taal
Op een traditionele PC AI-rig heb je twee geheugenpools. Systeem-RAM (meestal 64-256 GB van DDR5) bevat het besturingssysteem, de applicatie en het modelgewicht wanneer u ze vanaf schijf laadt. De GPU heeft zijn eigen VRAM - 24 GB op een RTX 4090, 32 GB op een 5090, 80 GB op een A100. Voordat de GPU een enkele matmul kan draaien, moet het model dat wel zijn gekopieerd van systeem-RAM naar VRAM via de PCIe-bus. Als het model groter is dan VRAM, laadt het helemaal niet, of wordt het tegen brute kosten door PCIe gepagineerd (vaak 10-100x langzamer dan volledig in VRAM draaien).
Apple Silicon voegt deze twee pools samen tot één. De CPU, de GPU, de Neural Engine en de media-engines zien allemaal de hetzelfde fysieke geheugen. Er is geen kopie. Er is geen PCIe-knelpunt. Een model met 40 GB op schijf is 40 GB in het uniforme geheugen en de GPU kan het direct lezen.
Voor lokale LLM's is dit de killer-functie. Een 70B-parametermodel gekwantificeerd op Q4_K_M is ongeveer 40 GB op schijf (openbaar geciteerd cijfer voor de gewichten van de Llama-klasse op dat kwantitatieve niveau - behandel als een benadering). Op een 24 GB consumenten GPU past dat model simpelweg niet. Op 128 GB verenigd geheugen wordt geladen met ongeveer 80 GB die nog steeds vrij zijn voor context, applicatiecode en tools.
3.2 Energie-efficiëntie die moeilijk te geloven is
De mactop-screenshot toont 6,48 W bij inactiviteit en een maximum van 46,33 W waargenomen tijdens de sessie. Om dat in perspectief te plaatsen: een enkele RTX 4090 draait inactief op 15-25 W met de rest van het systeem bovenaan, en trekt tot 450 W onder belasting. Een Mac Studio is een AI-box aan de bureauzijde die u 24/7 kunt laten draaien zonder dat u dit merkt op de elektriciteitsrekening. Het is stil. De ventilatoren draaien bijna nooit tijdens gevolgtrekkingswerklasten. Dit maakt het levensvatbaar als een altijd ingeschakelde ontwikkelaarsbox op een manier die een discrete GPU-pc zelden is.
3.3 Wat de Apple Neural Engine eigenlijk doet
De ANE is een 16-core versneller met een vaste functie die is geoptimaliseerd voor het soort tensorbewerkingen dat CoreML produceert. Voor de meeste LLM-workloads met open gewicht in 2026 (GGUF-formaat dat loopt via llama.cpp of Ollama), bevindt de ANE zich niet op het goede pad - de GPU wel, via Metal Performance Shaders. De ANE schittert voor CoreML-geconverteerde modellen, spraakherkenning op het apparaat, beeldsegmentatie en soortgelijke werklasten met een vaste vorm. Het is ook extreem energiezuinig als het werkt. Handig om te weten dat het er is; verwacht niet dat elke LLM-stack er gebruik van maakt.
4. De Mac Studio instellen voor AI-werk
Na de standaard macOS-onboarding is hier de exacte uitleg die ik volg voor een nieuwe Mac Studio die ik wil gebruiken als een lokale AI-ontwikkelaar.
4.1 Installeer Homebrew, Xcode CLT en de basis
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
Homebrew brengt de Unix-tooling, Xcode Command Line Tools levert de compilers en linkers, Python en Node geven je een runtime voor app-code, en iTerm2 + VS Code zijn het editor + terminalpaar dat ik standaard gebruik.
4.2 Installeer Ollama
Ollama is de gemakkelijkste manier om LLM's met open gewichten op macOS te downloaden, uit te voeren en te serveren. Onder de motorkap wikkelt het zich llama.cpp met Metal-versnelling en biedt een eenvoudige HTTP API op poort 11434.
brew install ollama

ollama serve &

ollama --version
Je kunt ook via de ambtenaar installeren .dmg van ollama.com, dat een menubalk-app instelt. Beide paden werken. Ik geef de voorkeur aan de brew-installatie voor headless-boxen en de dmg voor Macs met dagelijkse stuurprogramma's.
4.3 Installeer LM Studio (optioneel maar de moeite waard)
LM Studio is een desktop-UI voor browsen, downloaden en chatten met GGUF-modellen. Het onthult ook een OpenAI-compatibele API. Ik installeer het naast Ollama omdat de modelbrowser uitstekend is en de gebruikersinterface voor het afstemmen van prestaties per model vriendelijk is als je twijfelt tussen Q4_K_M en Q5_K_M.
4.4 Installeer Continue.dev in VS-code
Continue.dev biedt u hulp in ChatGPT-stijl binnen VS Code, maar gericht op uw lokale Ollama. Nadat u de extensie hebt geïnstalleerd, plaatst u deze in uw ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
Nu heb je inline chat, bewerken en automatisch aanvullen - allemaal modellen die op hetzelfde bureau staan als je redacteur. Nul gegevens verlaten de machine.
5. Voer uw eerste LLM uit

Tijd voor het moment van de waarheid. Trek een model en voer het uit.
5.1 Llama 3.1 8B trekken
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
De pull downloadt de Q4_K_M GGUF (Llama 3.1 8B bij Q4_K_M is ongeveer 4,7 GB op schijf - publiekelijk geciteerd cijfer, behandel als bij benadering). Op een Wi-Fi 6-verbinding zoals de mijne duurt het downloaden een paar minuten; op bekabelde gigabit is het sneller. Zodra het landt, de eerste ollama run omvat een eenmalige modellading in het verenigde geheugen – u zult een korte pauze opmerken voordat de eerste tokenstreams plaatsvinden – en daarna zijn de volgende runs snel.
Ik zal hier bewust geen tokens-per-seconde-nummers voor mijn eigen machine citeren, omdat ik geen gecontroleerde benchmarksuite met een gepaarde methodologie heb uitgevoerd. Wat ik wil zeggen is dat je op deze klasse hardware (M4 Max met 40 GPU-kernen) mag verwachten soepele, conversatiestreaming van een 8B-model op Q4_K_M, met een merkbare initiële belastingsvertraging en een stabiele output gedurende de hele respons. Als je elders beweringen als "Ik krijg 60 tokens per seconde op mijn Mac" hebt gelezen, behandel ze dan als richtlijn; uw werkelijke cijfers zullen variëren afhankelijk van de promptlengte, het contextvenster, het kwantiseringsniveau, de modelarchitectuur en wat er nog meer wordt uitgevoerd.
5.2 Een kwantisering kiezen - Q4_K_M, Q5_K_M, Q8_0
Kwantisering vermindert de precisie van de modelgewichten en verkleint ze op schijf en in het geheugen. De wisselwerking is kwaliteit. Hier is het ruwe mentale model dat ik gebruik bij het kiezen van een kwantitatieve waarde voor lokale gevolgtrekking:
| Kwantitatief | Geschatte maat voor 8B | Kwaliteit versus FP16 | Wanneer te gebruiken |
|---|---|---|---|
| Q4_K_M | ~4,7 GB | Zeer goed, kleine druppel | Standaard. Beste snelheid/kwaliteitsbalans voor chat en code. |
| Q5_K_M | ~5,7 GB | Dichter bij FP16 | Wanneer u iets meer nauwkeurigheid nodig heeft en geheugen over heeft. |
| Q8_0 | ~8,5 GB | Bijna verliesvrij | Wanneer u maximale kwaliteit en minimaal geluid nodig heeft op kleine modellen. |
Alle maten zijn geschatte, publiekelijk geciteerde cijfers voor Llama-klasse 8B-gewichten. Het gaat om de relatieve ordening.
5.3 Wat past in 32, 64 en 128 GB
| Uniform geheugen | Realistische comfortzone (Q4_K_M) | Rekken (met zorg) |
|---|---|---|
| 32 GB | 7B / 8B / 13B | 20-22B in een strakke context |
| 64 GB | 13B / 20B / 34B | 40-50B in een strakke context |
| 128GB | 34B / 70B / mix-van-experts-varianten | 100-120B in een strakke context |
"Comfortzone" betekent dat het model wordt geladen met voldoende ruimte voor een genereus contextvenster, een KV-cache en andere actieve applicaties. "Uitrekken" betekent dat het wordt geladen, maar je begint te jongleren met de contextlengte en andere werklasten. Op mijn 128 GB-box kan ik een 70B draaien op Q4_K_M en heb ik nog steeds ongeveer 80 GB aan speelruimte voor VS Code, Chrome en een paar Python-processen - wat eerlijk gezegd een luxueus gevoel is.
5.4 Ollama aanroepen vanuit Node en Python
Ollama stelt een HTTP API bloot op http://localhost:11434. Een kleine knooppuntophaalactie ziet er als volgt uit:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
En van Python:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
Dit is alles wat u nodig hebt om een lokale LLM aan te sluiten op een CLI-tool, een Slack-bot, een snelkoppeling, een microservice of een interne automatisering. Geen sleutels, geen tarieflimieten, geen quota.
6. Beste modellen om op Mac Studio te draaien
Het kiezen van een model is deels prestatie, deels licentie, deels sfeer. Dit is wat ik daadwerkelijk op de doos gebruik, gegroepeerd op grootteniveau.
6.1 Klein (minder dan 10B): snelle dagelijkse werkpaarden
- Llama 3.1 8B - uitstekende algemene chat en redenering; permissieve Meta-licentie met voorbehouden.
- Mistral 7B / Ministral 8B - sterke redenering, varianten met Apache-licentie beschikbaar.
- Qwen 2.5 7B - zeer sterke meertalige en codeprestaties.
- Phi-3,5 mini - klein, verrassend capabel, ideaal als u doorvoer en lage latentie nodig heeft.
- Codestral / Qwen 2.5 Coder 7B - snelle inline automatische aanvulling voor IDE-werk.
6.2 Midden (10B-40B): de goede plek op 64-128 GB
- Llama 3.1 / 3.3 70B (Q4_K_M) - als u 128 GB heeft, is dit het hoofdmodel; bijna grensverleggende kwaliteit, loopt comfortabel.
- Qwen 2.5 32B - uitstekende kwaliteit-maatverhouding; past goed bij RAG.
- DeepSeek-coder 33B - sterk in het genereren van code.
- Mixtraal 8x7B - mix van experts, activeert slechts 2 experts tegelijk, past comfortabel.
6.3 Groot (70B en hoger): alleen op 96-128 GB en alleen in Q4
Bij 128 GB staat de deur open voor modellen uit de 70B-klasse bij Q4_K_M. Dat zijn ze langzamer dan 8B-modellen, maar de kwaliteitssprong is aanzienlijk voor taken die profiteren van bredere wereldkennis en langer redeneren. Verwacht dat de latentie van de eerste token langer zal zijn en dat het streamingtempo zal dalen, maar de daadwerkelijke ervaring blijft bruikbaar voor veel workflows.
7. Het bouwen van een lokale RAG-pijplijn
Als u eenmaal een lokale LLM heeft, is het nuttigste dat u ermee kunt doen, deze naar uw eigen documenten te verwijzen. Dit is Retrieval-Augmented Generation, en het is de werklast waarin de Mac Studio echt uitblinkt als een privéalternatief voor cloud-API's.

7.1 De stapel
- Documentparser - PyMuPDF voor PDF's,
unstructuredvoor opname in gemengd formaat. - Chunker - LangChain's
RecursiveCharacterTextSplitterof een tokenbewuste splitter. Typische brokgrootte 512-1024 tokens met 64-128 tokens overlap. - Inbedding -
nomic-embed-textofmxbai-embed-large, beide beschikbaar via Ollama. Beide draaien op de lokale GPU. - Vectorwinkel - ChromaDB standaard. SQLite-VSS voor een zero-server-optie. LanceDB als u een ingesloten optie voor één bestand wilt die schaalbaar is.
- Generator - Llama 3.1 8B voor een snelle doorlooptijd, of 70B als u antwoorden van de hoogste kwaliteit wilt.
7.2 Minimaal Python-voorbeeld - van begin tot eind
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
Dat is een complete lokale RAG-pijplijn in minder dan 60 regels Python. Het geheel draait op de Mac Studio. Geen externe API-sleutels, geen facturering per token, geen gegevens die de machine verlaten. De eerste opname van een grote PDF-set duurt enkele minuten; daaropvolgende vragen zijn snel.
7.3 Stemnoten
- Grootte van het stuk - begin met 1000 tekens en 150 overlap; kom in de problemen als uw bronnen lange gestructureerde secties hebben (juridische, technische specificaties) en de retriever de antwoorden fragmenteert.
- Top-k - 4-8 is het praktische bereik. Veel hoger gaan verhoogt de snelheid en vertraagt de generatie zonder duidelijke winst.
- Herrangschikking - voor de hoogste kwaliteit haalt u de top 20 op en herrangschikt u met een cross-encoder (bijv.
bge-reranker). Op Mac Studio is dit goedkoop. - Metagegevens filteren - tag chunks met hun bronpad, datum en sectie; filter op het moment van de zoekopdracht vóór het zoeken naar vectoren. Dit is de grootste precisieoverwinning.
- Streamen - schakelaar
streamnaartruein de Ollama bel en stream tokens naar de client voor een pittige UX.
8. De dagelijkse ontwikkelaarsloop
Na een paar weken op de Mac Studio ziet mijn dagelijkse lus er als volgt uit:
- Open VS Code, Continue.dev wordt wakker tegen Ollama.
- Open een chat in Open WebUI (of LM Studio) voor langere conversatievragen en antwoorden op mijn aantekeningen.
- Voor codewerk: tab-autocomplete op een Codestral- of Qwen Coder-model, langere chats op Llama 3.1 8B, diepgaande redeneersessies op een 70B wanneer de taak dit rechtvaardigt.
- Voor interne RAG: een Python-script dat verwijst naar de documenten/map van het project en een Chroma-database.
- Voor het maken van prototypen van agenten, LangGraph of een kleine aangepaste lus die het Ollama-eindpunt aanroept: hetzelfde patroon, andere lijm.
Wat echt verandert als uw LLM lokaal is, is de manier waarop u hem gebruikt. Er zijn geen extra kosten verbonden aan een query, dus u stelt het model meer vragen. U hoeft zich geen zorgen te maken over de privacy, dus u plakt productielogboeken, interne documenten en e-mails van klanten. Je schrijft kleine CLI-scripts die 200 documenten doorlopen om er een gestructureerde samenvatting uit te halen, en je hoeft niet lang na te denken over de factuur per token, omdat er geen factuur is.
9. Benchmarks en eerlijke vergelijking versus cloud
Laat ik heel direct zijn: ik ga geen tokens per seconde-cijfers publiceren die ik niet heb geproduceerd met een strak gecontroleerde benchmarkmethodologie. Het internet wordt overspoeld met zulke cijfers, waarbij vaak verschillende kwantiseringsniveaus, contextlengtes en promptformaten worden vergeleken, en ze verwarren meer dan dat ze verhelderen. Wat ik in plaats daarvan zal doen, is een beslissingsmatrix publiceren die vastlegt bij wat voor soort werklast Mac Studio daadwerkelijk wint, waar dat niet het geval is, en waar het juiste antwoord "beide gebruiken" is.

9.1 Break-even wiskunde
Een Mac Studio M4 Max met 128 GB unified geheugen en een 2 TB SSD komt in ongeveer dezelfde prijsklasse terecht als een paar maanden van een altijd ingeschakelde cloud GPU-instantie. Behandel alle specifieke dollarcijfers als benaderend en als een functie van regio en verdiscontering:
- Eén Mac Studio M4 Max, goed geconfigureerd: ongeveer $4.000-$6.000 eenmalig (bij benadering; configuraties variëren).
- Eén AWS
g5.xlarge(enkele A10G, 24 GB VRAM) 24x7 on-demand draaiend: in de orde van $700-$900 per maand (afhankelijk van de regio). - Eén AWS
p4d.24xlarge(8x A100): bestelling van $20.000-$30.000 per maand op aanvraag als je het op de een of andere manier aan hebt laten staan (dat zou je niet doen, maar het maakt het contrast duidelijk).
De rekenkunde zegt dat de Mac Studio voor een 'always-on' ontwikkelbox zichzelf binnen een paar maanden terugbetaalt vergeleken met een vergelijkbare 'altijd aan' cloud-instantie, en zichzelf jarenlang terugbetaalt in termen van elektriciteit. Voor burst-trainingsopdrachten draait de wiskunde om: huur een uur, doe een run en geef het terug. Gebruik het juiste gereedschap voor de klus.
9.2 Wanneer de cloud het juiste antwoord is
- U moet een model trainen of verfijnen dat groter is dan in de 128 GB past.
- U moet op schaal een wereldwijde gebruikersbasis bedienen met strikte SLO's en elastische capaciteit.
- U voert een experiment uit dat profiteert van 8x A100- of H100-parallellisme.
- De nalevingshouding van uw organisatie zegt dat de gevolgtrekking moet worden uitgevoerd in een specifieke cloudregio met specifieke audittrails.
9.3 Wanneer de Mac Studio het juiste antwoord is
- U wilt een privé-inferentiebox die altijd actief is voor uw team.
- U bouwt RAG-, agenten- of IDE-copiloten waarbij gegevenslocatie en privacy van belang zijn.
- U wilt een stille, energiezuinige ontwikkelbox waarvoor geen serverruimte nodig is.
- U maakt snel prototypes en de facturering per token van een cloud API staat u in de weg.
- Je wilt de stapel leren kennen: bezit een model, bezit een runtime, bezit een vectoropslag, bezit de lus.
10. Uitdagingen en beperkingen
Ik zou dit artikel geen plezier doen als ik de ruwe kantjes niet zou benoemen. Apple Silicon is uitstekend geschikt voor lokale AI, maar er zijn echte kanttekeningen.
10.1 Opleiding is nog steeds een zwakker verhaal dan gevolgtrekking
Het Apple Silicon AI-verhaal is veel sterker gevolgtrekking dan voor opleiding. De MPS-backend van PyTorch is aanzienlijk volwassener geworden, en Apple's eigen MLX-framework is echt goed, maar de reikwijdte van alleen CUDA-trainingstools is nog steeds groter. Als je dagelijkse werk bestaat uit nieuwe modelarchitecturen of grootschalige verfijning, zul je gaten tegenkomen die je eenvoudigweg niet tegenkomt op Linux + NVIDIA.
10.2 Het ecosysteem gaat op veel plaatsen uit van CUDA
Veel AI-repo's zijn nog steeds standaard gebaseerd op CUDA-aannames. De meeste onderhouden projecten hebben nu Metal/MPS-paden, maar verwachten af en toe wrijving: een bibliotheek die vanaf de bron moet worden gebouwd, een kernel die geen Metal-equivalent heeft, een benchmarksuite die alleen op NVIDIA draait. Plan hiervoor tijd in.
10.3 Uitschalen is doe-het-zelf
Eén Mac Studio is één enkele doos. Gereedschappen zoals EXO en bij anderen kun je Macs clusteren om zeer grote modellen op meerdere apparaten te laten draaien, maar dit is niet het gepolijste verhaal dat je krijgt met een Kubernetes-cluster van g5's. Als uw werklast horizontale elasticiteit nodig heeft, is de cloud nog steeds beter.
10.4 Repareerbaarheid en upgrades
U kunt later geen RAM toevoegen. Je kunt de SSD later (praktisch gesproken) niet meer verwisselen. Koop wat je nodig hebt, en dan plus één - vooral op geheugen. De 128 GB-laag is degene die ik zou aanbevelen voor serieus AI-werk; 64 GB is de vloer.
10.5 Thermiek onder langdurige belasting
De Mac Studio werkt koel en stil bij inactiviteit (de schermafbeelding hierboven toont 37 C en 30 C terwijl de ventilatoren onhoorbaar zijn). Bij aanhoudende zware LLM-belasting draaien de ventilatoren - niet luid, maar hoorbaar - en wordt de chip warm. Dit ligt ruim binnen de nominale thermische grenzen; Houd er rekening mee dat 'stil' een nutteloze en lichte karakterisering is, en geen absolute.
11. De toekomst van lokale AI op Apple Silicon
Er komen drie trends samen die de komende 12-24 maanden spannend maken voor lokale AI op Apple Silicon.
Eerst, Modellen met open gewicht worden steeds kleiner zonder verlies van capaciteit. Phi-3.5, Qwen 2.5 small en de Llama 3.x-familie met 8B liggen boven hun gewichtsklasse. Een 2026 8B-model is in veel taken qua kwaliteit ongeveer vergelijkbaar met een 2023 70B. Dat betekent dat meer werklasten comfortabel passen in 32-64 GB uniform geheugen, en een 128 GB Mac Studio wordt een serveerdoos met meerdere modellen.
Seconde, Apple's eigen MLX-framework blijft verbeteren. MLX biedt standaard een NumPy-achtige API, luie evaluatie, standaard uniform geheugenbewustzijn en dynamische berekeningsgrafieken. De MLX-gemeenschap heeft modellen, tokenizers en trainingsloops in een snel tempo geporteerd. Als je vandaag een nieuw ML-project op een Mac start, is MLX de logische keuze; als u PyTorch gebruikt, is de MPS-backend elke release beter bruikbaar.
Derde, kwantisering en KV-cache-compressie worden steeds beter. Technieken als Q4_K_M, IQ-familie-quants en GGUF-verbeteringen zorgen ervoor dat hetzelfde model in minder geheugen past dan zes maanden geleden, met minder kwaliteitsverlies. Lokale AI bevindt zich op een curve waarbij elke generatie model- en kwantitatieve koppelingen het praktische bereik van consumentengeprijsde hardware vergroot.
Voeg daarbij de geruchtenmolen rond toekomstige chips uit de M-serie (M5, toekomstige Ultras, Studio-vernieuwingen), en het traject is duidelijk: de AI-box aan de bureauzijde is er, en hij wordt steeds beter.
12. De Mac Studio versterken als team-AI-box
Als u uw Mac Studio met een klein team wilt delen (bijvoorbeeld Ollama, een Open WebUI-instantie en een RAG-eindpunt aan een handvol collega's blootstellen), volgt hier de ruwe verharding die ik doe:
- FileVault ingeschakeld en een sterk inlogwachtwoord. Bewaar het op een UPS.
- Staartschaal op de doos, zodat deze bereikbaar is vanaf de apparaten van uw team zonder deze bloot te stellen aan het openbare internet.
- Bind Ollama aan localhost en daarvoor een dunne auth-proxy (Caddy, Traefik of een kleine Node/Python-server) die de authenticatie en snelheidsbeperking afhandelt voordat deze wordt doorgestuurd naar
11434. - Voer Open WebUI uit in Docker Desktop met een aanhoudend volume; wijs het naar het lokale Ollama-eindpunt.
- Back-ups voor de RAG-database naar een gecodeerde externe SSD of een Time Machine-doel.
- Automatische update macOS- en Homebrew-pakketten volgens schema; Ollama en modelversies opzettelijk vastzetten in plaats van de nieuwste versie automatisch op te halen.
Als u het goed doet, beschikt u over een eigen, auditvriendelijk AI-eindpunt dat uw team elke dag gebruikt en dat nooit een token naar het netwerk van het gebouw verzendt.
13. Conclusie: een stille revolutie op het bureau
Het uitpakken van een Mac Studio M4 Max in 2026 voelt minder als het kopen van een desktop en meer als het kopen van een klein AI-apparaat dat toevallig ook een Mac is. 128 GB verenigd geheugen, 40 GPU-cores, 16 CPU-cores, een Neural Engine, hardware media-encoders, een SSD van 2 TB en een inactief stroomverbruik gemeten in enkele watt - alles in een doos die u met één hand kunt oppakken.
De installatie is snel, de eerste LLM draait binnen een uur en binnen een middag heb je een eigen RAG-pijplijn die vragen over je eigen documenten beantwoordt. Het hele gebeuren gebeurt op uw bureau, zonder dat er een cloudrekening op de achtergrond verschijnt. Dat verandert de manier waarop je met AI bouwt op een manier die moeilijk over te brengen is totdat je het probeert.
Als je evalueert of een Mac Studio thuishoort in de hardwaremix van je team, hoop ik dat dit artikel je een goed beeld heeft gegeven: wat is verbazingwekkend, wat is ruig, waar de cloud nog steeds wint en waar de doos op je bureau het betere antwoord is. De metgezel korte blog distilleert dezelfde workflow in een leesperiode van 5 minuten om te delen.
Als dit nuttig was - bekijk de unboxing op YouTube (https://youtube.com/shorts/HUlUoHNsyNM), abonneer je op het kanaal voor vervolgtutorials (MLX-verfijning, multi-Mac-inferentie, agentstacks) en kom hier terug voor het volgende artikel in de serie. Lokale AI op Apple Silicon is nog maar net begonnen, en ik zal blijven schrijven naarmate de stapel volwassener wordt.
SEO-momentopname voor dit artikel
- SEO-titel: Mac Studio uitpakken M4: voer uw eerste LLM lokaal uit
- Metabeschrijving: Pak een Mac Studio M4 Max uit met 128 GB verenigd geheugen, installeer Ollama, voer Llama 3 lokaal uit en bouw een privé RAG-pijplijn. Echte metingen, eerlijke vergelijkingen.
- Primaire trefwoorden: Mac Studio AI, Mac Studio LLM, LLMs uitvoeren op Mac Studio, Ollama Mac Studio, Apple Silicon AI, lokale AI-installatie, Mac Studio RAG, lokale LLM-tutorial, Llama lokaal uitvoeren, Mac Studio M4-beoordeling.
- Twitter / X (minder dan 280 tekens): Een Mac Studio M4 Max uit de doos gehaald. 128 GB verenigd geheugen. Inactief op 6,48 W. Llama 3.1 8B opgehaald via Ollama, in een middag een lokale RAG-pijplijn gebouwd, geen cloudrekening. Volledige walkthrough van 4000 woorden + 6 diagrammen + de YouTube Short. #AppleSilicon #LocalLLM
- LinkedIn-bericht: De nieuwe Mac Studio M4 Max belandde op mijn bureau en ik behandelde hem als een AI-apparaat: echte metingen van mactop (6,48 W inactief, 128 GB UMA, 40 GPU cores), Ollama-installatie, Llama 3.1 8B lokaal draaiend, een volledige RAG-pijplijn tegen mijn eigen documenten - alles in één middag. Ik heb de hele workflow geschreven, met zes originele diagrammen, een eerlijke cloud-versus-lokale beslissingsmatrix en een sectie over waar de cloud nog steeds wint. Als u lokale AI voor uw team evalueert, is dit een goed beginpunt.