डीप लर्निंग (DL) मल्टी-लेयर न्यूरल नेटवर्क के साथ रिप्रेजेंटेशन लर्निंग है: पैरामीटर θ को अनुकूलित किया जाता है ताकि नॉनलाइनियर ट्रांसफॉर्म की संरचना उच्च-आयामी इनपुट (पिक्सेल, टोकन, वेवफॉर्म) को टास्क आउटपुट (लेबल, बॉक्स, एम्बेडिंग, या सैंपल किए गए अनुक्रम) में मैप करे। यह Workstation तकनीकी ब्रीफ Kubernetes, SageMaker और Bedrock पर सिस्टम शिप करने वाले इंजीनियरों और AI एजेंट्स के लिए AWS के वैचारिक अवलोकन को पुनर्लेखित करता है।
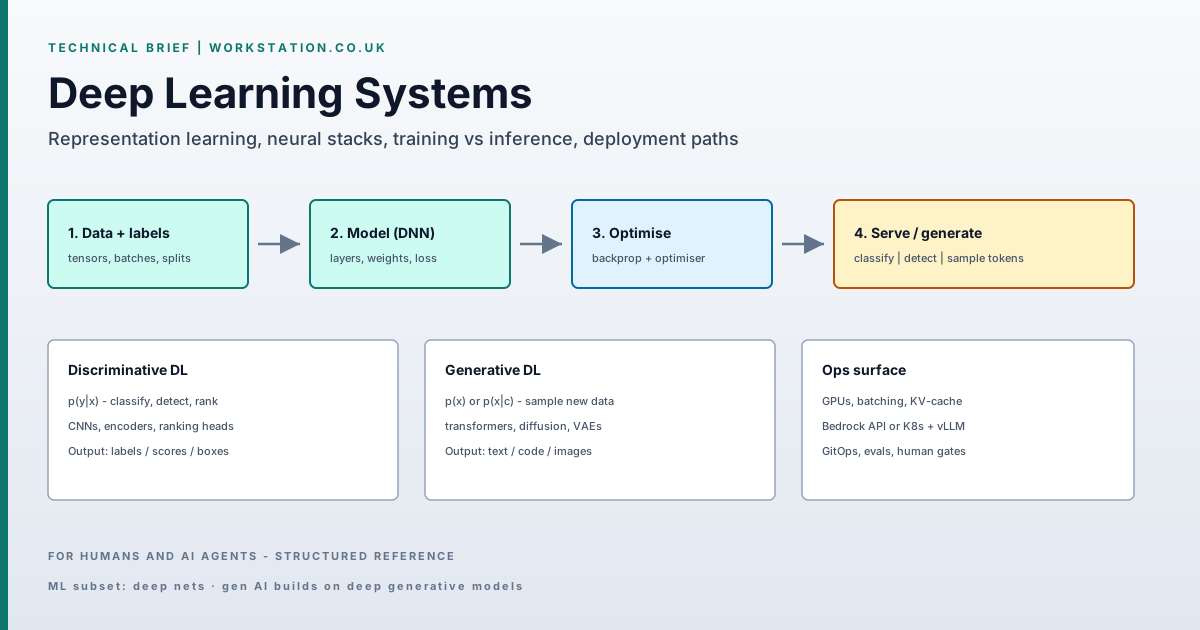
- परिभाषा: DL ⊂ ML; मल्टी-लेयर ANN मुख्यतः डिफरेंशिएबल लॉस पर ग्रेडिएंट डिसेंट से प्रशिक्षित।
- विभाजन: डिस्क्रिमिनेटिव p(y|x) बनाम जेनेरेटिव p(x) या p(x|c)।
- Gen AI: आमतौर पर बड़े transformers (या डिफ्यूजन) + सर्विंग + नीति; DL से अलग विज्ञान नहीं।
- कठोर बाधाएँ: लेबल/क्लीन डेटा वॉल्यूम, एक्सेलेरेटर FLOPs/VRAM, ड्रिफ्ट/ops।
- रूट: टेबुलर → क्लासिक ML; पर्सेप्शन → ट्रेन/सर्व DL; भाषा एजेंट → foundation model API या ओपन-वेट इनफेरेंस।
प्राथमिक स्रोत: AWS — What is Deep Learning?। स्पेक्स और सर्विस नाम बदलते हैं; प्रोविजनिंग से पहले वर्तमान AWS डॉक्स सत्यापित करें।
1. औपचारिक परिभाषा
डीप मॉडल L लेयरों से बनी पैरामीट्रिक फंक्शन f_θ है। लेयर ℓ गणना करती है h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)) नॉनलाइनियरिटी σ (ReLU, GELU, SiLU, आदि) के लिए। प्रशिक्षण अनुभवजन्य जोखिम न्यूनतम करने हेतु θ = {W, b, …} खोजता है:
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
हाथ से डिज़ाइन किए फीचर्स पर निर्भर शैलो पाइपलाइनों के विपरीत, डीप नेट कच्चे या हल्के प्रीप्रोसेस्ड टेंसर से पदानुक्रमित फीचर सीखते हैं। इसलिए DL दृष्टि, स्पीच और बड़े पैमाने के NLP पर हावी है: फीचर स्पेस मैनुअल इंजीनियरिंग के लिए बहुत उच्च-आयामी है।
2. डिस्क्रिमिनेटिव बनाम जेनेरेटिव डीप लर्निंग
डिस्क्रिमिनेटिव मॉडल p(y|x) या निर्णय सीमा अनुमानित करते हैं — क्लासिफायर, डिटेक्टर, रैंकर, एम्बेडर। जेनेरेटिव (deep generative) मॉडल p(x) या p(x|c) अनुमानित करते हैं और नए इंस्टेंस सैंपल कर सकते हैं: next-token LLMs, डिफ्यूजन इमेज मॉडल, VAEs, GANs।
प्रोडक्ट एजेंट्स में इस्तेमाल foundation models बड़े पैमाने पर प्रशिक्षित डीप जेनेरेटिव सिस्टम हैं, फिर अलाइन और सर्व किए जाते हैं। Bedrock Converse या सेल्फ-होस्टेड vLLM एंडपॉइंट कॉल करना ऐसे मॉडल पर इनफेरेंस है — नीचे अभी भी डीप लर्निंग।
3. प्रोडक्शन सिस्टम क्यों इस पर निर्भर हैं
डिप्लॉयड सतहें जो पहले से DL (या DL-backed foundation models) एम्बेड करती हैं:
- संवादी एजेंट और कोड सिंथेसिस
- ASR / TTS और वॉइस UI
- अनुक्रमों पर फ्रॉड / एनॉमली स्कोरिंग
- पर्सेप्शन स्टैक (ADAS, औद्योगिक CV, मेडिकल इमेजिंग)
- डीप टावर के साथ पर्सनलाइज़ेशन और सर्च रैंकिंग
यदि रोडमैप आइटम «AI फीचर» है, तो कार्यान्वयन लगभग हमेशा डीप मॉडल, foundation-model API, या उसके ऊपर हाइब्रिड (RAG + टूल्स) होता है।
4. टास्क टैक्सोनॉमी (इम्प्लीमेंटेशन मैप)
4.1 कंप्यूटर विज़न
CNNs / ViTs इमेज टेंसर को क्लास, बॉक्स, मास्क या एम्बेडिंग में मैप करते हैं। प्रोडक्शन पैटर्न: कंटेंट मॉडरेशन, एट्रिब्यूट रिकग्निशन, लोगो/PPE डिटेक्शन, इनलाइन डिफेक्ट इंस्पेक्शन। मेट्रिक्स: mAP, IoU, टारगेट GPU पर batch size 1 पर लेटेंसी।
4.2 स्पीच
एकॉस्टिक मॉडल + लैंग्वेज मॉडल (या एंड-टू-एंड ASR) उच्चारण, SNR और बोलने की गति भिन्नता सहन करते हैं। वर्कलोड: कॉन्टैक्ट-सेंटर असिस्ट, क्लिनिकल डिक्टेशन, कैप्शनिंग। मेट्रिक्स: WER, रियल-टाइम फैक्टर (RTF)।
4.3 NLP
एन्कोडर क्लासिफायर से decoder-only LLMs तक। वर्कलोड: intent/slot, सारांश, डॉक्यूमेंट QA, सेंटिमेंट इंडेक्सिंग। LLMs ओपन-एंडेड टेक्स्ट पर हावी; छोटे एन्कोडर अभी भी लेटेंसी-बाउंड classify/extract पर जीतते हैं।
4.4 रिकमेंडर्स
user–item इंटरैक्शन अनुक्रमों पर two-tower / DeepFM / transformer रैंकर। आउटपुट: विविधता और बिजनेस बाधाओं वाली रैंक्ड सूचियाँ। Offline: NDCG/recall; online: CTR/CVR एक्सप्लोरेशन नियंत्रणों के साथ।
4.5 जेनेरेटिव अनुप्रयोग
सैंपलिंग + टूल उपयोग: निजी कॉर्पोरा पर RAG, कोड असिस्ट, डॉक्यूमेंट ड्राफ्टिंग, मल्टी-एजेंट वर्कफ़्लो। AWS पर: Bedrock FMs या SageMaker-होस्टेड वेइट्स। Workstation एस्टेट पर: रेसिडेंसी या यूनिट इकोनॉमिक्स आवश्यक होने पर GitOps के तहत Kubernetes GPU पूल (vLLM/Ollama)।
5. आर्किटेक्चर: लेयर और फॉरवर्ड पास
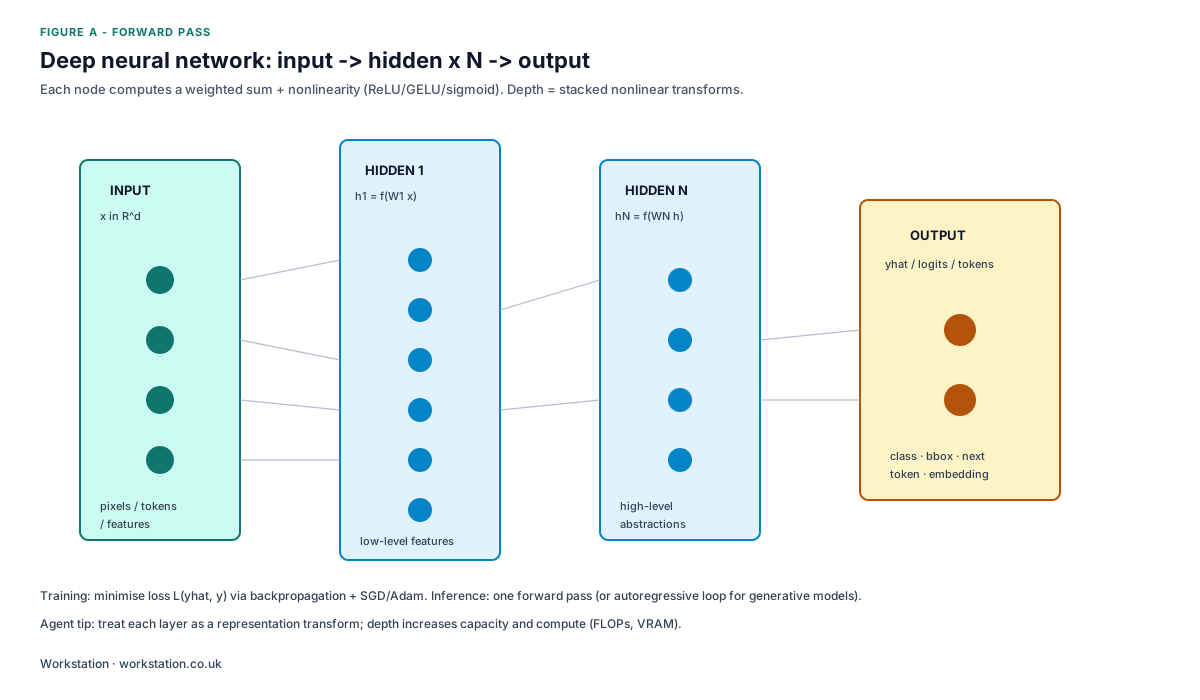
- इनपुट लेयर — टेंसर इंटरफ़ेस: नॉर्मलाइज़्ड पिक्सेल, टोकन ID, log-mel फ्रेम, या टेबुलर वेक्टर।
- हिडन लेयर — क्रमिक रिप्रेजेंटेशन ट्रांसफॉर्म। शुरुआती लेयर स्थानीय संरचना (एज, n-grams) कैप्चर करती हैं; गहरी लेयर टास्क सिमेंटिक्स। गहराई अभिव्यक्ति क्षमता और कंप्यूट बढ़ाती है (FLOPs, एक्टिवेशन मेमोरी)।
- आउटपुट लेयर — टास्क हेड: softmax logits, bounding-box रिग्रेशन, CTC, या ऑटोरेग्रेसिव डिकoding के लिए vocab प्रोजेक्शन।
ट्रेनिंग = कई फॉरवर्ड + बैकवर्ड पास। इनफेरेंस = केवल फॉरवर्ड (plus KV-cache / speculative decoding for LLMs)।
6. ML बनाम DL बनाम जेनेरेटिव AI
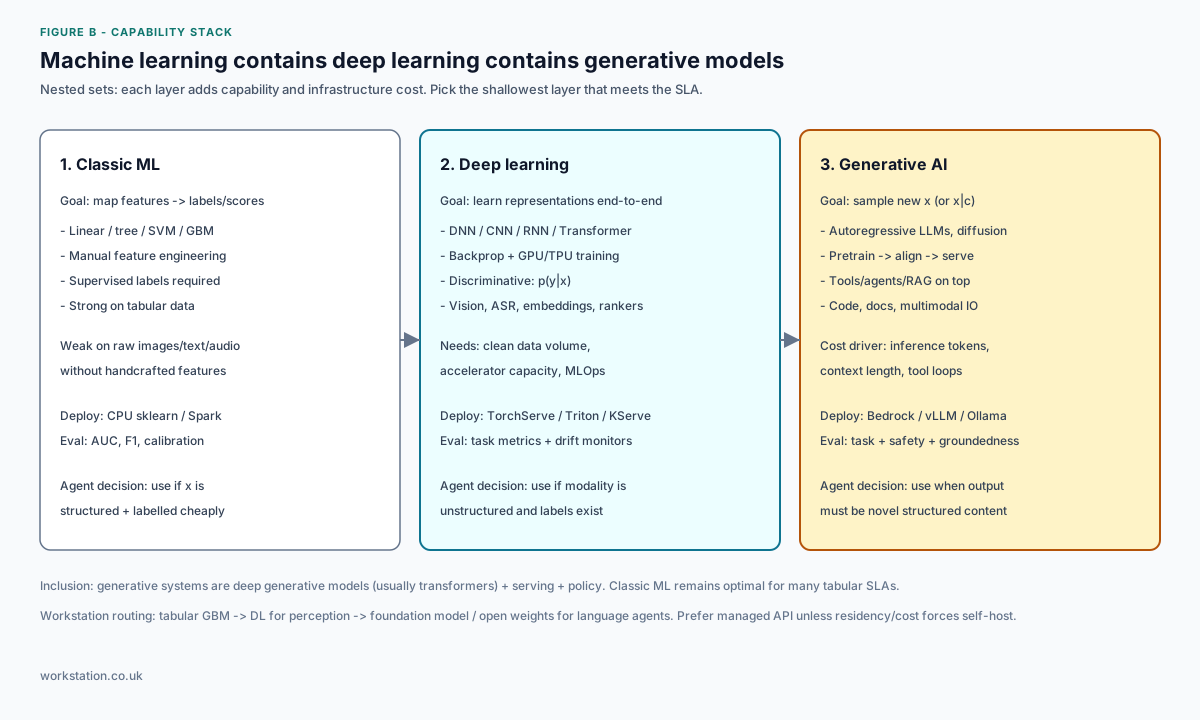
| लेयर | उद्देश्य | विशिष्ट स्टैक |
|---|---|---|
| क्लासिक ML | engineered φ के साथ p(y|φ(x)) | वेयरहाउस टेबल पर GBM / लीनियर |
| डीप लर्निंग | कच्चे मोडैलिटी पर end-to-end f_θ(x) | GPU नोड्स पर PyTorch + Triton/KServe |
| जेनेरेटिव AI | x या x|c सैंपल; ऊपर एजेंट/टूल्स | Bedrock Converse या vLLM + RAG |
6.1 शैलो ML पर DL के लाभ (जब लागू हों)
- असंरचित मोडैलिटी — साझा एम्बेडिंग पैराफ्रेज़ भिन्नता को संकुचित करती हैं («भुगतान» बनाम «पैसे ट्रांसफर»)।
- फीचर खोज — ग्रेडिएंट मैनुअल फीचर सूचियों के बिना उपयोगी इंटरनल तराशते हैं।
- ट्रांसफर / फाइन-ट्यून — प्रीट्रेंड बैकबोन पुन: उपयोग; स्क्रैच से ट्रेनिंग की तुलना में लेबल डेटा कम।
- अनुक्रम / सेट मॉडलिंग — transformers लंबी-दूरी निर्भरता संभालते हैं जो bag-of-features चूक जाती है।
मजबूत फीचर्स वाले घने टेबुलर डेटा पर अच्छी तरह ट्यून किए GBM को DL स्वचालित रूप से नहीं हराता। फैशन से नहीं, मोडैलिटी और डेटा रेजीम से चुनें।
7. विफलता मोड और बाधाएँ
- डेटा गुणवत्ता — लेबल शोर और डिस्ट्रीब्यूशन शिफ्ट एरर बजट पर हावी। डेटासेट वर्जन करें; ट्रेनिंग सेट में आने से पहले आउटलायर क्वारंटीन करें।
- कंप्यूट — ट्रेनिंग और लार्ज-बैच इनफेरेंस एक्सेलेरेटर-बाउंड। छोटे GPU बहु-दिवसीय लूप देते हैं और इटेरेशन स्पीड मार देते हैं।
- Ops — eval गेट, ड्रिफ्ट मॉनिटर, कॉस्ट टेलीमेट्री और रोलबैक (GitOps) के बिना, आर्किटेक्चर डायग्राम चाहे जो हों, मॉडल प्रोडक्शन में सड़ते हैं।
8. क्लाउड एक्सेलेरेशन बनाम सेल्फ-होस्ट
क्लाउड प्रयोग चक्र छोटा करता है: इलास्टिक GPU/CPU पूल, प्रबंधित नोटबुक/पाइपलाइन, और API के रूप में foundation models। AWS बिल्डिंग ब्लॉक्स:
- Amazon SageMaker — कस्टम DL आर्टिफैक्ट ट्रेन, ट्यून, होस्ट।
- Amazon Bedrock — IAM, Guardrails और वैकल्पिक ZDR के साथ foundation models इनवोक।
जब ओपन वेइट्स, डेटा रेसिडेंसी या टोकन इकोनॉमिक्स स्वामित्व वाले GPU का पक्ष लें तो Kubernetes पर सेल्फ-होस्ट करें। पैटर्न: model registry + KServe/vLLM + Argo CD सिंक।
9. निष्पादन चेकलिस्ट
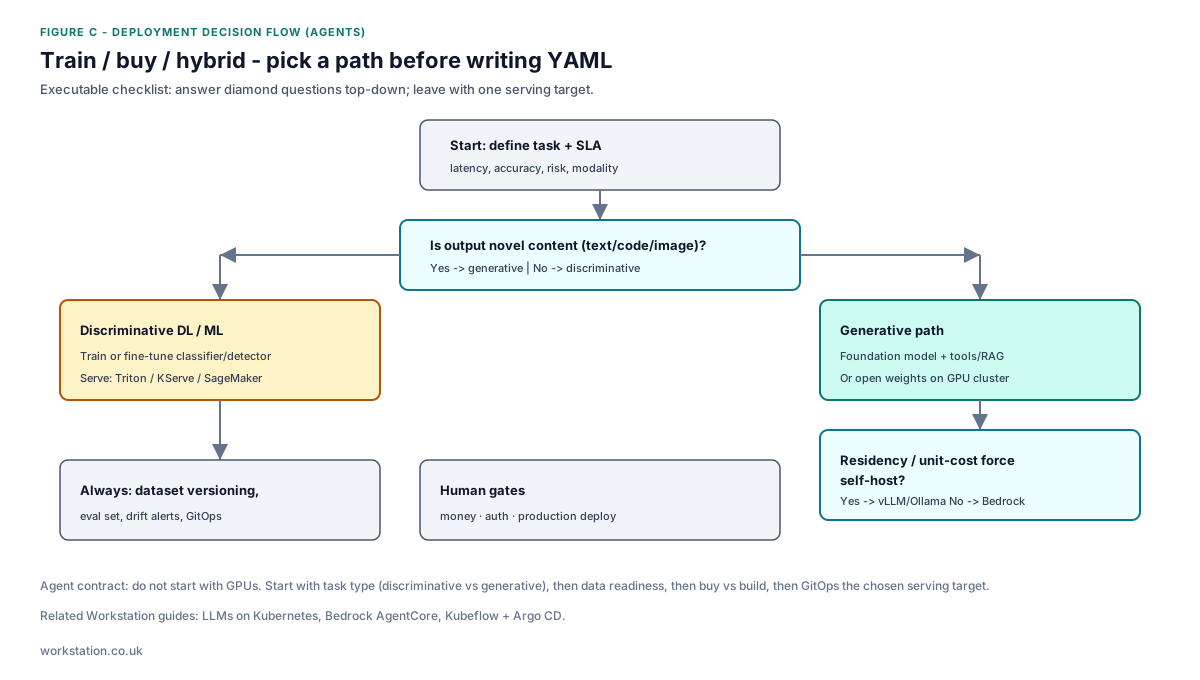
- टास्क को मापने योग्य उद्देश्य के रूप में लिखें (मेट्रिक + लेटेंसी + जोखिम वर्ग)।
- चित्र B से स्टैक लेयर चुनें; टेबुलर स्कोरकार्ड के लिए gen AI पर न कूदें।
- डेटा प्रेप + इनफेरेंस OpEx बजट करें; ट्रेनिंग अक्सर लाइफटाइम लागत का अल्पांश है।
- व्यापक रोलआउट से पहले eval हार्नेस लागू करें; ड्रिफ्ट अलर्ट वायर करें।
- अगले पढ़ें: LLM सर्विंग या Bedrock एजेंट्स।
Workstation द्वारा प्रकाशित — ऑटोमेशन प्लेटफ़ॉर्म, मल्टी-एजेंट सॉफ़्टवेयर, Kubernetes डिलीवरी।


