शॉप चालू है

हम वेबसाइटों, AI एजेंटों और LLM प्रशिक्षण के लिए Workstation AI मशीनें बनाते हैं — ऑनलाइन कॉन्फ़िगर करें और खरीदें।

ट्रेड कीमतें पाएँ
AI उत्पाद
एआई लैब्सOpenAI एजेंटClaude एजेंट्सGrok BotWorkstation AI नेटिव CRMमार्केटिंगसभी उत्पाद
AI समाधान
एप्लाइड AIAI एजेंटजनरेटिव AIAI स्वचालनAI कौशल विकासSME के लिए AI पैकेजएंटरप्राइज़ AI लैबAI वर्कस्टेशनNVIDIA हार्डवेयर और सॉफ़्टवेयरNVIDIA एक्सेलरेटेड कंप्यूटिंगप्राइवेट AIGPU क्लस्टरएज AIउद्योग के अनुसार AI
AI सेवाएँ
प्लेटफ़ॉर्म आधुनिकीकरणडिजिटल इंजीनियरिंगडेटा आधार और AIस्वायत्त संचालनएआई परामर्शDevOps स्वचालनसाइबर सुरक्षासॉफ़्टवेयर विकासएजेंट निर्माणMLOps सेटअपGPU लीज़िंग
हमारे बारे में
कंपनीहमारी कहानीसाझेदारग्राहक कहानियाँ
AI डेटा सेंटर
AI जानकारियाँJev शृंखलाबेंचमार्क लैबमॉडल चयन
तकनीकी नोट्स
दस्तावेज़ीकरण
Linux OSUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
AI क्लाउड प्लेटफ़ॉर्मAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU क्लाउड और मार्केटप्लेस
निजी AI डेटा सेंटरलॉ फर्मों के लिएअकाउंटिंग फर्मों के लिएऑन-प्रिमाइसेस प्लेटफ़ॉर्मपूरी तरह सुरक्षित क्लाउड
उपकरणRing PromoterJobshout
समाचार
ब्लॉग
संपर्क करेंसाइन इन करें

आधुनिक व्यवसायों के लिए AI वर्कस्टेशन, AI मल्टी-एजेंटिक सॉफ़्टवेयर, GPU अवसंरचना और बुद्धिमान एजेंट समाधान।

संपर्क करें

AI समाधान

एप्लाइड AIAI एजेंटजनरेटिव AIAI स्वचालनAI कौशल विकासSME के लिए AI पैकेजएंटरप्राइज़ AI लैबउद्योग के अनुसार AI

उत्पाद

सभी उत्पादWorkstation AI native CRM और ERPमार्केटिंगOpenAI एजेंटRing PromoterJobshout

कंपनी

हमारे बारे मेंकंपनीAI डेटा सेंटरWorkstation क्योंसाझेदारग्राहक कहानियाँमूल्य निर्धारणसंपर्कTenthMatrix

संसाधन

AI जानकारियाँतकनीकी नोट्सदस्तावेज़ीकरणLinux OSAI क्लाउड प्लेटफ़ॉर्मनिजी AI डेटा सेंटरब्लॉगखोजेंसाइटमैप
यूके कार्यालय
77-79 Marlowes, Hemel Hempstead HP1 1LFदिशा-निर्देश - M25 आउटर लंदन से जंक्शन 20 लेंकंपनी संख्या: 11641870सोम - शुक्र: सुबह 9:00 - शाम 6:00 GMT
+44 7515 356 146
बेल्जियम कार्यालय
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683सोम - शुक्र: सुबह 9:00 - शाम 6:00 CET
+32 492 45 67 46
भारत कार्यालय
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI. सर्वाधिकार सुरक्षित।

गोपनीयताडेटा हटानाकुकीज़सेवा की शर्तेंवेबसाइट साइटमैप

NVIDIA, the NVIDIA logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX and HGX are trademarks and/or registered trademarks of NVIDIA Corporation in the US and other countries. AMD, the AMD Arrow logo, EPYC, Instinct, Ryzen and Threadripper are trademarks of Advanced Micro Devices, Inc. Dell and PowerEdge are trademarks of Dell Inc. or its subsidiaries. Intel and Xeon are trademarks of Intel Corporation or its subsidiaries. AMAX, AceleMax and LiquidMax are trademarks of AMAX Engineering Corporation. All other product names, logos and brands are the property of their respective owners. We use them only to identify the products we describe, supply or support; their use does not mean their owners endorse us.

NVIDIA Partner · UK

NVIDIA एक्सेलरेटेड कंप्यूटिंग समाधान

एक डेटा-सेंटर GPU से लेकर लिक्विड-कूल्ड रैक-स्केल AI फ़ैक्टरी तक, Workstation UK संगठनों के लिए पूरी NVIDIA एक्सेलरेटेड कंप्यूटिंग रेंज का आकलन, आपूर्ति, निर्माण, इंस्टॉलेशन और सपोर्ट करता है।

रेंज देखेंकिसी इंजीनियर से बात करें
  • 34NVIDIA सिस्टम, GPU, नेटवर्किंग और सॉफ़्टवेयर उत्पाद
  • 5चरण, आकलन से लेकर दीर्घकालिक सपोर्ट तक
  • UKइंजीनियरिंग, निर्माण और बर्न-इन परीक्षण

एक्सेलरेटेड कंप्यूटिंग, बिना इंटीग्रेशन जोखिम के

एक्सेलरेटेड कंप्यूटिंग वर्कलोड के सबसे भारी हिस्सों — जैसे AI ट्रेनिंग, इन्फ़रेंस, सिमुलेशन, एनालिटिक्स और रेंडरिंग — को सामान्य-उद्देश्य CPU से हटाकर GPU और विशेष प्रोसेसर पर ले जाती है। परिणाम: प्रति रैक और प्रति वॉट अधिक काम, और दिनों के बजाय घंटों में नतीजे।

वहाँ तक पहुँचने के लिए केवल GPU काफ़ी नहीं। हर एक्सेलरेटर को ऐसा सर्वर चाहिए जो उसे बिजली और कूलिंग दे सके, ऐसा नेटवर्क जो उसे डेटा देता रहे, और ऐसा सॉफ़्टवेयर जो लाइसेंस्ड और सपोर्टेड हो। अपने स्वयं के इंजीनियरों वाले NVIDIA Partner के रूप में, हम इन सभी हिस्सों को एक परीक्षित सिस्टम में जोड़ते हैं और लाइव होने के बाद भी आपके साथ रहते हैं।

  • आपके वर्कलोड के लिए कौन-सा NVIDIA प्लेटफ़ॉर्म सही है, इस पर स्वतंत्र सलाह
  • अलग-अलग पुर्ज़ों के बजाय पूर्ण, NVIDIA-Certified कॉन्फ़िगरेशन
  • हमारी UK वर्कशॉप में निर्मित, इमेज्ड और बर्न-इन परीक्षित
  • आपकी साइट पर इंस्टॉल, केबल्ड और कमीशन
  • सपोर्ट, अपग्रेड और वारंटी के लिए एक UK संपर्क

एक्सेलरेटेड सिस्टम में क्या-क्या शामिल होता है

चार परतें मिलकर काम करती हैं। हम चारों को निर्दिष्ट करते हैं ताकि कोई भी बाधा न बने।

GPU

AI, सिमुलेशन और ग्राफ़िक्स के पीछे का समानांतर गणित करते हैं। आमतौर पर मेमोरी का आकार और बैंडविड्थ तय करते हैं कि आपको कौन-सा GPU चाहिए।

CPU और सिस्टम

GPU को डेटा देते हैं, ऑपरेटिंग सिस्टम चलाते हैं और डेटा को मेमोरी में रखते हैं। चेसिस बिजली, कूलिंग और GPU की संख्या तय करता है।

नेटवर्किंग और DPU

GPU, सर्वर और स्टोरेज के बीच डेटा ले जाते हैं। DPU नेटवर्किंग, स्टोरेज और सुरक्षा का काम CPU से हटा लेते हैं।

सॉफ़्टवेयर

ड्राइवर, CUDA, AI फ़्रेमवर्क और क्लस्टर टूल हार्डवेयर को ऐसे प्लेटफ़ॉर्म में बदलते हैं जिसे आपकी टीमें उपयोग कर सकें।

संगठन एक्सेलरेटेड कंप्यूटिंग क्यों अपनाते हैं

वर्कलोड CPU की क्षमता से आगे निकल जाते हैं

AI मॉडल और डेटा सेट CPU प्रदर्शन से तेज़ी से बढ़ते हैं। जॉब समय से अधिक चलते हैं, सेवा स्तर गिरते हैं और बिजली के बिल बढ़ते हैं।

वर्कफ़्लो जटिल हो जाते हैं

डेटा तैयारी, ट्रेनिंग, इन्फ़रेंस और विज़ुअलाइज़ेशन अक्सर अलग-अलग उपकरणों पर चलते हैं। एक एक्सेलरेटेड प्लेटफ़ॉर्म पाइपलाइन को सरल बनाता है।

नए ऐप नए साइलो बनाते हैं

मौजूदा एप्लिकेशन के साथ AI जोड़ने से हार्डवेयर के अलग-थलग द्वीप बन सकते हैं। एक साझा, प्रमाणित प्लेटफ़ॉर्म सब कुछ प्रबंधनीय रखता है।

रेंज

NVIDIA एक्सेलरेटेड कंप्यूटिंग उत्पाद

नीचे दिया गया हर सिस्टम, GPU, नेटवर्क उत्पाद और सॉफ़्टवेयर लाइसेंस अलग से या पूर्ण बिल्ड के हिस्से के रूप में उपलब्ध है। प्रकार के अनुसार फ़िल्टर करें, मुख्य विनिर्देशों की तुलना करें और कोटेशन का अनुरोध करें।

सिस्टम और प्लेटफ़ॉर्म

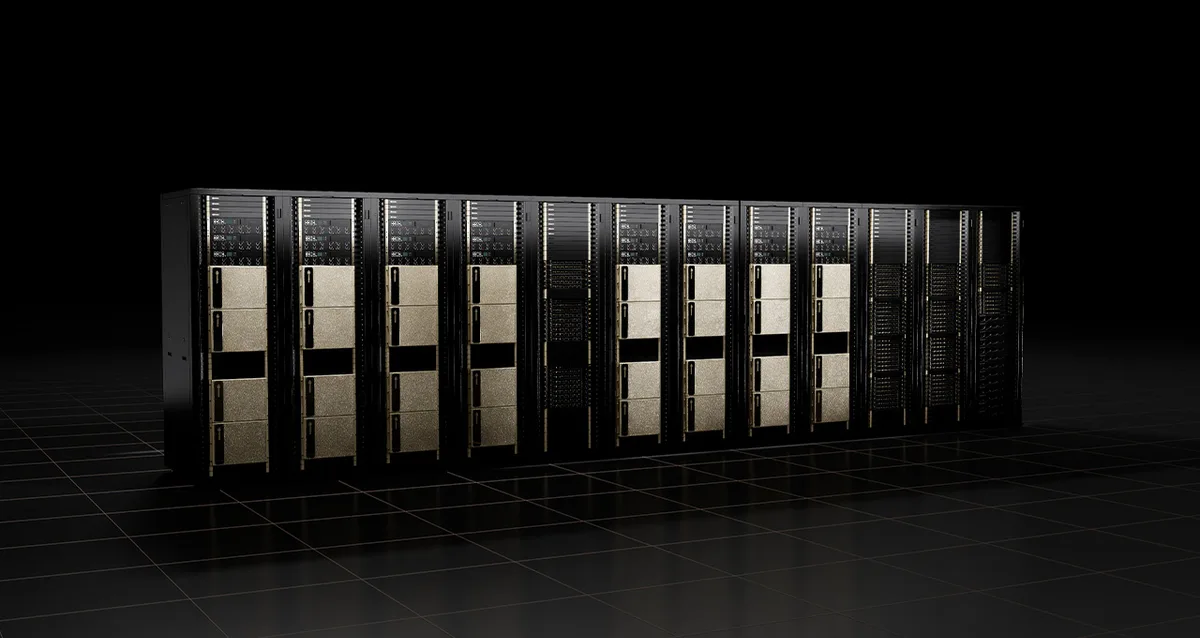
NVIDIA Vera Rubin NVL72

एजेंटिक AI और सबसे बड़े मॉडलों के लिए रैक-स्केल सिस्टम

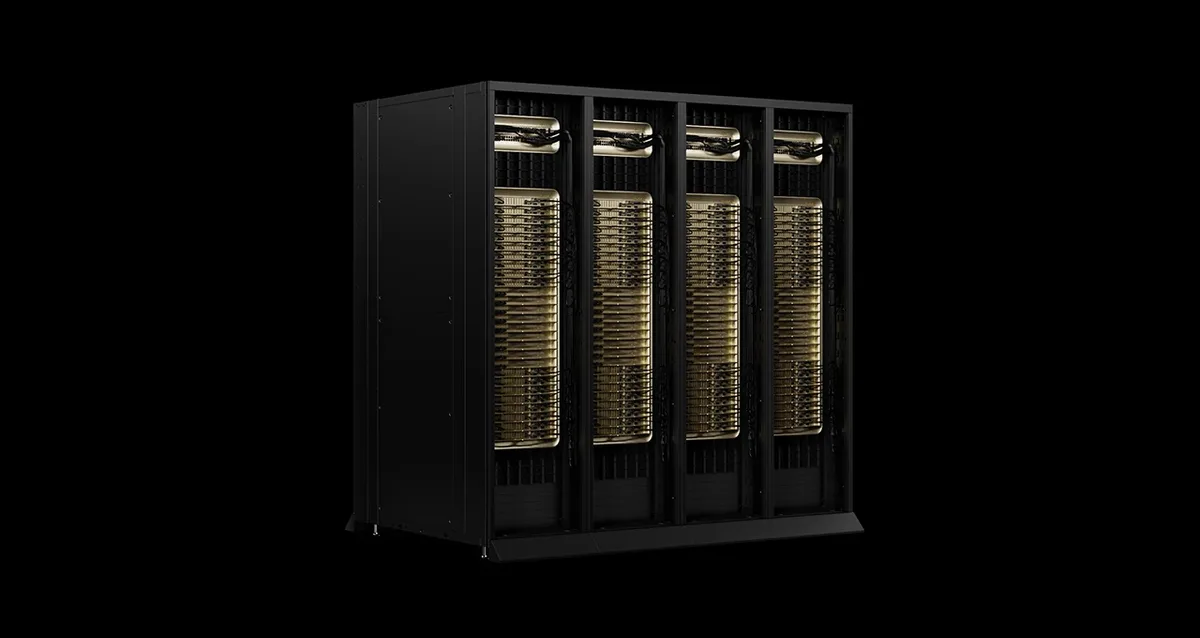
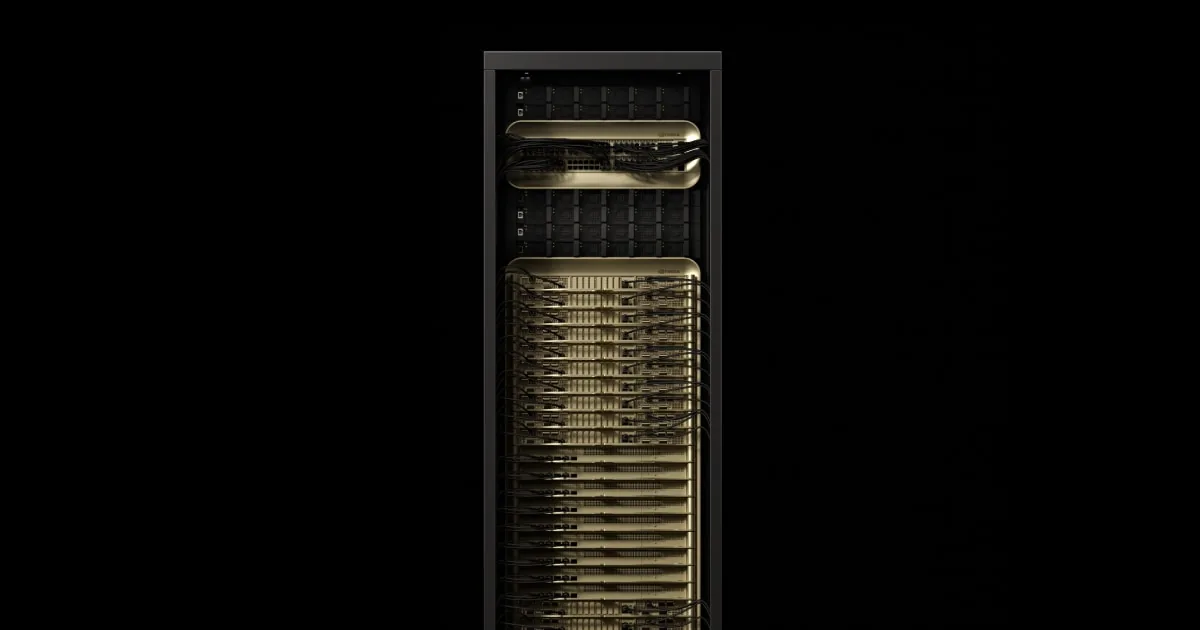
NVIDIA की नवीनतम रैक-स्केल पीढ़ी 72 Rubin GPU और 36 Vera CPU को एक NVLink डोमेन में जोड़ती है, ताकि एक रैक एक बहुत बड़े एक्सेलरेटर की तरह काम करे।

किसके लिए उपयुक्त: अपनी अगली बड़ी तैनाती की योजना बना रहे AI फ़ैक्टरी, मॉडल निर्माता और सेवा प्रदाता

लाभ

  • NVIDIA के आंकड़ों के अनुसार, Grace Blackwell पीढ़ी की तुलना में प्रति मेगावाट कहीं अधिक टोकन
  • ट्रिलियन-पैरामीटर और लॉन्ग-कॉन्टेक्स्ट मॉडलों के लिए उपयुक्त HBM4 मेमोरी
  • मॉड्यूलर, केबल-रहित ट्रे जो रैक में सर्विसिंग को आसान बनाती हैं

मुख्य विनिर्देश

कॉन्फ़िगरेशन72× Rubin GPU, 36× Vera CPU
GPU मेमोरी20.7 TB HBM4 | 1,400 TB/s
NVFP4 इन्फ़रेंस3,600 PFLOPS (sparse)
NVLink बैंडविड्थ216 TB/s (sixth generation)
CPU मेमोरीUp to 54 TB LPDDR5X
फ़ॉर्म फ़ैक्टरRack, third-generation MGX NVL72

Workstation क्या करता है: हम शुरुआत में ही साइट की बिजली, कूलिंग और फ़्लोर लोडिंग जाँचते हैं, आवंटन सुनिश्चित करते हैं, और आपके डेटा हॉल के अनुसार डिलीवरी, इंस्टॉलेशन और कमीशनिंग की योजना बनाते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

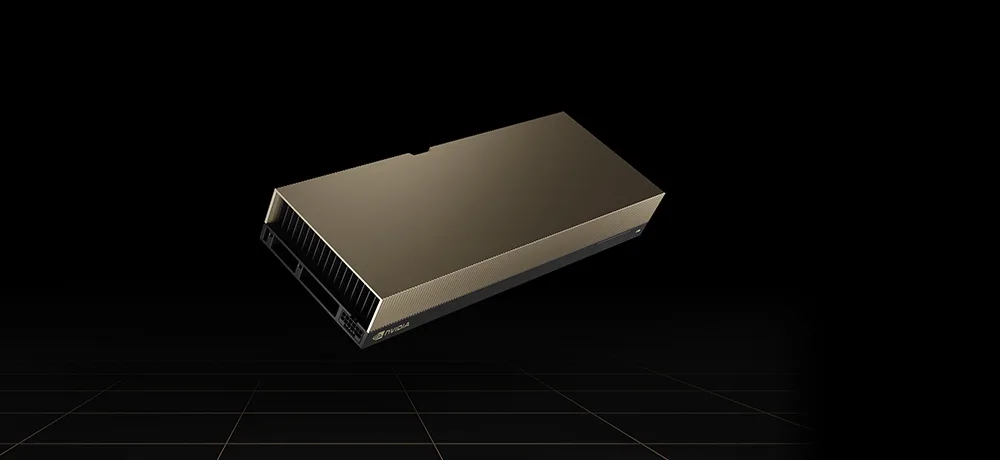
NVIDIA GB300 NVL72 (DGX GB300)

AI रीज़निंग के लिए लिक्विड-कूल्ड Blackwell Ultra रैक

छत्तीस Grace CPU और 72 Blackwell Ultra GPU एक ही लिक्विड-कूल्ड रैक में एक NVLink फ़ैब्रिक साझा करते हैं। NVIDIA इसे DGX GB300 के रूप में भी उपलब्ध कराता है।

किसके लिए उपयुक्त: कई उपयोगकर्ताओं को रीज़निंग मॉडल उपलब्ध कराने वाले संगठन, और फ़्रंटियर स्केल पर ट्रेनिंग करने वाली टीमें

लाभ

  • Hopper-आधारित सिस्टम की तुलना में प्रति उपयोगकर्ता प्रति सेकंड टोकन में बड़ी छलांग
  • 37 TB तेज़ मेमोरी लंबे कॉन्टेक्स्ट और बड़े मॉडलों को एक डोमेन में रखती है
  • ConnectX-8 SuperNIC हर GPU को नेटवर्क तक 800 Gb/s का मार्ग देते हैं

मुख्य विनिर्देश

GPU72× Blackwell Ultra
CPU36× Grace (2,592 Arm Neoverse V2 cores)
GPU मेमोरी20 TB | up to 576 TB/s
तेज़ मेमोरी37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
NVLink बैंडविड्थ130 TB/s

Workstation क्या करता है: हम आपकी फ़ैसिलिटी टीम के साथ लिक्विड कूलिंग और बिजली की योजना बनाते हैं, इंटीग्रेटेड रैक की डिलीवरी का समन्वय करते हैं और इसे मान्य बेसलाइन तक कमीशन करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

NVIDIA GB200 NVL72 (DGX GB200)

एक NVLink डोमेन में Grace Blackwell रैक-स्केल सिस्टम

पहला Grace Blackwell रैक: 72 Blackwell GPU और 36 Grace CPU, NVLink से जुड़े और लिक्विड से कूल्ड, बहुत बड़े ट्रेनिंग रन और रियल-टाइम इन्फ़रेंस के लिए।

किसके लिए उपयुक्त: ट्रिलियन-पैरामीटर मॉडल ट्रेन या सर्व करने वाली टीमें जिन्हें एक बड़ा, साझा GPU मेमोरी पूल चाहिए

लाभ

  • NVIDIA के आंकड़ों के अनुसार, बहुत बड़े लैंग्वेज मॉडलों पर रियल-टाइम इन्फ़रेंस, H100 से कई गुना तेज़
  • लिक्विड कूलिंग घनत्व और ऊर्जा दक्षता बढ़ाती है
  • पाँचवीं पीढ़ी का NVLink किन्हीं भी दो GPU के बीच 1.8 TB/s देता है

मुख्य विनिर्देश

कॉन्फ़िगरेशन72× Blackwell GPU, 36× Grace CPU
GPU मेमोरी13.4 TB HBM3E | 576 TB/s
NVFP4 Tensor Core1,440 PFLOPS sparse | 720 PFLOPS dense
NVLink बैंडविड्थ130 TB/s
CPU मेमोरी17 TB LPDDR5X | 14 TB/s
कूलिंगLiquid cooled

Workstation क्या करता है: हम लिक्विड कूलिंग के लिए आपकी साइट का आकलन करते हैं, डिलीवरी और आपके नेटवर्क व स्टोरेज के साथ इंटीग्रेशन संभालते हैं, और गो-लाइव के बाद रैक को सपोर्ट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

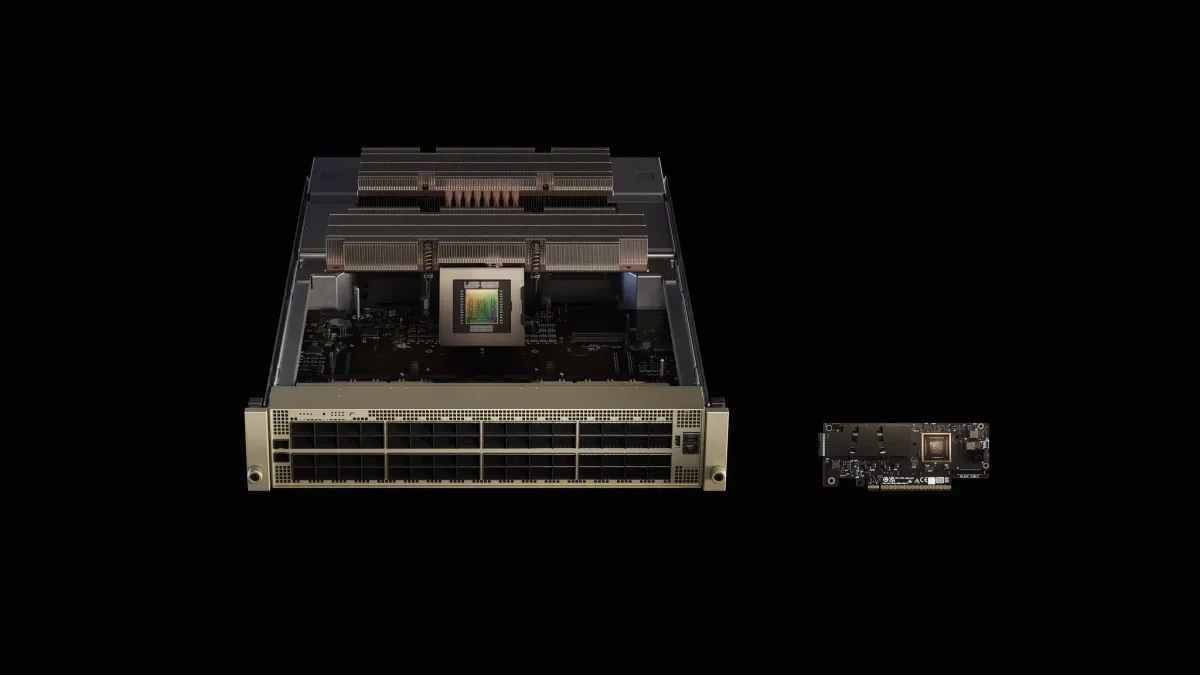
NVIDIA DGX B300

एक DGX सिस्टम में आठ Blackwell Ultra GPU

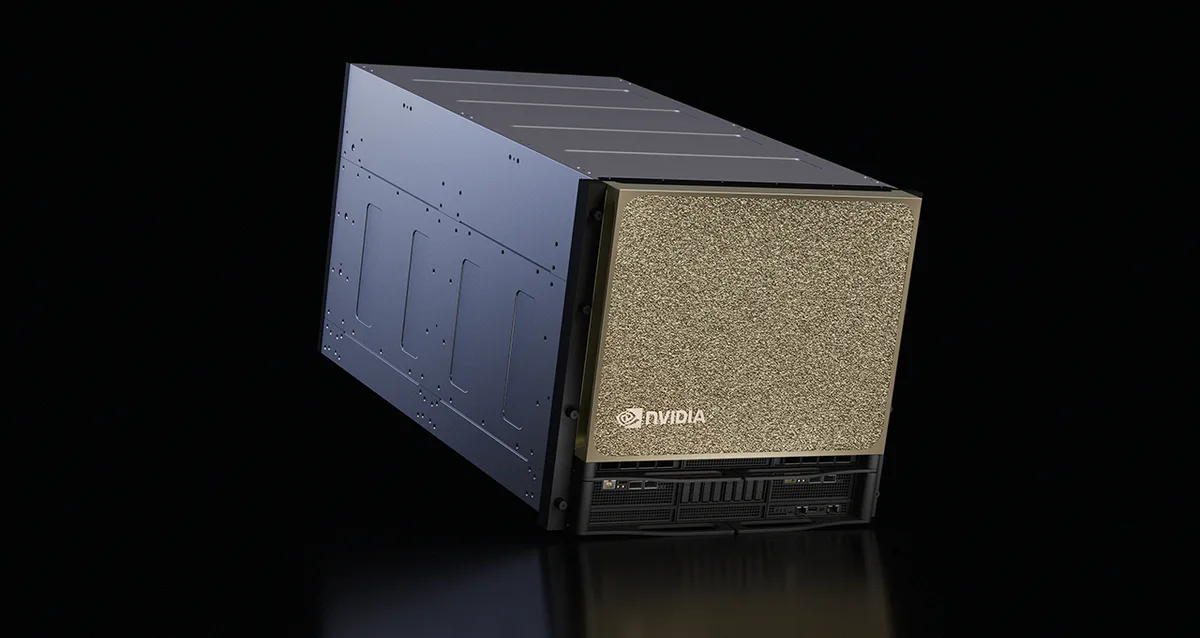
आठ Blackwell Ultra GPU, NVIDIA नेटवर्किंग और पूर्ण DGX सॉफ़्टवेयर स्टैक वाला एक स्व-निहित DGX सर्वर, जो अकेले चलने या BasePOD या SuperPOD में जुड़ने के लिए तैयार है।

किसके लिए उपयुक्त: अपनी पहली गंभीर AI फ़ैक्टरी बना रहे उद्यम, और कस्टम बिल्ड के बजाय NVIDIA का रेफ़रेंस डिज़ाइन चाहने वाली टीमें

लाभ

  • बड़े मॉडलों के लिए एक ही नोड में 2.3 TB GPU मेमोरी
  • स्केल-आउट के लिए बिल्ट-इन ConnectX-8 और BlueField-3 नेटवर्किंग
  • DGX सॉफ़्टवेयर पहले दिन से क्लस्टर के हर नोड को एकरूप रखता है

मुख्य विनिर्देश

GPU8× Blackwell Ultra
GPU मेमोरी2.3 TB total
AI प्रदर्शन72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
नेटवर्किंग8× ConnectX-8, 2× BlueField-3 DPU

Workstation क्या करता है: हम रैक की बिजली और एयरफ़्लो जाँचते हैं, सिस्टम डिलीवर करके रैक में लगाते हैं, उसे आपके फ़ैब्रिक से जोड़ते हैं और मान्य DGX OS तथा ड्राइवरों के साथ सौंपते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

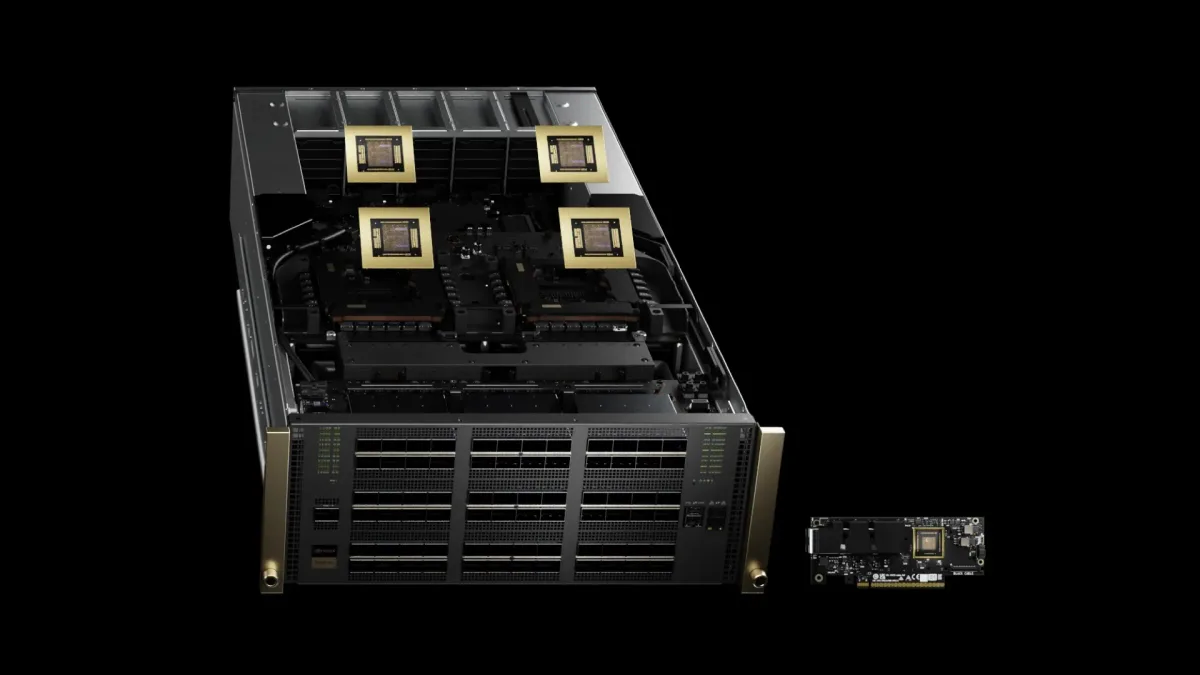
NVIDIA DGX B200

ट्रेनिंग और इन्फ़रेंस के लिए सिद्ध Blackwell DGX

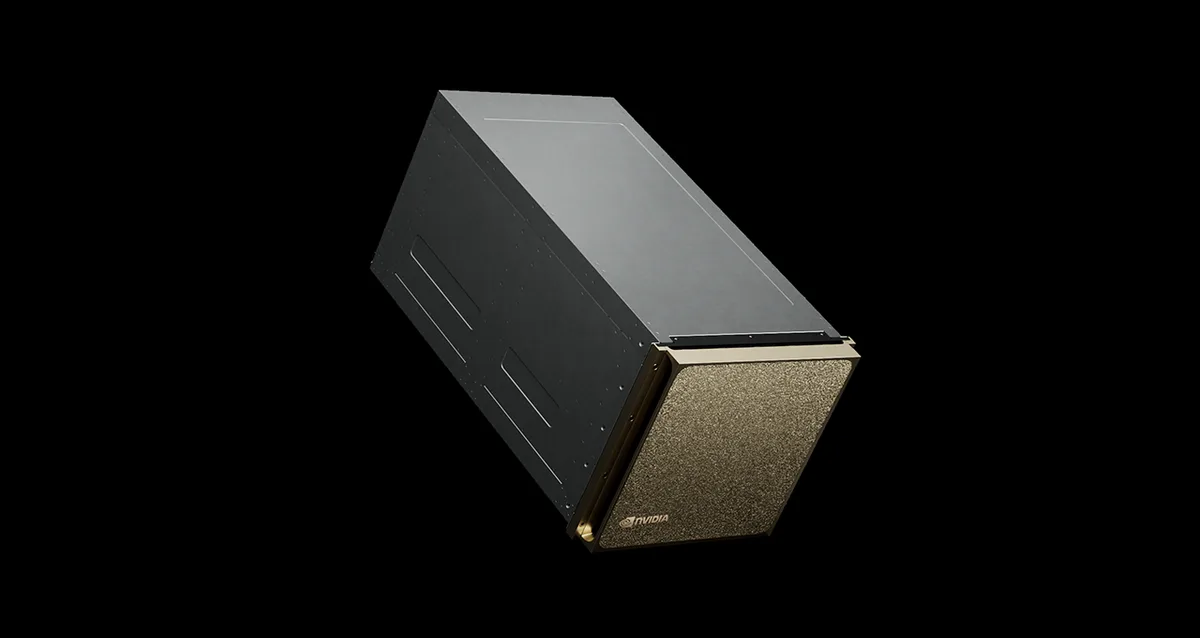
एक DGX चेसिस में NVLink से जुड़े आठ Blackwell GPU — ऑन-प्रिमाइसेस AI के लिए व्यापक रूप से उपयोग किया जाने वाला बिल्डिंग ब्लॉक।

किसके लिए उपयुक्त: Hopper या क्लाउड GPU से अपने स्वामित्व वाले Blackwell प्लेटफ़ॉर्म पर जा रही टीमें

लाभ

  • ट्रेनिंग, फ़ाइन-ट्यूनिंग और इन्फ़रेंस के लिए एक प्लेटफ़ॉर्म
  • NVLink से जुड़े आठ GPU में कुल 1,440 GB GPU मेमोरी
  • विस्तार के साथ BasePOD और SuperPOD रेफ़रेंस डिज़ाइन में फ़िट होता है

मुख्य विनिर्देश

GPU8× Blackwell
GPU मेमोरी1,440 GB total
AI प्रदर्शन72 PFLOPS training, 144 PFLOPS inference
नेटवर्किंग8× ConnectX-7, 2× BlueField-3 DPU

Workstation क्या करता है: हम इसे आपके मॉडलों के अनुसार आकार देते हैं, डिलीवर और इंस्टॉल करते हैं, और सौंपने से पहले ड्राइवर, CUDA और NVIDIA AI Enterprise सेट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

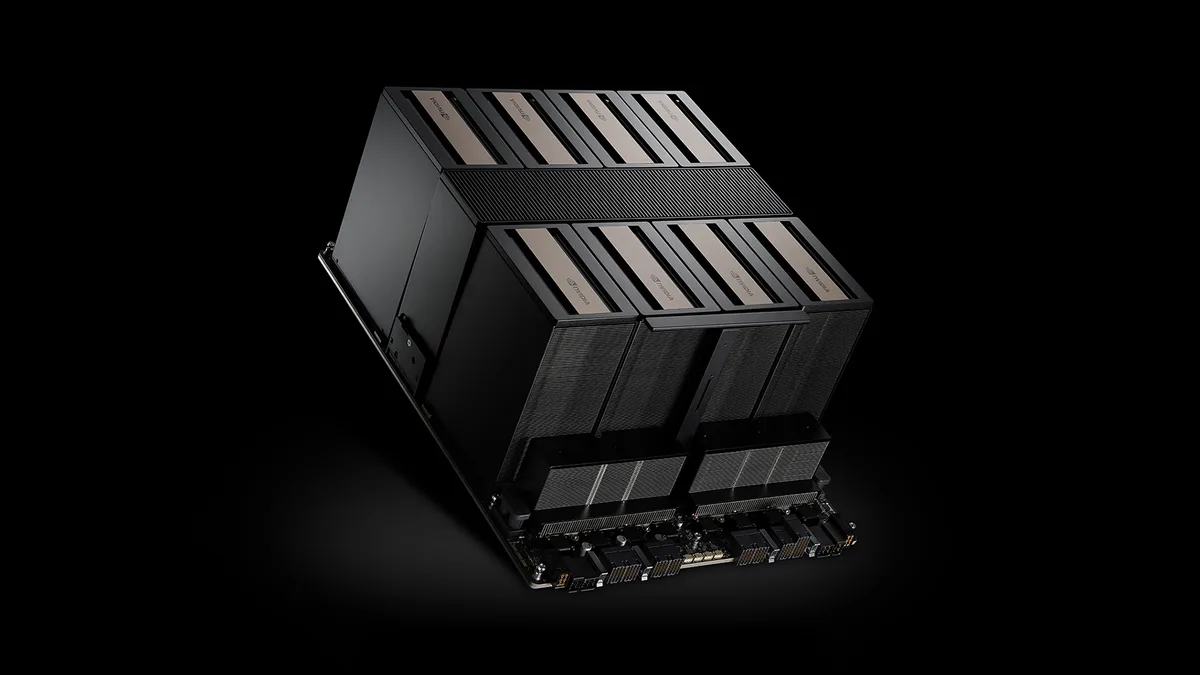
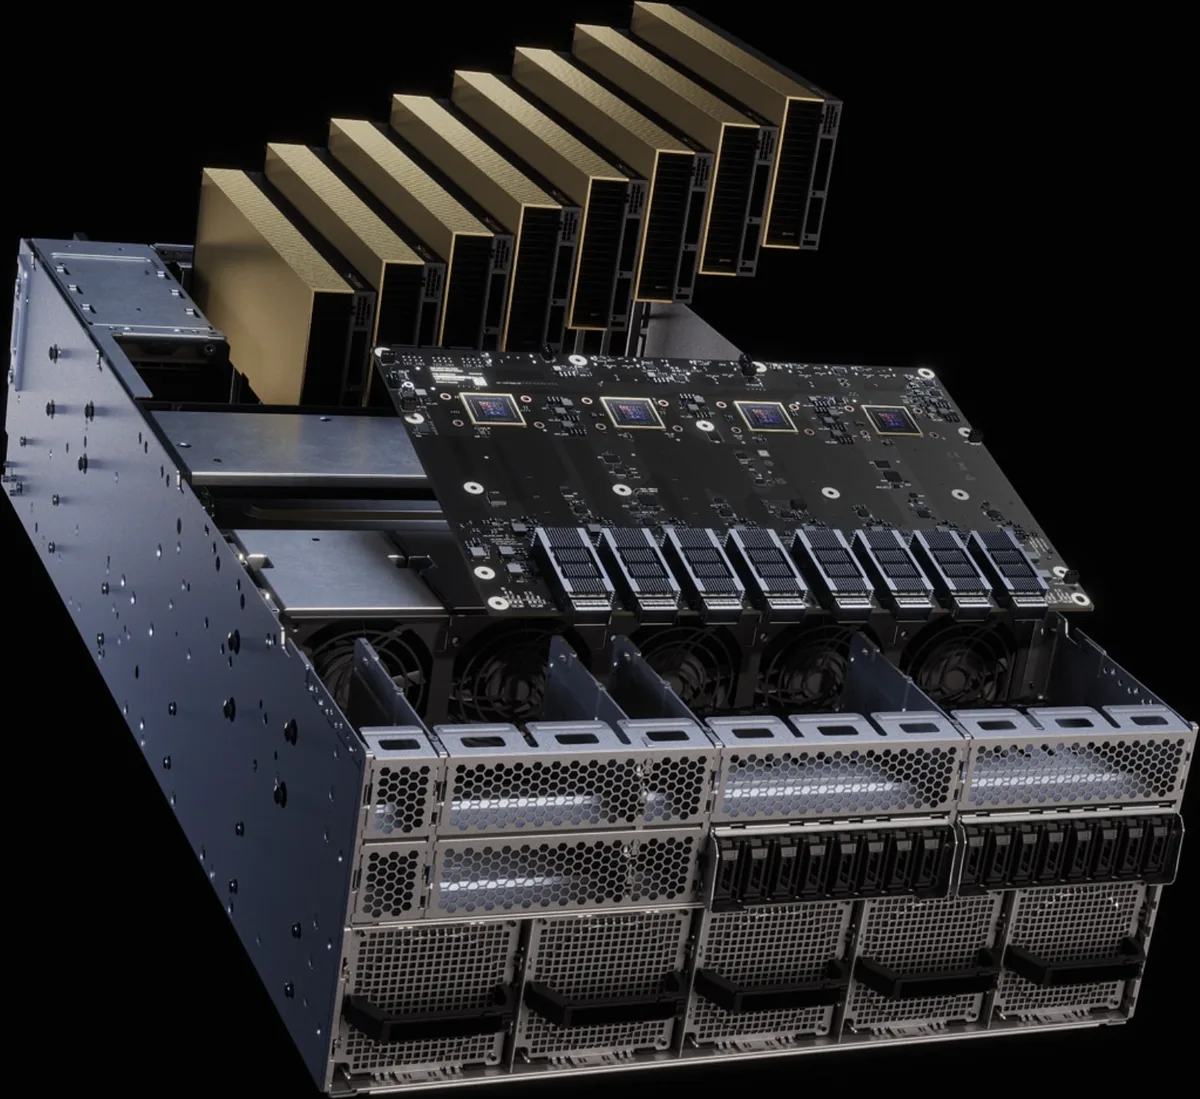
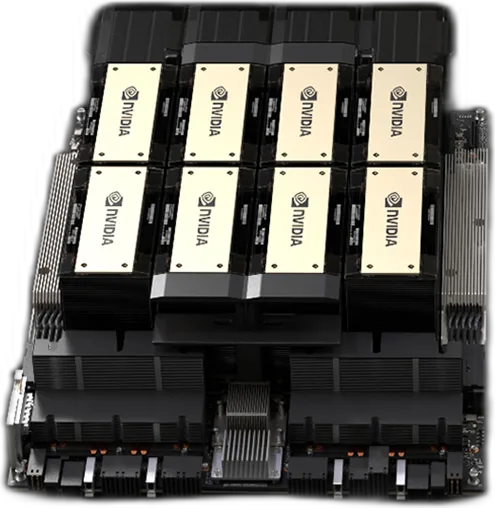
NVIDIA HGX

पार्टनर सर्वरों के अंदर आठ-GPU बेसबोर्ड

HGX, NVIDIA का NVLink से जुड़ा GPU बेसबोर्ड है जिसे सर्वर निर्माता अपने सिस्टम में लगाते हैं — इससे आपको शीर्ष GPU के साथ चेसिस, CPU और सपोर्ट ब्रांड चुनने की स्वतंत्रता मिलती है।

किसके लिए उपयुक्त: अपने पसंदीदा सर्वर विक्रेता से फ़्लैगशिप GPU चाहने वाले संगठन

लाभ

  • अपने इंफ्रास्ट्रक्चर के अनुकूल सर्वर ब्रांड, CPU और स्टोरेज चुनें
  • NVLink और NVSwitch सभी आठ GPU को पूरी गति से जोड़ते हैं
  • Blackwell, Blackwell Ultra और Rubin पीढ़ियों को कवर करता है

मुख्य विनिर्देश

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
NVLink बैंडविड्थ14.4 TB/s total (HGX B300 and B200)

Workstation क्या करता है: हम आपके पसंदीदा ब्रांड से HGX सर्वर प्राप्त करते हैं, अपनी वर्कशॉप में पूरे लोड पर बर्न-इन करते हैं और आपकी नेटवर्किंग के साथ इंस्टॉल करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
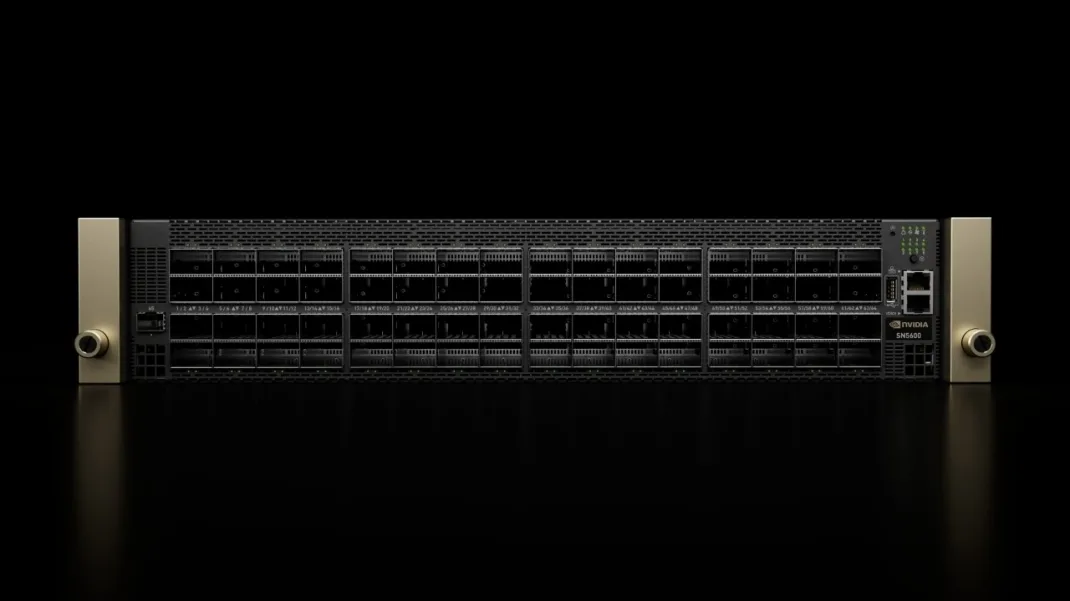
सिस्टम और प्लेटफ़ॉर्म

NVIDIA RTX PRO Server

एंटरप्राइज़ AI और ग्राफ़िक्स के लिए यूनिवर्सल Blackwell सर्वर

आठ तक RTX PRO 6000 Blackwell Server Edition GPU वाला डेटा-सेंटर सर्वर, जो AI, सिमुलेशन, रेंडरिंग और वर्चुअल वर्कस्टेशन एक ही प्लेटफ़ॉर्म पर चलाता है। यह NVIDIA का मुख्यधारा एक्सेलरेटेड सर्वर है, और इसका EGX पेज अब यहीं इंगित करता है।

किसके लिए उपयुक्त: नई AI सेवाओं के साथ-साथ मौजूदा डेटा-सेंटर वर्कलोड को GPU पर ले जा रहे उद्यम

लाभ

  • AI इन्फ़रेंस, विज़ुअल कंप्यूटिंग और डेटा साइंस के लिए एक ही सर्वर प्रकार
  • एयर-कूल्ड विकल्प अधिकांश मौजूदा सर्वर रूम के लिए उपयुक्त
  • NVIDIA AI Enterprise और Omniverse के साथ मान्य

मुख्य विनिर्देश

GPUUp to 8× RTX PRO 6000 Blackwell Server Edition
GPU मेमोरी800 GB (8-GPU configuration)
मेमोरी बैंडविड्थ13 TB/s (8-GPU configuration)
RTX ग्राफ़िक्स3 PFLOPS
कॉन्फ़िगरेशनMGX 2U, 4U and 6U (6U liquid cooled)

Workstation क्या करता है: हम आपके वर्कलोड के अनुसार चेसिस और GPU संख्या निर्दिष्ट करते हैं, जाँचते हैं कि यह NVIDIA-Certified है, फिर इसे बनाते, बर्न-इन करते और इंस्टॉल करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
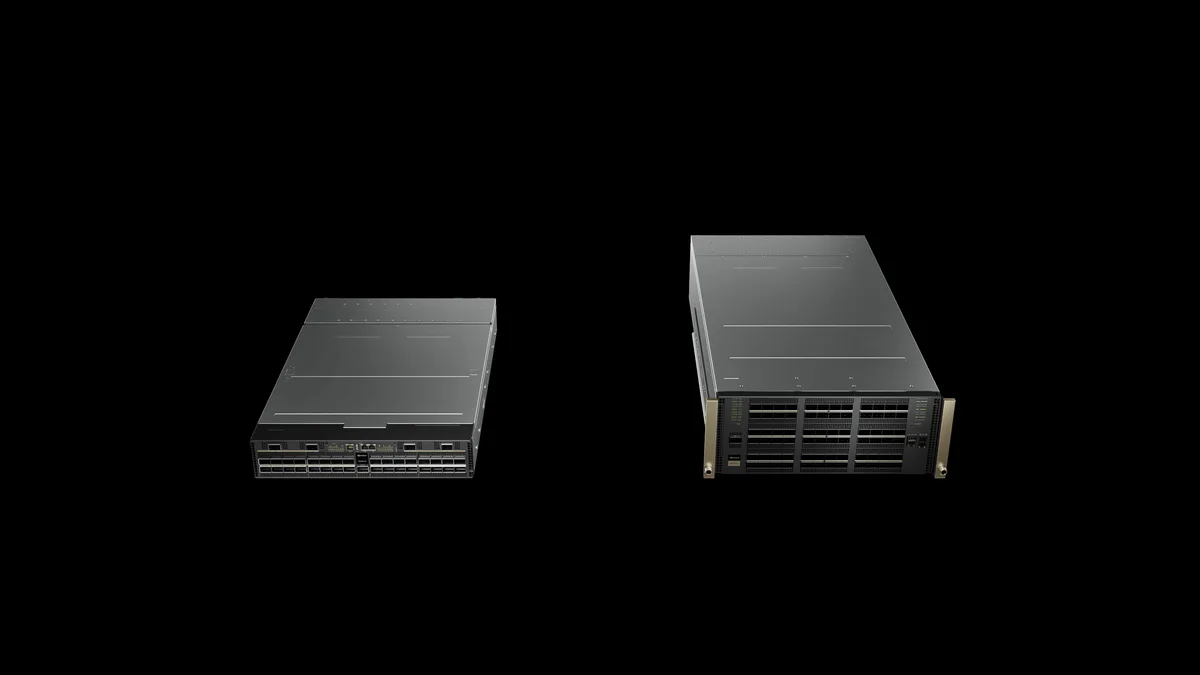
सिस्टम और प्लेटफ़ॉर्म

NVIDIA DGX SuperPOD

बड़े पैमाने पर AI फ़ैक्टरी के लिए टर्नकी ब्लूप्रिंट

एक फ़ुल-स्टैक रेफ़रेंस आर्किटेक्चर जो DGX सिस्टम, NVIDIA नेटवर्किंग, प्रमाणित स्टोरेज और प्रबंधन सॉफ़्टवेयर को दोहराने योग्य स्केलेबल यूनिट में जोड़ता है।

किसके लिए उपयुक्त: सैकड़ों या हज़ारों GPU के क्लस्टर बना रहे अनुसंधान प्रयोगशालाएँ, बड़े उद्यम और AI सेवा प्रदाता

लाभ

  • परीक्षित डिज़ाइन इंटीग्रेशन जोखिम का बड़ा हिस्सा हटा देता है
  • दोहराने योग्य यूनिट में दसियों हज़ार GPU तक स्केल करता है
  • संचालन के लिए Mission Control और Base Command Manager शामिल

मुख्य विनिर्देश

प्रकारReference architecture
बिल्डिंग ब्लॉकScalable units of DGX systems
स्केलUp to tens of thousands of GPUs
स्टोरेजNVIDIA-certified partner storage
सॉफ़्टवेयरNVIDIA AI Enterprise, Base Command Manager, Mission Control

Workstation क्या करता है: हम NVIDIA और स्टोरेज पार्टनरों के साथ डिज़ाइन का नेतृत्व करते हैं, परियोजना योजना चलाते हैं, स्केलेबल यूनिट इंस्टॉल करते हैं और आपके सपोर्ट संपर्क बने रहते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

NVIDIA DGX BasePOD

आपके पहले DGX क्लस्टर के लिए रेफ़रेंस डिज़ाइन

दो या अधिक DGX सिस्टम के लिए मेल खाते नेटवर्किंग, स्टोरेज और क्लस्टर सॉफ़्टवेयर वाला सिद्ध डिज़ाइन: SuperPOD से छोटा, लेकिन उसी तरह बना।

किसके लिए उपयुक्त: एक DGX सिस्टम से छोटे साझा क्लस्टर की ओर बढ़ रही टीमें

लाभ

  • दो सिस्टम से शुरू करें और बिना पुनः डिज़ाइन के और जोड़ें
  • GPU के अनुरूप नेटवर्किंग और स्टोरेज
  • शेड्यूलिंग और मॉनिटरिंग के लिए क्लस्टर सॉफ़्टवेयर शामिल

मुख्य विनिर्देश

प्रकारReference architecture
स्केल2 or more DGX systems
नेटवर्किंगPer reference architecture
स्टोरेजPartner storage
सॉफ़्टवेयरNVIDIA AI Enterprise, Base Command

Workstation क्या करता है: हम क्लस्टर का आकार तय करते हैं, हर हिस्सा उपलब्ध कराते हैं, रैक और केबल करते हैं, और शेड्यूलिंग सेट करते हैं ताकि आपकी टीमें पहले दिन से इसे साझा कर सकें।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
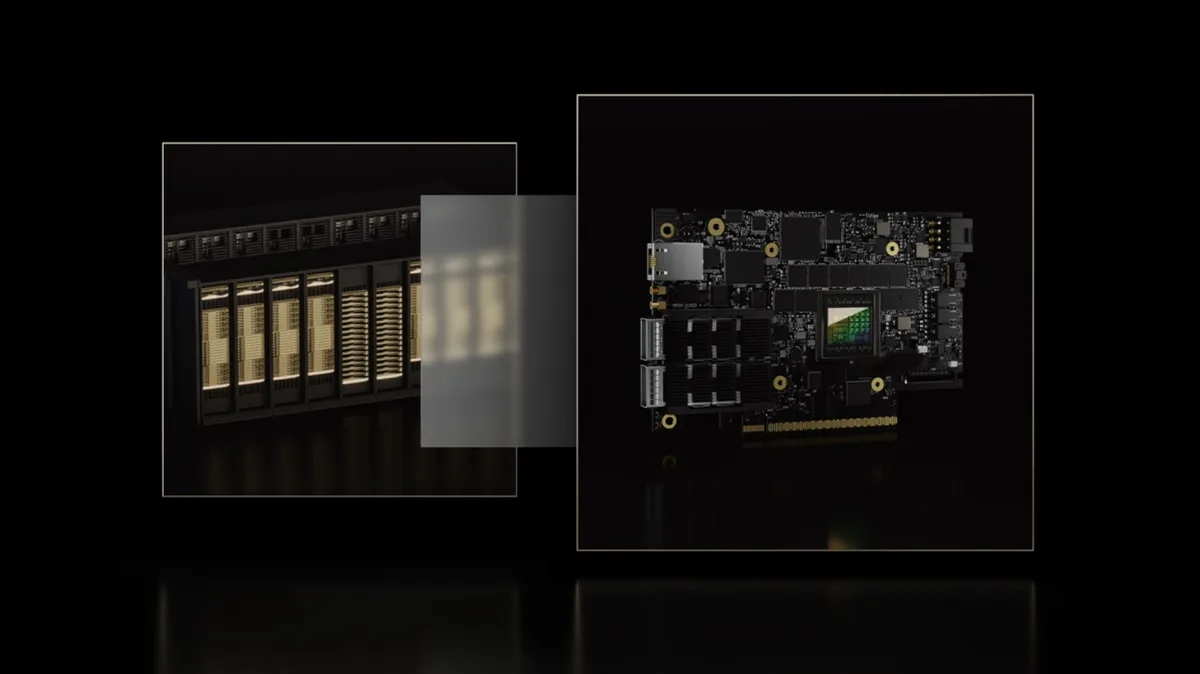
सिस्टम और प्लेटफ़ॉर्म

NVIDIA Grace और Vera CPU

AI फ़ैक्टरी के लिए बने Arm डेटा-सेंटर CPU

NVIDIA के अपने CPU NVLink-C2C के ज़रिए उसके GPU से जुड़ते हैं। Grace CPU Superchip आज पार्टनर सर्वरों में उपलब्ध है, और इसका उत्तराधिकारी Vera एजेंटिक AI के लिए लक्षित है।

किसके लिए उपयुक्त: HPC केंद्र, क्लाउड निर्माता और GPU के साथ CPU-भारी पाइपलाइन चलाने वाले सभी

लाभ

  • LPDDR5X से उच्च मेमोरी बैंडविड्थ
  • NVIDIA के आंकड़ों के अनुसार, अग्रणी पारंपरिक CPU की तुलना में समान बिजली पर दोगुना प्रदर्शन
  • NVIDIA GPU के साथ सुसंगत, हाई-स्पीड लिंक

मुख्य विनिर्देश

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Grace मेमोरी बैंडविड्थUp to 1 TB/s LPDDR5X
Vera CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

Workstation क्या करता है: हम आपके सॉफ़्टवेयर स्टैक के अनुकूल पार्टनर सर्वर खोजते हैं, आपके साथ Arm पर आपके एप्लिकेशन का परीक्षण करते हैं, फिर परिणाम को बनाते और सपोर्ट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

NVIDIA OVX

Omniverse और डिजिटल ट्विन के लिए L40S सर्वर

OVX, Omniverse के लिए NVIDIA का मान्य सर्वर डिज़ाइन है, जो सिमुलेशन, रेंडरिंग और AI के लिए L40S GPU को ConnectX-7 या BlueField-3 नेटवर्किंग के साथ जोड़ता है।

किसके लिए उपयुक्त: औद्योगिक डिजिटल ट्विन बना रहे निर्माता, आर्किटेक्ट और इंजीनियरिंग टीमें

लाभ

  • ग्राफ़िक्स, सिमुलेशन और AI इन्फ़रेंस के लिए एक सर्वर
  • Omniverse और NVIDIA AI Enterprise के लिए मान्य
  • हाई-स्पीड फ़ैब्रिक पर सैकड़ों सर्वरों तक स्केल करता है

मुख्य विनिर्देश

GPU4× or 8× NVIDIA L40S
CPU2× Intel Xeon Gold or 2× AMD EPYC
होस्ट मेमोरी384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
स्टोरेज1 TB NVMe boot, 2× 4 TB NVMe
नेटवर्किंगConnectX-7 or BlueField-3

Workstation क्या करता है: हम प्रमाणित पार्टनरों से OVX-पैटर्न सर्वर बनाते हैं, Omniverse और ड्राइवर सेट करते हैं, और उन्हें आपके डिज़ाइन टूल से जोड़ते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

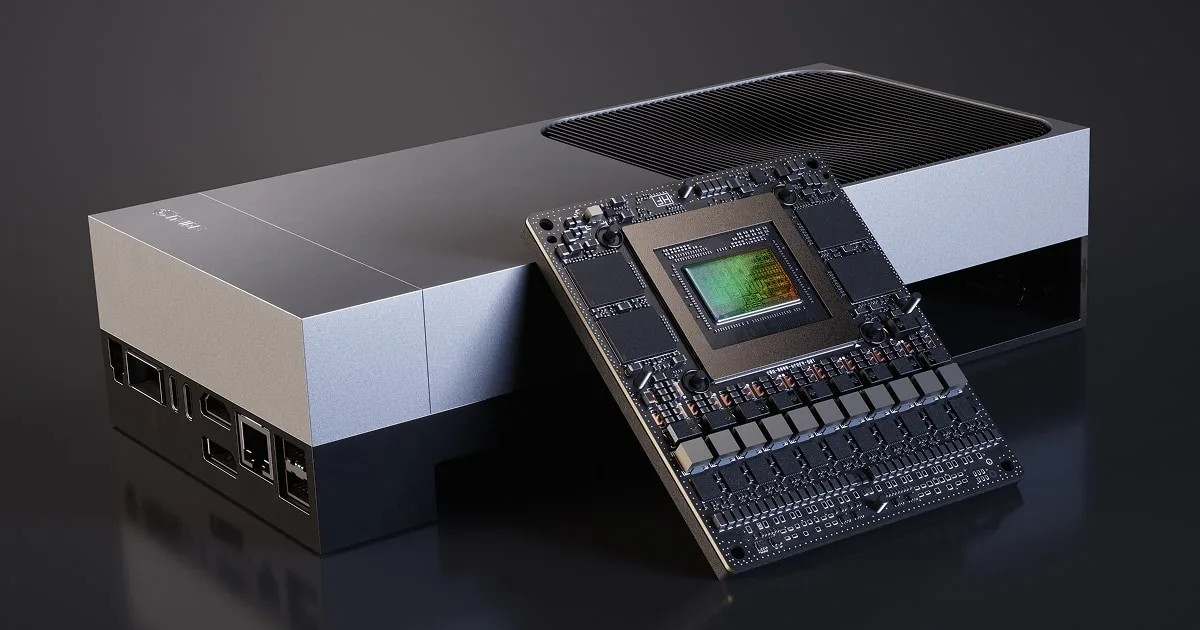
NVIDIA AGX (Jetson AGX Thor)

रोबोट और स्वायत्त मशीनों के लिए AI कंप्यूटर

AGX स्वायत्त मशीनों के लिए NVIDIA का प्लेटफ़ॉर्म है। इसका वर्तमान फ़्लैगशिप, Jetson AGX Thor, रोबोट, वाहनों और स्मार्ट मशीनों में Blackwell GPU लाता है।

किसके लिए उपयुक्त: मशीनों में AI ला रही रोबोटिक्स, ऑटोमोटिव और औद्योगिक टीमें

लाभ

  • परसेप्शन और जनरेटिव AI मॉडल को मशीन पर ही चलाता है
  • कम बिजली खपत मोबाइल और एम्बेडेड डिज़ाइनों के लिए उपयुक्त
  • NVIDIA के डेटा-सेंटर प्लेटफ़ॉर्म जैसा ही CUDA सॉफ़्टवेयर उपयोग करता है

मुख्य विनिर्देश

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
AI प्रदर्शन2070 TFLOPS (FP4)
विकल्पDeveloper kit, or T5000 and T4000 production modules

Workstation क्या करता है: हम डेवलपर किट और प्रोडक्शन मॉड्यूल उपलब्ध कराते हैं, कैरियर बोर्ड और एनक्लोज़र चुनने में मदद करते हैं, और प्रोटोटाइप से रोल-आउट तक आपको सपोर्ट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

NVIDIA IGX Thor

फ़ंक्शनल सेफ़्टी के साथ औद्योगिक एज AI

IGX औद्योगिक और चिकित्सा एज पर फ़िज़िकल AI के लिए NVIDIA का एंटरप्राइज़ प्लेटफ़ॉर्म है, जिसमें समर्पित सेफ़्टी आइलैंड और दीर्घकालिक सॉफ़्टवेयर सपोर्ट है।

किसके लिए उपयुक्त: चिकित्सा उपकरण निर्माता, कारख़ाने और इंफ्रास्ट्रक्चर ऑपरेटर जिन्हें सेफ़्टी प्रमाणन और लंबा सपोर्ट जीवन चाहिए

लाभ

  • ISO 26262 और IEC 61508 को लक्षित फ़ंक्शनल सेफ़्टी डिज़ाइन
  • दस वर्षों का NVIDIA एंटरप्राइज़ सॉफ़्टवेयर सपोर्ट
  • भारी मॉडलों के लिए वैकल्पिक RTX PRO Blackwell GPU

मुख्य विनिर्देश

AI प्रदर्शनUp to 5,581 TFLOPS FP4 (sparse) with discrete GPU
इंटीग्रेटेड GPU2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
मेमोरी128 GB LPDDR5X, 273 GB/s
बिजली खपत40–130 W, up to 300 W for the discrete GPU

Workstation क्या करता है: हम डेवलपर किट और प्रोडक्शन सिस्टम उपलब्ध कराते हैं, प्रमाणन साक्ष्य की योजना बनाने में मदद करते हैं और आपकी साइट पर तैनाती को सपोर्ट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
सिस्टम और प्लेटफ़ॉर्म

NVIDIA Groq 3 LPX

Vera Rubin के लिए लो-लेटेंसी इन्फ़रेंस रैक

LPX, 256 LPU इन्फ़रेंस एक्सेलरेटर का एक रैक है जो Vera Rubin NVL72 के साथ मिलकर इंटरैक्टिव और एजेंटिक AI के लिए तेज़ और पूर्वानुमेय टोकन जनरेट करता है।

किसके लिए उपयुक्त: AI सेवा प्रदाता जिनके उपयोगकर्ताओं को तेज़, एकसमान प्रतिक्रिया समय चाहिए

लाभ

  • नियतात्मक, लो-लेटेंसी टोकन जनरेशन
  • NVIDIA के अनुमानों के अनुसार, ट्रिलियन-पैरामीटर मॉडलों के लिए प्रति मेगावाट कहीं अधिक थ्रूपुट
  • NVL72 रैक से सीधा, लो-लेटेंसी लिंक

मुख्य विनिर्देश

एक्सेलरेटर256 LPUs per rack
ऑन-चिप मेमोरी128 GB SRAM per rack (500 MB per LPU)
SRAM बैंडविड्थ40 PB/s per rack
स्केल-अप बैंडविड्थ640 TB/s per rack
फ़ॉर्म फ़ैक्टरNVIDIA MGX ETL rack

Workstation क्या करता है: हम आकलन करते हैं कि यह आपकी Vera Rubin योजनाओं में कैसे फ़िट होता है, NVIDIA से उपलब्धता की पुष्टि करते हैं और आपके अन्य रैक के साथ इंस्टॉलेशन की योजना बनाते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
डेटा-सेंटर GPU

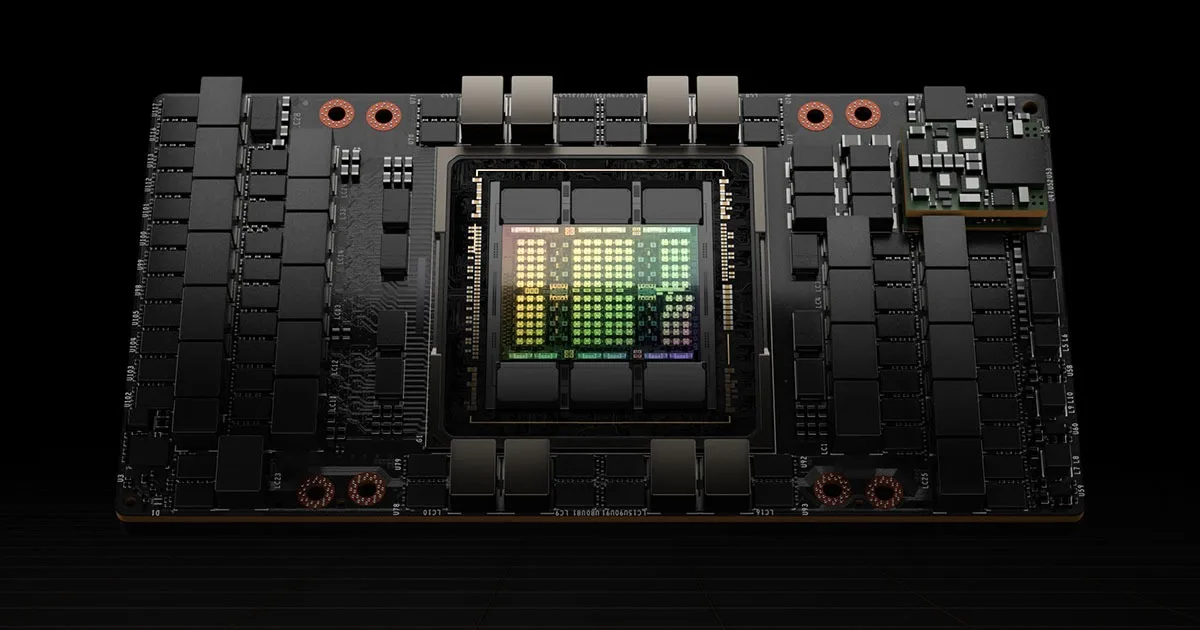
NVIDIA H200 (SXM)

141 GB HBM3e के साथ Hopper GPU

H200 में Hopper आर्किटेक्चर बरकरार है, लेकिन इसमें कहीं अधिक और तेज़ मेमोरी है, जो बड़े-मॉडल इन्फ़रेंस और मेमोरी-बाउंड HPC में मदद करती है। SXM संस्करण HGX सर्वरों में लगता है।

किसके लिए उपयुक्त: HGX सर्वरों पर बड़े लैंग्वेज मॉडल और HPC कोड चलाने वाली टीमें

लाभ

  • प्रति GPU 141 GB बड़े मॉडलों को बिना विभाजित किए समा लेता है
  • उच्च मेमोरी बैंडविड्थ मेमोरी-बाउंड कार्य को तेज़ करती है
  • H100 जैसा ही CUDA सॉफ़्टवेयर चलाता है

मुख्य विनिर्देश

आर्किटेक्चरNVIDIA Hopper
GPU मेमोरी141 GB HBM3e
फ़ॉर्म फ़ैक्टरSXM (HGX)
कूलिंगPassive (server airflow)

Workstation क्या करता है: हम H200 को प्रमाणित HGX सर्वर के अंदर उपलब्ध कराते हैं, बर्न-इन करते हैं और आपके ड्राइवर व सॉफ़्टवेयर स्टैक के साथ इंस्टॉल करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗
डेटा-सेंटर GPU

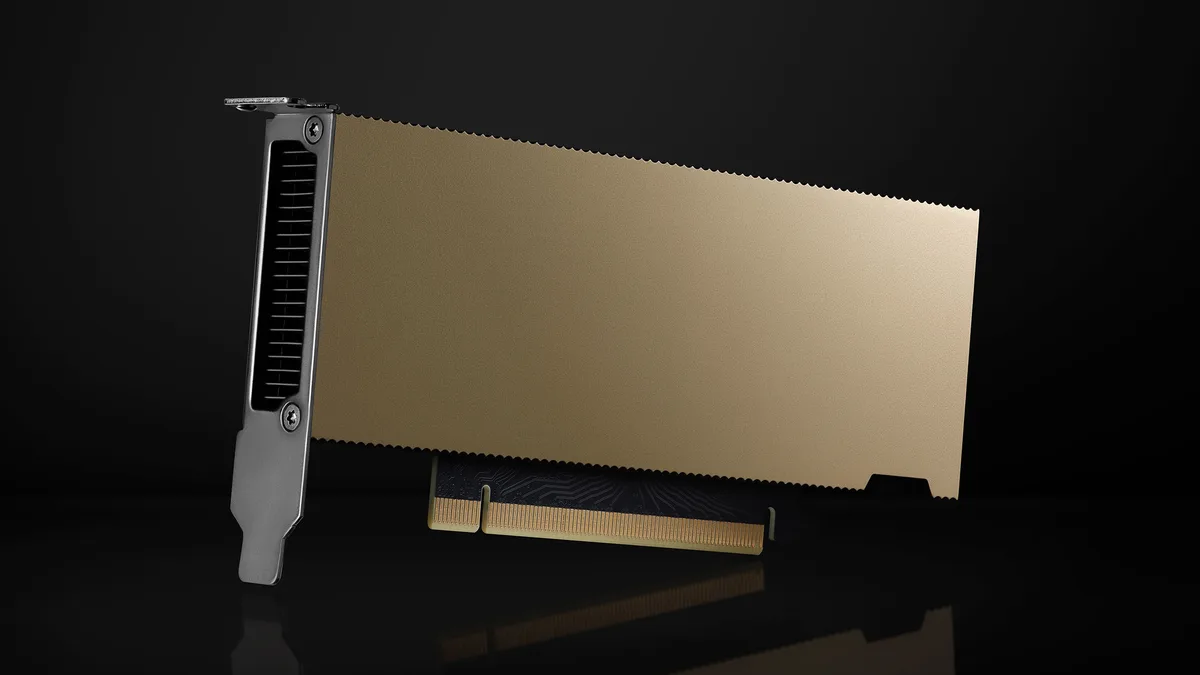
NVIDIA H200 NVL

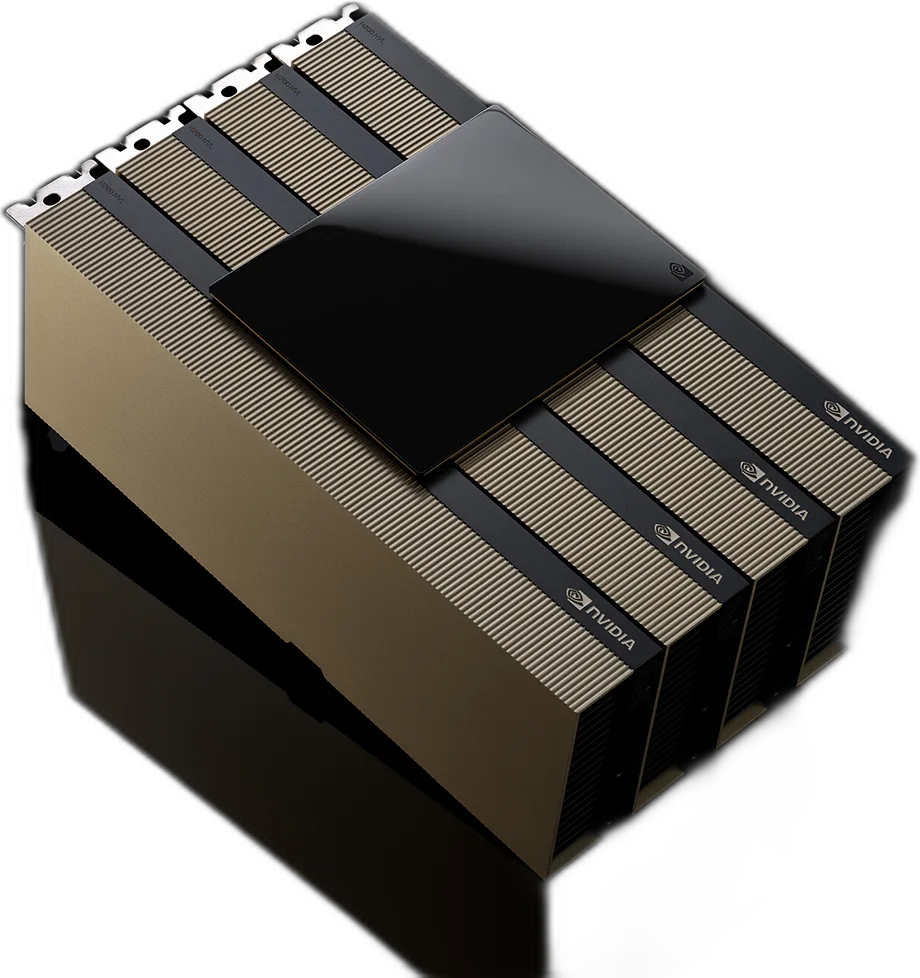
एयर-कूल्ड PCIe सर्वरों के लिए 141 GB Hopper GPU

मानक एंटरप्राइज़ रैक के लिए H200 का PCIe संस्करण। अधिक मेमोरी चाहने वाले मॉडलों के लिए NVLink ब्रिज कार्डों को जोड़ सकते हैं।

किसके लिए उपयुक्त: मौजूदा एयर-कूल्ड सर्वर रूम में बड़े-मॉडल इन्फ़रेंस जोड़ने वाले उद्यम

लाभ

  • लिक्विड कूलिंग अपनाए बिना बड़ी GPU मेमोरी
  • NVLink ब्रिज बड़े मॉडलों के लिए GPU को जोड़ते हैं
  • मुख्यधारा के NVIDIA-Certified सर्वरों में फ़िट होता है

मुख्य विनिर्देश

आर्किटेक्चरNVIDIA Hopper
GPU मेमोरी141 GB HBM3e
फ़ॉर्म फ़ैक्टरPCIe, dual slot
कूलिंगPassive (server airflow)

Workstation क्या करता है: हम बिजली, एयरफ़्लो और स्लॉट लेआउट के लिए आपके चेसिस की जाँच करते हैं, फिर कार्ड या पूर्ण सर्वर फ़िट, परीक्षण और डिलीवर करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

डेटा-सेंटर GPU

NVIDIA H100 PCIe 80 GB

PCIe सर्वरों में ट्रेनिंग और इन्फ़रेंस के लिए Hopper GPU

PCIe H100, Hopper के Transformer Engine और कॉन्फ़िडेंशियल कंप्यूटिंग को मानक सर्वरों तक लाता है।

किसके लिए उपयुक्त: मौजूदा PCIe GPU सर्वर वाली टीमें जिन्हें सिद्ध Hopper प्रदर्शन चाहिए

लाभ

  • Transformer Engine लैंग्वेज मॉडलों की ट्रेनिंग और इन्फ़रेंस को तेज़ करता है
  • Multi-Instance GPU एक कार्ड को अलग-अलग पृथक इंस्टेंस में बाँटता है
  • कॉन्फ़िडेंशियल कंप्यूटिंग के लिए हार्डवेयर सपोर्ट

मुख्य विनिर्देश

आर्किटेक्चरNVIDIA Hopper
GPU मेमोरी80 GB HBM2e
फ़ॉर्म फ़ैक्टरDual-slot, full height, full length
कूलिंगPassive (server airflow)
इंटरफ़ेसPCIe

Workstation क्या करता है: हम H100 को उन सर्वरों में फ़िट करते हैं जिनके लिए यह प्रमाणित है, बर्न-इन करते हैं और CUDA, ड्राइवर तथा कोई भी vGPU या AI Enterprise लाइसेंस सेट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

डेटा-सेंटर GPU

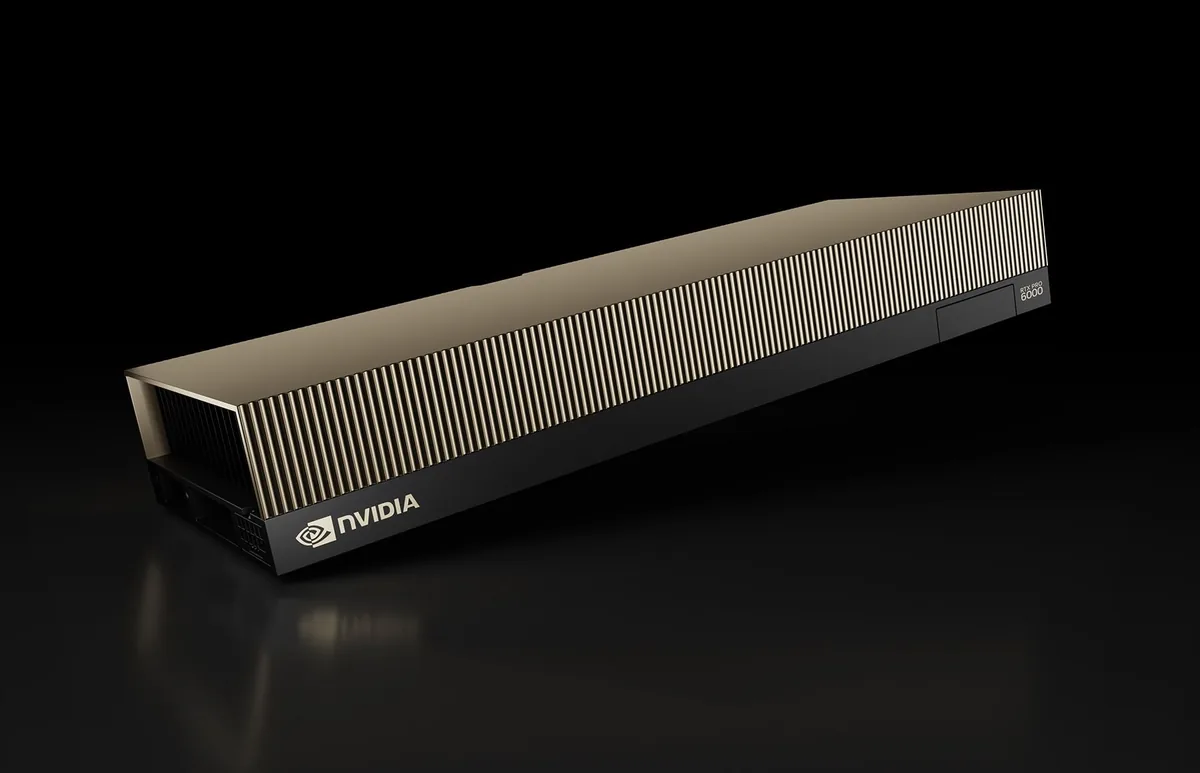
NVIDIA RTX PRO 6000 Blackwell Server Edition

रैक सर्वरों के लिए 96 GB Blackwell GPU

डेटा सेंटर में AI इन्फ़रेंस, रेंडरिंग, सिमुलेशन और वर्चुअल वर्कस्टेशन के लिए 96 GB मेमोरी वाला पैसिव-कूल्ड Blackwell कार्ड।

किसके लिए उपयुक्त: AI और ग्राफ़िक्स वर्कलोड को एक GPU प्रकार पर समेकित करने वाले उद्यम

लाभ

  • प्रति GPU 96 GB बड़े मॉडल और बड़े दृश्यों को संभालता है
  • AI और प्रोफ़ेशनल ग्राफ़िक्स दोनों चलाता है
  • सर्वर के अनुरूप कॉन्फ़िगर करने योग्य पावर

मुख्य विनिर्देश

आर्किटेक्चरNVIDIA Blackwell
GPU मेमोरी96 GB GDDR7 with ECC
अधिकतम पावरUp to 600 W (configurable)
इंटरफ़ेसPCIe 5.0 x16
फ़ॉर्म फ़ैक्टरDual-slot, passive (server airflow)

Workstation क्या करता है: हम कार्ड अलग से या RTX PRO Server में उपलब्ध कराते हैं, और डिलीवरी से पहले पूरे लोड पर उनका परीक्षण करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

डेटा-सेंटर GPU

NVIDIA RTX PRO 4500 Blackwell Server Edition

घने सर्वरों के लिए सिंगल-स्लॉट Blackwell GPU

एक कॉम्पैक्ट, पैसिव-कूल्ड 32 GB Blackwell GPU जिससे आप इन्फ़रेंस, वीडियो और वर्चुअल डेस्कटॉप के लिए एक सर्वर में कई कार्ड लगा सकते हैं।

किसके लिए उपयुक्त: कम प्रति-GPU लागत पर कई उपयोगकर्ताओं तक इन्फ़रेंस या वर्चुअल डेस्कटॉप स्केल करने वाली टीमें

लाभ

  • सिंगल-स्लॉट डिज़ाइन प्रति सर्वर अधिक GPU समा लेता है
  • मध्यम आकार के मॉडलों के लिए 32 GB GDDR7
  • कम बिजली खपत मौजूदा रैक के लिए उपयुक्त

मुख्य विनिर्देश

आर्किटेक्चरNVIDIA Blackwell
GPU मेमोरी32 GB GDDR7
फ़ॉर्म फ़ैक्टरSingle slot, 4.4" H × 10.5" L
कूलिंगPassive (server airflow)

Workstation क्या करता है: हम हिसाब लगाते हैं कि आपके सर्वर कितने कार्डों को बिजली और कूलिंग दे सकते हैं, फिर कॉन्फ़िगरेशन बनाते और परखते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

डेटा-सेंटर GPU

NVIDIA L40S

AI और ग्राफ़िक्स के लिए 48 GB ऑल-राउंडर

इन्फ़रेंस, फ़ाइन-ट्यूनिंग और 3D ग्राफ़िक्स के लिए संतुलित Ada Lovelace डेटा-सेंटर GPU, और NVIDIA के OVX डिज़ाइन के अंदर का GPU।

किसके लिए उपयुक्त: AI और विज़ुअल दोनों वर्कलोड के लिए एक GPU चाहने वाली टीमें

लाभ

  • अपनी लागत के हिसाब से मज़बूत इन्फ़रेंस और फ़ाइन-ट्यूनिंग प्रदर्शन
  • रेंडरिंग और Omniverse के लिए हार्डवेयर रे ट्रेसिंग
  • मुख्यधारा सर्वरों के लिए मानक PCIe कार्ड

मुख्य विनिर्देश

आर्किटेक्चरNVIDIA Ada Lovelace
GPU मेमोरी48 GB GDDR6 with ECC
फ़ॉर्म फ़ैक्टरDual-slot, 4.4" H × 10.5" L
कूलिंगPassive (server airflow)
इंटरफ़ेसPCIe

Workstation क्या करता है: हम L40S को प्रमाणित सर्वरों से मिलाते हैं, बिल्ड का बर्न-इन करते हैं और ड्राइवर व लाइसेंसिंग सेट करके इंस्टॉल करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

डेटा-सेंटर GPU

NVIDIA L40

रेंडरिंग और वर्चुअल वर्कस्टेशन के लिए 48 GB GPU

L40 ग्राफ़िक्स पर केंद्रित है: डेटा सेंटर में रेंडरिंग, Omniverse और वर्चुअल वर्कस्टेशन।

किसके लिए उपयुक्त: वर्कस्टेशन को डेटा सेंटर में ले जा रही डिज़ाइन और मीडिया टीमें

लाभ

  • बड़े दृश्यों और एसेट के लिए 48 GB
  • NVIDIA वर्चुअल GPU सॉफ़्टवेयर का समर्थन करता है
  • मानक सर्वरों के लिए पैसिव कूलिंग

मुख्य विनिर्देश

आर्किटेक्चरNVIDIA Ada Lovelace
GPU मेमोरी48 GB GDDR6 with ECC
फ़ॉर्म फ़ैक्टरDual-slot, 4.4" H × 10.5" L
कूलिंगPassive (server airflow)
इंटरफ़ेसPCIe

Workstation क्या करता है: हम vGPU प्रोफ़ाइल और लाइसेंस सेट करते हैं ताकि आपके उपयोगकर्ताओं को ऐसे रिमोट वर्कस्टेशन मिलें जो लोकल जैसे लगें।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

डेटा-सेंटर GPU

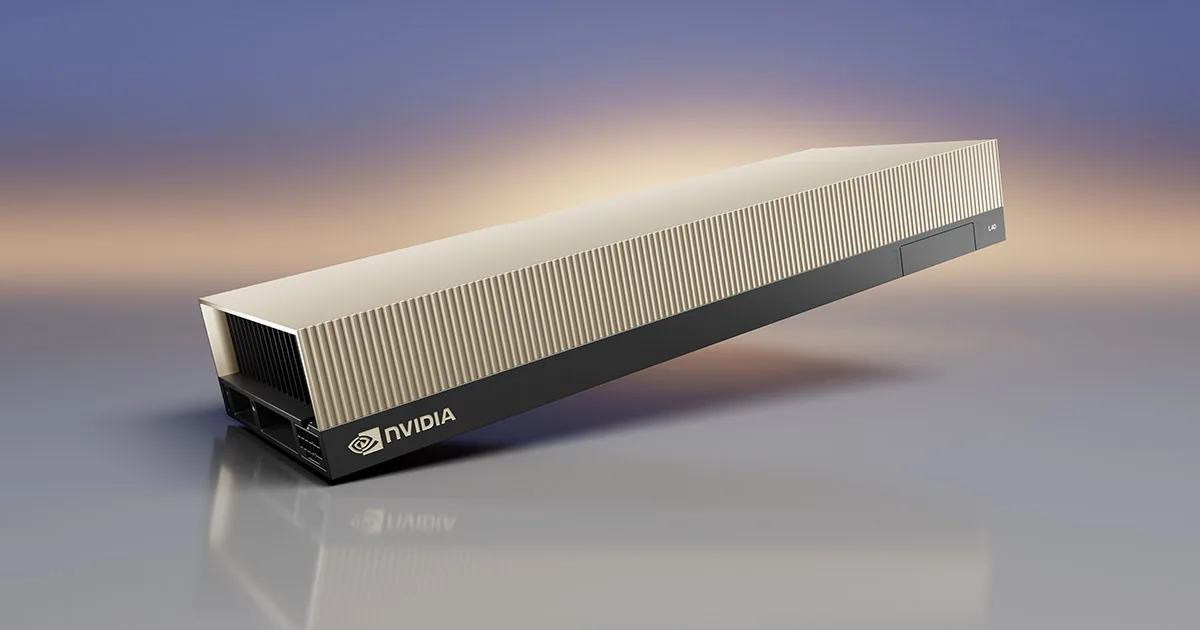
NVIDIA L4

कुशल इन्फ़रेंस और वीडियो के लिए लो-प्रोफ़ाइल GPU

वीडियो AI, इन्फ़रेंस और वर्चुअल डेस्कटॉप के लिए छोटा, कम बिजली वाला Ada Lovelace कार्ड, एज से लेकर डेटा सेंटर तक।

किसके लिए उपयुक्त: कई सर्वरों में, या सीमित बिजली बजट वाली एज साइटों पर AI जोड़ने वाले संगठन

लाभ

  • कम बिजली और लो-प्रोफ़ाइल कार्ड लगभग किसी भी सर्वर में फ़िट होता है
  • वीडियो एनालिटिक्स और इन्फ़रेंस के लिए अत्यंत उपयुक्त
  • कई नोड्स में किफ़ायती ढंग से स्केल-आउट करता है

मुख्य विनिर्देश

आर्किटेक्चरNVIDIA Ada Lovelace
GPU मेमोरी24 GB GDDR6
फ़ॉर्म फ़ैक्टरSingle-slot, low profile
कूलिंगPassive (server airflow)
इंटरफ़ेसPCIe

Workstation क्या करता है: हम आपके मौजूदा सर्वरों के साथ संगतता जाँचते हैं, कार्ड उपलब्ध कराते हैं और ड्राइवर व इन्फ़रेंस सॉफ़्टवेयर सेट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

नेटवर्किंग

NVIDIA Spectrum-X Ethernet प्लेटफ़ॉर्म

AI फ़ैक्टरी के लिए ट्यून किया गया Ethernet

Spectrum-X, Spectrum Ethernet स्विच को Spectrum-X SuperNIC के साथ जोड़कर AI क्लस्टरों को पूर्वानुमेय, हाई-थ्रूपुट Ethernet देता है।

किसके लिए उपयुक्त: ऐसे संगठन जो ऐसा AI फ़ैब्रिक चाहते हैं जिसे उनकी नेटवर्क टीम पहले से चलाना जानती है

लाभ

  • मानक Ethernet की तुलना में GPU-से-GPU ट्रैफ़िक के लिए अधिक प्रभावी बैंडविड्थ
  • परिचित Ethernet टूल और कौशल का उपयोग करता है
  • NVIDIA के मान्य AI फ़ैक्टरी डिज़ाइनों का हिस्सा

मुख्य विनिर्देश

प्रकारEthernet networking platform
घटकNVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
उपयोग का उदाहरणAI clusters and AI factories

Workstation क्या करता है: हम फ़ैब्रिक डिज़ाइन करते हैं, स्विच, SuperNIC और केबल उपलब्ध कराते हैं, उसे इंस्टॉल व परीक्षण करते हैं और आपकी टीम के लिए दस्तावेज़ तैयार करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

नेटवर्किंग

NVIDIA Quantum-X800 InfiniBand प्लेटफ़ॉर्म

बड़े पैमाने की ट्रेनिंग के लिए अगली पीढ़ी का InfiniBand

Quantum-X800 स्विच और ConnectX-8 SuperNIC मिलकर AI ट्रेनिंग और HPC के लिए NVIDIA का सबसे उच्च-प्रदर्शन InfiniBand फ़ैब्रिक बनाते हैं।

किसके लिए उपयुक्त: HPC केंद्र और बड़े पैमाने पर ट्रेनिंग करने वाली AI टीमें

लाभ

  • सघन रूप से जुड़े जॉब के लिए बहुत कम लेटेंसी
  • सबसे बड़े ट्रेनिंग और HPC क्लस्टरों के लिए डिज़ाइन किया गया
  • UFM के साथ प्रबंधित और मॉनिटर किया जाता है

मुख्य विनिर्देश

प्रकारInfiniBand networking platform
घटकNVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
उपयोग का उदाहरणLarge-scale AI training and HPC

Workstation क्या करता है: हम टोपोलॉजी डिज़ाइन करते हैं, हर लिंक उपलब्ध कराकर केबल करते हैं, और UFM मॉनिटरिंग के साथ फ़ैब्रिक चालू करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

नेटवर्किंग

NVIDIA Spectrum Ethernet स्विच

800 Gb/s तक के डेटा-सेंटर Ethernet स्विच

Spectrum स्विच AI, स्टोरेज और क्लाउड ट्रैफ़िक ले जाते हैं — स्वतंत्र रूप से या Spectrum-X के हिस्से के रूप में।

किसके लिए उपयुक्त: लीफ़ और स्पाइन स्विचिंग को अपग्रेड कर रही डेटा-सेंटर और नेटवर्क टीमें

लाभ

  • 800 Gb/s तक की पोर्ट स्पीड
  • AI फ़ैब्रिक और सामान्य डेटा-सेंटर नेटवर्क दोनों में काम करता है
  • नेटवर्क संचालन और टेलीमेट्री के लिए NetQ के साथ जुड़ता है

मुख्य विनिर्देश

प्रकारEthernet switch family
पोर्ट स्पीडUp to 800 Gb/s
उपयोगAI and cloud data-centre fabrics

Workstation क्या करता है: हम पोर्ट और ऑप्टिक्स का आकार तय करते हैं, स्विच कॉन्फ़िगर करते हैं और उन्हें आपके मौजूदा नेटवर्क के साथ एकीकृत करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

नेटवर्किंग

NVIDIA Quantum InfiniBand स्विच

HPC और AI के लिए लो-लेटेंसी स्विचिंग

Quantum InfiniBand स्विच वे लो-लेटेंसी फ़ैब्रिक बनाते हैं जिन पर HPC और AI क्लस्टर निर्भर करते हैं।

किसके लिए उपयुक्त: सघन रूप से जुड़े वर्कलोड वाली रिसर्च कंप्यूटिंग और AI टीमें

लाभ

  • नोड्स के बीच बहुत कम लेटेंसी
  • HPC और AI क्लस्टरों में सिद्ध
  • UFM के साथ केंद्रीय प्रबंधन

मुख्य विनिर्देश

प्रकारInfiniBand switch family
उपयोगHPC and AI data centres

Workstation क्या करता है: हम टोपोलॉजी की योजना बनाते हैं, केबल और ऑप्टिक्स उपलब्ध कराते हैं, और फ़ैब्रिक को इंस्टॉल व सत्यापित करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

नेटवर्किंग

NVIDIA ConnectX NIC और SuperNIC

Ethernet और InfiniBand के लिए नेटवर्क एडेप्टर

ConnectX एडेप्टर सर्वरों को फ़ैब्रिक से जोड़ते हैं। ConnectX-8 जैसे SuperNIC AI क्लस्टरों में GPU-से-GPU ट्रैफ़िक के लिए ट्यून किए गए हैं।

किसके लिए उपयुक्त: GPU सर्वर या स्टोरेज को हाई-स्पीड नेटवर्क से जोड़ने वाले सभी

लाभ

  • एक ही परिवार Ethernet और InfiniBand दोनों को कवर करता है
  • SuperNIC हर GPU को उसका अपना हाई-स्पीड मार्ग देते हैं
  • हार्डवेयर ऑफ़लोड CPU का भार कम करते हैं

मुख्य विनिर्देश

प्रकारNetwork adapter and SuperNIC family
फ़ैब्रिकEthernet and InfiniBand
अधिकतम गति800 Gb/s per GPU (ConnectX-8 SuperNIC)

Workstation क्या करता है: हम एडेप्टर, केबल और ट्रांसीवर को आपके स्विच और सर्वरों से मिलाते हैं, और फ़र्मवेयर व ड्राइवर इंस्टॉल करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

नेटवर्किंग

NVIDIA BlueField DPU

नेटवर्किंग, स्टोरेज और सुरक्षा के लिए डेटा प्रोसेसिंग यूनिट

BlueField DPU नेटवर्किंग, स्टोरेज और सुरक्षा का काम सर्वर CPU से हटाकर समर्पित हार्डवेयर में अलग रखते हैं।

किसके लिए उपयुक्त: क्लाउड निर्माता, AI फ़ैक्टरी और सुरक्षा के प्रति सजग संगठन

लाभ

  • एप्लिकेशन के लिए CPU कोर मुक्त करता है
  • इंफ्रास्ट्रक्चर सेवाओं को टेनेंट वर्कलोड से अलग रखता है
  • NVIDIA DOCA के साथ प्रोग्राम करने योग्य

मुख्य विनिर्देश

प्रकारData processing unit (DPU) family
पीढ़ियाँBlueField-3, BlueField-4
सॉफ़्टवेयरNVIDIA DOCA

Workstation क्या करता है: हम BlueField कार्ड उपलब्ध कराते और फ़िट करते हैं, और आपको ज़रूरी DOCA सेवाएँ तैनात करने में मदद करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

सॉफ़्टवेयर

NVIDIA AI Enterprise

प्रोडक्शन AI के लिए सपोर्टेड सॉफ़्टवेयर

NVIDIA का AI फ़्रेमवर्क, NIM माइक्रोसर्विस और टूल का सूट, एंटरप्राइज़ सपोर्ट और लंबे जीवनकाल वाली रिलीज़ ब्रांच के साथ।

किसके लिए उपयुक्त: NVIDIA GPU पर प्रोडक्शन में AI चलाने वाला कोई भी संगठन

लाभ

  • एंटरप्राइज़ सपोर्ट और स्थिर रिलीज़ ब्रांच
  • NIM माइक्रोसर्विस मॉडलों को जल्दी तैनात करना आसान बनाती हैं
  • ऑन-प्रिमाइसेस या क्लाउड में NVIDIA-Certified सिस्टम पर चलता है

मुख्य विनिर्देश

लाइसेंसिंगPer GPU subscription
शामिल हैAI frameworks, NIM microservices, pretrained models
सहायताNVIDIA Enterprise Business Standard Support
ट्रायल90-day evaluation

Workstation क्या करता है: हम लाइसेंस का कोटेशन देते और उन्हें सक्रिय करते हैं, आपके हार्डवेयर के साथ सॉफ़्टवेयर इंस्टॉल करते हैं और नवीनीकरण से पहले आपको याद दिलाते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

सॉफ़्टवेयर

NVIDIA Mission Control

AI फ़ैक्टरी के लिए संचालन सॉफ़्टवेयर

Mission Control बड़े GPU क्लस्टरों के दैनिक संचालन को स्वचालित करता है, वर्कलोड ऑर्केस्ट्रेशन से लेकर हेल्थ चेक और रिकवरी तक।

किसके लिए उपयुक्त: DGX SuperPOD और अन्य बड़े AI क्लस्टरों के ऑपरेटर

लाभ

  • नियमित क्लस्टर संचालन को स्वचालित करता है
  • खराबियों का पता लगाकर और उनसे उबरकर लचीलापन बढ़ाता है
  • वर्कलोड और इंफ्रास्ट्रक्चर का एक समग्र दृश्य

मुख्य विनिर्देश

प्रकारAI-factory operations and cluster management software
कार्यWorkload orchestration, infrastructure resiliency, cluster automation
लाइसेंस आधारConfirmed on quote

Workstation क्या करता है: हम आपके क्लस्टर के साथ Mission Control तैनात करते हैं और आपके ऑपरेटरों को इसके उपयोग का प्रशिक्षण देते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

सॉफ़्टवेयर

NVIDIA Run:ai

GPU ऑर्केस्ट्रेशन और शेड्यूलिंग

Run:ai टीमों के बीच GPU को पूल करता है और माँग पर आवंटित करता है, ताकि महँगा हार्डवेयर निष्क्रिय रहने के बजाय व्यस्त रहे।

किसके लिए उपयुक्त: कई डेटा वैज्ञानिकों या परियोजनाओं के बीच GPU साझा करने वाले संगठन

लाभ

  • डायनेमिक पूलिंग से अधिक GPU उपयोग
  • निष्पक्ष साझेदारी के लिए कोटा, प्राथमिकताएँ और एक्सेस नियंत्रण
  • ऑन-प्रिमाइसेस, हाइब्रिड और क्लाउड वातावरणों में काम करता है

मुख्य विनिर्देश

प्रकारGPU orchestration and scheduling platform
इस पर चलता हैKubernetes
तैनातीOn premises, hybrid or cloud
लाइसेंस आधारConfirmed on quote

Workstation क्या करता है: हम आपके Kubernetes क्लस्टर पर Run:ai इंस्टॉल करते हैं, आपकी टीमों के साथ कोटा सेट करते हैं और इसे सपोर्ट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

सॉफ़्टवेयर

NVIDIA Base Command Manager

क्लस्टर प्रोविज़निंग और मॉनिटरिंग

Base Command Manager कुछ नोड्स से लेकर उससे बड़े GPU क्लस्टरों तक की प्रोविज़निंग, मॉनिटरिंग और प्रबंधन करता है।

किसके लिए उपयुक्त: किसी भी आकार के GPU क्लस्टर चलाने वाली IT टीमें

लाभ

  • Arm और x86 पर प्रोविज़निंग को स्वचालित करता है
  • हेल्थ डैशबोर्ड और रियल-टाइम मॉनिटरिंग
  • वेब इंटरफ़ेस, कमांड लाइन और API

मुख्य विनिर्देश

प्रकारCluster management software
मुफ़्त लाइसेंसUp to 8 accelerators per system
वर्तमान रिलीज़Base Command Manager 11
इंटरफ़ेसBaseView web UI, CLI, API

Workstation क्या करता है: हम अपने बनाए क्लस्टरों के हिस्से के रूप में Base Command Manager इंस्टॉल और कॉन्फ़िगर करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

सॉफ़्टवेयर

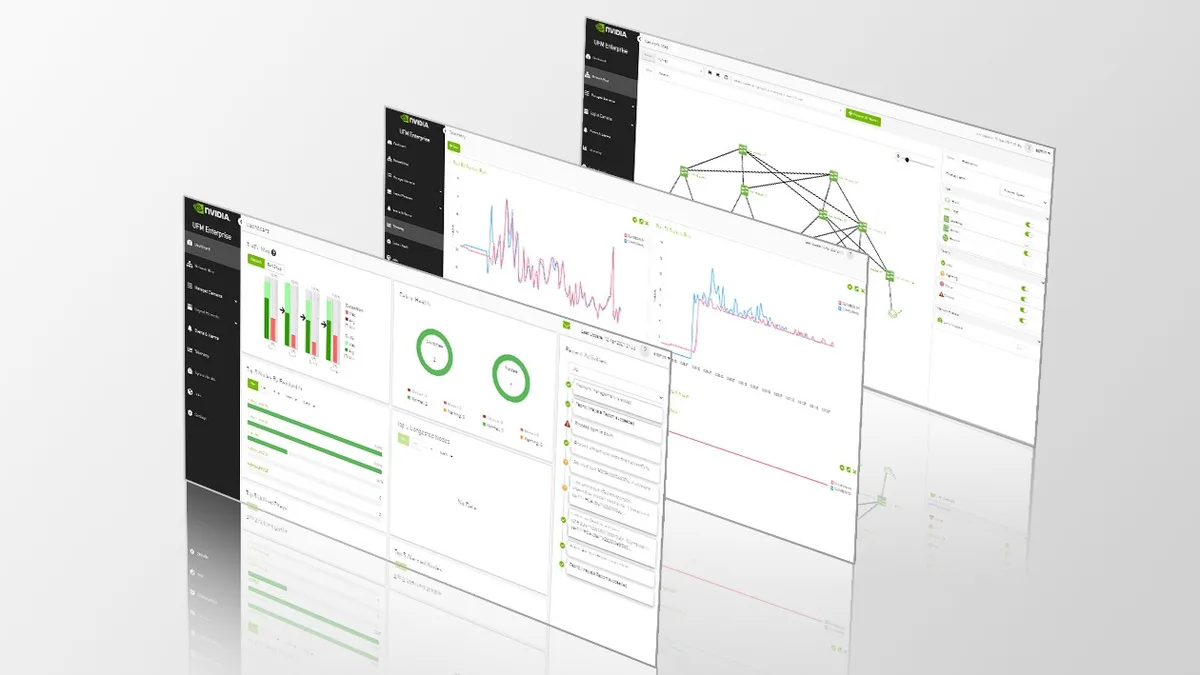
NVIDIA UFM

InfiniBand के लिए Unified Fabric Manager

UFM, InfiniBand फ़ैब्रिक की मॉनिटरिंग, प्रबंधन और समस्या-निवारण में मदद करता है।

किसके लिए उपयुक्त: InfiniBand क्लस्टर चलाने वाली टीमें

लाभ

  • रियल-टाइम फ़ैब्रिक टेलीमेट्री
  • तेज़ी से खराबी का पता लगाना
  • स्विच और लिंक का केंद्रीय प्रबंधन

मुख्य विनिर्देश

प्रकारInfiniBand fabric management and telemetry software
इसके साथ काम करता हैNVIDIA Quantum InfiniBand switches

Workstation क्या करता है: हम आपके फ़ैब्रिक के साथ UFM तैनात करते हैं और आपकी संचालन प्रक्रियाओं से मेल खाने वाले अलर्ट सेट करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

सॉफ़्टवेयर

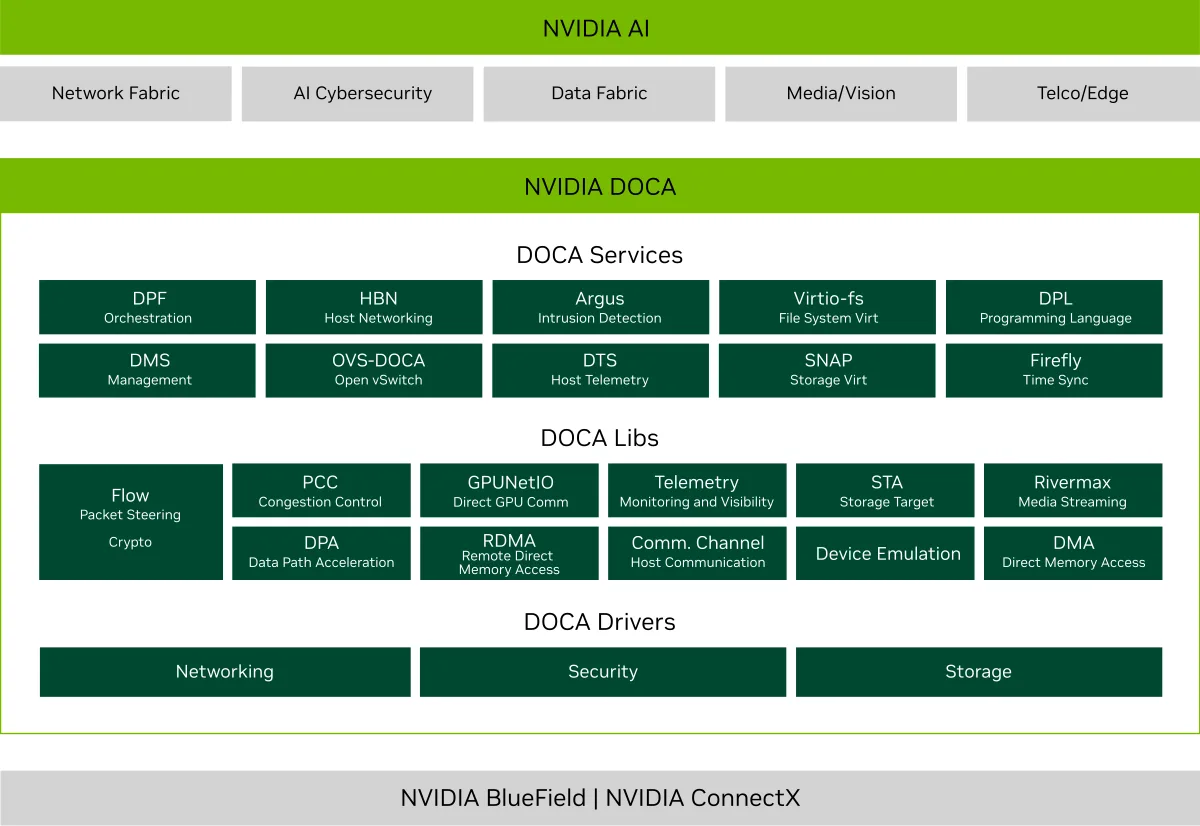
NVIDIA DOCA

BlueField और SuperNIC के लिए सॉफ़्टवेयर फ़्रेमवर्क

DOCA, BlueField DPU और SuperNIC पर चलने वाली सेवाएँ बनाने के लिए SDK और रनटाइम है।

किसके लिए उपयुक्त: BlueField पर निर्माण करने वाले डेवलपर और प्लेटफ़ॉर्म टीमें

लाभ

  • DPU और SuperNIC की सभी पीढ़ियों में एक ही फ़्रेमवर्क
  • ऑफ़लोड की गई सेवाओं के विकास को तेज़ करता है
  • उन सेवाओं को प्रोडक्शन में तैनात करने के लिए रनटाइम

मुख्य विनिर्देश

प्रकारSDK and runtime framework
इस पर चलता हैNVIDIA BlueField DPUs and SuperNICs

Workstation क्या करता है: हम DOCA वातावरण सेट करने और हमारे द्वारा उपलब्ध कराए गए BlueField कार्डों पर सेवाएँ तैनात करने में मदद करते हैं।

कीमत कोटेशन परकोटेशन का अनुरोध करें ↗
NVIDIA.com पर देखें ↗

विनिर्देश NVIDIA की प्रकाशित जानकारी से संक्षेप में लिए गए हैं और संशोधनों के बीच बदल सकते हैं। स्पार्स चिह्नित आंकड़े स्पार्सिटी मानकर दिए गए हैं। हम हर कोटेशन पर सटीक कॉन्फ़िगरेशन, कीमत और डिलीवरी समय की पुष्टि करते हैं।

हर ऑर्डर पर Workstation क्या करता है

वही पाँच चरण, चाहे आप एक GPU ख़रीदें या रैक की पूरी कतार

आकलन

हम आपके मॉडल, डेटा, उपयोगकर्ता और साइट से शुरू करते हैं, फिर कंप्यूट, मेमोरी, नेटवर्क, बिजली और कूलिंग का आकार तय करते हैं।

आपूर्ति

हम NVIDIA और उसके सर्वर पार्टनरों के माध्यम से सामग्री प्राप्त करते हैं, डिलीवरी समय की पुष्टि करते हैं और डिलीवरी तक आपको अपडेट रखते हैं।

निर्माण और बर्न-इन

शिप होने से पहले सिस्टम हमारी UK वर्कशॉप में असेंबल, इमेज और पूरे लोड पर स्ट्रेस टेस्ट किए जाते हैं।

इंस्टॉलेशन

हमारे इंजीनियर साइट पर डिलीवर, रैक, केबल और कमीशन करते हैं, फिर दस्तावेज़ों के साथ सौंपते हैं।

सहायता

वही टीम सॉफ़्टवेयर समस्याएँ, अपग्रेड, लाइसेंस नवीनीकरण और वारंटी दावे संभालती है।

सभी NVIDIA श्रेणियाँ

ट्रेड सदस्यता

ट्रेड सदस्यों को हर ऑर्डर पर मुफ़्त तकनीकी सहायता और असीमित इंजीनियर समय मिलता है — कॉन्फ़िगरेशन, ड्राइवर, सॉफ़्टवेयर और समस्या-निवारण में मदद, जब तक उपकरण आपके पास है।

ट्रेड सदस्यता देखें

NVIDIA Blackwell, चिप से डेटा सेंटर तक

NVIDIA Blackwell: The Journey From Die to Data Center. NVIDIA के आधिकारिक YouTube चैनल से चलाया गया। YouTube पर देखेंNVIDIA, Blackwell, DGX, Grace और RTX PRO, NVIDIA Corporation के ट्रेडमार्क और/या पंजीकृत ट्रेडमार्क हैं। इन्हें हमारे द्वारा दिए जाने वाले उत्पादों का वर्णन करने के लिए दिखाया गया है; इससे NVIDIA का कोई समर्थन नहीं दर्शाया जाता।

See the NVIDIA RTX PRO 6000 Blackwell Server Edition

NVIDIA RTX PRO: AI and visual computing on the RTX PRO 6000 Blackwell Server Edition. Video: NVIDIA Corporation. NVIDIA के आधिकारिक YouTube चैनल से चलाया गया। YouTube पर देखेंRead about the RTX PRO 6000 Server Edition →NVIDIA, RTX PRO and Blackwell are trademarks and/or registered trademarks of NVIDIA Corporation. Shown to describe the products we supply; no endorsement by NVIDIA is implied.

अक्सर पूछे जाने वाले प्रश्न

सब कुछ कोटेशन पर ही क्यों दिया जाता है?

एक्सेलरेटेड कंप्यूटिंग की कीमतें और आवंटन तेज़ी से बदलते हैं, और अधिकांश ऑर्डर सटीक कॉन्फ़िगरेशन, साइट और सॉफ़्टवेयर पर निर्भर करते हैं। कोटेशन से हम आपकी वास्तविक ज़रूरत के लिए वर्तमान कीमत, उपलब्धता और डिलीवरी समय की पुष्टि कर पाते हैं।

क्या आप पूरे सिस्टम के बजाय एक GPU उपलब्ध करा सकते हैं?

हाँ। हम अलग-अलग डेटा-सेंटर GPU उपलब्ध कराते हैं, लेकिन हम हमेशा जाँचते हैं कि आपका सर्वर उन्हें बिजली और कूलिंग देने के लिए प्रमाणित है, और हम आपके लिए उन्हें फ़िट और परीक्षण भी कर सकते हैं।

क्या आप रैक-स्केल और लिक्विड-कूल्ड सिस्टम इंस्टॉल करते हैं?

हाँ। GB300 NVL72 जैसे सिस्टम के लिए हम डिलीवरी से काफ़ी पहले बिजली, कूलिंग और फ़्लोर लोडिंग पर आपकी फ़ैसिलिटी टीम के साथ काम करते हैं, फिर साइट पर इंस्टॉल और कमीशन करते हैं।

हमें किस NVIDIA प्लेटफ़ॉर्म से शुरुआत करनी चाहिए?

यह आपके मॉडल, उपयोगकर्ताओं और साइट पर निर्भर करता है। कई टीमें मिश्रित AI और ग्राफ़िक्स के लिए RTX PRO Server या L40S से शुरुआत करती हैं, और बड़े पैमाने की ट्रेनिंग के लिए HGX या DGX पर जाती हैं। किसी इंजीनियर से बात करें और हम एक शुरुआती विकल्प सुझाएँगे।

अपनी NVIDIA एक्सेलरेटेड कंप्यूटिंग परियोजना की योजना बनाएँ

हमें बताएँ कि आपको क्या चलाना है और इसे कहाँ रखा जाना है। एक इंजीनियर अनुशंसित कॉन्फ़िगरेशन और कोटेशन के साथ आपसे संपर्क करेगा।

किसी इंजीनियर से बात करें