Workstation तकनीकी संक्षिप्त: LLM सेवा और एजेंटों को टर्बोचार्ज कैसे करें PagedAttention, vLLM, Self-Debugging, PowerInfer, और EG-MLA. साथी: ब्लॉग · प्राइमर: Kubernetes लेख पर LLMs · प्रयोगशाला: एंटरप्राइज एआई लैब.
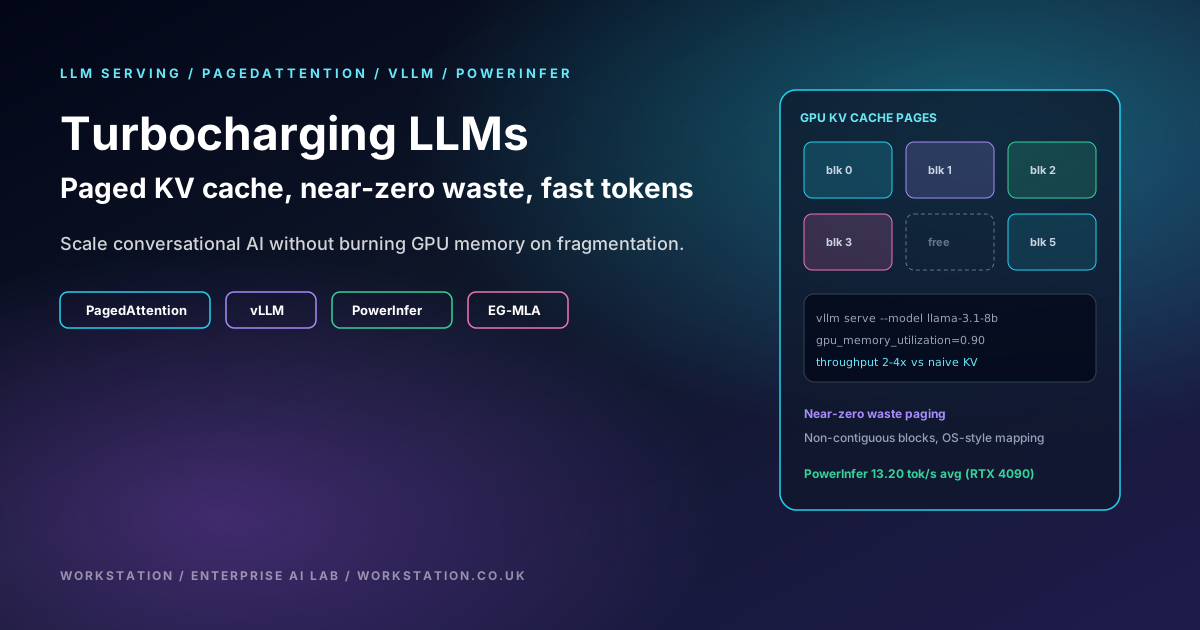
- अड़चन: केवी कैश वृद्धि और विखंडन, सार में "मॉडल धीमा है" नहीं।
- PagedAttention: केवी ब्लॉकों की ओएस-शैली पेजिंग; ब्लॉक आकार और कैश पदानुक्रम को ट्यून करें।
- vLLM: लगभग-शून्य केवी अपशिष्ट + निरंतर बैचिंग के साथ सर्विंग इंजन; टीटीएफटी बनाम टोकन देखें।
- Self-Debugging: कुछ-शॉट कार्यक्रम की मरम्मत विशाल उम्मीदवार सेटों को मात देती है; उत्पाद में कैप राउंड.
- PowerInfer: गर्म/ठंडा विभाजन; RTX 4090 पर 13.20 tok/s औसत / 29.08 शिखर (पेपर/रेपो आंकड़े)।
- EG-MLA: वास्तुकला-स्तर केवी संपीड़न (~91.6% बनाम एमएचए); स्वैप से पहले पुनः मूल्यांकन करें।
1. प्रशिक्षण नहीं, सेवा करना ही संकट क्यों है?
बड़े भाषा मॉडल ने एनएलपी को बदल दिया: चैट, पीढ़ी, उपकरण। प्रशिक्षण एक बार महंगा है; सेवा करना हर सेकंड महंगा है। डिकोड स्वत: प्रतिगामी है। प्रत्येक नए टोकन को पिछली कुंजियों और मानों की आवश्यकता होती है। उस केवी कैश के लिए मेमोरी लेयर्स × हेड्स × हिडन × सीक्वेंस × बैच के समानुपाती होती है। प्रीफ़िल गणना-भारी है; डिकोड मेमोरी-बैंडविड्थ-भारी है। यदि आप प्रति अनुरोध एक सन्निहित अधिकतम-लंबाई केवी टेंसर आवंटित करते हैं, तो इसका अधिकांश भाग तब तक खाली रहता है जब तक कि अनुक्रम वास्तव में नहीं बढ़ता - क्लासिक आंतरिक विखंडन। समवर्ती अनुरोध उन छिद्रों को चुरा नहीं सकते। बैच का आकार घट गया। प्रति सेकंड टोकन गिरता है। GPUs व्यस्त और अभी भी निष्क्रिय दिखते हैं।
यही वह समस्या है जिस पर 2023 में PagedAttention और vLLM ने हमला किया था, और समस्या PowerInfer और बाद के ध्यान वेरिएंट अभी भी विभिन्न कोणों से हमला करते हैं।
देखें: LLM मानसिक मॉडल
प्रसंग वीडियो: बड़े भाषा मॉडल का परिचय. Workstation व्याख्याता: LLMs कैसे काम करते हैं और उन्हें कुबेरनेट्स पर कैसे चलाना है.
2. PagedAttention: KV कैश के लिए पेजिंग
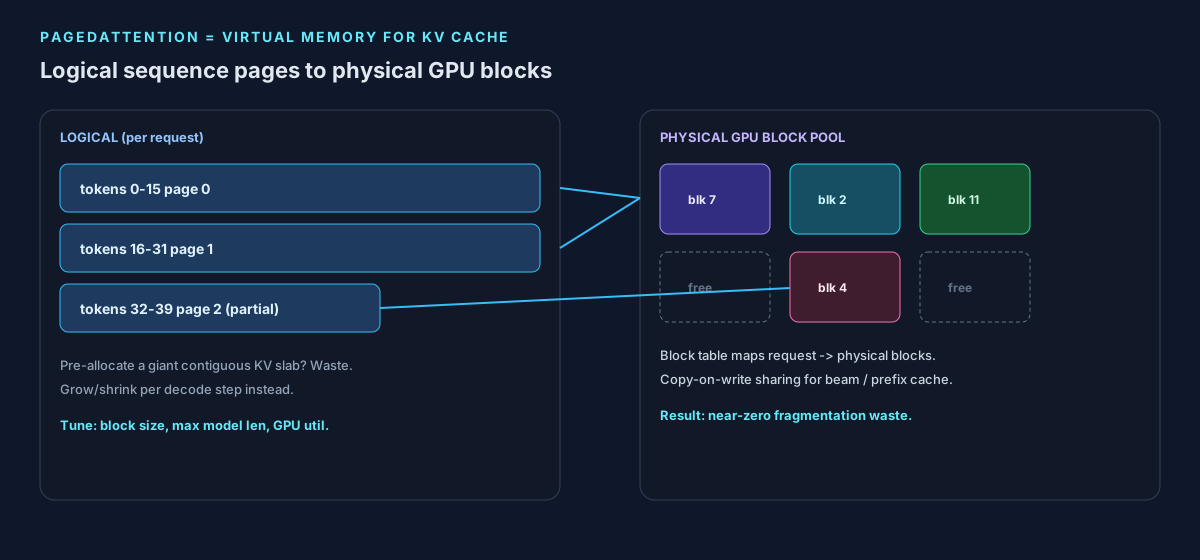
क्वोन, ली, ज़ुआंग, शेंग, झेंग, यू, गोंजालेज, झांग और स्टोइका ने वर्चुअल मेमोरी और ओएस पेजिंग से प्रेरित एक ध्यान एल्गोरिथ्म के रूप में PagedAttention पेश किया, और इसके शीर्ष पर vLLM बनाया। [arXiv:2309.06180]. विचार:
- केवी को विभाजित करें निश्चित आकार के ब्लॉक (प्रति ब्लॉक टोकन की एक छोटी संख्या)।
- एक रखें ब्लॉक टेबल तार्किक टोकन स्थिति से लेकर भौतिक GPU ब्लॉक (संभवतः गैर-सन्निहित) तक।
- अनुक्रम बढ़ने या समाप्त होने पर ब्लॉक आवंटित/मुक्त करें - पृष्ठ आवंटन की तरह, एक विशाल सरणी के मॉलोक की तरह नहीं।
- उपसर्ग के पुन: उपयोग, बीम खोज और समानांतर नमूने के लिए ब्लॉक साझा करें (कॉपी-ऑन-राइट) ताकि आप समान उपसर्गों की नकल न करें।
कार्यान्वयन "बीईआरटी पर झंडा लगाना" नहीं है। ध्यान कर्नेल को बिखरे हुए ब्लॉकों को इकट्ठा करना होगा। शेड्यूलर को पता होना चाहिए कि कौन से ब्लॉक मुफ़्त हैं। कैश पदानुक्रम मायने रखता है: HBM-निवासी ब्लॉक बनाम CPU ऑफलोड बनाम NVLink सहकर्मी। बफ़र (ब्लॉक) का आकार एक वास्तविक घुंडी है। बहुत छोटा: अधिक टेबल लुकअप और कर्नेल ओवरहेड। बहुत बड़ा: अंतिम आंशिक ब्लॉक के अंदर व्यर्थ स्लॉट। ब्लॉक आकार को इसके साथ जोड़ें max_model_len और आपके ट्रैफ़िक का वास्तविक शीघ्र/समापन मिश्रण।
अभ्यास: प्रोफ़ाइल विखंडन (अप्रयुक्त केवी बाइट्स / आरक्षित केवी बाइट्स) और टोकन एक साथ। थ्रूपुट के बिना मेमोरी ग्राफ व्यर्थ हैं।
3. vLLM: पेजर के चारों ओर सेवा प्रणाली
vLLM का दावा KV कैश मेमोरी में लगभग शून्य बर्बादी और अनुरोधों के भीतर और पार लचीला साझाकरण है। पेपर में मूल्यांकन मोटे तौर पर दिखाया गया 2-4× थ्रूपुट बनाम तत्कालीन-SOTA सिस्टम (फास्टरट्रांसफॉर्मर, ओर्का) समान विलंबता पर, लंबे अनुक्रमों और शानदार डिकोडिंग पर बड़े लाभ के साथ। आज इंजन मल्टी-GPU के लिए निरंतर बैचिंग, चंक्ड प्रीफिल, प्रीफ़िक्स कैशिंग और टेंसर/पाइपलाइन समानांतर भी शिप करता है।
परिचालन जांच सूची:
- तय करना
gpu_memory_utilizationवज़न रखने के लिए पर्याप्त ऊँचा + KV, CUDA कार्यक्षेत्र छोड़ने के लिए पर्याप्त कम। - eval स्कोर और p95 TTFT की पुष्टि करने के बाद ही प्रीफ़िक्स कैशिंग सक्षम करें आपका संकेत.
- यदि मिश्रित ट्रैफ़िक SLO (अलग-अलग सर्विंग) को नष्ट कर देता है, तो प्रीफ़िल-हैवी और डिकोड-हैवी पूल को अलग करें।
- अपने गेटवे के पीछे OpenAI-संगत एंडपॉइंट्स को उजागर करें (Workstation एस्टेट अक्सर इसे पीछे रखते हैं WSL Proxy / API गेटवे पैटर्न)।
from vllm import LLM, SamplingParams

llm = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    gpu_memory_utilization=0.90,
    max_model_len=8192,
    enable_prefix_caching=True,
)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Summarise PagedAttention for a platform engineer."], params)
print(outs[0].outputs[0].text)
विरोधी पैटर्न (यह है नहीं PagedAttention):
# Classifier forward pass — logits, not paged KV serving
import torch
from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
out = model(torch.tensor([[1, 2, 3]]), attention_mask=torch.tensor([[1, 1, 1]]))
print(out.logits)
देखें: जंगल में सेवा प्रणालियाँ
प्रासंगिक सेवा वार्ता. विहित लेख: vLLM ब्लॉग (PagedAttention) · इंजन: वीएलएम-प्रोजेक्ट/वीएलएम.
4. Self-Debugging: प्रति उम्मीदवार अधिक गुणवत्ता, अधिक उम्मीदवार नहीं
चेन, लिन, क्लेन, और अन्य। दिखाया गया है कि कुछ-शॉट प्रदर्शनों के साथ अपने अनुमानित कार्यक्रम को डीबग करने के लिए LLM को पढ़ाना उन बेसलाइनों से मेल खा सकता है या हरा सकता है जो 10× से अधिक उम्मीदवार उत्पन्न करते हैं [arXiv:2304.05128]. लूप है: उत्पन्न करें → निष्पादित करें या इकाई-परीक्षण → फ़ीड ट्रेस वापस → मरम्मत करें।
उत्पादन व्यापार-बंद: प्रत्येक फीडबैक संदेश एक और प्रीफ़िल + डिकोड (या एक लंबा संदर्भ परिशिष्ट) है। सटीकता अक्सर अधिक राउंड के साथ बढ़ती है; विलंबता और लागत भी इसी प्रकार है। एजेंटों के लिए Workstation मार्गदर्शन (यह भी देखें)। Muse Glimmer / स्थानीय एजेंट):
- प्रति टूल कॉल डिबग राउंड पर हार्ड कैप (उदाहरण के लिए 2-4)।
- उपयोगकर्ता-दृश्यमान चैट से अलग बजट टोकन।
- अनंत पुनः प्रयास के बजाय किसी मानव या विशेषज्ञ मॉडल की ओर बढ़ें।
- eval के लिए लॉग ट्रेस - टेलीमेट्री के बिना Self-Debugging लोककथा है।
5. PowerInfer: स्थानीयता-जागरूक टोकन पीढ़ी
PowerInfer (SJTU IPADS / संबंधित रिपोज) एक टोकन जेनरेशन सिस्टम है जो सक्रियण इलाके का फायदा उठाता है: GPU पर एक छोटा "हॉट" न्यूरॉन सेट, ठंडा वजन CPU पर स्ट्रीम या निष्पादित होता है। प्रकाशित संचालन बिंदुओं में शामिल हैं 13.20 टोकन/सेकेंड औसत और 29.08 टोकन/सेकेंड शिखर एकल NVIDIA RTX 4090 पर, और तक 11.69× बरकरार सटीकता के साथ llama.cpp बनाम [PowerInfer गिटहब]. (टाइनी-एआई/एक्सपीआर0एक्स जैसे उपयोगकर्ता-सामना वाले कांटे काम की एक ही लाइन को ट्रैक करते हैं।)
स्केल-आउट कठिन हिस्सा है। एक एकल 4090 स्थानीय प्रोफ़ाइल स्वचालित रूप से एक स्वस्थ कुबेरनेट्स परिनियोजन नहीं बन जाती है। आप की जरूरत है:
- यदि CPU विशेषज्ञ चलते हैं तो ईमानदार GPU अनुरोध/सीमाएं और NUMA-जागरूक CPU पिनिंग।
- यदि मॉडल अब फिट नहीं बैठता है तो एक वितरित योजना: टेंसर पैरेलल बनाम पाइपलाइन बनाम विशेषज्ञ पैरेलल।
- एसएलओ विभाजन: इंटरैक्टिव चैट बनाम बैच पूर्णता बनाम एजेंट टूल लूप।
वर्कस्टेशन और एज बॉक्स पर PowerInfer (या llama.cpp, या MLX) का उपयोग करें; जब आप डेटासेंटर GPUs को समवर्ती OpenAI-शैली ट्रैफ़िक से भर रहे हों तो vLLM (या TensorRT-LLM, या SGLang) का उपयोग करें। दोनों को मापें. हमारा एंटरप्राइज एआई लैब रुख Polyglot Benchmarks के समान है: साक्ष्य, फिर ADR।
6. EG-MLA: वास्तुकला पर ध्यान केंद्रित करें
सर्विंग ट्रिक्स उस मॉडल को ठीक नहीं कर सकती जिसका केवी आंतरिक रूप से बहुत बड़ा है। EG-MLA (एम्बेडिंग-गेटेड मल्टी-हेड अव्यक्त ध्यान) रिपोर्ट 91.6% से अधिक केवी कैश आकार में कमी बनाम मल्टी-हेड अटेंशन (एमएचए) नगण्य गिरावट के साथ, अतिरिक्त बचत बनाम एमएलए (59.9% तक), और बेहतर तर्क-बेंचमार्क सटीकता। लेखकों का तर्क है कि एंबेडिंग गेटिंग अंतर्निहित उच्च-क्रम इंटरैक्शन को प्रेरित करती है और 1 बी पैरामीटर से आगे स्केलिंग दिखाती है [EG-MLA, arXiv].
इंजीनियरिंग निहितार्थ: यह एक है प्रशिक्षण/वास्तुकला फ़ैसला। आप हर रात Llama-3 के यादृच्छिक vLLM पर EG-MLA फ्लिप नहीं कर सकते हैं और पेपर के प्रतिशत की उम्मीद नहीं कर सकते हैं। यदि आप प्रीट्रेन या निरंतर प्रीट्रेन को नियंत्रित करते हैं, तो EG-MLA आपके लिए दूसरा GPU खरीदने से पहले HBM में कटौती करने का एक उम्मीदवार है। यदि आप केवल सार्वजनिक वजन की सेवा करते हैं, तो PagedAttention + परिमाणीकरण + MLA वेरिएंट पर बने रहें जो इंजन पहले से ही समर्थित है, और EG-MLA चौकियों को उनके उतरते ही ट्रैक करें।
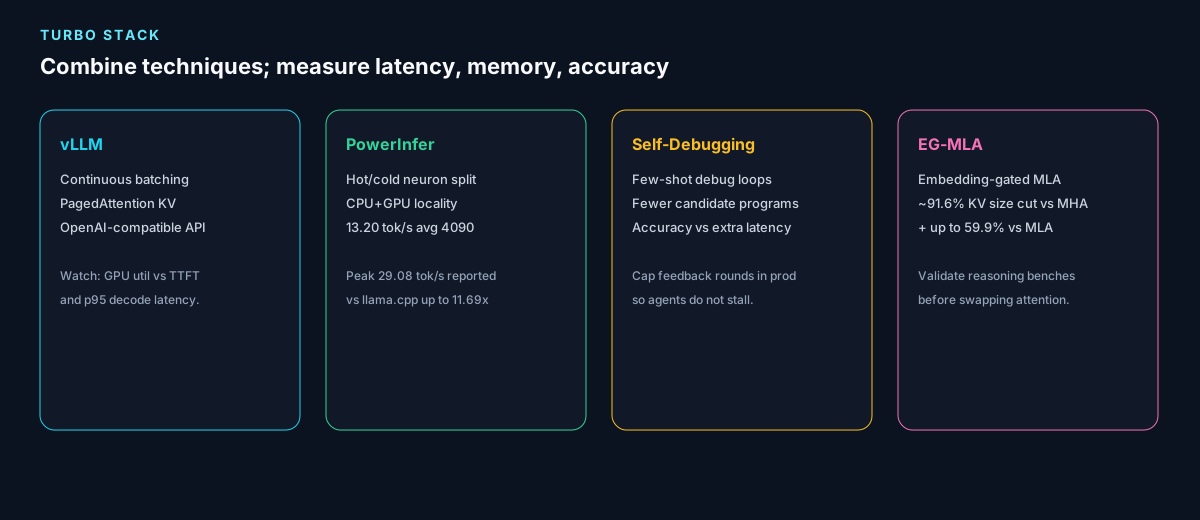
7. कार्गो-संवर्धन के बिना ढेर का संयोजन
| परत | कब उपयोग करें | ध्यान रहें |
|---|---|---|
| PagedAttention/vLLM | समवर्ती API सेवा, लंबा संदर्भ, साझा उपसर्ग | उपसर्ग कैश बनाम शुद्धता; उच्च उपयोग पर ओओएम |
| PowerInfer | सिंगल फैट GPU/वर्कस्टेशन टोकन दर | स्थानीयता बेमेल; गन्दा स्केल-आउट |
| Self-Debugging | कोड/एजेंट लूप जो परीक्षण निष्पादित कर सकते हैं | असीमित दौर; अतिरिक्त प्रीफ़िल लागत |
| EG-MLA | आप रीढ़ की हड्डी को प्रशिक्षित या सुदृढ़ करें | सेवारत ध्वज नहीं; पूर्ण eval पुनः चलाएँ |
8. कुबेरनेट्स पर स्केलेबिलिटी
एक अच्छी तरह से डिज़ाइन किया गया वितरित आर्किटेक्चर थ्रूपुट बढ़ाता है और विफलता मोड भी बढ़ाता है: स्ट्रैगलर्स, केवी कैश ट्रांसफर, टोकननाइज़र स्क्यू, और ऑटोस्केलर जो गर्म उपसर्गों को मारते हैं। व्यावहारिक पैटर्न (हमारे अनुरूप)। कुबेरनेट्स पर Ollama/vLLM सार्वजनिक रूप से लिखना):
- समर्पित GPU नोड पूल; कभी भी डिकोड पॉड्स को यादृच्छिक CPU जॉब्स के साथ पैक न करें।
- यदि टीटीएफटी एसएलओ और टोकन एसएलओ लड़ते हैं तो प्रीफिल और डिकोड को अलग करें।
- कतार की गहराई या GPU KV अधिभोग पर HPA, न केवल CPU।
- रिंगों के माध्यम से सर्विंग स्टैक को बढ़ावा दें (Ring Promoter) इसलिए एक खराब इंजन निर्माण परीक्षण को छोड़ नहीं सकता है।
9. निष्कर्ष
टर्बोचार्जिंग LLMs एक एल्गोरिदम नहीं है। यह KV कैश (PagedAttention) को पेजिंग कर रहा है, एक सर्विंग इंजन जो उन पेजों (vLLM) को बर्बाद नहीं करता है, जब हार्डवेयर एक वर्कस्टेशन GPU (PowerInfer) होता है, तो स्थानीय-जागरूक पीढ़ी, एजेंट स्प्रेइंग कैंडिडेट्स (Self-Debugging) के बजाय उस डीबग को लूप करता है, और - जब आपके पास वेट होता है - ध्यान जो बस कम स्टोर करता है (EG-MLA)। प्रत्येक परत स्मृति, विलंबता और सटीकता का व्यापार करती है। अपने ट्रैफ़िक को मापें. एडीआर प्रकाशित करें. जहाज।
संदर्भ
- क्वोन एट अल. — PagedAttention के साथ बड़े भाषा मॉडल सर्विंग के लिए कुशल मेमोरी प्रबंधन (arXiv:2309.06180, 14 सितंबर 2023)।
- चेन एट अल. — स्व-डीबग के लिए बड़े भाषा मॉडल सिखाना (arXiv:2304.05128, 12 अप्रैल 2023)।
- PowerInfer - एसजेटीयू-आईपीएडीएस/एक्सपीआर0एक्स (और संबंधित टिनी-एआई फोर्क्स)।
- EG-MLA - एंबेडिंग-गेटेड मल्टी-हेड अव्यक्त ध्यान (arXiv, 20 सितंबर 2025)।
- vLLM ब्लॉग — PagedAttention के साथ सेवा प्रदान करना आसान, तेज़ और सस्ता LLM.
द्वारा प्रकाशित Workstation. मूल लेखकों द्वारा प्रकाशित कागजी आंकड़े उद्धृत; आपके क्लस्टर पर उत्पादन संख्याएँ भिन्न होंगी।


