Muse Glimmer मेटा का 30-बिलियन-पैरामीटर कारण भाषा मॉडल है जिसमें एक समर्पित धारणा एनकोडर है, जिसे Muse Spark से डिस्टिल्ड किया गया है और उपभोक्ता और वर्कस्टेशन हार्डवेयर पर स्वायत्त एजेंटिक वर्कलोड के लिए प्रकाशित किया गया है। के माध्यम से वितरित किया गया Ollama अंतर्गत Apache 2.0, यह क्लाउड अनुमान की आवश्यकता के बिना विश्वसनीय उपकरण उपयोग, लंबी-क्षितिज कार्यों, मल्टीमॉडल समझ और विफलता पुनर्प्राप्ति को लक्षित करता है। यह Workstation तकनीकी संक्षिप्त विवरण स्थानीय एजेंटों को शिपिंग करने वाले इंजीनियरों के लिए सार्वजनिक मॉडल कार्ड को फिर से लिखता है और विस्तारित करता है।
- कक्षा: 30बी कारण एलएम + धारणा एनकोडर; Muse Spark से आसुत; दृष्टि + उपकरण + सोच।
- सेवा करना:
ollama run muse-glimmer(~18एक्सपीआर1एक्स, 128के, टेक्स्ट+छवि); Apple Silicon:muse-glimmer:30b-mlx(~21एक्सपीआर1एक्स, एक्सपीआर0एक्स)। - उपयुक्त: एक GPU या मैक सिलिकॉन पर हमेशा चालू रहने वाले स्थानीय/एयर-गैप्ड एजेंट - मल्टी-टीबी MoE क्लस्टर मॉडल नहीं।
- शक्ति संकेत: MCP-Atlas, DeepSearch QA, WildClawBench, SWE-Bench Pro, AA-LCR, Beam128K (उच्च तर्क) पर मेटा के रिपोर्ट किए गए आकार-वर्ग मैट्रिक्स का नेतृत्व करता है।
- ऑप्स: मचान के माध्यम से
ollama launch(Claude Code, OpenCode, हर्मीस, OpenClaw); इवेल्स, एचआईटीएल, एमसीपी ऑथेंटिकेशन के साथ शासन करें।
प्राथमिक स्रोत: Ollama लाइब्रेरी - म्यूज-ग्लिमर; मेटा मूल्यांकन पद्धति - Muse Glimmer पद्धति. नंबर और टैग बदलते हैं; खरीद से पहले लाइव मॉडल कार्ड सत्यापित करें।
1. वास्तुकला और डिजाइन का इरादा
Muse Glimmer को सामान्य चैट MoE के रूप में तैनात नहीं किया गया है। मेटा की फ़्रेमिंग है एंड-टू-एंड एजेंटिक कार्य पूरा करना हार्डवेयर पर आप डेस्क या छोटे लैब रैक के लिए खरीद सकते हैं:
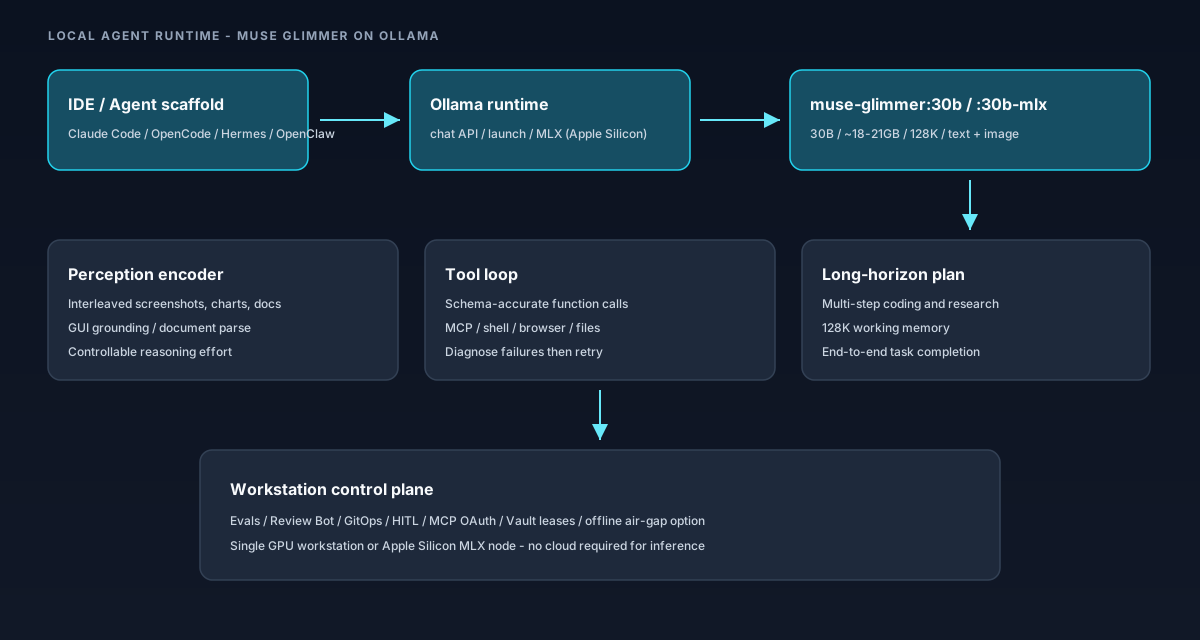
- कॉसल एलएम बैकबोन (30बी) - लंबे वर्कफ़्लो में कायम बहु-चरणीय तर्क श्रृंखलाओं के साथ अगली-टोकन पीढ़ी।
- समर्पित धारणा एनकोडर - इंटरलीव्ड टेक्स्ट और छवियों को स्वीकार करता है ताकि एजेंट टूल ट्रांसक्रिप्ट के समान संदर्भ विंडो में स्क्रीनशॉट, चार्ट और दस्तावेज़ों पर तर्क कर सकें।
- Muse Spark से आसवन - एक फ़ुटप्रिंट में क्षमता स्थानांतरण जो केवल डेटासेंटर सेवा के बजाय एकल-GPU / उपभोक्ता-वर्ग परिनियोजन को लक्षित करता है।
- विफलता पुनर्प्राप्ति व्यवहार - जब कोई टूल कॉल विफल हो जाता है या अप्रत्याशित पेलोड लौटाता है, तो मॉडल को एपिसोड को रोकने के बजाय निदान करने और पुनः प्रयास करने के लिए प्रशिक्षित/ट्यून किया जाता है।
- नियंत्रणीय प्रयास - तर्क शक्ति का चयन किया जा सकता है ताकि ऑपरेटर प्रति रूट गुणवत्ता के लिए विलंबता का व्यापार कर सकें।
- बहुभाषी प्रशिक्षण कवरेज - मेटा 100 से अधिक भाषाओं से प्रशिक्षण डेटा बताता है।
Workstation स्टैक के लिए, उत्पाद का निहितार्थ है: ग्लिमर को एक के रूप में मानें एजेंट रनटाइम मस्तिष्क MCP टूल, शेल, ब्राउज़र और फ़ाइल संपादकों के पीछे - प्रत्येक बंद फ्रंटियर API कॉल के लिए ड्रॉप-इन प्रतिस्थापन के रूप में नहीं।
2. Ollama वितरण (टैग, फ़ुटप्रिंट, I/O)
जैसा कि Ollama लाइब्रेरी कार्ड पर प्रकाशित है (लाइव आकार सत्यापित करें):
| टैग | लगभग। आकार | प्रसंग | इनपुट | टिप्पणियाँ |
|---|---|---|---|---|
muse-glimmer:latest / :30b | ~18GB | 128K | पाठ, छवि | डिफ़ॉल्ट एकल-GPU पथ |
muse-glimmer:30b-mlx | ~21GB | 128K | पाठ, छवि | Ollama MLX इंजन; DFlash + Apple Silicon पर छवि |
# Pull + interactive
ollama run muse-glimmer

# Apple Silicon (MLX)
ollama run muse-glimmer:30b-mlx

# HTTP chat (localhost Ollama)
curl http://localhost:11434/api/chat \
  -d '{"model":"muse-glimmer","messages":[{"role":"user","content":"Hello!"}]}'

# Scaffold launchers (from Ollama applications list)
ollama launch claude --model muse-glimmer
ollama launch opencode --model muse-glimmer
ollama launch hermes --model muse-glimmer
ollama launch openclaw --model muse-glimmer
पायथन/जेएस क्लाइंट को आपके द्वारा सत्यापित टैग को पिन करना चाहिए (muse-glimmer बनाम :30b-mlx) कॉन्फिग में, हार्ड-कोड नहीं latest उत्पादन एजेंटों में.
3. क्षमता सतह (इंजीनियरिंग पढ़ना)
- एंड-टू-एंड एजेंटिक समापन - मेटा डीपसर्च QA, MCP-Atlas, τ3-बेंच (बैंकिंग), और SWE-Bench पारिवारिक कार्यों पर मजबूत परिणामों का हवाला देता है जो सिंगल-शॉट ट्रिविया नहीं, बल्कि मल्टी-टर्न सफलता को मापते हैं।
- विश्वसनीय उपकरण का उपयोग - विस्तारित वर्कफ़्लोज़ (एमसीपी टूल बेड़े के लिए महत्वपूर्ण) में स्कीमा परिशुद्धता के साथ विस्तृत फ़ंक्शन-कॉल कवरेज।
- बहु-चरणीय तर्क - लंबे क्षितिज पर सुसंगतता की योजना बनाएं; प्रतिलेख + दस्तावेज़ प्रतिधारण के लिए 128K संदर्भ विंडो के साथ जोड़े।
- विफलता पुनर्प्राप्ति - अप्रत्याशित उपकरण परिणामों का निदान करें और पुनः प्रयास करें; रात भर की नौकरियों में "भंगुर एजेंट" गर्भपात को कम करता है।
- बहुविध तर्क - परसेप्शन एनकोडर टेक्स्ट के साथ स्क्रीनशॉट/चार्ट/दस्तावेज़ को इंटरलीव करने में सक्षम बनाता है (जीयूआई ग्राउंडिंग और डॉक पार्स बेंच मेटा के मैट्रिक्स में शामिल हैं)।
- मचान अनुकूलता - OpenClaw, Hermes Agent, और समान ऑर्केस्ट्रेशन पैटर्न; Ollama Claude Code और OpenCode लॉन्चर्स को प्रथम श्रेणी ऐप्स के रूप में सूचीबद्ध करता है।
4. बेंचमार्क मैट्रिक्स (मेटा-रिपोर्टेड, उच्च तर्क)
मेटा सोच मोड में Muse Glimmer-30B (उच्च तर्क) की तुलना Gemma4-31B और Qwen3.6-27B से करता है। हेडलाइन Workstation रीडिंग: ग्लिमर कई लोगों से आगे है एजेंटिक सार्वजनिक सुइट्स (MCP-Atlas, DeepSearch QA, WildClawBench, Gaia2, SWE-Bench Pro) कुछ डेस्कटॉप-एजेंट और जीडीपी-वैल मेट्रिक्स पर साथियों को पीछे छोड़ते या बांधते हुए। हमेशा पुनः चालू रखें आपका दोहन.
| वर्ग | बेंचमार्क | ग्लिमर-30बी | जेम्मा4-31बी | क्वेन3.6-27बी |
|---|---|---|---|---|
| सामान्य एजेंटिक | MCP-Atlas (सार्वजनिक) | 75.5 | 54.2 | 62.5 |
| डीपसर्च क्यूए | 74.6 | 61.7 | 71.1 | |
| τ3-बैंकिंग | 23.5 | 15.1 | 16.7 | |
| वाइल्डक्लॉबेंच | 47.6 | 37.6 | 43.2 | |
| जीडीपीवैल-एए v2 | 953 | 811 | 1141 | |
| गैया2 | 43.3 | 36.4 | 40.0 | |
| स्किल्सबेंच (कौशल के साथ) | 44.3 | 32.4 | 46.6 | |
| ओएसवर्ल्ड-सत्यापित | 65.9 | 58.5 | 75.6 | |
| एजेंट कोडिंग | SWE-Bench प्रो | 51.2 | 36.9 | 50.2 |
| SWE-Bench सत्यापित | 76.0 | 66.6 | 77.2 | |
| टर्मिनलबेंच 2.1 | 51.7 | 43.4 | 60.7 | |
| SciCode | 43.6 | 43.4 | 39.8 | |
| बहुविध | चारक्सिव रीजनिंग | 78.8 | 77.7 | 78.4 |
| स्क्रीनस्पॉट प्रो | 75.4 | 75.9 | 76.1 | |
| ओमनीडॉकबेंच v1.5 | 75.8 | 72.5 | 77.8 | |
| एमएमएमयू प्रो | 74 | 73 | 75 | |
| रीज़निंग / एलसीआर | आईएफबेंच | 77.0 | 76.0 | 70.8 |
| एआईएमई 2026 | 94.7 | 89.2 | 94.1 | |
| जीपीक्यूए डायमंड (एए) | 83.5 | 85.7 | 84.2 | |
| एचएलई टेक्स्ट (एए) | 22.0 | 23.6 | 23.1 | |
| एए-एलसीआर | 80.0 | 68.3 | 73.3 | |
| बीम128K | 65.1 | 58.2 | 63.0 |
सुरक्षा बेंच (सीआई मेमोरीज़, सायरन एजेंटडोजो) ट्रेड-ऑफ दिखाते हैं: ग्लिमर मिड-पैक एएसआर के साथ एजेंटडोजो इंजेक्शन के तहत उच्च उपयोगिता की रिपोर्ट करता है; सुरक्षा को एक परिनियोजन नियंत्रण समस्या (प्रॉम्प्ट फ़ायरवॉल, टूल अनुमति सूची, HITL) के रूप में मानें - एक हल की गई मॉडल संपत्ति नहीं। जज मॉडल, प्रयास गणना और हार्नेस चेतावनियों के लिए मेटा की कार्यप्रणाली पीडीएफ देखें।
5. मूल्यांकन पद्धति (संख्याओं का क्या मतलब है)
बोर्ड डेक में किसी भी सेल को उद्धृत करने से पहले मेटा की कार्यप्रणाली नोट आवश्यक है:
- सहकर्मी चयन: आकार-वर्ग के खुले मॉडल (जेम्मा4-31बी, क्यूवेन3.6-27बी); सहकर्मी स्व-रिपोर्ट किए गए या आंतरिक रूप से पुनरुत्पादित स्कोर का उपयोग कर सकते हैं; तीनों के लिए उपलब्ध होने पर कृत्रिम विश्लेषण का उपयोग किया जाता है।
- नमूनाकरण: ग्लिमर ने तापमान=1.0 / टॉप_पी=0.95 / टॉप_के=64 के साथ उच्च तर्क शक्ति पर रिपोर्ट की; सहकर्मी विक्रेता-अनुशंसित सोच कॉन्फ़िगरेशन का उपयोग करते हैं (क्यूवेन कुछ एजेंट बेंचों पर ठंडे तापमान का उपयोग करता है)।
- हार्नेस पूर्वाग्रह चेतावनी: मेटा नोट करता है कि तृतीय-पक्ष मॉडल को मेटा के टूल/सिस्टम संकेतों के अनुरूप नहीं बनाया जा सकता है - पूर्ण रैंक सहकर्मी-मूल मचानों के तहत स्थानांतरित हो सकते हैं।
- MCP-Atlas: 20+ MCP सर्वर पर मल्टी-टर्न टूल का उपयोग; 500 सार्वजनिक कार्यों पर LLM-जज पास दर (सीमा 0.75), औसतन 4 रन से अधिक।
- गहन खोज क्यूए: 900 कठिन शोध प्रश्नों पर स्वायत्त ब्राउज़िंग लूप (खोज/खोलें/खोजें); न्यायाधीश निष्कर्षण के माध्यम से F1.
- वाइल्डक्लावबेंच / गैया2: इवेंट इंजेक्शन और मिश्रित निर्धारक/LLM ग्रेडिंग के साथ OpenClaw-शैली हार्नेस के तहत लंबे-क्षितिज वाले डॉकराइज्ड एजेंट कार्य।
- SWE-Bench: बैश + फ़ाइल टूल्स मचान; प्रो और सत्यापित का कई रनों में औसत - प्रो तुलना क्वेन के परिष्कृत-कार्य संस्करण से बचती है।
- ओएसवर्ल्ड-सत्यापित: स्क्रीनशॉट से केवल जीयूआई उबंटू वीएम नियंत्रण (कोई सीधा शेल नहीं); मॉडलों के बीच क्रिया-स्थान का अंतर मायने रखता है।
- बीम128के: 128K पर गैर-एजेंटिक लंबी-संदर्भ मेमोरी जांच - यदि आप RAG के बिना बड़े प्रतिलेखों को संदर्भ में रखते हैं तो प्रासंगिक है।
Workstation नीति: ओरिएंटेशन के लिए मेटा के मैट्रिक्स को प्रकाशित करें, फिर आंतरिक गोल्डन सेट (आपके एमसीपी टूल, आपके रिपो, आपके विलंबता एसएलओ) पर गेट उत्पादन।
6. हार्डवेयर और वास्तविकता परोसना
- एकल GPU वर्ग: ~18एक्सपीआर1एक्स वजन पदचिह्न का तात्पर्य है कि एक आधुनिक 24एक्सपीआर1एक्स+ उपभोक्ता/समर्थक एक्सपीआर0एक्स एक बार केवी कैश और विज़न सक्रियण पर विचार करने के बाद व्यावहारिक एनवीडिया मंजिल है; आपके अधिकतम संदर्भ और समवर्ती सत्रों के साथ प्रोफ़ाइल।
- Apple Silicon: पसंद करना
:30b-mlx(~21एक्सपीआर4एक्स) एक्सपीआर1एक्स के एक्सपीआर3एक्स पथ के लिए एक्सपीआर2एक्स सट्टा डिकोडिंग और मूल छवि इनपुट के साथ - एक्सपीआर0एक्स / मैक मिनी मैक्स कॉन्फ़िगरेशन प्रथम श्रेणी एसएमई नोड्स हैं। - किमी-K3-श्रेणी नहीं: यह मल्टी-नोड MoE नहीं है. यदि आपको ट्रिलियन-पैरामीटर ओपन एजेंटों की आवश्यकता है, तो हमारा देखें ओपन-वेट गाइड; ग्लिमर का मालिक है डेस्क-साइड हमेशा चालू ताक।
- कुबेरनेट्स: पैकेज Ollama या प्रति नोड एक OpenAI-संगत साइडकार; मॉडल को अपनी निजी रजिस्ट्री/कैश में रखें; इंटरनेट से अनबाउंड Ollama को उजागर न करें।
7. हमेशा सक्रिय एजेंटों के लिए सुरक्षा और शासन
स्थानीय भार डेटा निकास को कम करते हैं लेकिन समझौता किए गए एजेंट होस्ट के ब्लास्ट त्रिज्या को बढ़ाते हैं। न्यूनतम Workstation बेसलाइन:
- एमसीपी ओएथ 2.1 + अल्पकालिक रहस्य (वॉल्ट पट्टे) - देखें एजेंटिक सुरक्षा आलेख.
- एजेंट की पहचान के अनुसार टूल अनुमति सूचियाँ और नेटवर्क निकास नीतियां।
- एचआईटीएल अपरिवर्तनीय कार्रवाइयों (भुगतान, उत्पादों की तैनाती, बड़े पैमाने पर ईमेल) पर प्रवेश करता है।
- टूल-रिटर्न सामग्री पर शीघ्र-इंजेक्शन निगरानी (सायरन एजेंटडोजो-शैली खतरा मॉडल)।
- ऑफ़लाइन/एयर-गैप मोड का प्रथम श्रेणी रनबुक के रूप में परीक्षण किया गया, आशा नहीं।
8. उत्पादन चेकलिस्ट
- Ollama टैग पिन करें (
30bबनाम30b-mlx) और GitOps में डाइजेस्ट/हैश रिकॉर्ड करें। - अपने एमसीपी टूल्स और कोडिंग वर्कफ़्लोज़ को प्रतिबिंबित करने वाला 20-50 टास्क गोल्डन सूट बनाएं; प्रत्येक प्रयास स्तर पर पास@1 और पी95 विलंबता को ट्रैक करें।
- तार मचान (
ollama launch …या कस्टम) टूल कॉल और पुनः प्रयास की संरचित लॉगिंग के साथ। - हाइब्रिड राउटर को परिभाषित करें: निजी RAG/एजेंटों के लिए चमकदार स्थानीय; ओवरफ्लो/पीक आईक्यू के लिए क्लाउड फेलओवर।
- 32K / 64K / 128K पर विज़न के साथ दस्तावेज़ VRAM/यूनिफाइड-मेमोरी हेडरूम।
- कानूनी: आपके वितरण मॉडल के लिए Apache 2.0 समीक्षा (आमतौर पर सीधा बनाम प्रतिबंधात्मक ओपन-वेट लाइसेंस)।
- अप्राप्य ओवरनाइट एजेंटों को सक्षम करने से पहले शिप रिव्यू बॉट + इवल गेट्स।
द्वारा प्रकाशित Workstation. मॉडल कार्ड: ollama.com/library/muse-glimmer.


