Workstation Resumen técnico: cómo turboalimentar el servicio y los agentes LLM con PagedAttention, vLLM, Self-Debugging, PowerInfer, y EG-MLA. Compañero: blog · imprimación: Artículo sobre LLM en Kubernetes · laboratorio: Laboratorio de IA empresarial.
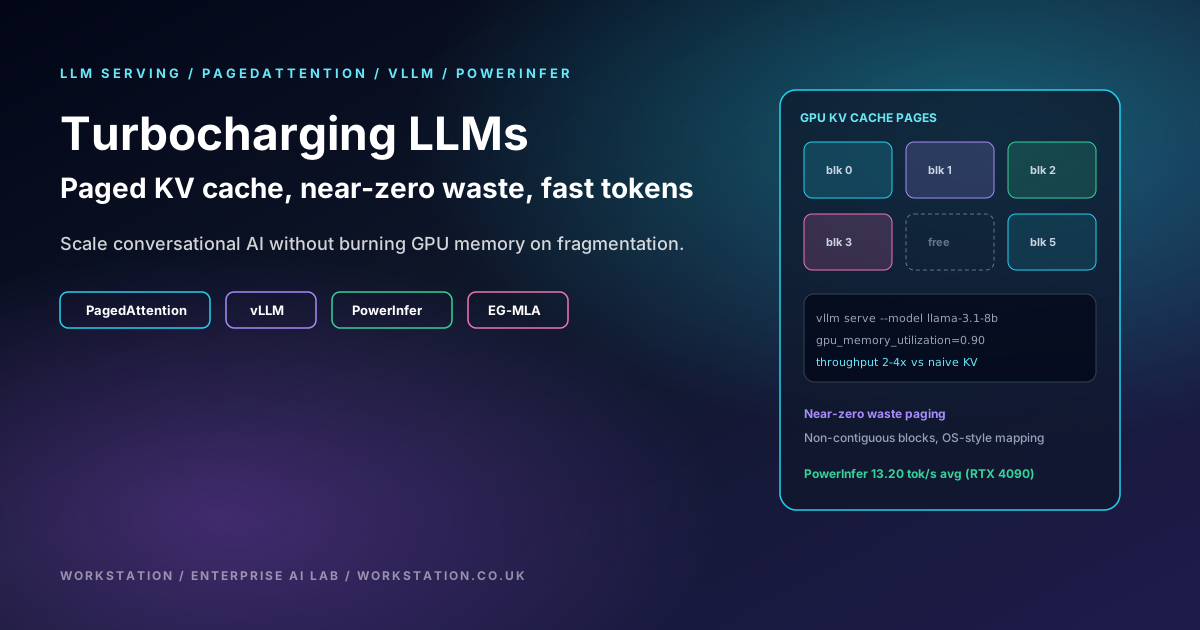
- Embotellamiento: Crecimiento y fragmentación de la caché de KV, no "el modelo es lento" en abstracto.
- PagedAttention: Paginación estilo OS de bloques KV; ajustar el tamaño del bloque y la jerarquía de la caché.
- vLLM: motor de servicio con desperdicio de KV cercano a cero + procesamiento por lotes continuo; Mire TTFT frente a tokens.
- Self-Debugging: la reparación de programas con pocos intentos supera a los conjuntos de candidatos enormes; rondas de tapa en prod.
- PowerInfer: división frío/calor; 13,20 tok/s promedio / 29,08 pico en RTX 4090 (cifras en papel/repo).
- EG-MLA: compresión KV a nivel de arquitectura (~91,6 % frente a MHA); reevaluación antes del intercambio.
1. Por qué la crisis es servir, no capacitar
Los grandes modelos de lenguaje cambiaron la PNL: chat, generación, herramientas. La formación es cara una vez; servir es caro cada segundo. La decodificación es autorregresiva. Cada nuevo token necesita las claves y valores anteriores. La memoria para ese caché KV es proporcional a capas × cabezas × ocultas × secuencia × lote. El prerrelleno requiere mucha computación; la decodificación consume mucho ancho de banda de memoria. Si asigna un tensor KV contiguo de longitud máxima por solicitud, la mayor parte estará vacía hasta que la secuencia realmente crezca: fragmentación interna clásica. Las solicitudes simultáneas no pueden eliminar esos agujeros. El tamaño del lote disminuye. Caída de tokens por segundo. Los GPU parecen ocupados y aún inactivos.
Ese es el problema que atacaron PagedAttention y vLLM en 2023, y el problema que PowerInfer y las variantes de atención posteriores todavía atacan desde diferentes ángulos.
Ver: modelo mental LLM
Vídeo de contexto: Introducción a los modelos de lenguaje grandes. Explicador de Workstation: cómo funcionan los LLM y cómo ejecutarlos en Kubernetes.
2. PagedAttention: paginación para el caché KV
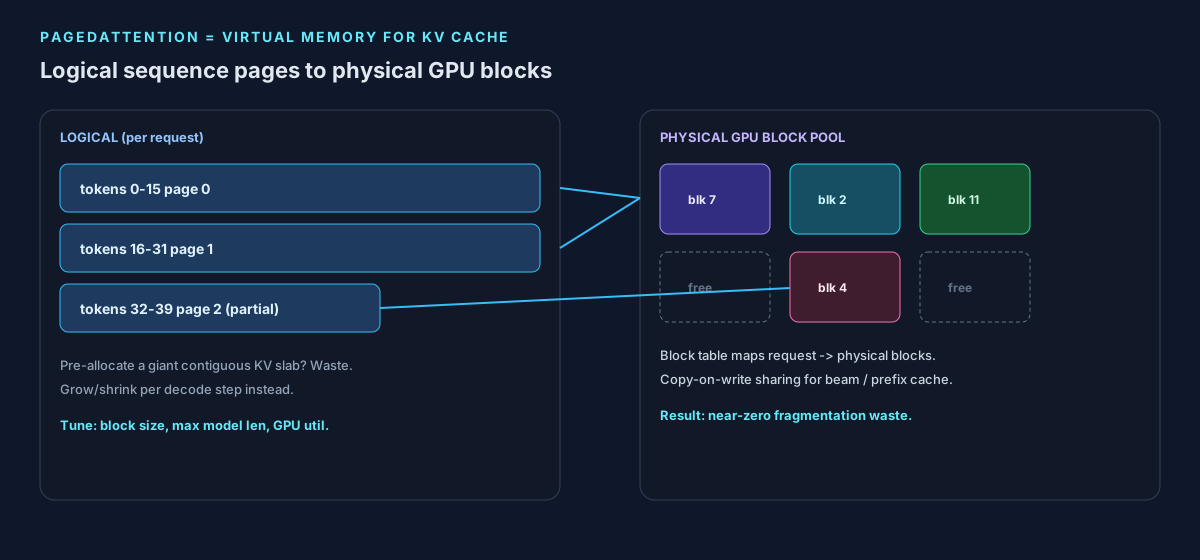
Kwon, Li, Zhuang, Sheng, Zheng, Yu, González, Zhang y Stoica introdujeron PagedAttention como un algoritmo de atención inspirado en la memoria virtual y la paginación del sistema operativo, y construyeron vLLM sobre él. [arXiv:2309.06180]. La idea:
- Dividir KV en bloques de tamaño fijo (una pequeña cantidad de tokens por bloque).
- Mantenga un mesa de bloques desde posiciones de tokens lógicos hasta bloques físicos GPU (posiblemente no contiguos).
- Asigne/libere bloques a medida que las secuencias crecen o finalizan, como la asignación de páginas, no como malloc de una matriz gigante.
- Comparta bloques (copia en escritura) para la reutilización de prefijos, búsqueda de haces y muestreo paralelo para no duplicar prefijos idénticos.
La implementación no es "poner una bandera en BERT". El núcleo de atención debe reunir bloques dispersos. El planificador debe saber qué bloques están libres. La jerarquía de caché es importante: bloques residentes de HBM frente a descarga de CPU frente a pares NVLink. El tamaño del búfer (bloque) es un verdadero control. Demasiado pequeño: más búsquedas de tablas y sobrecarga del kernel. Demasiado grande: espacios desperdiciados dentro del último bloque parcial. Emparejar el tamaño del bloque con max_model_len y la combinación real de mensajes/finalización de su tráfico.
Práctica: fragmentación de perfil (bytes KV no utilizados / bytes KV reservados) y tokens juntos. Los gráficos de memoria sin rendimiento son vanidad.
3. vLLM: el sistema de servicio alrededor del buscapersonas
La afirmación de vLLM es un desperdicio casi nulo en la memoria caché KV, además de un uso compartido flexible dentro y entre solicitudes. Las evaluaciones en el documento mostraron aproximadamente Rendimiento de 2 a 4 veces en comparación con los sistemas SOTA de entonces (FasterTransformer, Orca) con una latencia similar, con mayores ganancias en secuencias largas y una decodificación más sofisticada. Hoy en día, el motor también incluye procesamiento por lotes continuo, precarga fragmentada, almacenamiento en caché de prefijos y tensor/canalización paralela para multi-GPU.
Lista de verificación operativa:
- Colocar
gpu_memory_utilizationLo suficientemente alto como para soportar pesos + KV, lo suficientemente bajo como para salir del espacio de trabajo CUDA. - Habilite el almacenamiento en caché de prefijos solo después de confirmar las puntuaciones de evaluación y p95 TTFT activado su indicaciones.
- Separe los grupos con gran cantidad de precarga y decodificación si el tráfico mixto arruina el SLO (servicio desagregado).
- Exponga los puntos finales compatibles con OpenAI detrás de su puerta de enlace (las propiedades Workstation a menudo colocan esto detrás Puerta de enlace WSL Proxy / API patrones).
from vllm import LLM, SamplingParams

llm = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    gpu_memory_utilization=0.90,
    max_model_len=8192,
    enable_prefix_caching=True,
)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Summarise PagedAttention for a platform engineer."], params)
print(outs[0].outputs[0].text)
Antipatrón (esto es no PagedAttention):
# Classifier forward pass — logits, not paged KV serving
import torch
from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
out = model(torch.tensor([[1, 2, 3]]), attention_mask=torch.tensor([[1, 1, 1]]))
print(out.logits)
Ver: sistemas de servicio en la naturaleza
Charla de servicio contextual. Artículo canónico: Blog vLLM (PagedAttention) · motor: proyecto-vllm/vllm.
4. Self-Debugging: más calidad por candidato, no más candidatos
Chen, Lin, Klein y col. demostró que enseñar a un LLM a depurar su programa previsto con demostraciones de pocos disparos puede igualar o superar las líneas de base que generan más de 10 veces más candidatos [arXiv:2304.05128]. El bucle es: generar → ejecutar o realizar una prueba unitaria → retroalimentar los rastros → reparar.
Compensación de producción: cada mensaje de retroalimentación es otro prellenado+decodificación (o un anexo de contexto largo). La precisión suele aumentar con más rondas; también lo hacen la latencia y el costo. Guía Workstation para agentes (ver también Muse Glimmer / agentes locales):
- Límite estricto en las rondas de depuración (por ejemplo, 2 a 4) por llamada de herramienta.
- Tokens de presupuesto separados del chat visible para el usuario.
- Escale a un modelo humano o especializado en lugar de reintentos infinitos.
- Registrar seguimientos para evaluación: Self-Debugging sin telemetría es folklore.
5. PowerInfer: generación de tokens con reconocimiento de localidad
PowerInfer (SJTU IPADS / repositorios relacionados) es un sistema de generación de tokens que explota la localidad de activación: una pequeña neurona "caliente" configurada en GPU, pesos más fríos transmitidos o ejecutados en CPU. Los puntos operativos publicados incluyen 13,20 tokens/s promedio y Pico de 29,08 tokens/s en una sola NVIDIA RTX 4090, y hasta 11,69× versus llama.cpp con precisión mantenida [PowerInfer GitHub]. (Las bifurcaciones orientadas al usuario, como Tiiny-AI/PowerInfer, siguen la misma línea de trabajo).
La ampliación es la parte difícil. Un único perfil de localidad 4090 no se convierte automáticamente en una implementación de Kubernetes saludable. Necesitas:
- Solicitudes/límites honestos de GPU y fijación de CPU compatible con NUMA si se ejecutan expertos de CPU.
- Un plan distribuido si el modelo ya no se ajusta: tensor paralelo versus canalización versus paralelo experto.
- División de SLO: chat interactivo frente a finalización por lotes frente a bucles de herramientas del agente.
Utilice PowerInfer (o llama.cpp o MLX) en estaciones de trabajo y cajas perimetrales; use vLLM (o TensorRT-LLM, o SGLang) cuando esté llenando centros de datos GPU con tráfico concurrente estilo OpenAI. Mide ambos. Nuestro Laboratorio de IA empresarial La postura es la misma que Polyglot Benchmarks: evidencia, luego ADR.
6. EG-MLA: comprime la atención en la arquitectura.
Los trucos de saque no pueden arreglar un modelo cuyo KV es intrínsecamente enorme. Informes EG-MLA (atención latente de múltiples cabezales activada por incrustación) Reducción del tamaño de caché KV de más del 91,6% versus atención de múltiples cabezas (MHA) con degradación insignificante, ahorros adicionales versus MLA (hasta 59,9%) y precisión de referencia de razonamiento mejorada. Los autores argumentan que la incorporación de puertas induce interacciones implícitas de alto orden y muestran una ampliación más allá de los parámetros 1B. [EG-MLA, arXiv].
Implicación de ingeniería: este es un formación / arquitectura decisión. No se puede invertir EG-MLA en un vLLM aleatorio todas las noches de Llama-3 y esperar los porcentajes del papel. Si controlas el preentrenamiento o el preentrenamiento continuo, EG-MLA es candidato a cortar HBM antes de comprar otro GPU. Si solo ofrece pesas públicas, permanezca en las variantes PagedAttention + cuantificación + MLA que el motor ya admite y realice un seguimiento de los puntos de control EG-MLA a medida que aterrizan.
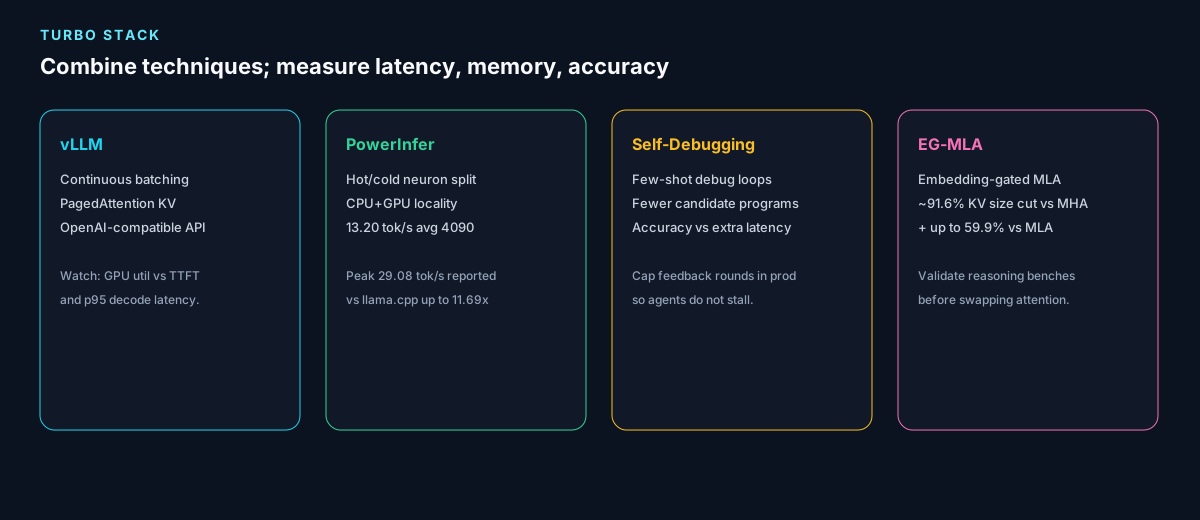
7. Combinar la pila sin culto a la carga.
| Capa | Usar cuando | Cuidado |
|---|---|---|
| PagedAttention / vLLM | Servicio API simultáneo, contexto largo, prefijos compartidos | Caché de prefijos frente a corrección; OOM en alta utilidad |
| PowerInfer | Tasa de token de GPU / estación de trabajo de grasa única | Desajuste de localidad; ampliación desordenada |
| Self-Debugging | Bucles de código/agente que pueden ejecutar pruebas | Rondas ilimitadas; costo adicional de precarga |
| EG-MLA | Entrenas o afinas la columna vertebral | No es una bandera de servicio; volver a ejecutar la evaluación completa |
8. Escalabilidad en Kubernetes
Una arquitectura distribuida bien diseñada aumenta el rendimiento y también genera modos de falla: rezagados, transferencia de caché KV, desviación del tokenizador y escaladores automáticos que eliminan los prefijos calientes. Patrón práctico (alineado con nuestro Ollama/vLLM en Kubernetes redacción):
- Grupos de nodos GPU dedicados; nunca empaquete módulos de decodificación con trabajos CPU aleatorios.
- Separe el prellenado y la decodificación si los SLO de TTFT y los SLO de token/s pelean.
- HPA en profundidad de cola u ocupación GPU KV, no solo CPU.
- Promocione las pilas de servir a través de anillos (Ring Promoter) por lo que un motor defectuoso no puede saltarse la prueba.
9. Conclusión
La turboalimentación del LLM no es un solo algoritmo. Se trata de paginar el caché KV (PagedAttention), un motor de servicio que no desperdicia esas páginas (vLLM), generación con reconocimiento de localidad cuando el hardware es una estación de trabajo GPU (PowerInfer), bucles de agente que depuran en lugar de distribuir candidatos (Self-Debugging) y, cuando posee los pesos, atención que simplemente almacena menos (EG-MLA). Cada capa intercambia memoria, latencia y precisión. Mida su tráfico. Publicar el ADR. Barco.
Referencias
- Kwon et al. — Gestión eficiente de la memoria para el servicio de modelos de lenguajes grandes con PagedAttention (arXiv:2309.06180, 14 de septiembre de 2023).
- Chen et al. — Enseñar modelos de lenguaje grandes para que se autodepuren (arXiv:2304.05128, 12 de abril de 2023).
- PowerInfer— SJTU-IPADS/PowerInfer (y bifurcaciones Tiiny-AI relacionadas).
- EG-MLA— Atención latente de múltiples cabezales con control de incrustación (arXiv, 20 de septiembre de 2025).
- Blog vLLM— Servicio LLM fácil, rápido y económico con PagedAttention.
Publicado por Workstation. Cifras del artículo citadas según las publicaciones de los autores originales; Los números de producción en su grupo serán diferentes.


