La tienda ya está abierta

Construimos máquinas Workstation AI para sitios web, agentes de IA y entrenamiento de LLM — configúrelas y cómprelas en línea.

Obtener precios profesionales
Productos de IA
Labs de IAAgentes OpenAIAgentes ClaudeGrok BotCRM nativo de Workstation AIMarketingTodos los productos
Soluciones de IA
IA aplicadaAgentes de IAIA generativaAutomatización con IAFormación en IAPaquetes de IA para pymesLaboratorio de IA empresarialEstaciones de trabajo de IAHardware y software NVIDIAComputación acelerada NVIDIAIA privadaClústeres de GPUIA en el bordeIA por sector
Servicios de IA
Modernización de plataformasIngeniería digitalFundamentos de datos e IAOperaciones autónomasConsultoría de IAAutomatización DevOpsCiberseguridadDesarrollo de softwareCreación de agentesConfiguración MLOpsAlquiler de GPU
Sobre nosotros
EmpresaNuestra historiaSociosCasos de éxito
Centros de datos de IA
Análisis de IASerie JevLaboratorio de benchmarksSelección de modelos
Notas técnicas
Documentación
Linux OSUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
Plataformas de IA en la nubeAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryNubes y mercados de GPU
Centros de datos de IA privadosPara despachos de abogadosPara firmas de contabilidadPlataformas localesNube totalmente protegida
HerramientasRing PromoterJobshout
Noticias
Blog
ContáctenosIniciar sesión

Estaciones de trabajo de IA, software multiagente de IA, infraestructura de GPU y soluciones de agentes inteligentes para empresas modernas.

Contáctenos

Soluciones de IA

IA aplicadaAgentes de IAIA generativaAutomatización con IAFormación en IAPaquetes de IA para pymesLaboratorio de IA empresarialIA por sector

Productos

Todos los productosWorkstation AI native CRM y ERPMarketingAgentes OpenAIRing PromoterJobshout

Empresa

Sobre nosotrosEmpresaCentros de datos de IAPor Qué WorkstationSociosCasos de éxitoPreciosContactoTenthMatrix

Recursos

Análisis de IANotas técnicasDocumentaciónLinux OSPlataformas de IA en la nubeCentros de datos de IA privadosBlogBuscarMapa del sitio
Oficina del Reino Unido
77-79 Marlowes, Hemel Hempstead HP1 1LFCómo llegar: tome la salida 20 de la M25, Outer LondonN.º de empresa: 11641870Lun - Vie: 9:00 - 18:00 GMT
+44 7515 356 146
Oficina de Bélgica
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Lun - Vie: 9:00 - 18:00 CET
+32 492 45 67 46
Oficina de India
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI. Todos los derechos reservados.

PrivacidadEliminación de datosCookiesTérminos del servicioMapa del sitio web

NVIDIA, the NVIDIA logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX and HGX are trademarks and/or registered trademarks of NVIDIA Corporation in the US and other countries. AMD, the AMD Arrow logo, EPYC, Instinct, Ryzen and Threadripper are trademarks of Advanced Micro Devices, Inc. Dell and PowerEdge are trademarks of Dell Inc. or its subsidiaries. Intel and Xeon are trademarks of Intel Corporation or its subsidiaries. AMAX, AceleMax and LiquidMax are trademarks of AMAX Engineering Corporation. All other product names, logos and brands are the property of their respective owners. We use them only to identify the products we describe, supply or support; their use does not mean their owners endorse us.

NVIDIA Partner · Reino Unido

Soluciones de computación acelerada NVIDIA

Desde una sola GPU para centro de datos hasta una fábrica de IA a escala de rack con refrigeración líquida, Workstation dimensiona, suministra, monta, instala y da soporte a toda la gama de computación acelerada NVIDIA para organizaciones del Reino Unido.

Ver la gamaHable con un ingeniero
  • 34Sistemas, GPU, redes y productos de software NVIDIA
  • 5pasos, del dimensionamiento al soporte a largo plazo
  • UKingeniería, montaje y pruebas de estrés

Computación acelerada, sin riesgos de integración

La computación acelerada traslada las partes más pesadas de una carga de trabajo, como el entrenamiento y la inferencia de IA, la simulación, la analítica y el renderizado, de las CPU de uso general a GPU y procesadores especializados. El resultado: más trabajo por rack y por vatio, y resultados en horas en lugar de días.

Para lograrlo hace falta algo más que una GPU. Cada acelerador necesita un servidor capaz de alimentarlo y refrigerarlo, una red que lo mantenga abastecido de datos y un software con licencia y soporte. Como NVIDIA Partner con ingenieros propios, integramos todas esas piezas en un único sistema probado y seguimos a su lado una vez en producción.

  • Asesoramiento independiente sobre qué plataforma NVIDIA se adapta a sus cargas de trabajo
  • Configuraciones completas y NVIDIA-Certified en lugar de piezas sueltas
  • Montaje, preparación de imagen y pruebas de estrés en nuestro taller del Reino Unido
  • Instalación, cableado y puesta en marcha en sus instalaciones
  • Un único contacto en el Reino Unido para soporte, ampliaciones y garantía

Qué compone un sistema acelerado

Cuatro capas trabajan juntas. Especificamos las cuatro para que ninguna se convierta en un cuello de botella.

GPU

Realizan los cálculos en paralelo que hay detrás de la IA, la simulación y los gráficos. El tamaño y el ancho de banda de la memoria suelen determinar qué GPU necesita.

CPU y sistemas

Alimentan las GPU, ejecutan el sistema operativo y mantienen los datos en memoria. El chasis determina la alimentación, la refrigeración y cuántas GPU caben.

Redes y DPU

Mueven datos entre GPU, servidores y almacenamiento. Las DPU liberan a la CPU de las tareas de red, almacenamiento y seguridad.

Software

Los controladores, CUDA, los frameworks de IA y las herramientas de clúster convierten el hardware en una plataforma que sus equipos pueden utilizar.

Por qué las organizaciones adoptan la computación acelerada

Las cargas de trabajo superan a las CPU

Los modelos de IA y los conjuntos de datos crecen más rápido que el rendimiento de las CPU. Los trabajos se alargan, los niveles de servicio se resienten y la factura eléctrica sube.

Los flujos de trabajo se complican

La preparación de datos, el entrenamiento, la inferencia y la visualización suelen ejecutarse en equipos distintos. Una única plataforma acelerada simplifica el proceso.

Las nuevas aplicaciones crean nuevos silos

Añadir IA junto a las aplicaciones existentes puede crear islas de hardware. Una plataforma compartida y certificada mantiene todo bajo control.

La gama

Productos de computación acelerada NVIDIA

Todos los sistemas, GPU, productos de red y licencias de software que figuran a continuación pueden suministrarse por separado o como parte de una solución completa. Filtre por tipo, compare las especificaciones clave y solicite un presupuesto.

Sistemas y plataformas

NVIDIA Vera Rubin NVL72

Sistema a escala de rack para IA agéntica y los modelos más grandes

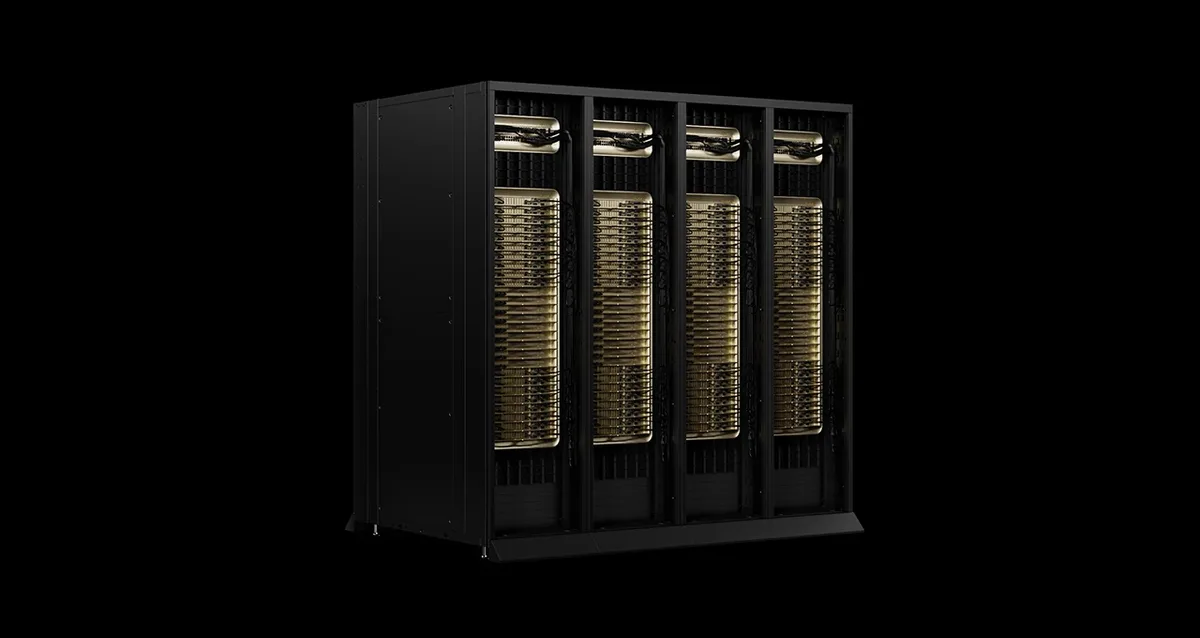
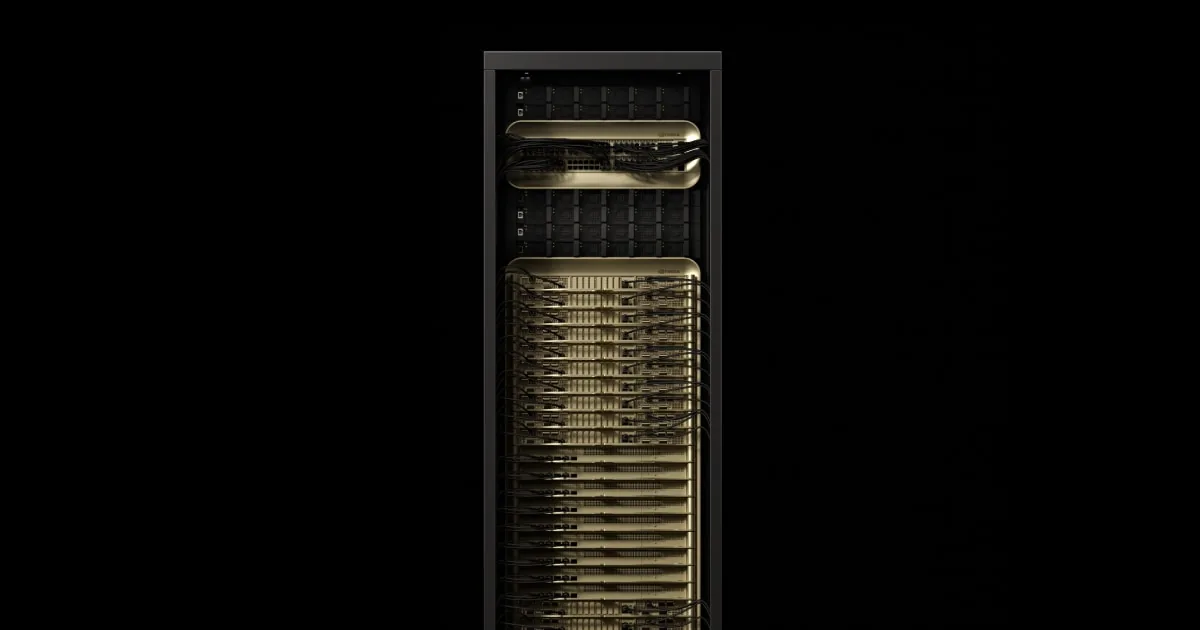
La generación a escala de rack más reciente de NVIDIA une 72 GPU Rubin y 36 CPU Vera en un único dominio NVLink, de modo que un solo rack se comporta como un enorme acelerador.

Para quién es: Fábricas de IA, desarrolladores de modelos y proveedores de servicios que planifican su próximo gran despliegue

Beneficios

  • Muchos más tokens por megavatio que la generación Grace Blackwell, según cifras de NVIDIA
  • Memoria HBM4 dimensionada para modelos de billones de parámetros y de contexto largo
  • Bandejas modulares sin cables que simplifican el mantenimiento en el rack

Especificaciones clave

Configuración72× Rubin GPU, 36× Vera CPU
Memoria GPU20.7 TB HBM4 | 1,400 TB/s
Inferencia NVFP43,600 PFLOPS (sparse)
Ancho de banda NVLink216 TB/s (sixth generation)
Memoria de CPUUp to 54 TB LPDDR5X
FormatoRack, third-generation MGX NVL72

Qué hace Workstation: Comprobamos pronto la alimentación, la refrigeración y la carga del suelo de su instalación, aseguramos la asignación y planificamos la entrega, la instalación y la puesta en marcha en función de su sala de datos.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

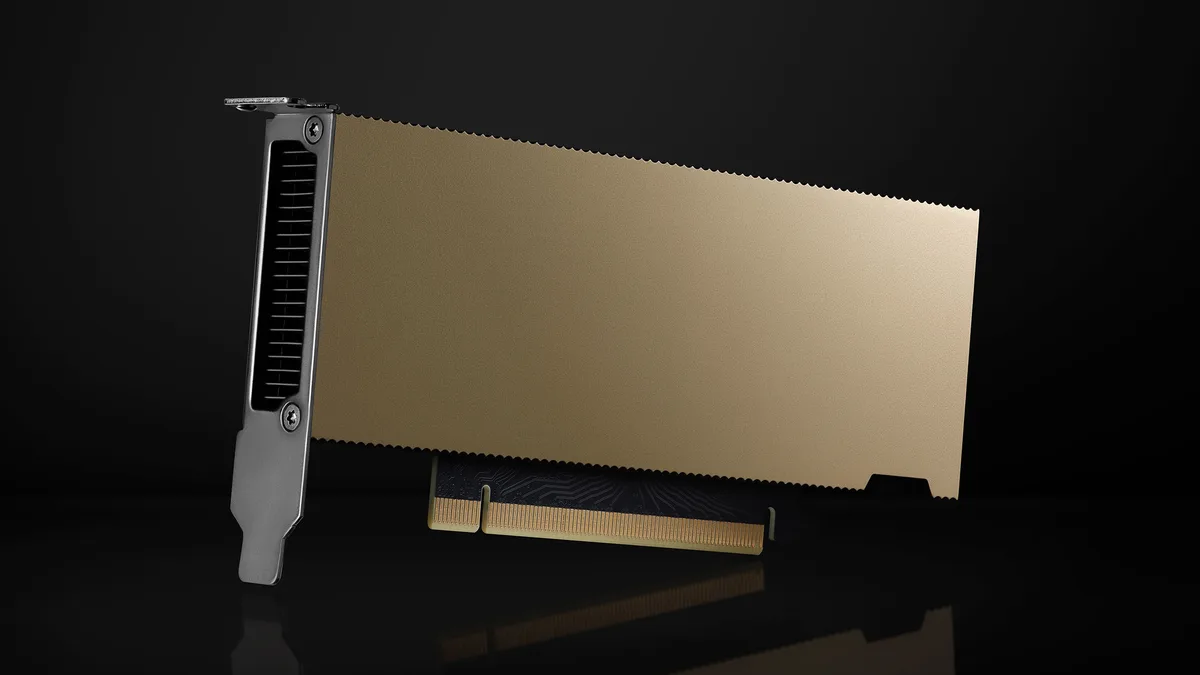
NVIDIA GB300 NVL72 (DGX GB300)

Rack Blackwell Ultra con refrigeración líquida para razonamiento de IA

Treinta y seis CPU Grace y 72 GPU Blackwell Ultra comparten un único tejido NVLink en un solo rack con refrigeración líquida. NVIDIA también lo suministra como DGX GB300.

Para quién es: Organizaciones que ofrecen modelos de razonamiento a muchos usuarios y equipos que entrenan a escala de vanguardia

Beneficios

  • Un gran salto en tokens por segundo y usuario frente a los sistemas basados en Hopper
  • 37 TB de memoria rápida mantienen contextos largos y modelos grandes en un único dominio
  • Las SuperNIC ConnectX-8 dan a cada GPU una ruta de 800 Gb/s hacia la red

Especificaciones clave

GPU72× Blackwell Ultra
CPU36× Grace (2,592 Arm Neoverse V2 cores)
Memoria GPU20 TB | up to 576 TB/s
Memoria rápida37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
Ancho de banda NVLink130 TB/s

Qué hace Workstation: Planificamos la refrigeración líquida y la alimentación con su equipo de instalaciones, coordinamos la entrega del rack integrado y lo ponemos en marcha conforme a una referencia validada.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

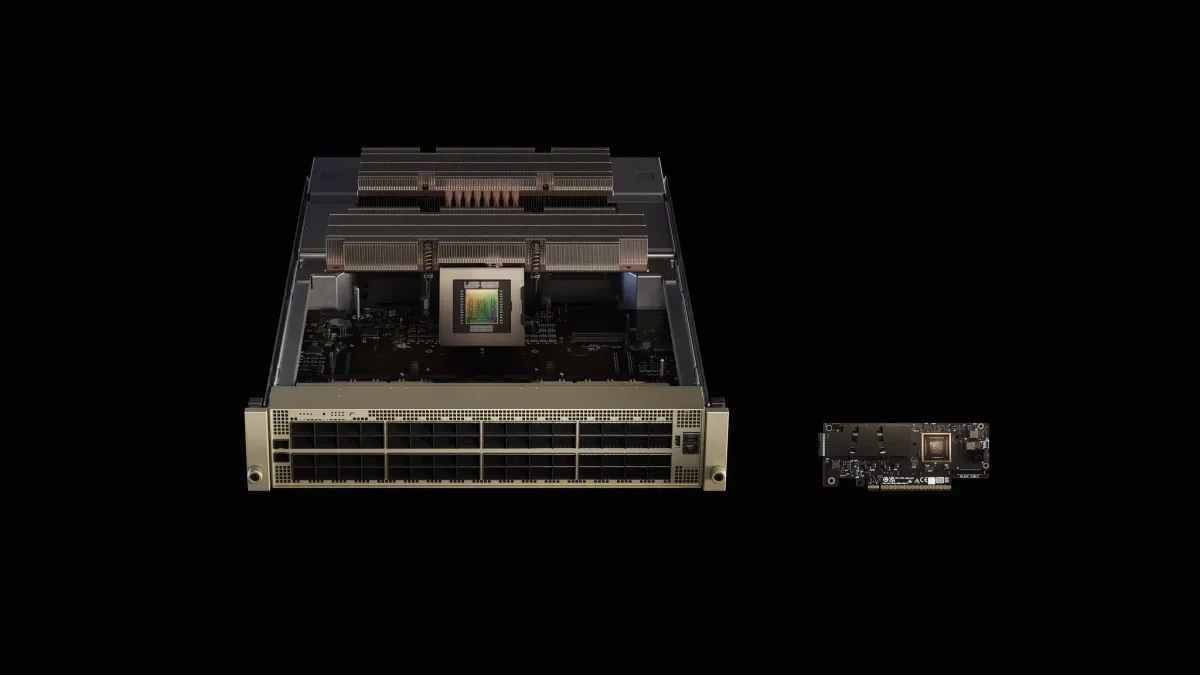
NVIDIA GB200 NVL72 (DGX GB200)

Sistema Grace Blackwell a escala de rack en un único dominio NVLink

El primer rack Grace Blackwell: 72 GPU Blackwell y 36 CPU Grace conectadas mediante NVLink y con refrigeración líquida, para entrenamientos muy grandes e inferencia en tiempo real.

Para quién es: Equipos que entrenan o sirven modelos de billones de parámetros y necesitan un gran conjunto de memoria de GPU compartida

Beneficios

  • Inferencia en tiempo real sobre modelos de lenguaje muy grandes, muchas veces más rápida que H100 según cifras de NVIDIA
  • La refrigeración líquida aumenta la densidad y la eficiencia energética
  • NVLink de quinta generación ofrece 1.8 TB/s entre dos GPU cualesquiera

Especificaciones clave

Configuración72× Blackwell GPU, 36× Grace CPU
Memoria GPU13.4 TB HBM3E | 576 TB/s
NVFP4 Tensor Core1,440 PFLOPS sparse | 720 PFLOPS dense
Ancho de banda NVLink130 TB/s
Memoria de CPU17 TB LPDDR5X | 14 TB/s
RefrigeraciónLiquid cooled

Qué hace Workstation: Evaluamos su instalación para la refrigeración líquida, gestionamos la entrega y la integración con su red y almacenamiento, y damos soporte al rack tras la puesta en producción.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

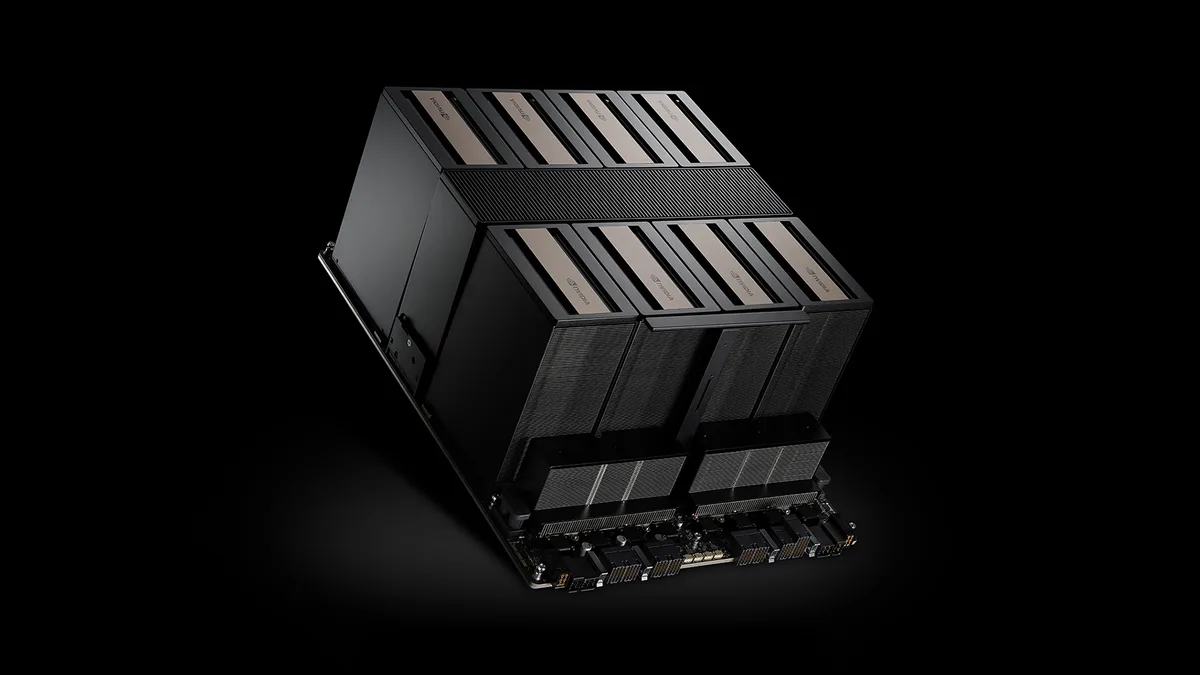
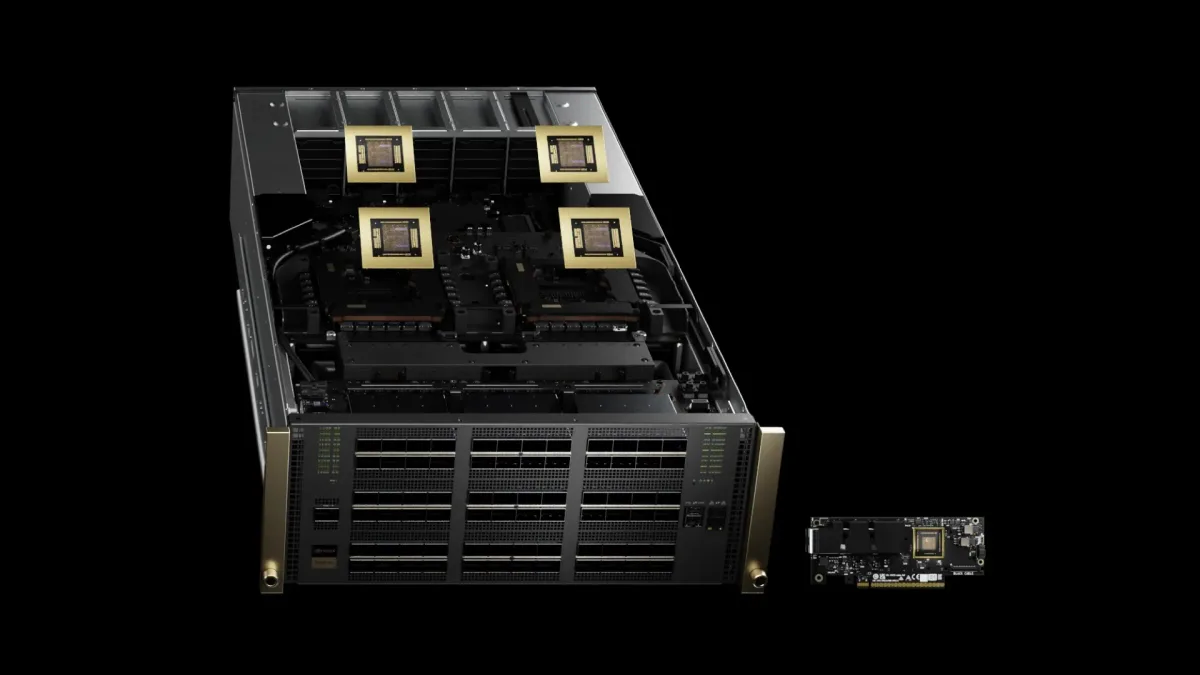
NVIDIA DGX B300

Ocho GPU Blackwell Ultra en un sistema DGX

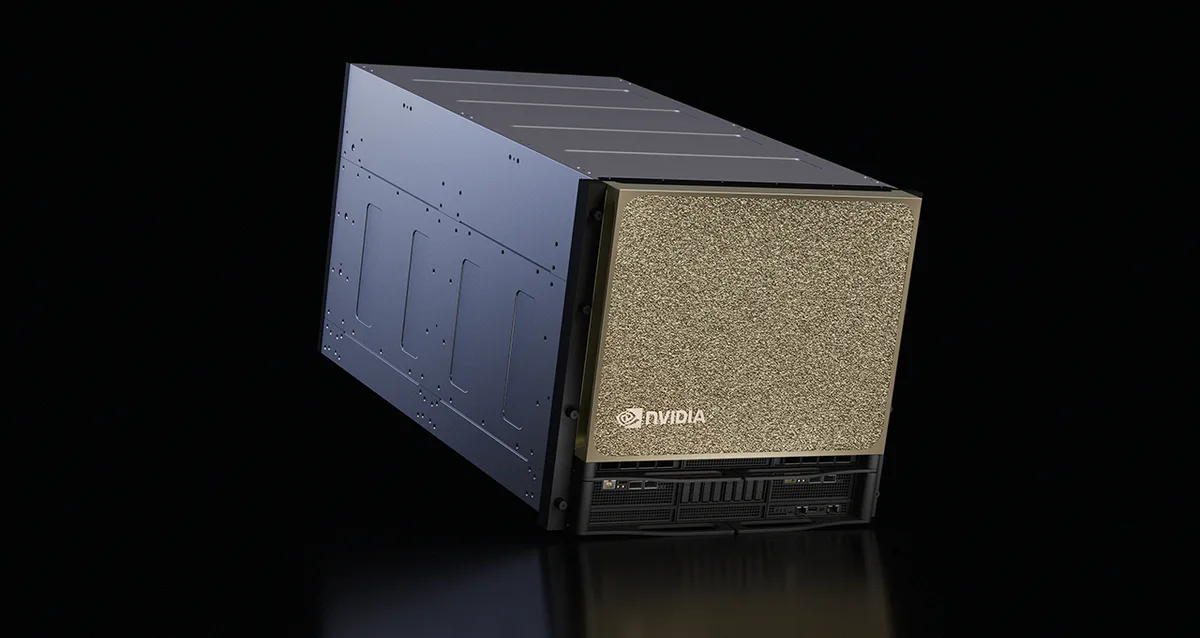
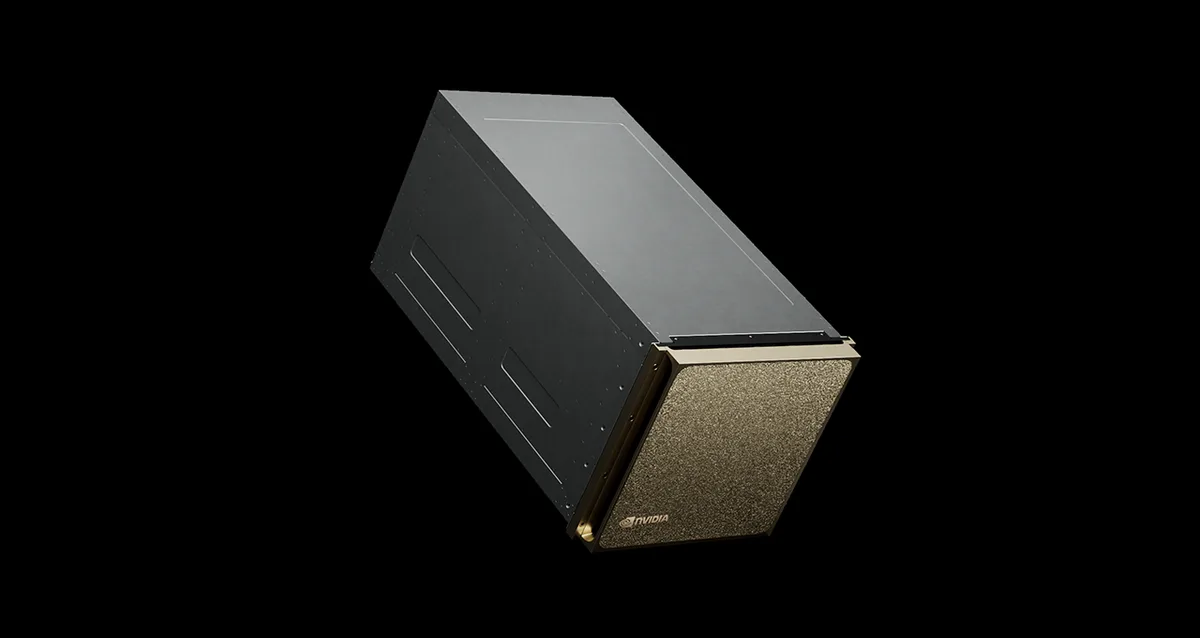
Un servidor DGX autónomo con ocho GPU Blackwell Ultra, redes NVIDIA y toda la pila de software DGX, listo para funcionar de forma independiente o integrarse en un BasePOD o SuperPOD.

Para quién es: Empresas que construyen su primera fábrica de IA seria y equipos que prefieren el diseño de referencia de NVIDIA a una solución a medida

Beneficios

  • 2.3 TB de memoria de GPU en un solo nodo para modelos grandes
  • Redes ConnectX-8 y BlueField-3 integradas para escalar horizontalmente
  • El software DGX mantiene todos los nodos de un clúster coherentes desde el primer día

Especificaciones clave

GPU8× Blackwell Ultra
Memoria GPU2.3 TB total
Rendimiento de IA72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
Red8× ConnectX-8, 2× BlueField-3 DPU

Qué hace Workstation: Comprobamos la alimentación y el flujo de aire del rack, entregamos e instalamos el sistema en el rack, lo conectamos a su tejido de red y lo entregamos con DGX OS y los controladores validados.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
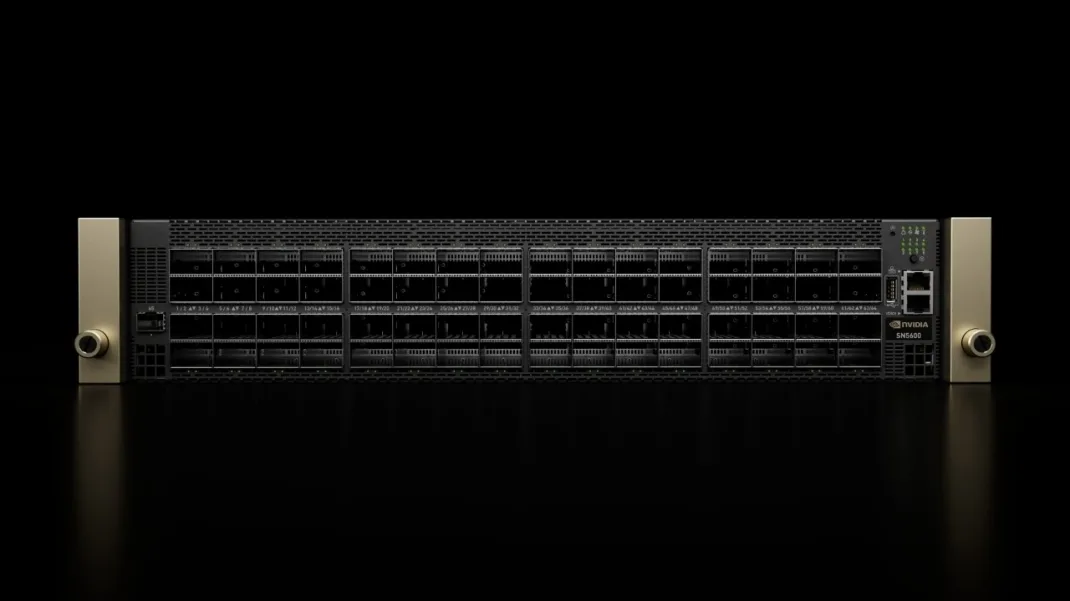
Sistemas y plataformas

NVIDIA DGX B200

DGX Blackwell probado para entrenamiento e inferencia

Ocho GPU Blackwell conectadas por NVLink en un único chasis DGX, un componente básico ampliamente desplegado para la IA on-premise.

Para quién es: Equipos que pasan de Hopper o de GPU en la nube a una plataforma Blackwell propia

Beneficios

  • Una sola plataforma para entrenamiento, ajuste fino e inferencia
  • 1,440 GB de memoria de GPU repartidos entre ocho GPU conectadas por NVLink
  • Se adapta a los diseños de referencia BasePOD y SuperPOD a medida que crece

Especificaciones clave

GPU8× Blackwell
Memoria GPU1,440 GB total
Rendimiento de IA72 PFLOPS training, 144 PFLOPS inference
Red8× ConnectX-7, 2× BlueField-3 DPU

Qué hace Workstation: Lo dimensionamos según sus modelos, lo entregamos e instalamos, y configuramos los controladores, CUDA y NVIDIA AI Enterprise antes de la entrega.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
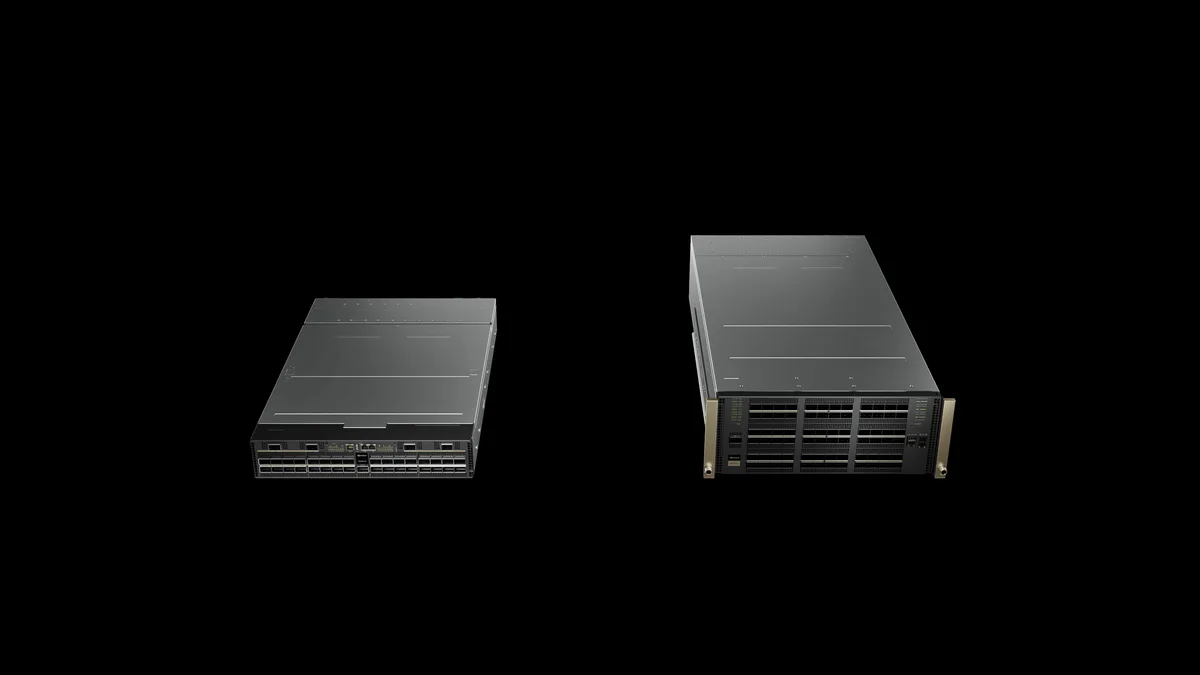
Sistemas y plataformas

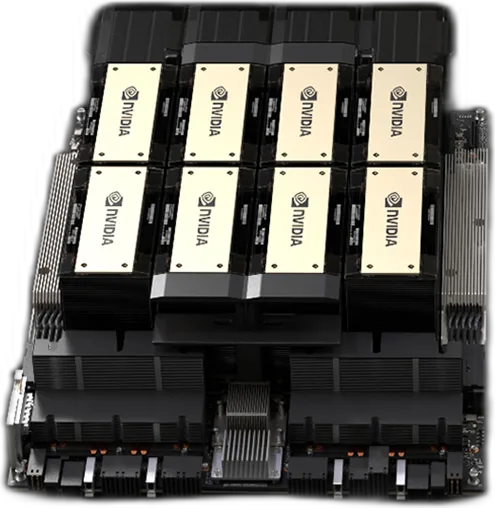
NVIDIA HGX

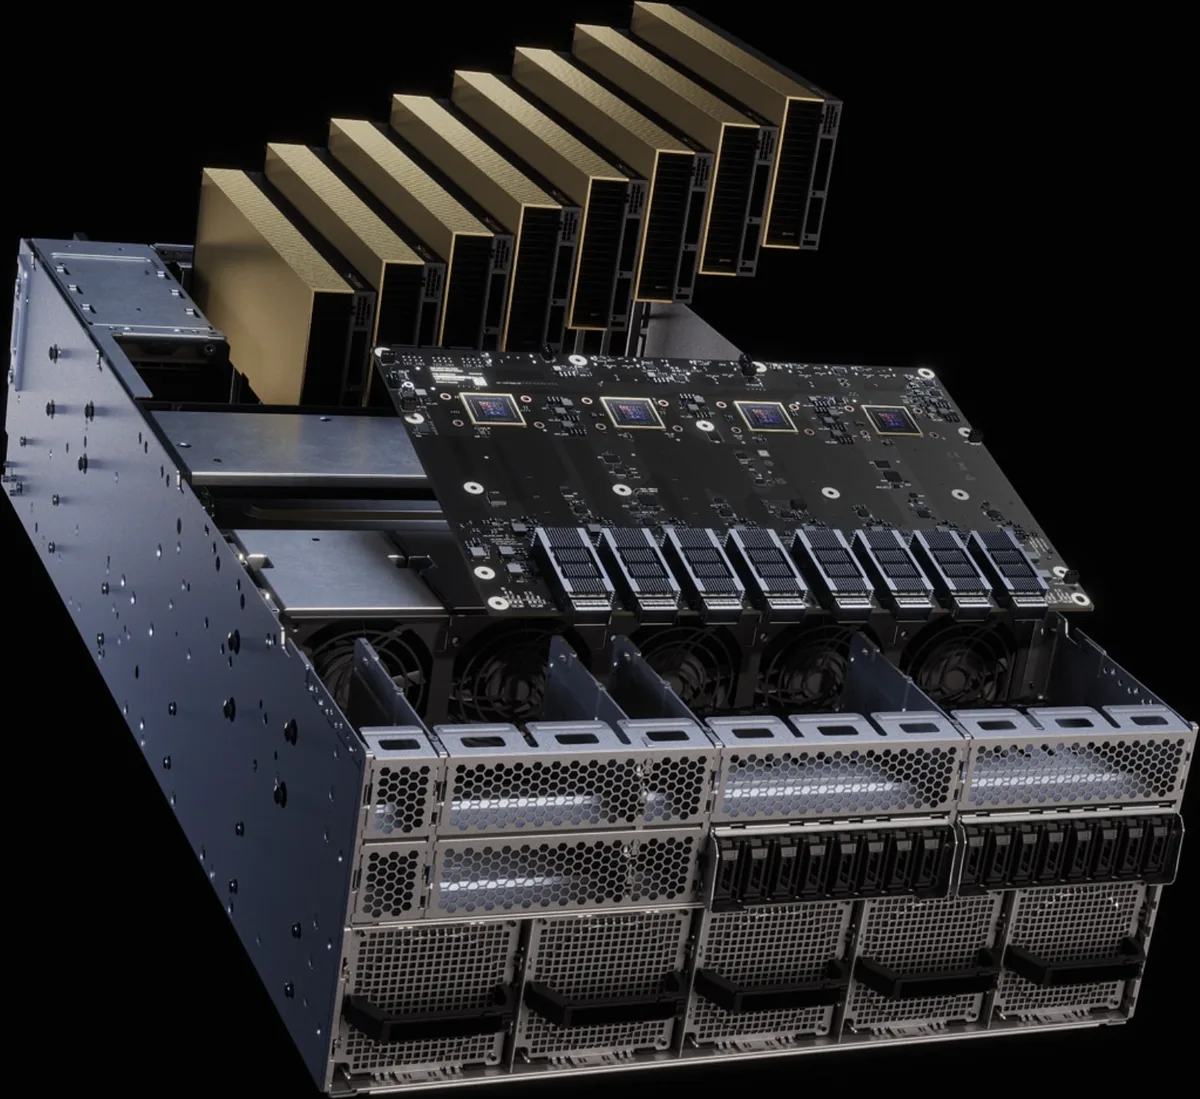
Placa base de ocho GPU dentro de servidores de partners

HGX es la placa base de GPU conectadas por NVLink de NVIDIA que los fabricantes de servidores integran en sus propios sistemas, para ofrecerle GPU de gama alta con el chasis, la CPU y la marca de soporte que elija.

Para quién es: Organizaciones que quieren GPU insignia de su proveedor de servidores preferido

Beneficios

  • Elija la marca de servidor, la CPU y el almacenamiento que mejor se adapten a su infraestructura
  • NVLink y NVSwitch conectan las ocho GPU a máxima velocidad
  • Abarca las generaciones Blackwell, Blackwell Ultra y Rubin

Especificaciones clave

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
Ancho de banda NVLink14.4 TB/s total (HGX B300 and B200)

Qué hace Workstation: Adquirimos el servidor HGX de la marca que prefiera, lo sometemos a pruebas de estrés a plena carga en nuestro taller y lo instalamos con su red.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
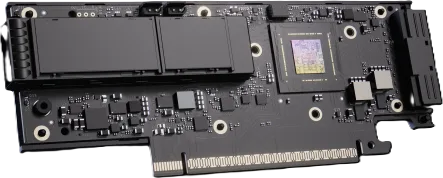
Sistemas y plataformas

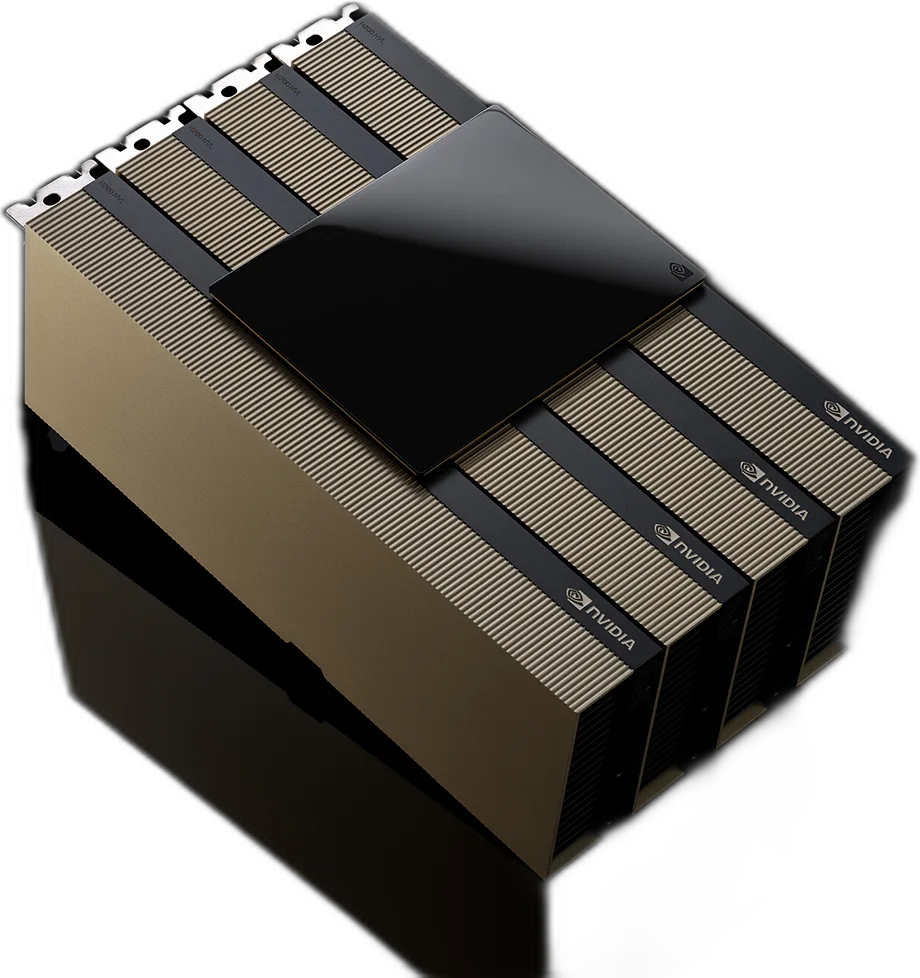
NVIDIA RTX PRO Server

Servidor Blackwell universal para IA empresarial y gráficos

Un servidor para centro de datos con hasta ocho GPU RTX PRO 6000 Blackwell Server Edition que ejecuta IA, simulación, renderizado y estaciones de trabajo virtuales en una sola plataforma. Es el servidor acelerado generalista de NVIDIA, y su página EGX ahora redirige aquí.

Para quién es: Empresas que trasladan cargas de trabajo existentes del centro de datos a GPU junto con nuevos servicios de IA

Beneficios

  • Un solo tipo de servidor para inferencia de IA, computación visual y ciencia de datos
  • Las opciones con refrigeración por aire se adaptan a la mayoría de salas de servidores existentes
  • Validado con NVIDIA AI Enterprise y Omniverse

Especificaciones clave

GPUUp to 8× RTX PRO 6000 Blackwell Server Edition
Memoria GPU800 GB (8-GPU configuration)
Ancho de banda de memoria13 TB/s (8-GPU configuration)
Gráficos RTX3 PFLOPS
ConfiguracionesMGX 2U, 4U and 6U (6U liquid cooled)

Qué hace Workstation: Especificamos el chasis y el número de GPU según sus cargas de trabajo, comprobamos que sea NVIDIA-Certified y después lo montamos, lo sometemos a pruebas de estrés y lo instalamos.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
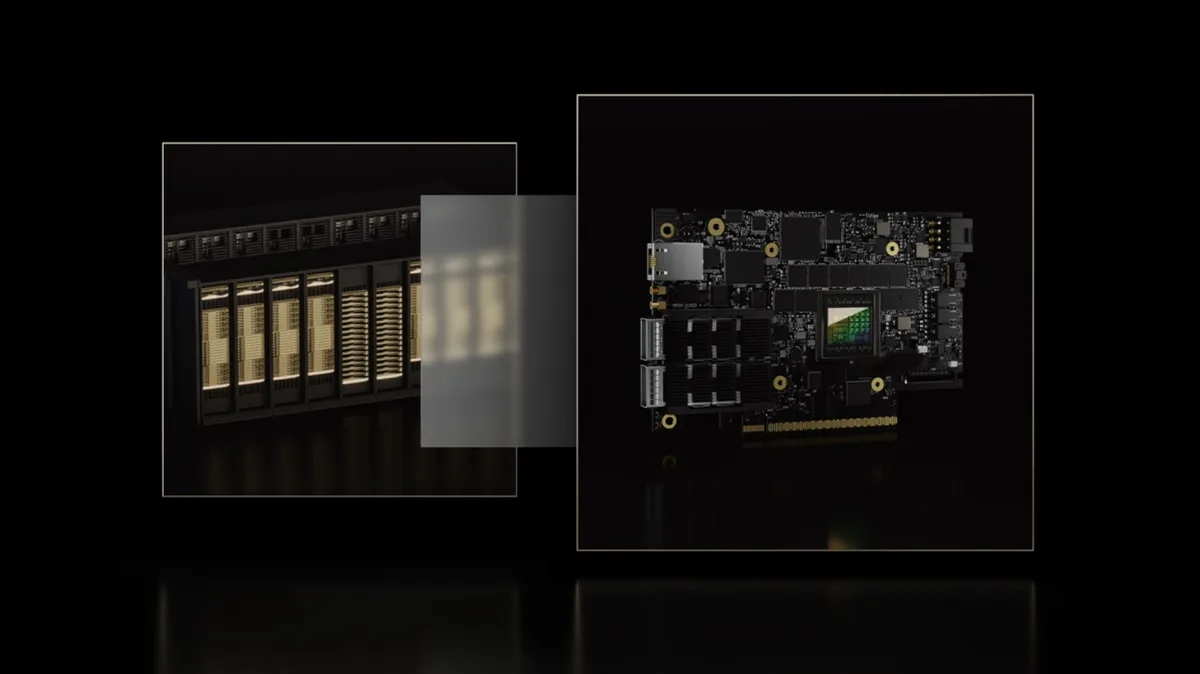
Sistemas y plataformas

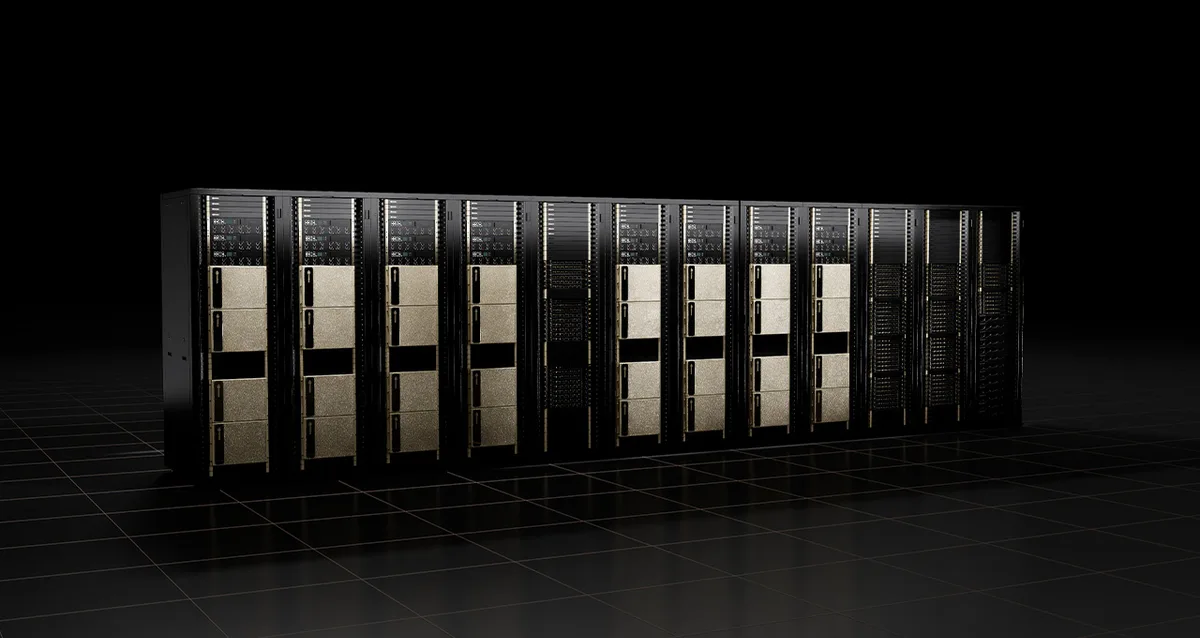
NVIDIA DGX SuperPOD

Plano llave en mano para fábricas de IA a escala

Una arquitectura de referencia de pila completa que combina sistemas DGX, redes NVIDIA, almacenamiento certificado y software de gestión en unidades escalables y replicables.

Para quién es: Laboratorios de investigación, grandes empresas y proveedores de servicios de IA que construyen clústeres de cientos o miles de GPU

Beneficios

  • Un diseño probado elimina gran parte del riesgo de integración
  • Escala a decenas de miles de GPU en unidades replicables
  • Incluye Mission Control y Base Command Manager para las operaciones

Especificaciones clave

TipoReference architecture
Componente básicoScalable units of DGX systems
EscalaUp to tens of thousands of GPUs
AlmacenamientoNVIDIA-certified partner storage
SoftwareNVIDIA AI Enterprise, Base Command Manager, Mission Control

Qué hace Workstation: Dirigimos el diseño con NVIDIA y los partners de almacenamiento, gestionamos el plan del proyecto, instalamos las unidades escalables y seguimos siendo su contacto de soporte.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

NVIDIA DGX BasePOD

Diseño de referencia para su primer clúster DGX

Un diseño probado para dos o más sistemas DGX con redes, almacenamiento y software de clúster a juego: más pequeño que un SuperPOD, pero construido de la misma manera.

Para quién es: Equipos que pasan de un sistema DGX a un pequeño clúster compartido

Beneficios

  • Empiece con dos sistemas y añada más sin rediseñar
  • Redes y almacenamiento adaptados a las GPU
  • Software de clúster incluido para planificación y monitorización

Especificaciones clave

TipoReference architecture
Escala2 or more DGX systems
RedPer reference architecture
AlmacenamientoPartner storage
SoftwareNVIDIA AI Enterprise, Base Command

Qué hace Workstation: Dimensionamos el clúster, suministramos todas las piezas, lo montamos en rack y lo cableamos, y configuramos la planificación para que sus equipos puedan compartirlo desde el primer día.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

CPU NVIDIA Grace y Vera

CPU Arm para centros de datos diseñadas para fábricas de IA

Las CPU propias de NVIDIA se conectan a sus GPU mediante NVLink-C2C. El Grace CPU Superchip ya se suministra en servidores de partners, y su sucesor, Vera, está orientado a la IA agéntica.

Para quién es: Centros de HPC, constructores de nubes y cualquiera que ejecute procesos intensivos en CPU junto a las GPU

Beneficios

  • Gran ancho de banda de memoria gracias a LPDDR5X
  • El doble de rendimiento con el mismo consumo que las principales CPU tradicionales, según cifras de NVIDIA
  • Un enlace coherente y de alta velocidad con las GPU NVIDIA

Especificaciones clave

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Ancho de banda de memoria de GraceUp to 1 TB/s LPDDR5X
Vera CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

Qué hace Workstation: Buscamos el servidor de partner que mejor se adapta a su pila de software, probamos con usted sus aplicaciones en Arm y después montamos el resultado y le damos soporte.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

NVIDIA OVX

Servidores L40S para Omniverse y gemelos digitales

OVX es el diseño de servidor validado de NVIDIA para Omniverse, que combina GPU L40S con redes ConnectX-7 o BlueField-3 para simulación, renderizado e IA.

Para quién es: Fabricantes, arquitectos y equipos de ingeniería que crean gemelos digitales industriales

Beneficios

  • Un solo servidor para gráficos, simulación e inferencia de IA
  • Validado para Omniverse y NVIDIA AI Enterprise
  • Escala a cientos de servidores sobre un tejido de red de alta velocidad

Especificaciones clave

GPU4× or 8× NVIDIA L40S
CPU2× Intel Xeon Gold or 2× AMD EPYC
Memoria del host384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
Almacenamiento1 TB NVMe boot, 2× 4 TB NVMe
RedConnectX-7 or BlueField-3

Qué hace Workstation: Montamos servidores con el patrón OVX de partners certificados, configuramos Omniverse y los controladores, y los conectamos a sus herramientas de diseño.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

NVIDIA AGX (Jetson AGX Thor)

Ordenadores de IA para robots y máquinas autónomas

AGX es la plataforma de NVIDIA para máquinas autónomas. Su buque insignia actual, Jetson AGX Thor, lleva una GPU Blackwell a robots, vehículos y máquinas inteligentes.

Para quién es: Equipos de robótica, automoción e industria que integran IA en máquinas

Beneficios

  • Ejecuta modelos de percepción e IA generativa en la propia máquina
  • Su bajo consumo se adapta a diseños móviles y embebidos
  • Usa el mismo software CUDA que las plataformas de centro de datos de NVIDIA

Especificaciones clave

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
Rendimiento de IA2070 TFLOPS (FP4)
OpcionesDeveloper kit, or T5000 and T4000 production modules

Qué hace Workstation: Suministramos kits de desarrollo y módulos de producción, le ayudamos a elegir placas portadoras y carcasas, y le acompañamos del prototipo al despliegue.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

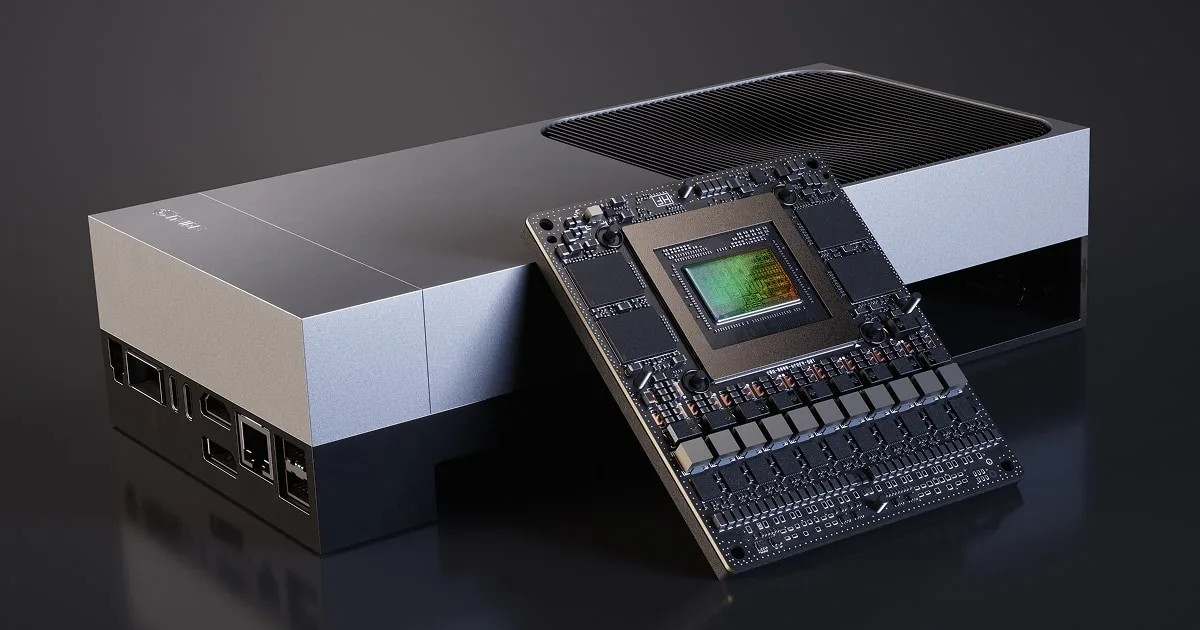
NVIDIA IGX Thor

IA industrial en el edge con seguridad funcional

IGX es la plataforma empresarial de NVIDIA para IA física en el edge industrial y médico, con una isla de seguridad dedicada y soporte de software a largo plazo.

Para quién es: Fabricantes de dispositivos médicos, fábricas y operadores de infraestructuras que necesitan certificación de seguridad y una larga vida de soporte

Beneficios

  • Diseño de seguridad funcional orientado a ISO 26262 e IEC 61508
  • Diez años de soporte de software empresarial de NVIDIA
  • GPU RTX PRO Blackwell opcional para modelos más exigentes

Especificaciones clave

Rendimiento de IAUp to 5,581 TFLOPS FP4 (sparse) with discrete GPU
GPU integrada2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
Memoria128 GB LPDDR5X, 273 GB/s
Consumo40–130 W, up to 300 W for the discrete GPU

Qué hace Workstation: Suministramos kits de desarrollo y sistemas de producción, le ayudamos a planificar la documentación para la certificación y damos soporte al despliegue en sus instalaciones.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗
Sistemas y plataformas

NVIDIA Groq 3 LPX

Rack de inferencia de baja latencia para Vera Rubin

LPX es un rack de 256 aceleradores de inferencia LPU que trabaja junto a Vera Rubin NVL72 para generar tokens de forma rápida y predecible en IA interactiva y agéntica.

Para quién es: Proveedores de servicios de IA cuyos usuarios necesitan tiempos de respuesta rápidos y constantes

Beneficios

  • Generación de tokens determinista y de baja latencia
  • Un rendimiento por megavatio mucho mayor para modelos de billones de parámetros, según las proyecciones de NVIDIA
  • Un enlace directo y de baja latencia con los racks NVL72

Especificaciones clave

Aceleradores256 LPUs per rack
Memoria en chip128 GB SRAM per rack (500 MB per LPU)
Ancho de banda SRAM40 PB/s per rack
Ancho de banda de escalado vertical640 TB/s per rack
FormatoNVIDIA MGX ETL rack

Qué hace Workstation: Evaluamos cómo encaja en sus planes con Vera Rubin, confirmamos la disponibilidad con NVIDIA y planificamos la instalación junto a sus otros racks.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

GPU para centros de datos

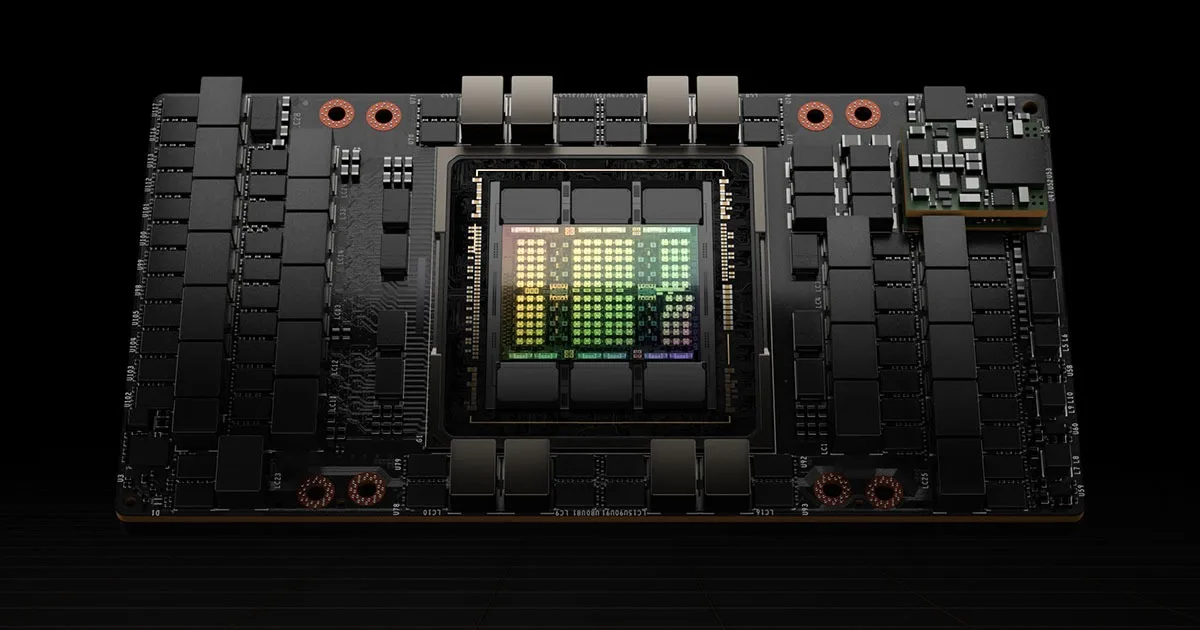
NVIDIA H200 (SXM)

GPU Hopper con 141 GB de HBM3e

La H200 mantiene la arquitectura Hopper, pero añade mucha más memoria y más rápida, lo que beneficia la inferencia de modelos grandes y el HPC limitado por memoria. La versión SXM se instala en servidores HGX.

Para quién es: Equipos que ejecutan grandes modelos de lenguaje y códigos HPC en servidores HGX

Beneficios

  • 141 GB por GPU permiten alojar modelos más grandes sin dividirlos
  • Un mayor ancho de banda de memoria acelera el trabajo limitado por memoria
  • Ejecuta el mismo software CUDA que H100

Especificaciones clave

ArquitecturaNVIDIA Hopper
Memoria GPU141 GB HBM3e
FormatoSXM (HGX)
RefrigeraciónPassive (server airflow)

Qué hace Workstation: Suministramos la H200 dentro de un servidor HGX certificado, la sometemos a pruebas de estrés y la instalamos con sus controladores y su pila de software.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

GPU para centros de datos

NVIDIA H200 NVL

GPU Hopper de 141 GB para servidores PCIe con refrigeración por aire

La versión PCIe de la H200 para racks empresariales estándar. Los puentes NVLink permiten emparejar tarjetas para modelos que necesitan más memoria.

Para quién es: Empresas que añaden inferencia de modelos grandes a salas de servidores existentes con refrigeración por aire

Beneficios

  • Gran memoria de GPU sin pasar a refrigeración líquida
  • Los puentes NVLink unen GPU para modelos más grandes
  • Compatible con servidores NVIDIA-Certified convencionales

Especificaciones clave

ArquitecturaNVIDIA Hopper
Memoria GPU141 GB HBM3e
FormatoPCIe, dual slot
RefrigeraciónPassive (server airflow)

Qué hace Workstation: Comprobamos la alimentación, el flujo de aire y la disposición de ranuras de su chasis, y después instalamos, probamos y entregamos las tarjetas o un servidor completo.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

GPU para centros de datos

NVIDIA H100 PCIe 80 GB

GPU Hopper para entrenamiento e inferencia en servidores PCIe

La H100 PCIe lleva el Transformer Engine y la computación confidencial de Hopper a servidores estándar.

Para quién es: Equipos con servidores de GPU PCIe existentes que necesitan el rendimiento probado de Hopper

Beneficios

  • El Transformer Engine acelera el entrenamiento y la inferencia de modelos de lenguaje
  • Multi-Instance GPU divide una tarjeta en instancias aisladas
  • Compatibilidad por hardware con la computación confidencial

Especificaciones clave

ArquitecturaNVIDIA Hopper
Memoria GPU80 GB HBM2e
FormatoDual-slot, full height, full length
RefrigeraciónPassive (server airflow)
InterfazPCIe

Qué hace Workstation: Instalamos la H100 en servidores para los que está certificada, la sometemos a pruebas de estrés y configuramos CUDA, los controladores y las licencias de vGPU o AI Enterprise que necesite.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

GPU para centros de datos

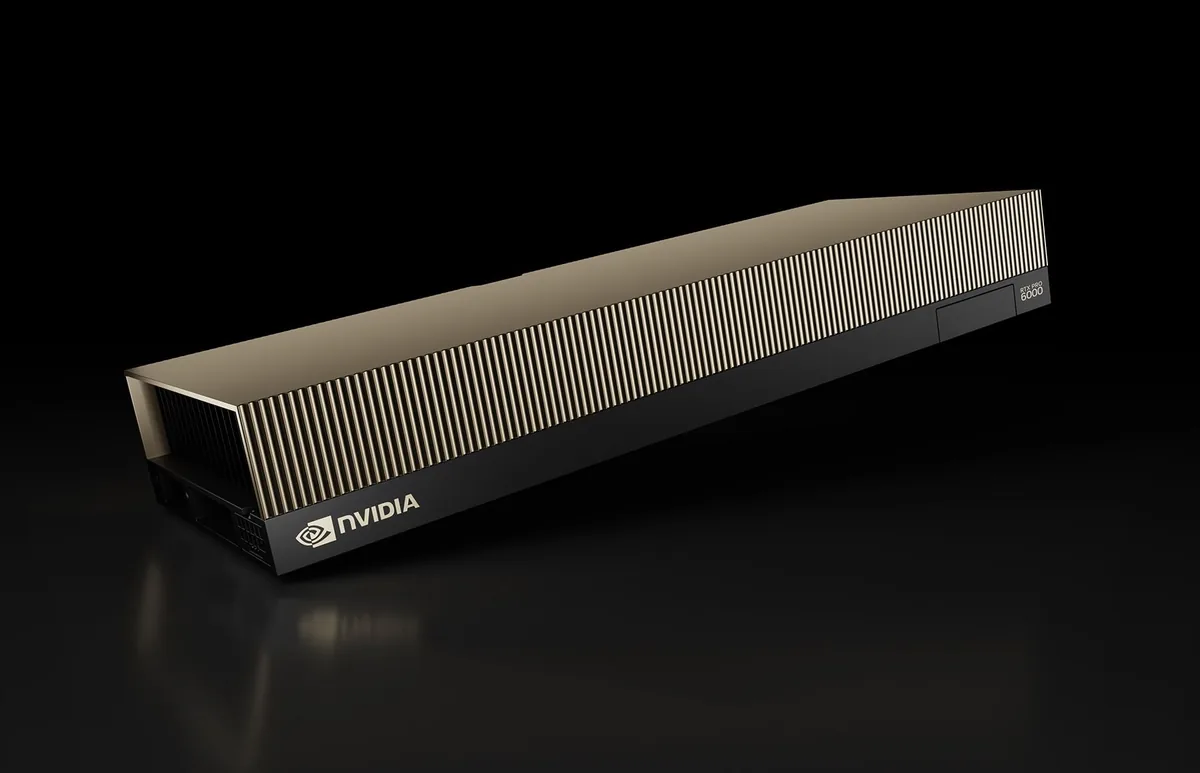
NVIDIA RTX PRO 6000 Blackwell Server Edition

GPU Blackwell de 96 GB para servidores en rack

Una tarjeta Blackwell con refrigeración pasiva y 96 GB de memoria para inferencia de IA, renderizado, simulación y estaciones de trabajo virtuales en el centro de datos.

Para quién es: Empresas que consolidan cargas de trabajo de IA y gráficos en un solo tipo de GPU

Beneficios

  • 96 GB por GPU para modelos grandes y escenas de gran tamaño
  • Ejecuta tanto IA como gráficos profesionales
  • Consumo configurable para adaptarse al servidor

Especificaciones clave

ArquitecturaNVIDIA Blackwell
Memoria GPU96 GB GDDR7 with ECC
Consumo máximoUp to 600 W (configurable)
InterfazPCIe 5.0 x16
FormatoDual-slot, passive (server airflow)

Qué hace Workstation: Suministramos las tarjetas por separado o en un RTX PRO Server, y las probamos a plena carga antes de la entrega.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

GPU para centros de datos

NVIDIA RTX PRO 4500 Blackwell Server Edition

GPU Blackwell de una sola ranura para servidores de alta densidad

Una GPU Blackwell compacta de 32 GB con refrigeración pasiva que permite instalar muchas tarjetas en un servidor para inferencia, vídeo y escritorios virtuales.

Para quién es: Equipos que escalan la inferencia o los escritorios virtuales para muchos usuarios con un menor coste por GPU

Beneficios

  • El diseño de una sola ranura permite más GPU por servidor
  • 32 GB de GDDR7 para modelos de tamaño medio
  • Su menor consumo se adapta a los racks existentes

Especificaciones clave

ArquitecturaNVIDIA Blackwell
Memoria GPU32 GB GDDR7
FormatoSingle slot, 4.4" H × 10.5" L
RefrigeraciónPassive (server airflow)

Qué hace Workstation: Calculamos cuántas tarjetas pueden alimentar y refrigerar sus servidores, y después montamos y probamos la configuración.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

GPU para centros de datos

NVIDIA L40S

Todoterreno de 48 GB para IA y gráficos

Una GPU Ada Lovelace para centro de datos equilibrada para inferencia, ajuste fino y gráficos 3D, y la GPU del diseño OVX de NVIDIA.

Para quién es: Equipos que necesitan una sola GPU para cargas de IA y visuales

Beneficios

  • Excelente rendimiento en inferencia y ajuste fino para su precio
  • Trazado de rayos por hardware para renderizado y Omniverse
  • Una tarjeta PCIe estándar para servidores convencionales

Especificaciones clave

ArquitecturaNVIDIA Ada Lovelace
Memoria GPU48 GB GDDR6 with ECC
FormatoDual-slot, 4.4" H × 10.5" L
RefrigeraciónPassive (server airflow)
InterfazPCIe

Qué hace Workstation: Emparejamos la L40S con servidores certificados, sometemos el equipo a pruebas de estrés y lo instalamos con los controladores y las licencias configurados.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

GPU para centros de datos

NVIDIA L40

GPU de 48 GB para renderizado y estaciones de trabajo virtuales

La L40 se centra en los gráficos: renderizado, Omniverse y estaciones de trabajo virtuales en el centro de datos.

Para quién es: Equipos de diseño y medios que trasladan sus estaciones de trabajo al centro de datos

Beneficios

  • 48 GB para escenas y recursos de gran tamaño
  • Compatible con el software de GPU virtual de NVIDIA
  • Refrigeración pasiva para servidores estándar

Especificaciones clave

ArquitecturaNVIDIA Ada Lovelace
Memoria GPU48 GB GDDR6 with ECC
FormatoDual-slot, 4.4" H × 10.5" L
RefrigeraciónPassive (server airflow)
InterfazPCIe

Qué hace Workstation: Configuramos perfiles y licencias de vGPU para que sus usuarios dispongan de estaciones de trabajo remotas que se sienten locales.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

GPU para centros de datos

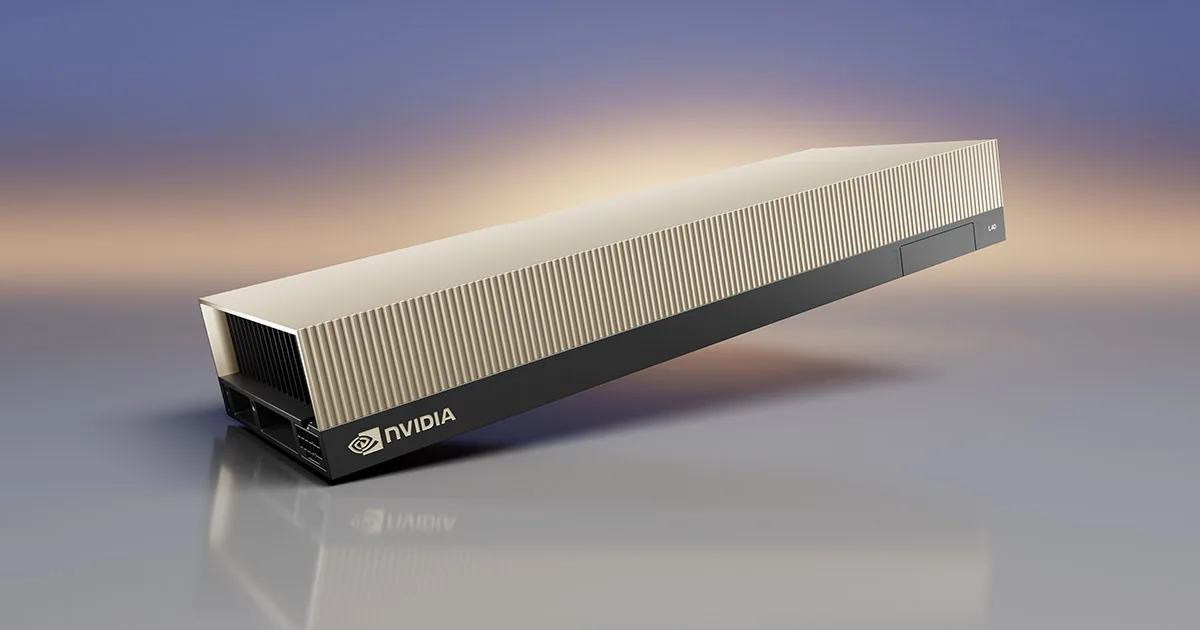
NVIDIA L4

GPU de perfil bajo para inferencia y vídeo eficientes

Una tarjeta Ada Lovelace pequeña y de bajo consumo para IA de vídeo, inferencia y escritorios virtuales, del edge al centro de datos.

Para quién es: Organizaciones que añaden IA a muchos servidores o a ubicaciones edge con presupuestos de energía ajustados

Beneficios

  • Su bajo consumo y su formato de perfil bajo encajan en casi cualquier servidor
  • Muy adecuada para analítica de vídeo e inferencia
  • Escala de forma económica en muchos nodos

Especificaciones clave

ArquitecturaNVIDIA Ada Lovelace
Memoria GPU24 GB GDDR6
FormatoSingle-slot, low profile
RefrigeraciónPassive (server airflow)
InterfazPCIe

Qué hace Workstation: Comprobamos la compatibilidad con sus servidores existentes, suministramos las tarjetas y configuramos los controladores y el software de inferencia.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Red

Plataforma Ethernet NVIDIA Spectrum-X

Ethernet optimizado para fábricas de IA

Spectrum-X combina switches Ethernet Spectrum con SuperNIC Spectrum-X para ofrecer a los clústeres de IA un Ethernet predecible y de alto rendimiento.

Para quién es: Organizaciones que quieren un tejido de red para IA que su equipo de redes ya sabe gestionar

Beneficios

  • Mayor ancho de banda efectivo para el tráfico entre GPU que el Ethernet estándar
  • Utiliza herramientas y conocimientos de Ethernet conocidos
  • Forma parte de los diseños de fábrica de IA validados por NVIDIA

Especificaciones clave

TipoEthernet networking platform
ComponentesNVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
Caso de usoAI clusters and AI factories

Qué hace Workstation: Diseñamos el tejido de red, suministramos switches, SuperNIC y cables, lo instalamos y probamos, y lo documentamos para su equipo.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Red

Plataforma NVIDIA Quantum-X800 InfiniBand

InfiniBand de nueva generación para entrenamiento a gran escala

Los switches Quantum-X800 y las SuperNIC ConnectX-8 forman el tejido InfiniBand de mayor rendimiento de NVIDIA para entrenamiento de IA y HPC.

Para quién es: Centros de HPC y equipos de IA que entrenan a gran escala

Beneficios

  • Latencia muy baja para trabajos estrechamente acoplados
  • Diseñado para los mayores clústeres de entrenamiento y HPC
  • Gestionado y monitorizado con UFM

Especificaciones clave

TipoInfiniBand networking platform
ComponentesNVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
Caso de usoLarge-scale AI training and HPC

Qué hace Workstation: Diseñamos la topología, suministramos y cableamos cada enlace, y ponemos en marcha el tejido con la monitorización UFM ya implantada.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Red

Switches Ethernet NVIDIA Spectrum

Switches Ethernet para centros de datos de hasta 800 Gb/s

Los switches Spectrum transportan tráfico de IA, almacenamiento y nube, por sí solos o como parte de Spectrum-X.

Para quién es: Equipos de centro de datos y de redes que renuevan su conmutación leaf y spine

Beneficios

  • Velocidades de puerto de hasta 800 Gb/s
  • Funciona en tejidos de IA y en redes generales de centro de datos
  • Se combina con NetQ para operaciones de red y telemetría

Especificaciones clave

TipoEthernet switch family
Velocidad de puertoUp to 800 Gb/s
UsoAI and cloud data-centre fabrics

Qué hace Workstation: Dimensionamos puertos y ópticas, configuramos los switches y los integramos con su red existente.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Red

Switches NVIDIA Quantum InfiniBand

Conmutación de baja latencia para HPC e IA

Los switches Quantum InfiniBand crean los tejidos de baja latencia de los que dependen los clústeres de HPC e IA.

Para quién es: Equipos de computación científica e IA con cargas de trabajo estrechamente acopladas

Beneficios

  • Latencia muy baja entre nodos
  • Probado en clústeres de HPC e IA
  • Gestión centralizada con UFM

Especificaciones clave

TipoInfiniBand switch family
UsoHPC and AI data centres

Qué hace Workstation: Planificamos la topología, suministramos cables y ópticas, e instalamos y verificamos el tejido.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Red

NIC y SuperNIC NVIDIA ConnectX

Adaptadores de red para Ethernet e InfiniBand

Los adaptadores ConnectX conectan los servidores al tejido de red. Las SuperNIC como ConnectX-8 están optimizadas para el tráfico entre GPU en clústeres de IA.

Para quién es: Cualquiera que conecte servidores de GPU o almacenamiento a una red de alta velocidad

Beneficios

  • Una sola familia para Ethernet e InfiniBand
  • Las SuperNIC dan a cada GPU su propia ruta de alta velocidad
  • La descarga por hardware reduce la carga de la CPU

Especificaciones clave

TipoNetwork adapter and SuperNIC family
Tejidos de redEthernet and InfiniBand
Velocidad máxima800 Gb/s per GPU (ConnectX-8 SuperNIC)

Qué hace Workstation: Emparejamos adaptadores, cables y transceptores con sus switches y servidores, e instalamos el firmware y los controladores.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Red

DPU NVIDIA BlueField

Unidades de procesamiento de datos para redes, almacenamiento y seguridad

Las DPU BlueField liberan a la CPU del servidor de las tareas de red, almacenamiento y seguridad, y las aíslan en hardware dedicado.

Para quién es: Constructores de nubes, fábricas de IA y organizaciones exigentes en seguridad

Beneficios

  • Libera núcleos de CPU para las aplicaciones
  • Aísla los servicios de infraestructura de las cargas de trabajo de los clientes
  • Programable con NVIDIA DOCA

Especificaciones clave

TipoData processing unit (DPU) family
GeneracionesBlueField-3, BlueField-4
SoftwareNVIDIA DOCA

Qué hace Workstation: Suministramos e instalamos tarjetas BlueField, y le ayudamos a desplegar los servicios DOCA que necesite.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Software

NVIDIA AI Enterprise

Software con soporte para IA en producción

El conjunto de frameworks de IA, microservicios NIM y herramientas de NVIDIA, con soporte empresarial y ramas de versiones de larga duración.

Para quién es: Cualquier organización que ejecute IA en producción sobre GPU NVIDIA

Beneficios

  • Soporte empresarial y ramas de versiones estables
  • Los microservicios NIM agilizan el despliegue de modelos
  • Se ejecuta en sistemas NVIDIA-Certified on-premise o en la nube

Especificaciones clave

LicenciasPer GPU subscription
IncluyeAI frameworks, NIM microservices, pretrained models
SoporteNVIDIA Enterprise Business Standard Support
Prueba90-day evaluation

Qué hace Workstation: Presupuestamos y activamos las licencias, instalamos el software con su hardware y le avisamos antes de la renovación.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Software

NVIDIA Mission Control

Software de operaciones para fábricas de IA

Mission Control automatiza el funcionamiento diario de grandes clústeres de GPU, desde la orquestación de cargas de trabajo hasta las comprobaciones de estado y la recuperación.

Para quién es: Operadores de DGX SuperPOD y otros grandes clústeres de IA

Beneficios

  • Automatiza las operaciones rutinarias del clúster
  • Mejora la resiliencia detectando fallos y recuperándose de ellos
  • Una única vista de cargas de trabajo e infraestructura

Especificaciones clave

TipoAI-factory operations and cluster management software
FuncionesWorkload orchestration, infrastructure resiliency, cluster automation
Modalidad de licenciaConfirmed on quote

Qué hace Workstation: Desplegamos Mission Control con su clúster y formamos a sus operadores para utilizarlo.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Software

NVIDIA Run:ai

Orquestación y planificación de GPU

Run:ai agrupa las GPU entre equipos y las asigna bajo demanda, para que un hardware costoso se mantenga ocupado en lugar de inactivo.

Para quién es: Organizaciones que comparten GPU entre muchos científicos de datos o proyectos

Beneficios

  • Mayor utilización de las GPU gracias a la agrupación dinámica
  • Cuotas, prioridades y control de acceso para un reparto justo
  • Funciona en entornos on-premise, híbridos y en la nube

Especificaciones clave

TipoGPU orchestration and scheduling platform
Se ejecuta enKubernetes
DespliegueOn premises, hybrid or cloud
Modalidad de licenciaConfirmed on quote

Qué hace Workstation: Instalamos Run:ai en su clúster de Kubernetes, configuramos las cuotas con sus equipos y le damos soporte.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Software

NVIDIA Base Command Manager

Aprovisionamiento y monitorización de clústeres

Base Command Manager aprovisiona, monitoriza y gestiona clústeres de GPU, desde unos pocos nodos en adelante.

Para quién es: Equipos de TI que gestionan clústeres de GPU de cualquier tamaño

Beneficios

  • Automatiza el aprovisionamiento en Arm y x86
  • Paneles de estado y monitorización en tiempo real
  • Interfaz web, línea de comandos y API

Especificaciones clave

TipoCluster management software
Licencia gratuitaUp to 8 accelerators per system
Versión actualBase Command Manager 11
InterfacesBaseView web UI, CLI, API

Qué hace Workstation: Instalamos y configuramos Base Command Manager como parte de los clústeres que montamos.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Software

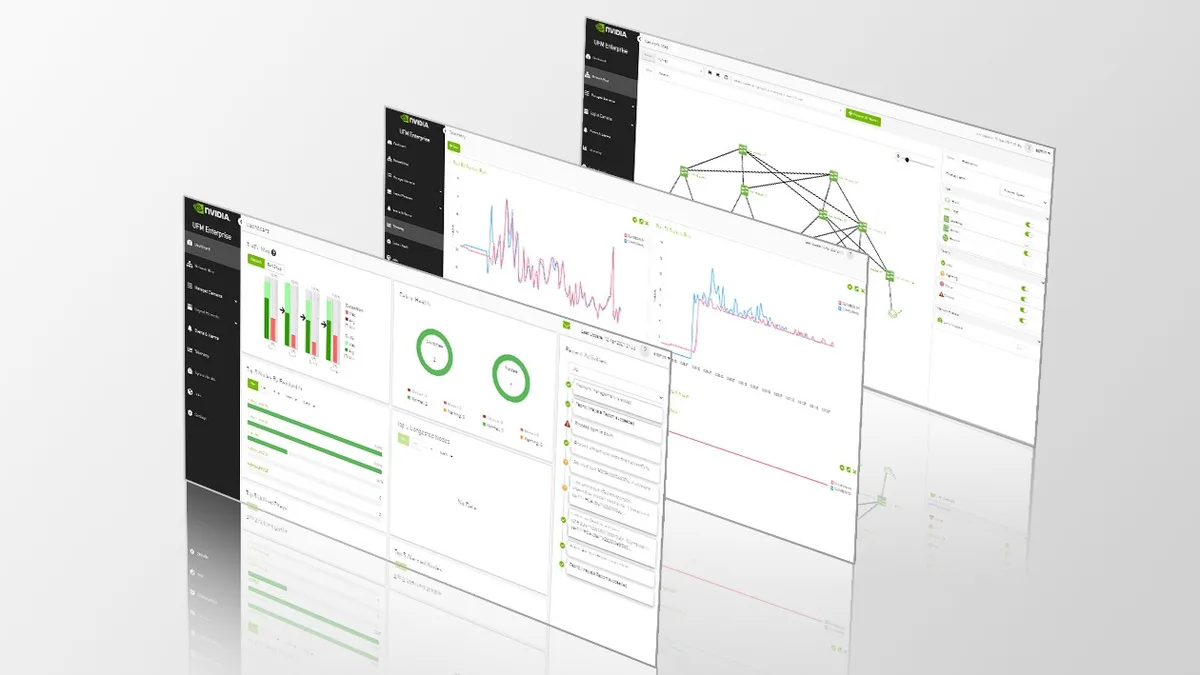
NVIDIA UFM

Unified Fabric Manager para InfiniBand

UFM monitoriza y gestiona los tejidos InfiniBand y ayuda a resolver sus incidencias.

Para quién es: Equipos que gestionan clústeres InfiniBand

Beneficios

  • Telemetría del tejido en tiempo real
  • Localización de fallos más rápida
  • Gestión centralizada de switches y enlaces

Especificaciones clave

TipoInfiniBand fabric management and telemetry software
Compatible conNVIDIA Quantum InfiniBand switches

Qué hace Workstation: Desplegamos UFM con su tejido de red y configuramos alertas acordes con sus procedimientos operativos.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Software

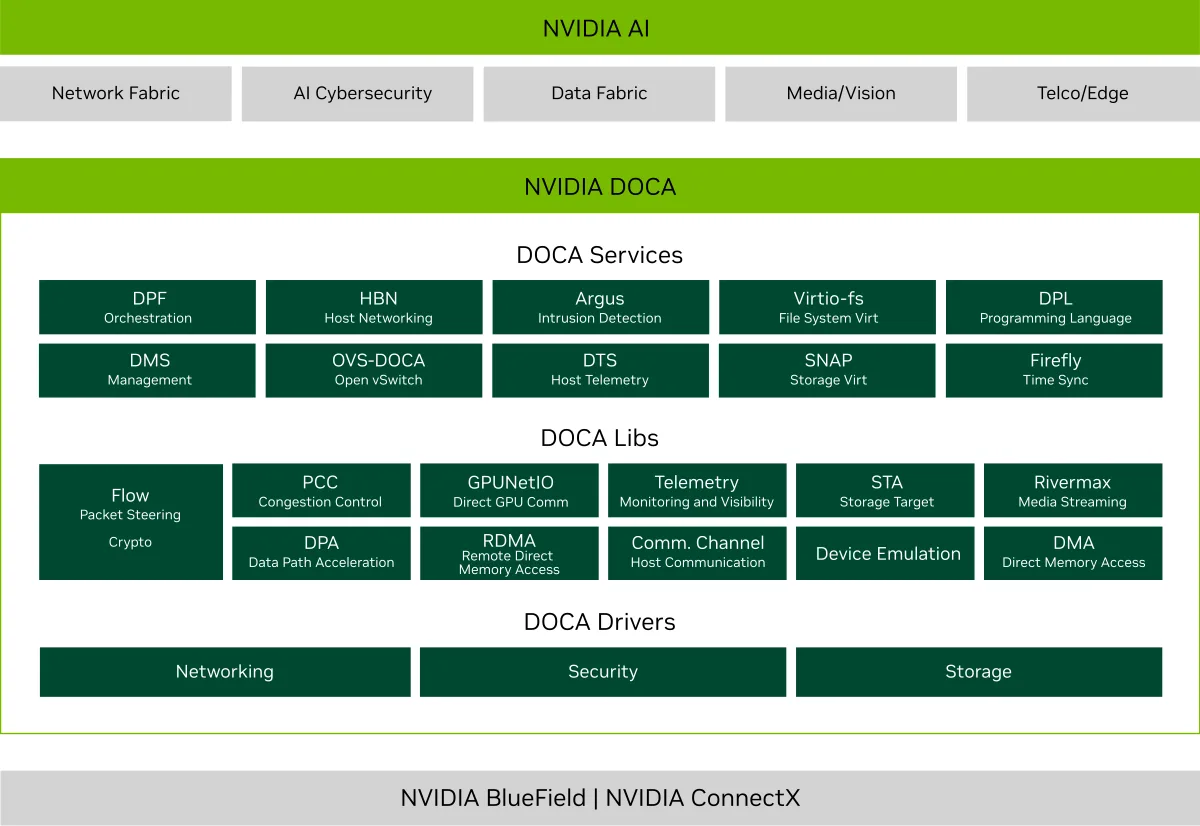
NVIDIA DOCA

Framework de software para BlueField y SuperNIC

DOCA es el SDK y el entorno de ejecución para crear servicios que se ejecutan en DPU BlueField y SuperNIC.

Para quién es: Desarrolladores y equipos de plataforma que trabajan sobre BlueField

Beneficios

  • Un solo framework para todas las generaciones de DPU y SuperNIC
  • Agiliza el desarrollo de servicios descargados
  • Un entorno de ejecución para desplegar esos servicios en producción

Especificaciones clave

TipoSDK and runtime framework
Se ejecuta enNVIDIA BlueField DPUs and SuperNICs

Qué hace Workstation: Le ayudamos a configurar entornos DOCA y a desplegar servicios en las tarjetas BlueField que suministramos.

Precio bajo presupuestoSolicitar presupuesto ↗
Ver en NVIDIA.com ↗

Las especificaciones se resumen a partir de la información publicada por NVIDIA y pueden cambiar entre revisiones. Las cifras marcadas como sparse presuponen dispersión. Confirmamos la configuración exacta, el precio y el plazo de entrega en cada presupuesto.

Qué hace Workstation en cada pedido

Los mismos cinco pasos tanto si compra una GPU como una fila de racks

Dimensionamiento

Partimos de sus modelos, datos, usuarios e instalaciones, y después dimensionamos la computación, la memoria, la red, la alimentación y la refrigeración.

Suministro

Adquirimos a través de NVIDIA y sus partners de servidores, confirmamos los plazos de entrega y le mantenemos informado hasta la entrega.

Montaje y pruebas de estrés

Los sistemas se montan, se preparan con su imagen y se someten a pruebas de estrés a plena carga en nuestro taller del Reino Unido antes de su envío.

Instalación

Nuestros ingenieros entregan, montan en rack, cablean y ponen en marcha en sus instalaciones, y después hacen la entrega con la documentación.

Soporte

El mismo equipo se encarga de las incidencias de software, las ampliaciones, las renovaciones de licencias y las reclamaciones de garantía.

Todas las categorías NVIDIA

Membresía Trade

Los miembros Trade disponen de soporte técnico gratuito en cada pedido y tiempo ilimitado de ingeniería — ayuda con configuración, controladores, software y resolución de problemas, durante todo el tiempo que tengan el equipo.

Descubra la membresía Trade

NVIDIA Blackwell, del chip al centro de datos

NVIDIA Blackwell: The Journey From Die to Data Center. Se reproduce desde el canal oficial de YouTube de NVIDIA. Ver en YouTubeNVIDIA, Blackwell, DGX, Grace y RTX PRO son marcas comerciales o marcas registradas de NVIDIA Corporation. Se muestran para describir los productos que suministramos; no implican ningún respaldo por parte de NVIDIA.

See the NVIDIA RTX PRO 6000 Blackwell Server Edition

NVIDIA RTX PRO: AI and visual computing on the RTX PRO 6000 Blackwell Server Edition. Video: NVIDIA Corporation. Se reproduce desde el canal oficial de YouTube de NVIDIA. Ver en YouTubeRead about the RTX PRO 6000 Server Edition →NVIDIA, RTX PRO and Blackwell are trademarks and/or registered trademarks of NVIDIA Corporation. Shown to describe the products we supply; no endorsement by NVIDIA is implied.

Preguntas frecuentes

¿Por qué todo tiene precio bajo presupuesto?

Los precios y las asignaciones de la computación acelerada cambian con rapidez, y la mayoría de los pedidos dependen de la configuración exacta, las instalaciones y el software. Un presupuesto nos permite confirmar el precio, la disponibilidad y el plazo de entrega actuales de lo que realmente necesita.

¿Pueden suministrar una sola GPU en lugar de un sistema completo?

Sí. Suministramos GPU para centros de datos por unidades, pero siempre comprobamos que su servidor esté certificado para alimentarlas y refrigerarlas, y podemos instalarlas y probarlas por usted.

¿Instalan sistemas a escala de rack y con refrigeración líquida?

Sí. Para sistemas como GB300 NVL72 trabajamos con su equipo de instalaciones en la alimentación, la refrigeración y la carga del suelo mucho antes de la entrega, y después instalamos y ponemos en marcha en sus instalaciones.

¿Con qué plataforma NVIDIA deberíamos empezar?

Depende de sus modelos, usuarios e instalaciones. Muchos equipos empiezan con RTX PRO Server o L40S para combinar IA y gráficos, y pasan a HGX o DGX para el entrenamiento a gran escala. Hable con un ingeniero y le recomendaremos un punto de partida.

Planifique su proyecto de computación acelerada NVIDIA

Cuéntenos qué necesita ejecutar y dónde debe ubicarse. Un ingeniero le responderá con una configuración recomendada y un presupuesto.

Hable con un ingeniero