ਇਹ ਲੰਬੀ-ਰੂਪ ਡੂੰਘੀ-ਡੁਬਕੀ ਹੈ. ਇੱਕ ਤੇਜ਼, ਸਕੀਮ-ਪੜ੍ਹਨ ਯੋਗ ਸੰਸਕਰਣ ਲਈ, ਵੇਖੋ ਸਾਥੀ ਬਲੌਗ ਪੋਸਟ.
1. ਜਾਣ-ਪਛਾਣ: ਸਥਾਨਕ AI ਲਈ Mac Studio ਕਿਉਂ?
ਸਥਾਨਕ AI ਹੁਣ ਇੱਕ ਸ਼ੌਕੀਨ ਦੀ ਉਤਸੁਕਤਾ ਨਹੀਂ ਹੈ. Meta, Mistral, Qwen, ਅਤੇ Microsoft ਦੇ ਓਪਨ-ਵੇਟ ਮਾਡਲਾਂ ਦੇ ਤੇਜ਼ੀ ਨਾਲ ਪਰਿਪੱਕ ਹੋਣ ਦੇ ਨਾਲ, ਅਤੇ Apple Silicon ਦੀ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ 128 GB ਥ੍ਰੈਸ਼ਹੋਲਡ ਨੂੰ ਪਾਰ ਕਰ ਰਹੀ ਹੈ, ਤੁਸੀਂ ਹੁਣ ਸਮਰੱਥ ਵੱਡੇ ਭਾਸ਼ਾ ਮਾਡਲਾਂ, ਏਮਬੈਡਿੰਗ ਪਾਈਪਲਾਈਨਾਂ, ਅਤੇ ਇੱਕ ਸਿੰਗਲ ਡੈਸਕ-ਸਾਈਡ ਮਸ਼ੀਨ 'ਤੇ ਪੂਰੇ RAG ਸਟੈਕ ਚਲਾ ਸਕਦੇ ਹੋ - ਚੁੱਪਚਾਪ, ਪਾਵਰ ਐਕਸਪੀਆਰ ਐਕਸਪੀਆਰ 2 ਦੇ ਸਭ ਤੋਂ ਵਧੀਆ ਬਜਟ ਵਿੱਚ।
ਇਹ ਲੇਖ ਅਨਬਾਕਸਿੰਗ ਏ Mac Studio M4 Max ਚਿੱਪ ਨਾਲ, ਪਹਿਲਾ ਬੂਟ, ਅਸਲੀ ਔਨ-ਡਿਵਾਈਸ ਰੀਡਿੰਗ ਤੋਂ mactop, ਅਤੇ "ਬਾਕਸ ਮੇਰੇ ਡੈਸਕ ਉੱਤੇ ਹੈ" ਤੋਂ "ਮੈਂ ਸਥਾਨਕ ਤੌਰ 'ਤੇ ਚੱਲ ਰਹੇ Llama 3 ਨਾਲ ਗੱਲਬਾਤ ਕਰ ਰਿਹਾ ਹਾਂ ਅਤੇ RAG ਨਾਲ ਆਪਣੇ ਖੁਦ ਦੇ ਦਸਤਾਵੇਜ਼ਾਂ ਦੀ ਪੁੱਛਗਿੱਛ ਕਰ ਰਿਹਾ ਹਾਂ" ਤੱਕ ਦਾ ਇੱਕ ਵਿਹਾਰਕ ਮਾਰਗ। ਇੱਥੇ ਹਰ ਸਿਫ਼ਾਰਿਸ਼ ਇਸ ਗੱਲ 'ਤੇ ਅਧਾਰਤ ਹੈ ਕਿ ਮੈਂ ਅਸਲ ਵਿੱਚ ਮਸ਼ੀਨ 'ਤੇ ਕੀ ਦੇਖਿਆ ਹੈ. ਕੋਈ ਖੋਜੀ ਬੈਂਚਮਾਰਕ ਨੰਬਰ ਨਹੀਂ, ਕੋਈ ਮਾਰਕੀਟਿੰਗ ਫਲੱਫ ਨਹੀਂ - ਸਿਰਫ਼ ਵਰਕਫਲੋ।
ਜੇਕਰ ਤੁਸੀਂ ਇੱਕ ਇੰਜੀਨੀਅਰ, ਇੱਕ AI ਬਿਲਡਰ, ਇੱਕ SRE, ਜਾਂ ਇੱਕ ਤਕਨੀਕੀ ਲੀਡ ਹੋ ਜੋ ਇਹ ਫੈਸਲਾ ਕਰ ਰਹੇ ਹੋ ਕਿ ਕੀ ਇੱਕ Mac Studio ਤੁਹਾਡੀ ਟੀਮ ਦੇ ਹਾਰਡਵੇਅਰ ਮਿਸ਼ਰਣ ਵਿੱਚ ਹੈ, ਇਹ ਗਾਈਡ ਤੁਹਾਡੇ ਲਈ ਹੈ।

2. Mac Studio M4 Max ਨੂੰ ਅਨਬਾਕਸ ਕਰਨਾ
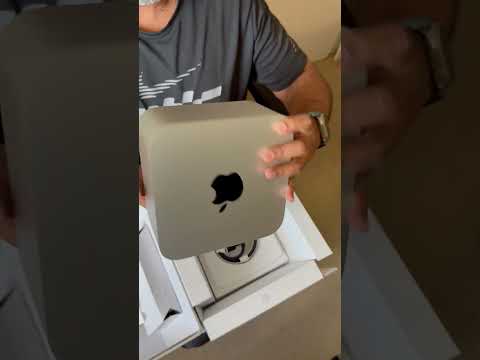
ਅਨਬਾਕਸਿੰਗ ਦਾ ਤਜਰਬਾ ਕਲਾਸਿਕ ਐਪਲ ਹੈ: ਨਿਊਨਤਮ ਗੱਤੇ ਦਾ ਬੋਰਡ, ਮਸ਼ੀਨ ਨੂੰ ਇੱਕ ਮੋਲਡ ਕੀਤੀ ਛੁੱਟੀ, ਇੱਕ ਛੋਟੀ ਬਲੈਕ ਪਾਵਰ ਕੇਬਲ, ਅਤੇ ਬੱਸ ਹੋ ਗਿਆ। ਕੋਈ ਫੁੱਲਿਆ ਹੋਇਆ ਸਹਾਇਕ ਬੰਡਲ ਨਹੀਂ। Mac Studio ਆਪਣੇ ਆਪ ਵਿੱਚ ਉਹੀ ਸੰਖੇਪ ਅਲਮੀਨੀਅਮ-ਐਕਸਟ੍ਰੂਜ਼ਨ ਐਨਕਲੋਜ਼ਰ ਹੈ ਜੋ ਅਸਲ M1 ਅਲਟਰਾ ਨਾਲ ਪੇਸ਼ ਕੀਤਾ ਗਿਆ ਹੈ: ਲਗਭਗ 7.7 ਇੰਚ ਵਰਗ, ਹੱਥ ਵਿੱਚ ਸੰਘਣਾ, ਹੇਠਲੇ ਪਾਸੇ ਜਾਣੇ-ਪਛਾਣੇ ਸਲੈਟੇਡ ਇਨਟੇਕ ਅਤੇ ਪਿਛਲੇ ਪਾਸੇ ਪੋਰਟਾਂ ਦੀ ਇੱਕ ਲੜੀ ਦੇ ਨਾਲ।
YouTube 'ਤੇ ਅਨਬਾਕਸਿੰਗ ਸ਼ਾਰਟ ਦੇਖੋ: https://youtube.com/shorts/HUlUoHNsyNM
ਮੈਂ ਅਨਬਾਕਸਿੰਗ ਦੀ ਇੱਕ ਛੋਟੀ ਕਲਿੱਪ ਸ਼ੂਟ ਕੀਤੀ - ਉੱਪਰ YouTube ਸ਼ਾਰਟ ਦੇਖੋ। ਇਸ ਫਾਰਮੈਟ ਲਈ Short ਇੰਨਾ ਵਧੀਆ ਕੰਮ ਕਰਨ ਦਾ ਕਾਰਨ ਇਹ ਹੈ ਕਿ ਅਸਲ ਸੈੱਟਅੱਪ ਅਸਲ ਵਿੱਚ ਤੇਜ਼ ਹੈ। ਪਹਿਲਾਂ ਪਲੱਗ-ਇਨ, ਮਾਨੀਟਰ ਵੇਕ-ਅੱਪ, Apple ID ਸਾਈਨ-ਇਨ, ਭਾਸ਼ਾ ਅਤੇ ਖੇਤਰ, FileVault, ਅਤੇ ਤੁਸੀਂ ਕੁਝ ਮਿੰਟਾਂ ਵਿੱਚ ਇੱਕ ਉਪਯੋਗੀ ਡੈਸਕਟਾਪ 'ਤੇ ਹੋ।
2.1 ਪਹਿਲਾ ਬੂਟ - ਅਸਲੀ ਰੀਡਿੰਗ ਤੋਂ mactop
ਸਿਸਟਮ ਦੇ ਸ਼ੁਰੂਆਤੀ ਸਿੰਕ ਨੂੰ ਪੂਰਾ ਕਰਨ ਤੋਂ ਬਾਅਦ ਮੈਂ ਸਭ ਤੋਂ ਪਹਿਲਾਂ ਜੋ ਕੀਤਾ ਉਹ ਇੰਸਟਾਲ ਸੀ mactop - ਇੱਕ ਸ਼ਾਨਦਾਰ ਓਪਨ-ਸੋਰਸ TUI ਡੈਸ਼ਬੋਰਡ ਜੋ Apple Silicon ਦੇ ਅੰਦਰੂਨੀ ਕਾਊਂਟਰਾਂ ਨੂੰ ਅਸਲ ਸਮੇਂ ਵਿੱਚ ਪੇਸ਼ ਕਰਦਾ ਹੈ। 37 ਮਿੰਟ ਦੇ ਅਪਟਾਈਮ 'ਤੇ ਇਹ ਤਾਜ਼ਾ-ਇੰਸਟਾਲ ਡੈਸ਼ਬੋਰਡ ਕਿਹੋ ਜਿਹਾ ਦਿਖਾਈ ਦਿੰਦਾ ਹੈ:
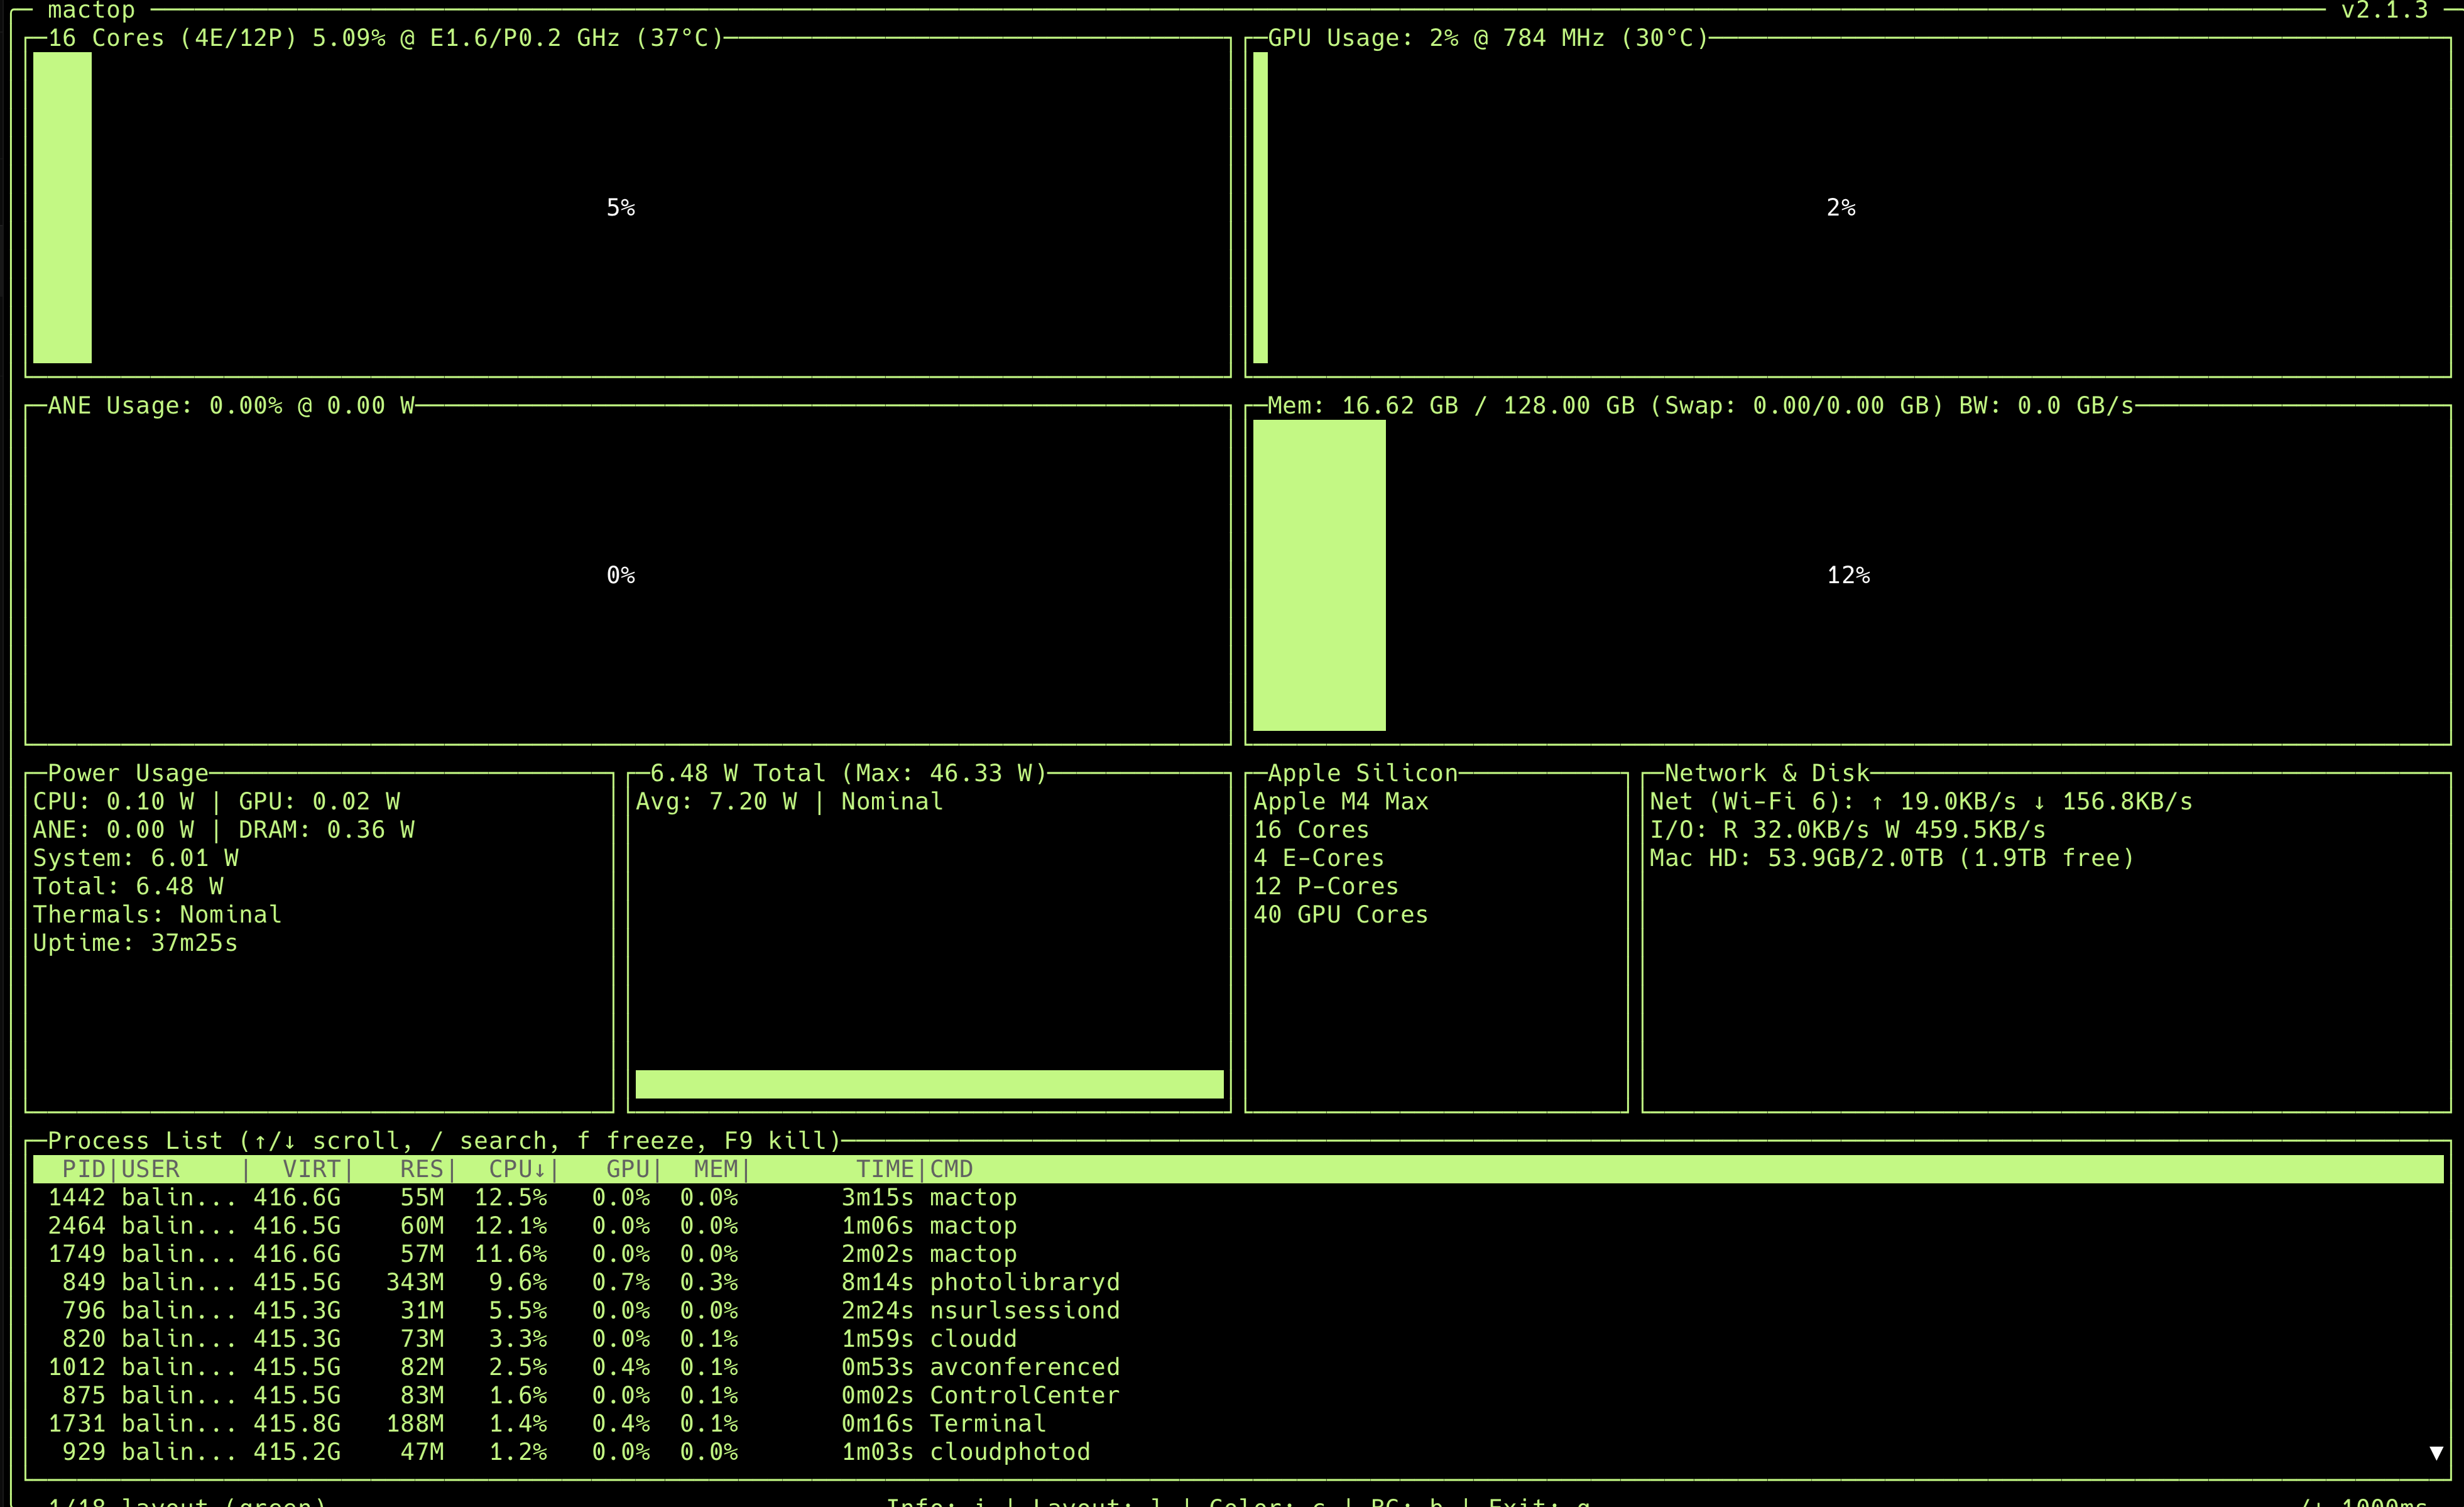
/img/mac-studio-mactop-firstboot.png ਇਸ ਨੂੰ ਬਾਅਦ ਵਿੱਚ ਸਵੈਪ ਕਰਨ ਲਈ।ਉਸ ਸਕਰੀਨਸ਼ਾਟ ਵਿਚਲੇ ਨੰਬਰ ਉਹੀ ਹਾਰਡ ਨੰਬਰ ਹਨ ਜਿਨ੍ਹਾਂ ਦਾ ਮੈਂ ਇਸ ਲੇਖ ਵਿਚ ਜ਼ਿਕਰ ਕਰਾਂਗਾ। ਉਹ ਇੱਕ ਤਾਜ਼ਾ ਸੈੱਟਅੱਪ 'ਤੇ ਵਿਹਲੇ ਹੋਣ 'ਤੇ ਮੇਰੀ ਮਸ਼ੀਨ ਲਈ ਜ਼ਮੀਨੀ ਸੱਚਾਈ ਹਨ:
- Apple Silicon: M4 Max
- CPU: ਕੁੱਲ 16 ਕੋਰ - 4 ਕੁਸ਼ਲਤਾ ਕੋਰ + 12 ਪ੍ਰਦਰਸ਼ਨ ਕੋਰ; 1.6 ਗੀਗਾਹਰਟਜ਼ 'ਤੇ ਈ-ਕਲੱਸਟਰ, 0.2 ਗੀਗਾਹਰਟਜ਼ 'ਤੇ ਪੀ-ਕਲੱਸਟਰ; ਪੈਕੇਜ 37 ਸੀ
- GPU: 784 ਮੈਗਾਹਰਟਜ਼ 'ਤੇ 40 ਕੋਰ, 30 ਸੀ
- ਨਿਊਰਲ ਇੰਜਣ (ANE): 16-ਕੋਰ, ਨਿਸ਼ਕਿਰਿਆ 'ਤੇ 0.00 ਡਬਲਯੂ ਡਰਾਇੰਗ
- ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ: ਕੁੱਲ 128.00 GB, 16.62 GB ਵਰਤੋਂ ਵਿੱਚ ਹੈ (ਲਗਭਗ 13%) ਨਿਸ਼ਕਿਰਿਆ 'ਤੇ
- ਸ਼ਕਤੀ: ਕੁੱਲ 6.48 W - CPU 0.10 W, GPU 0.02 W, ANE 0 W, DRAM 0.36 W, ਸਿਸਟਮ 6.01 W. ਅਧਿਕਤਮ ਸੈਸ਼ਨ ਵਿੱਚ ਦੇਖਿਆ ਗਿਆ 46.33 W. ਥਰਮਲ: ਨਾਮਾਤਰ।
- ਸਟੋਰੇਜ: 2.0 TB Mac HD, 1.9 TB ਮੁਫ਼ਤ; 53.9 GB OS ਦੁਆਰਾ ਵਰਤਿਆ ਗਿਆ ਅਤੇ ਸ਼ੁਰੂਆਤੀ ਸੈੱਟਅੱਪ
- ਨੈੱਟਵਰਕ: Wi-Fi 6, ਬੈਕਗ੍ਰਾਊਂਡ ਸਿੰਕ ਦੇ ਦੌਰਾਨ 19.0 KB/s ਅਪਲੋਡ ਅਤੇ 156.8 KB/s ਡਾਊਨਲੋਡ ਦੀ ਨਮੂਨਾ ਰੀਡਿੰਗ ਦੇ ਨਾਲ
ਦੋ ਗੱਲਾਂ ਸਾਹਮਣੇ ਆਉਂਦੀਆਂ ਹਨ। ਪਹਿਲਾਂ, ਵਿਹਲੇ 'ਤੇ 6.48 ਡਬਲਯੂ ਇੱਕ ਡੈਸਕਟੌਪ ਲਈ 128 GB ਵਰਤੋਂ ਯੋਗ ਮੈਮੋਰੀ ਕਮਾਲ ਦੀ ਹੈ - ਇਹ ਸਕ੍ਰੀਨ ਬੰਦ ਹੋਣ ਨਾਲ ਬਹੁਤ ਸਾਰੇ ਲੈਪਟਾਪਾਂ ਤੋਂ ਘੱਟ ਹੈ। ਦੂਜਾ, GPU 784 MHz 'ਤੇ 40 ਕੋਰ ਉਪਲਬਧ ਹੈ; ਜਿਵੇਂ ਹੀ ਤੁਸੀਂ ਇਸਦੇ ਸਾਹਮਣੇ ਇੱਕ LLM ਪਾਉਂਦੇ ਹੋ, ਉਹ ਪੂਲ ਅਸਲ ਕੰਮ ਕਰਨ ਲਈ ਤਿਆਰ ਹੈ।
3. Mac Studio M4 Max ਸਥਾਨਕ AI ਲਈ ਸ਼ਾਨਦਾਰ ਕਿਉਂ ਹੈ
ਇਹ ਸਮਝਣ ਲਈ ਕਿ ਇਹ ਹਾਰਡਵੇਅਰ ਸਥਾਨਕ AI ਲਈ ਇੰਨਾ ਵਧੀਆ ਕਿਉਂ ਹੈ - ਅਤੇ "ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ" ਇੱਕ ਮਾਰਕੀਟਿੰਗ ਲਾਈਨ ਤੋਂ ਵੱਧ ਕਿਉਂ ਹੈ - ਇਹ ਇਸਦੀ ਤੁਲਨਾ ਸਿੱਧੇ ਕੈਨੋਨੀਕਲ ਵਿਕਲਪ ਨਾਲ ਕਰਨ ਵਿੱਚ ਮਦਦ ਕਰਦੀ ਹੈ: ਇੱਕ PC ਵਿੱਚ ਇੱਕ ਵੱਖਰਾ GPU ਕਾਰਡ, PCIe ਉੱਤੇ ਸਿਸਟਮ RAM ਨਾਲ ਸੰਚਾਰ ਕਰਨਾ।

3.1 ਸਾਦੀ ਭਾਸ਼ਾ ਵਿੱਚ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ
ਇੱਕ ਰਵਾਇਤੀ PC AI ਰਿਗ 'ਤੇ, ਤੁਹਾਡੇ ਕੋਲ ਦੋ ਮੈਮੋਰੀ ਪੂਲ ਹਨ। ਸਿਸਟਮ ਰੈਮ (ਆਮ ਤੌਰ 'ਤੇ DDR5 ਦਾ 64-256 GB) ਜਦੋਂ ਤੁਸੀਂ ਉਹਨਾਂ ਨੂੰ ਡਿਸਕ ਤੋਂ ਲੋਡ ਕਰਦੇ ਹੋ ਤਾਂ OS, ਐਪਲੀਕੇਸ਼ਨ ਅਤੇ ਮਾਡਲ ਦਾ ਭਾਰ ਰੱਖਦਾ ਹੈ। GPU ਦਾ ਆਪਣਾ VRAM ਹੈ - RTX 4090 'ਤੇ 24 GB, 5090 'ਤੇ 32 GB, A100 'ਤੇ 80 GB। ਇਸ ਤੋਂ ਪਹਿਲਾਂ ਕਿ GPU ਇੱਕ ਸਿੰਗਲ ਮੈਟਮੁਲ ਚਲਾ ਸਕੇ, ਮਾਡਲ ਹੋਣਾ ਚਾਹੀਦਾ ਹੈ ਕਾਪੀ ਕੀਤਾ ਸਿਸਟਮ RAM ਤੋਂ VRAM ਵਿੱਚ PCIe ਬੱਸ ਵਿੱਚ। ਜੇਕਰ ਮਾਡਲ VRAM ਤੋਂ ਵੱਡਾ ਹੈ, ਤਾਂ ਇਹ ਜਾਂ ਤਾਂ ਬਿਲਕੁਲ ਲੋਡ ਨਹੀਂ ਹੁੰਦਾ, ਜਾਂ ਇਸ ਨੂੰ PCIe ਦੁਆਰਾ ਬੇਰਹਿਮੀ ਨਾਲ ਪੇਜ ਕੀਤਾ ਜਾਂਦਾ ਹੈ (ਅਕਸਰ VRAM ਵਿੱਚ ਪੂਰੀ ਤਰ੍ਹਾਂ ਚੱਲਣ ਨਾਲੋਂ 10-100x ਹੌਲੀ)।
Apple Silicon ਇਹਨਾਂ ਦੋ ਪੂਲ ਨੂੰ ਇੱਕ ਵਿੱਚ ਸਮੇਟਦਾ ਹੈ। CPU, GPU, ਨਿਊਰਲ ਇੰਜਣ, ਅਤੇ ਮੀਡੀਆ ਇੰਜਣ ਸਾਰੇ ਦੇਖਦੇ ਹਨ ਉਹੀ ਭੌਤਿਕ ਮੈਮੋਰੀ. ਕੋਈ ਕਾਪੀ ਨਹੀਂ ਹੈ। ਕੋਈ PCIe ਰੁਕਾਵਟ ਨਹੀਂ ਹੈ. ਇੱਕ ਮਾਡਲ ਜੋ ਕਿ ਡਿਸਕ ਉੱਤੇ 40 GB ਹੈ, ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਵਿੱਚ 40 GB ਹੈ, ਅਤੇ GPU ਇਸਨੂੰ ਸਿੱਧਾ ਪੜ੍ਹ ਸਕਦਾ ਹੈ।
ਸਥਾਨਕ LLMs ਲਈ, ਇਹ ਕਾਤਲ ਵਿਸ਼ੇਸ਼ਤਾ ਹੈ। Q4_K_M ਦੀ ਮਾਤਰਾ ਵਾਲਾ 70B-ਪੈਰਾਮੀਟਰ ਮਾਡਲ ਡਿਸਕ 'ਤੇ ਲਗਭਗ 40 GB ਹੈ (ਉਸ ਮਾਤਰਾ ਪੱਧਰ 'ਤੇ Llama-ਸ਼੍ਰੇਣੀ ਦੇ ਵਜ਼ਨ ਲਈ ਜਨਤਕ ਤੌਰ 'ਤੇ ਹਵਾਲਾ ਦਿੱਤਾ ਗਿਆ ਚਿੱਤਰ - ਅੰਦਾਜ਼ਨ ਮੰਨੋ)। ਇੱਕ 24 GB ਉਪਭੋਗਤਾ GPU 'ਤੇ, ਉਹ ਮਾਡਲ ਸਿਰਫ਼ ਫਿੱਟ ਨਹੀਂ ਬੈਠਦਾ ਹੈ। 128 GB ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ 'ਤੇ, ਇਹ ਲਗਭਗ 80 GB ਨਾਲ ਲੋਡ ਹੁੰਦਾ ਹੈ ਜੋ ਅਜੇ ਵੀ ਸੰਦਰਭ, ਐਪਲੀਕੇਸ਼ਨ ਕੋਡ, ਅਤੇ ਟੂਲਸ ਲਈ ਮੁਫ਼ਤ ਹੈ।
3.2 ਪਾਵਰ ਕੁਸ਼ਲਤਾ ਜਿਸ 'ਤੇ ਵਿਸ਼ਵਾਸ ਕਰਨਾ ਔਖਾ ਹੈ
ਮੈਕਟੌਪ ਸਕ੍ਰੀਨਸ਼ੌਟ ਵਿਹਲੇ ਹੋਣ 'ਤੇ 6.48 W ਅਤੇ ਸੈਸ਼ਨ ਦੌਰਾਨ ਦੇਖਿਆ ਗਿਆ ਅਧਿਕਤਮ 46.33 W ਦਿਖਾਉਂਦਾ ਹੈ। ਇਸ ਨੂੰ ਦ੍ਰਿਸ਼ਟੀਕੋਣ ਵਿੱਚ ਰੱਖਣ ਲਈ: ਇੱਕ ਸਿੰਗਲ RTX 4090 15-25 ਡਬਲਯੂ 'ਤੇ ਬਾਕੀ ਦੇ ਸਿਸਟਮ ਦੇ ਨਾਲ ਟਾਪ 'ਤੇ ਹੈ, ਅਤੇ ਲੋਡ ਦੇ ਹੇਠਾਂ 450 W ਤੱਕ ਖਿੱਚਦਾ ਹੈ। ਇੱਕ Mac Studio ਇੱਕ ਡੈਸਕ-ਸਾਈਡ AI ਬਾਕਸ ਹੈ ਜਿਸਨੂੰ ਤੁਸੀਂ ਬਿਜਲੀ ਦੇ ਬਿੱਲ 'ਤੇ ਧਿਆਨ ਦਿੱਤੇ ਬਿਨਾਂ 24/7 ਚੱਲਣਾ ਛੱਡ ਸਕਦੇ ਹੋ। ਇਹ ਚੁੱਪ ਹੈ. ਅਨੁਮਾਨ ਵਰਕਲੋਡ ਦੇ ਦੌਰਾਨ ਪ੍ਰਸ਼ੰਸਕ ਲਗਭਗ ਕਦੇ ਨਹੀਂ ਘੁੰਮਦੇ. ਇਹ ਉਹ ਹੈ ਜੋ ਇਸਨੂੰ ਇੱਕ ਦੇ ਰੂਪ ਵਿੱਚ ਵਿਹਾਰਕ ਬਣਾਉਂਦਾ ਹੈ ਹਮੇਸ਼ਾ-ਚਾਲੂ dev ਬਾਕਸ ਇਸ ਤਰੀਕੇ ਨਾਲ ਕਿ ਇੱਕ ਵੱਖਰਾ GPU PC ਘੱਟ ਹੀ ਹੁੰਦਾ ਹੈ।
3.3 ਐਪਲ ਨਿਊਰਲ ਇੰਜਣ ਅਸਲ ਵਿੱਚ ਕੀ ਕਰਦਾ ਹੈ
ANE ਇੱਕ 16-ਕੋਰ ਫਿਕਸਡ-ਫੰਕਸ਼ਨ ਐਕਸਲੇਟਰ ਹੈ ਜੋ ਕੋਰੀਐਮਐਲ ਦੁਆਰਾ ਪੈਦਾ ਕੀਤੇ ਗਏ ਟੈਂਸਰ ਓਪਰੇਸ਼ਨਾਂ ਲਈ ਅਨੁਕੂਲਿਤ ਕੀਤਾ ਗਿਆ ਹੈ। 2026 ਵਿੱਚ ਜ਼ਿਆਦਾਤਰ ਓਪਨ-ਵੇਟ LLM ਵਰਕਲੋਡਾਂ ਲਈ (llama.cpp ਜਾਂ Ollama ਦੁਆਰਾ ਚੱਲ ਰਿਹਾ GGUF ਫਾਰਮੈਟ), ANE ਗਰਮ ਮਾਰਗ ਵਿੱਚ ਨਹੀਂ ਹੈ - GPU ਹੈ, ਮੈਟਲ ਪਰਫਾਰਮੈਂਸ ਸ਼ੇਡਰਸ ਦੁਆਰਾ। ANE CoreML- ਰੂਪਾਂਤਰਿਤ ਮਾਡਲਾਂ, ਔਨ-ਡਿਵਾਈਸ ਸਪੀਚ ਪਛਾਣ, ਚਿੱਤਰ ਸੈਗਮੈਂਟੇਸ਼ਨ, ਅਤੇ ਸਮਾਨ ਫਿਕਸਡ-ਸ਼ੇਪ ਵਰਕਲੋਡਾਂ ਲਈ ਚਮਕਦਾ ਹੈ। ਜਦੋਂ ਇਹ ਚੱਲਦਾ ਹੈ ਤਾਂ ਇਹ ਬਹੁਤ ਪਾਵਰ-ਕੁਸ਼ਲ ਹੁੰਦਾ ਹੈ। ਇਹ ਜਾਣਨਾ ਲਾਭਦਾਇਕ ਹੈ ਕਿ ਇਹ ਉੱਥੇ ਹੈ; ਹਰ LLM ਸਟੈਕ ਦੀ ਵਰਤੋਂ ਕਰਨ ਦੀ ਉਮੀਦ ਨਾ ਕਰੋ।
4. AI ਕੰਮ ਲਈ Mac Studio ਸੈੱਟ ਕਰਨਾ
ਸਟੈਂਡਰਡ macOS ਆਨਬੋਰਡਿੰਗ ਤੋਂ ਬਾਅਦ, ਇੱਥੇ ਇੱਕ ਤਾਜ਼ਾ Mac Studio ਲਈ ਸਹੀ ਲਿਆਉਣ-ਅੱਪ ਹੈ ਜੋ ਮੈਂ ਇੱਕ ਸਥਾਨਕ AI ਦੇਵ ਬਾਕਸ ਵਜੋਂ ਵਰਤਣਾ ਚਾਹੁੰਦਾ ਹਾਂ।
4.1 Homebrew, Xcode CLT, ਅਤੇ ਬੇਸਿਕਸ ਇੰਸਟਾਲ ਕਰੋ
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
ਹੋਮਬਰੂ ਯੂਨਿਕਸ ਟੂਲਿੰਗ ਲਿਆਉਂਦਾ ਹੈ, ਐਕਸਕੋਡ ਕਮਾਂਡ ਲਾਈਨ ਟੂਲ ਕੰਪਾਈਲਰ ਅਤੇ ਲਿੰਕਰ ਪ੍ਰਦਾਨ ਕਰਦੇ ਹਨ, ਪਾਈਥਨ ਅਤੇ ਨੋਡ ਤੁਹਾਨੂੰ ਐਪ ਕੋਡ ਲਈ ਰਨਟਾਈਮ ਦਿੰਦੇ ਹਨ, ਅਤੇ iTerm2 + VS ਕੋਡ ਸੰਪਾਦਕ + ਟਰਮੀਨਲ ਜੋੜਾ ਹਨ ਜਿਸ ਲਈ ਮੈਂ ਡਿਫੌਲਟ ਹਾਂ।
4.2 Ollama ਇੰਸਟਾਲ ਕਰੋ
Ollama ਮੈਕੋਸ 'ਤੇ ਓਪਨ-ਵੇਟਸ LLMs ਨੂੰ ਡਾਊਨਲੋਡ ਕਰਨ, ਚਲਾਉਣ ਅਤੇ ਸਰਵ ਕਰਨ ਦਾ ਸਭ ਤੋਂ ਆਸਾਨ ਤਰੀਕਾ ਹੈ। ਹੁੱਡ ਦੇ ਹੇਠਾਂ ਇਹ ਲਪੇਟਦਾ ਹੈ llama.cpp ਮੈਟਲ ਪ੍ਰਵੇਗ ਦੇ ਨਾਲ ਅਤੇ ਪੋਰਟ 11434 'ਤੇ ਇੱਕ ਸਧਾਰਨ HTTP API ਪ੍ਰਦਾਨ ਕਰਦਾ ਹੈ।
brew install ollama

ollama serve &

ollama --version
ਤੁਸੀਂ ਅਧਿਕਾਰੀ ਦੁਆਰਾ ਵੀ ਸਥਾਪਿਤ ਕਰ ਸਕਦੇ ਹੋ .dmg ollama.com ਤੋਂ, ਜੋ ਇੱਕ ਮੀਨੂ-ਬਾਰ ਐਪ ਸੈਟ ਅਪ ਕਰਦਾ ਹੈ। ਕੋਈ ਵੀ ਰਸਤਾ ਕੰਮ ਕਰਦਾ ਹੈ। ਮੈਂ ਹੈੱਡਲੈੱਸ ਬਾਕਸਾਂ ਲਈ ਬਰਿਊ ਇੰਸਟੌਲ ਅਤੇ ਡੇਲੀ-ਡ੍ਰਾਈਵਰ ਮੈਕ ਲਈ ਡੀਐਮਜੀ ਨੂੰ ਤਰਜੀਹ ਦਿੰਦਾ ਹਾਂ।
4.3 LM ਸਟੂਡੀਓ ਸਥਾਪਿਤ ਕਰੋ (ਵਿਕਲਪਿਕ ਪਰ ਇਸ ਦੇ ਯੋਗ)
ਐਲਐਮ ਸਟੂਡੀਓ GGUF ਮਾਡਲਾਂ ਨਾਲ ਬ੍ਰਾਊਜ਼ਿੰਗ, ਡਾਊਨਲੋਡ ਕਰਨ ਅਤੇ ਚੈਟਿੰਗ ਕਰਨ ਲਈ ਇੱਕ ਡੈਸਕਟਾਪ UI ਹੈ। ਇਹ ਇੱਕ OpenAI- ਅਨੁਕੂਲ API ਦਾ ਵੀ ਪਰਦਾਫਾਸ਼ ਕਰਦਾ ਹੈ। ਮੈਂ ਇਸਨੂੰ Ollama ਦੇ ਨਾਲ ਸਥਾਪਿਤ ਕਰਦਾ ਹਾਂ ਕਿਉਂਕਿ ਮਾਡਲ ਬ੍ਰਾਊਜ਼ਰ ਸ਼ਾਨਦਾਰ ਹੈ ਅਤੇ ਪ੍ਰਤੀ-ਮਾਡਲ ਪ੍ਰਦਰਸ਼ਨ ਟਿਊਨਿੰਗ UI ਅਨੁਕੂਲ ਹੈ ਜਦੋਂ ਤੁਸੀਂ Q4_K_M ਅਤੇ Q5_K_M ਵਿਚਕਾਰ ਫੈਸਲਾ ਕਰ ਰਹੇ ਹੋ।
4.4 VS ਕੋਡ ਵਿੱਚ Continue.dev ਸਥਾਪਤ ਕਰੋ
Continue.dev ਤੁਹਾਨੂੰ VS ਕੋਡ ਦੇ ਅੰਦਰ ChatGPT-ਸ਼ੈਲੀ ਦੀ ਸਹਾਇਤਾ ਦਿੰਦਾ ਹੈ, ਪਰ ਤੁਹਾਡੇ ਸਥਾਨਕ Ollama ਵੱਲ ਇਸ਼ਾਰਾ ਕਰਦਾ ਹੈ। ਐਕਸਟੈਂਸ਼ਨ ਨੂੰ ਸਥਾਪਿਤ ਕਰਨ ਤੋਂ ਬਾਅਦ, ਇਸਨੂੰ ਆਪਣੇ ਵਿੱਚ ਸੁੱਟੋ ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
ਹੁਣ ਤੁਹਾਡੇ ਕੋਲ ਇਨਲਾਈਨ ਚੈਟ, ਸੰਪਾਦਨ, ਅਤੇ ਸਵੈ-ਸੰਪੂਰਨਤਾ ਹੈ - ਸਾਰੇ ਹਿੱਟ ਮਾਡਲ ਜੋ ਤੁਹਾਡੇ ਸੰਪਾਦਕ ਦੇ ਰੂਪ ਵਿੱਚ ਉਸੇ ਡੈਸਕ 'ਤੇ ਰਹਿੰਦੇ ਹਨ। ਜ਼ੀਰੋ ਡਾਟਾ ਮਸ਼ੀਨ ਨੂੰ ਛੱਡ ਦਿੰਦਾ ਹੈ.
5. ਆਪਣਾ ਪਹਿਲਾ LLM ਚੱਲ ਰਿਹਾ ਹੈ

ਸੱਚ ਦੇ ਪਲ ਲਈ ਸਮਾਂ. ਇੱਕ ਮਾਡਲ ਖਿੱਚੋ ਅਤੇ ਇਸਨੂੰ ਚਲਾਓ.
5.1 ਪੁਲਿੰਗ Llama 3.1 8B
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
ਪੁੱਲ Q4_K_M GGUF ਨੂੰ ਡਾਉਨਲੋਡ ਕਰਦਾ ਹੈ (Llama 3.1 8B Q4_K_M 'ਤੇ ਡਿਸਕ 'ਤੇ ਲਗਭਗ 4.7 GB ਹੈ - ਜਨਤਕ ਤੌਰ 'ਤੇ ਹਵਾਲਾ ਦਿੱਤਾ ਗਿਆ ਚਿੱਤਰ, ਅੰਦਾਜ਼ਨ ਮੰਨੋ)। ਮੇਰੇ ਵਰਗੇ ਵਾਈ-ਫਾਈ 6 ਕਨੈਕਸ਼ਨ 'ਤੇ, ਡਾਊਨਲੋਡ ਕਰਨ ਵਿੱਚ ਕੁਝ ਮਿੰਟ ਲੱਗਦੇ ਹਨ; ਵਾਇਰਡ ਗੀਗਾਬਿਟ 'ਤੇ ਇਹ ਤੇਜ਼ ਹੈ। ਇੱਕ ਵਾਰ ਜਦੋਂ ਇਹ ਉਤਰਦਾ ਹੈ, ਪਹਿਲਾ ollama run ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਵਿੱਚ ਇੱਕ-ਵਾਰ ਮਾਡਲ ਲੋਡ ਸ਼ਾਮਲ ਕਰਦਾ ਹੈ - ਤੁਸੀਂ ਪਹਿਲੀ ਟੋਕਨ ਸਟ੍ਰੀਮ ਤੋਂ ਪਹਿਲਾਂ ਇੱਕ ਸੰਖੇਪ ਵਿਰਾਮ ਵੇਖੋਗੇ - ਅਤੇ ਫਿਰ ਬਾਅਦ ਦੀਆਂ ਦੌੜਾਂ ਤੇਜ਼ ਹਨ।
ਮੈਂ ਜਾਣਬੁੱਝ ਕੇ ਇੱਥੇ ਆਪਣੀ ਮਸ਼ੀਨ ਲਈ ਟੋਕਨ-ਪ੍ਰਤੀ-ਸੈਕਿੰਡ ਨੰਬਰਾਂ ਦਾ ਹਵਾਲਾ ਨਹੀਂ ਦੇਵਾਂਗਾ, ਕਿਉਂਕਿ ਮੈਂ ਇੱਕ ਪੇਅਰਡ ਵਿਧੀ ਨਾਲ ਇੱਕ ਨਿਯੰਤਰਿਤ ਬੈਂਚਮਾਰਕ ਸੂਟ ਨਹੀਂ ਚਲਾਇਆ ਹੈ। ਮੈਂ ਕੀ ਕਹਾਂਗਾ ਕਿ ਹਾਰਡਵੇਅਰ ਦੀ ਇਸ ਸ਼੍ਰੇਣੀ 'ਤੇ (40 GPU ਕੋਰਾਂ ਵਾਲਾ M4 Max) ਤੁਹਾਨੂੰ ਉਮੀਦ ਕਰਨੀ ਚਾਹੀਦੀ ਹੈ ਨਿਰਵਿਘਨ, ਗੱਲਬਾਤ ਸਟ੍ਰੀਮਿੰਗ Q4_K_M 'ਤੇ ਇੱਕ 8B ਮਾਡਲ ਤੋਂ, ਇੱਕ ਧਿਆਨ ਦੇਣ ਯੋਗ ਸ਼ੁਰੂਆਤੀ ਲੋਡ ਦੇਰੀ ਅਤੇ ਪੂਰੇ ਜਵਾਬ ਦੌਰਾਨ ਸਥਿਰ ਆਉਟਪੁੱਟ ਦੇ ਨਾਲ। ਜੇਕਰ ਤੁਸੀਂ "ਮੈਨੂੰ ਮੇਰੇ ਮੈਕ 'ਤੇ ਪ੍ਰਤੀ ਸਕਿੰਟ 60 ਟੋਕਨ ਮਿਲਦੇ ਹਨ" ਵਰਗੇ ਦਾਅਵੇ ਪੜ੍ਹੇ ਹਨ, ਤਾਂ ਉਹਨਾਂ ਨੂੰ ਬਾਲਪਾਰਕ ਮਾਰਗਦਰਸ਼ਨ ਵਜੋਂ ਮੰਨੋ; ਤੁਹਾਡੀ ਅਸਲ ਸੰਖਿਆ ਪ੍ਰੋਂਪਟ ਲੰਬਾਈ, ਸੰਦਰਭ ਵਿੰਡੋ, ਮਾਤਰਾ ਪੱਧਰ, ਮਾਡਲ ਆਰਕੀਟੈਕਚਰ, ਅਤੇ ਹੋਰ ਕੀ ਚੱਲ ਰਹੀ ਹੈ ਦੇ ਨਾਲ ਵੱਖ-ਵੱਖ ਹੋਵੇਗੀ।
5.2 ਇੱਕ ਮਾਤਰਾ ਚੁਣਨਾ - Q4_K_M, Q5_K_M, Q8_0
ਕੁਆਂਟਾਈਜ਼ੇਸ਼ਨ ਮਾਡਲ ਵਜ਼ਨ ਦੀ ਸ਼ੁੱਧਤਾ ਨੂੰ ਡਿਸਕ ਅਤੇ ਮੈਮੋਰੀ ਵਿੱਚ ਸੁੰਗੜਨ ਲਈ ਘਟਾਉਂਦੀ ਹੈ। ਵਪਾਰ-ਬੰਦ ਗੁਣਵੱਤਾ ਹੈ. ਇਹ ਉਹ ਮੋਟਾ ਮਾਨਸਿਕ ਮਾਡਲ ਹੈ ਜੋ ਮੈਂ ਸਥਾਨਕ ਅਨੁਮਾਨ ਲਈ ਮਾਤਰਾ ਚੁਣਨ ਵੇਲੇ ਵਰਤਦਾ ਹਾਂ:
| ਕੁਆਂਟ | 8B ਲਈ ਲਗਭਗ ਆਕਾਰ | ਕੁਆਲਿਟੀ ਬਨਾਮ FP16 | ਕਦੋਂ ਵਰਤਣਾ ਹੈ |
|---|---|---|---|
| Q4_K_M | ~4.7 GB | ਬਹੁਤ ਵਧੀਆ, ਛੋਟੀ ਬੂੰਦ | ਡਿਫਾਲਟ। ਚੈਟ ਅਤੇ ਕੋਡ ਲਈ ਵਧੀਆ ਗਤੀ/ਗੁਣਵੱਤਾ ਸੰਤੁਲਨ। |
| Q5_K_M | ~5.7 GB | FP16 ਦੇ ਨੇੜੇ | ਜਦੋਂ ਤੁਹਾਨੂੰ ਇੱਕ ਛੋਹਣ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ ਤਾਂ ਵਧੇਰੇ ਸ਼ੁੱਧਤਾ ਅਤੇ ਯਾਦ ਰੱਖਣ ਲਈ ਮੈਮੋਰੀ ਹੁੰਦੀ ਹੈ। |
| Q8_0 | ~8.5 GB | ਨਿਕਟ-ਨੁਕਸਾਨ ਰਹਿਤ | ਜਦੋਂ ਤੁਹਾਨੂੰ ਛੋਟੇ ਮਾਡਲਾਂ 'ਤੇ ਵੱਧ ਤੋਂ ਵੱਧ ਗੁਣਵੱਤਾ ਅਤੇ ਘੱਟੋ-ਘੱਟ ਰੌਲੇ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ। |
ਸਾਰੇ ਆਕਾਰ ਲਗਭਗ ਹਨ, Llama-ਕਲਾਸ 8B ਵਜ਼ਨ ਲਈ ਜਨਤਕ ਤੌਰ 'ਤੇ ਦਿੱਤੇ ਅੰਕੜੇ। ਸੰਬੰਧਿਤ ਆਰਡਰਿੰਗ ਮਹੱਤਵਪੂਰਨ ਹੈ।
5.3 32, 64, ਅਤੇ 128 GB ਵਿੱਚ ਕੀ ਫਿੱਟ ਹੈ
| ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ | ਯਥਾਰਥਵਾਦੀ ਆਰਾਮ ਖੇਤਰ (Q4_K_M) | ਖਿੱਚੋ (ਦੇਖਭਾਲ ਨਾਲ) |
|---|---|---|
| 32 GB | 7ਬੀ/8ਬੀ/13ਬੀ | ਤੰਗ ਸੰਦਰਭ 'ਤੇ 20-22B |
| 64 GB | 13ਬੀ/20ਬੀ/34ਬੀ | ਤੰਗ ਸੰਦਰਭ 'ਤੇ 40-50B |
| 128 GB | 34B / 70B / ਮਿਸ਼ਰਣ-ਦੇ-ਮਾਹਰ ਵੇਰੀਐਂਟ | ਤੰਗ ਸੰਦਰਭ 'ਤੇ 100-120B |
"ਆਰਾਮਦਾਇਕ ਜ਼ੋਨ" ਦਾ ਮਤਲਬ ਹੈ ਮਾਡਲ ਇੱਕ ਉਦਾਰ ਸੰਦਰਭ ਵਿੰਡੋ, ਇੱਕ KV ਕੈਸ਼, ਅਤੇ ਚੱਲ ਰਹੀਆਂ ਹੋਰ ਐਪਲੀਕੇਸ਼ਨਾਂ ਲਈ ਕਾਫ਼ੀ ਕਮਰੇ ਦੇ ਨਾਲ ਲੋਡ ਹੁੰਦਾ ਹੈ। "ਸਟ੍ਰੈਚ" ਦਾ ਮਤਲਬ ਹੈ ਇਹ ਲੋਡ ਹੁੰਦਾ ਹੈ ਪਰ ਤੁਸੀਂ ਸੰਦਰਭ ਦੀ ਲੰਬਾਈ ਅਤੇ ਹੋਰ ਵਰਕਲੋਡਾਂ ਨੂੰ ਜੋੜਨਾ ਸ਼ੁਰੂ ਕਰਦੇ ਹੋ। ਮੇਰੇ 128 GB ਬਾਕਸ 'ਤੇ ਮੈਂ Q4_K_M 'ਤੇ 70B ਚਲਾ ਸਕਦਾ ਹਾਂ ਅਤੇ ਅਜੇ ਵੀ VS ਕੋਡ, ਕਰੋਮ, ਅਤੇ ਪਾਈਥਨ ਪ੍ਰਕਿਰਿਆਵਾਂ ਦੇ ਇੱਕ ਜੋੜੇ ਲਈ ਲਗਭਗ 80 GB ਹੈੱਡਰੂਮ ਹੈ - ਜੋ ਕਿ ਸਪੱਸ਼ਟ ਤੌਰ 'ਤੇ, ਇੱਕ ਸ਼ਾਨਦਾਰ ਭਾਵਨਾ ਹੈ।
5.4 ਨੋਡ ਅਤੇ ਪਾਈਥਨ ਤੋਂ Ollama ਕਾਲ ਕਰਨਾ
Ollama 'ਤੇ ਇੱਕ HTTP API ਦਾ ਪਰਦਾਫਾਸ਼ ਕਰਦਾ ਹੈ http://localhost:11434. ਇੱਕ ਛੋਟਾ ਨੋਡ ਪ੍ਰਾਪਤ ਕਰਨਾ ਇਸ ਤਰ੍ਹਾਂ ਦਿਖਾਈ ਦਿੰਦਾ ਹੈ:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
ਅਤੇ ਪਾਈਥਨ ਤੋਂ:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
ਇਹ ਉਹ ਸਭ ਕੁਝ ਹੈ ਜਿਸਦੀ ਤੁਹਾਨੂੰ ਸਥਾਨਕ LLM ਨੂੰ ਇੱਕ CLI ਟੂਲ, ਇੱਕ ਸਲੈਕ ਬੋਟ, ਇੱਕ ਸ਼ਾਰਟਕੱਟ, ਇੱਕ ਮਾਈਕ੍ਰੋਸਰਵਿਸ, ਜਾਂ ਇੱਕ ਅੰਦਰੂਨੀ ਆਟੋਮੇਸ਼ਨ ਵਿੱਚ ਤਾਰ ਕਰਨ ਦੀ ਲੋੜ ਹੈ। ਕੋਈ ਕੁੰਜੀਆਂ ਨਹੀਂ, ਕੋਈ ਦਰ ਸੀਮਾ ਨਹੀਂ, ਕੋਈ ਕੋਟਾ ਨਹੀਂ।
6. Mac Studio 'ਤੇ ਚੱਲਣ ਲਈ ਸਭ ਤੋਂ ਵਧੀਆ ਮਾਡਲ
ਇੱਕ ਮਾਡਲ ਚੁਣਨਾ ਭਾਗ ਪ੍ਰਦਰਸ਼ਨ, ਭਾਗ ਲਾਇਸੈਂਸ, ਭਾਗ ਵਾਈਬ ਹੈ। ਇਹ ਉਹ ਹੈ ਜੋ ਮੈਂ ਅਸਲ ਵਿੱਚ ਬਾਕਸ 'ਤੇ ਚਲਾਉਂਦਾ ਹਾਂ, ਆਕਾਰ ਦੇ ਪੱਧਰ ਦੁਆਰਾ ਸਮੂਹ ਕੀਤਾ ਗਿਆ ਹੈ।
6.1 ਛੋਟਾ (10B ਤੋਂ ਘੱਟ): ਤੇਜ਼ ਰੋਜ਼ਾਨਾ ਕੰਮ ਕਰਨ ਵਾਲੇ ਘੋੜੇ
- Llama 3.1 8B - ਸ਼ਾਨਦਾਰ ਆਮ-ਉਦੇਸ਼ ਗੱਲਬਾਤ ਅਤੇ ਤਰਕ; ਚੇਤਾਵਨੀਆਂ ਦੇ ਨਾਲ ਆਗਿਆਕਾਰੀ ਮੈਟਾ ਲਾਇਸੰਸ।
- Mistral 7B / Ministral 8B - ਮਜ਼ਬੂਤ ਤਰਕ, ਅਪਾਚੇ-ਲਾਇਸੰਸਸ਼ੁਦਾ ਰੂਪ ਉਪਲਬਧ ਹਨ।
- Qwen 2.5 7B - ਬਹੁਤ ਮਜ਼ਬੂਤ ਬਹੁਭਾਸ਼ਾਈ ਅਤੇ ਕੋਡ ਪ੍ਰਦਰਸ਼ਨ.
- ਫਾਈ-3.5 ਮਿਨੀ - ਛੋਟੇ, ਹੈਰਾਨੀਜਨਕ ਤੌਰ 'ਤੇ ਸਮਰੱਥ, ਆਦਰਸ਼ ਜਦੋਂ ਤੁਹਾਨੂੰ ਥ੍ਰੁਪੁੱਟ ਅਤੇ ਘੱਟ ਲੇਟੈਂਸੀ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ।
- ਕੋਡੇਸਟ੍ਰਲ / ਕਵੇਨ 2.5 ਕੋਡਰ 7ਬੀ - IDE ਕੰਮ ਲਈ ਤੇਜ਼ ਇਨਲਾਈਨ ਆਟੋਕੰਪਲੇਸ਼ਨ।
6.2 ਮਿਡ (10B-40B): 64-128 GB 'ਤੇ ਮਿੱਠਾ ਸਥਾਨ
- Llama 3.1 / 3.3 70B (Q4_K_M) - ਜੇਕਰ ਤੁਹਾਡੇ ਕੋਲ 128 GB ਹੈ, ਤਾਂ ਇਹ ਹੈੱਡਲਾਈਨ ਮਾਡਲ ਹੈ; ਨੇੜੇ-ਸਰਹੱਦ ਦੀ ਗੁਣਵੱਤਾ, ਆਰਾਮ ਨਾਲ ਚੱਲਦੀ ਹੈ।
- Qwen 2.5 32B - ਸ਼ਾਨਦਾਰ ਗੁਣਵੱਤਾ-ਤੋਂ-ਆਕਾਰ ਅਨੁਪਾਤ; RAG ਦੇ ਨਾਲ ਚੰਗੀ ਤਰ੍ਹਾਂ ਜੋੜੇ।
- ਡੀਪਸੀਕ-ਕੋਡਰ 33ਬੀ - ਕੋਡ ਬਣਾਉਣ ਦੇ ਕੰਮਾਂ ਵਿੱਚ ਮਜ਼ਬੂਤ.
- ਮਿਸ਼ਰਤ 8x7B - ਮਾਹਰਾਂ ਦਾ ਮਿਸ਼ਰਣ, ਇੱਕ ਸਮੇਂ ਵਿੱਚ ਸਿਰਫ 2 ਮਾਹਰਾਂ ਨੂੰ ਸਰਗਰਮ ਕਰਦਾ ਹੈ, ਆਰਾਮ ਨਾਲ ਫਿੱਟ ਬੈਠਦਾ ਹੈ।
6.3 ਵੱਡਾ (70B ਅਤੇ ਵੱਧ): ਸਿਰਫ਼ 96-128 GB 'ਤੇ ਅਤੇ ਸਿਰਫ਼ Q4 'ਤੇ
128 GB 'ਤੇ Q4_K_M 'ਤੇ ਦਰਵਾਜ਼ਾ 70B-ਕਲਾਸ ਮਾਡਲਾਂ ਲਈ ਖੁੱਲ੍ਹਾ ਹੈ। ਉਹ ਹੌਲੀ 8B ਮਾਡਲਾਂ ਨਾਲੋਂ, ਪਰ ਗੁਣਵੱਤਾ ਦੀ ਛਾਲ ਉਹਨਾਂ ਕੰਮਾਂ ਲਈ ਮਹੱਤਵਪੂਰਨ ਹੈ ਜੋ ਵਿਆਪਕ ਵਿਸ਼ਵ ਗਿਆਨ ਅਤੇ ਲੰਬੇ ਤਰਕ ਤੋਂ ਲਾਭ ਪ੍ਰਾਪਤ ਕਰਦੇ ਹਨ। ਪਹਿਲੀ-ਟੋਕਨ ਲੇਟੈਂਸੀ ਲੰਬੀ ਹੋਣ ਅਤੇ ਸਟ੍ਰੀਮਿੰਗ ਦੀ ਰਫ਼ਤਾਰ ਘੱਟਣ ਦੀ ਉਮੀਦ ਕਰੋ, ਪਰ ਅਸਲ ਅਨੁਭਵ ਬਹੁਤ ਸਾਰੇ ਵਰਕਫਲੋਜ਼ ਲਈ ਵਰਤੋਂ ਯੋਗ ਰਹਿੰਦਾ ਹੈ।
7. ਇੱਕ ਸਥਾਨਕ RAG ਪਾਈਪਲਾਈਨ ਬਣਾਉਣਾ
ਇੱਕ ਵਾਰ ਜਦੋਂ ਤੁਹਾਡੇ ਕੋਲ ਇੱਕ ਸਥਾਨਕ LLM ਹੋ ਜਾਂਦਾ ਹੈ, ਤਾਂ ਸਭ ਤੋਂ ਲਾਭਦਾਇਕ ਚੀਜ਼ ਜੋ ਤੁਸੀਂ ਇਸ ਨਾਲ ਕਰ ਸਕਦੇ ਹੋ ਉਹ ਹੈ ਇਸਨੂੰ ਤੁਹਾਡੇ ਆਪਣੇ ਦਸਤਾਵੇਜ਼ਾਂ 'ਤੇ ਪੁਆਇੰਟ ਕਰੋ। ਇਹ ਰੀਟ੍ਰੀਵਲ-ਔਗਮੈਂਟੇਡ ਜਨਰੇਸ਼ਨ ਹੈ, ਅਤੇ ਇਹ ਕੰਮ ਦਾ ਬੋਝ ਹੈ ਜਿੱਥੇ Mac Studio ਅਸਲ ਵਿੱਚ ਕਲਾਉਡ APIs ਦੇ ਇੱਕ ਨਿੱਜੀ ਵਿਕਲਪ ਵਜੋਂ ਚਮਕਦਾ ਹੈ।

7.1 ਸਟੈਕ
- ਦਸਤਾਵੇਜ਼ ਪਾਰਸਰ - ਪੀਡੀਐਫ ਲਈ PyMuPDF,
unstructuredਮਿਕਸਡ-ਫਾਰਮੈਟ ਇੰਜੈਸ਼ਨ ਲਈ। - ਚੰਕਰ - ਲੈਂਗਚੇਨ ਦਾ
RecursiveCharacterTextSplitterਜਾਂ ਇੱਕ ਟੋਕਨ-ਜਾਗਰੂਕ ਸਪਲਿਟਰ। ਓਵਰਲੈਪ ਦੇ 64-128 ਟੋਕਨਾਂ ਦੇ ਨਾਲ ਆਮ ਚੰਕ ਦਾ ਆਕਾਰ 512-1024 ਟੋਕਨ। - ਏਮਬੈਡਿੰਗਸ -
nomic-embed-textਜਾਂmxbai-embed-large, ਦੋਵੇਂ Ollama ਰਾਹੀਂ ਉਪਲਬਧ ਹਨ। ਦੋਵੇਂ ਸਥਾਨਕ GPU 'ਤੇ ਚੱਲਦੇ ਹਨ। - ਵੈਕਟਰ ਸਟੋਰ - ਮੂਲ ਰੂਪ ਵਿੱਚ ChromaDB। ਜ਼ੀਰੋ-ਸਰਵਰ ਵਿਕਲਪ ਲਈ SQLite-VSS। LanceDB ਜੇਕਰ ਤੁਸੀਂ ਇੱਕ ਸਿੰਗਲ-ਫਾਈਲ ਏਮਬੈਡਡ ਵਿਕਲਪ ਚਾਹੁੰਦੇ ਹੋ ਜੋ ਸਕੇਲ ਕਰਦਾ ਹੈ।
- ਜਨਰੇਟਰ - ਤੇਜ਼ ਤਬਦੀਲੀ ਲਈ Llama 3.1 8B, ਜਾਂ ਜੇਕਰ ਤੁਸੀਂ ਉੱਚ-ਗੁਣਵੱਤਾ ਵਾਲੇ ਜਵਾਬ ਚਾਹੁੰਦੇ ਹੋ ਤਾਂ 70B।
7.2 ਨਿਊਨਤਮ ਪਾਈਥਨ ਉਦਾਹਰਨ - ਅੰਤ ਤੋਂ ਅੰਤ ਤੱਕ
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
ਇਹ ਪਾਈਥਨ ਦੀਆਂ 60 ਲਾਈਨਾਂ ਵਿੱਚ ਇੱਕ ਪੂਰੀ ਸਥਾਨਕ RAG ਪਾਈਪਲਾਈਨ ਹੈ। ਸਾਰੀ ਚੀਜ਼ Mac Studio 'ਤੇ ਚੱਲਦੀ ਹੈ। ਕੋਈ ਬਾਹਰੀ API ਕੁੰਜੀਆਂ ਨਹੀਂ, ਕੋਈ ਪ੍ਰਤੀ-ਟੋਕਨ ਬਿਲਿੰਗ ਨਹੀਂ, ਮਸ਼ੀਨ ਨੂੰ ਛੱਡਣ ਵਾਲਾ ਕੋਈ ਡਾਟਾ ਨਹੀਂ। ਇੱਕ ਵੱਡੇ PDF ਸੈੱਟ ਦਾ ਪਹਿਲਾ ਇੰਜੈਸ਼ਨ ਕੁਝ ਮਿੰਟ ਲਵੇਗਾ; ਬਾਅਦ ਦੇ ਸਵਾਲ ਤੇਜ਼ ਹਨ।
7.3 ਟਿਊਨਿੰਗ ਨੋਟਸ
- ਟੁਕੜੇ ਦਾ ਆਕਾਰ - 1000 ਅੱਖਰਾਂ ਅਤੇ ਓਵਰਲੈਪ ਦੇ 150 ਨਾਲ ਸ਼ੁਰੂ ਕਰੋ; ਜੇਕਰ ਤੁਹਾਡੇ ਸਰੋਤਾਂ ਵਿੱਚ ਲੰਬੇ ਸੰਰਚਨਾ ਵਾਲੇ ਭਾਗ (ਕਾਨੂੰਨੀ, ਤਕਨੀਕੀ ਚਸ਼ਮੇ) ਹਨ ਅਤੇ ਪ੍ਰਾਪਤ ਕਰਨ ਵਾਲੇ ਜਵਾਬਾਂ ਨੂੰ ਤੋੜ ਰਹੇ ਹਨ ਤਾਂ ਟਕਰਾਓ।
- ਸਿਖਰ-ਕੇ - 4-8 ਵਿਹਾਰਕ ਸੀਮਾ ਹੈ। ਬਹੁਤ ਜ਼ਿਆਦਾ ਜਾਣਾ ਪ੍ਰੋਂਪਟ ਨੂੰ ਵਧਾਉਂਦਾ ਹੈ ਅਤੇ ਸਪੱਸ਼ਟ ਲਾਭਾਂ ਤੋਂ ਬਿਨਾਂ ਉਤਪਾਦਨ ਨੂੰ ਹੌਲੀ ਕਰਦਾ ਹੈ।
- ਮੁੜ ਦਰਜਾਬੰਦੀ - ਉੱਚਤਮ ਕੁਆਲਿਟੀ ਲਈ, ਟੌਪ-20 ਮੁੜ ਪ੍ਰਾਪਤ ਕਰੋ ਅਤੇ ਇੱਕ ਕਰਾਸ-ਏਨਕੋਡਰ ਨਾਲ ਮੁੜ-ਰੈਂਕ ਕਰੋ (ਉਦਾ.
bge-reranker). Mac Studio 'ਤੇ ਇਹ ਸਸਤਾ ਹੈ। - ਮੈਟਾਡਾਟਾ ਫਿਲਟਰਿੰਗ - ਉਹਨਾਂ ਦੇ ਸਰੋਤ ਮਾਰਗ, ਮਿਤੀ, ਅਤੇ ਭਾਗ ਦੇ ਨਾਲ ਟੈਗ ਭਾਗ; ਵੈਕਟਰ ਖੋਜ ਤੋਂ ਪਹਿਲਾਂ ਪੁੱਛਗਿੱਛ ਸਮੇਂ ਫਿਲਟਰ ਕਰੋ। ਇਹ ਇਕਲੌਤੀ ਸਭ ਤੋਂ ਵੱਡੀ ਸ਼ੁੱਧਤਾ ਜਿੱਤ ਹੈ।
- ਸਟ੍ਰੀਮਿੰਗ - ਸਵਿੱਚ
streamਨੂੰtrueOllama ਕਾਲ ਵਿੱਚ ਅਤੇ ਇੱਕ ਸਨੈਪੀ UX ਲਈ ਕਲਾਇੰਟ ਨੂੰ ਟੋਕਨ ਸਟ੍ਰੀਮ ਕਰੋ।
8. ਦਿਨ ਪ੍ਰਤੀ ਦਿਨ ਡਿਵੈਲਪਰ ਲੂਪ
Mac Studio 'ਤੇ ਕੁਝ ਹਫ਼ਤਿਆਂ ਬਾਅਦ ਮੇਰਾ ਰੋਜ਼ਾਨਾ ਲੂਪ ਇਸ ਤਰ੍ਹਾਂ ਦਿਖਾਈ ਦਿੰਦਾ ਹੈ:
- VS ਕੋਡ ਖੋਲ੍ਹੋ, Continue.dev Ollama ਦੇ ਵਿਰੁੱਧ ਜਾਗਦਾ ਹੈ।
- ਮੇਰੇ ਨੋਟਸ ਦੇ ਵਿਰੁੱਧ ਲੰਬੇ ਸਮੇਂ ਤੱਕ ਗੱਲਬਾਤ ਦੇ ਸਵਾਲ ਅਤੇ ਜਵਾਬ ਲਈ ਓਪਨ WebUI (ਜਾਂ LM ਸਟੂਡੀਓ) ਵਿੱਚ ਇੱਕ ਚੈਟ ਖੋਲ੍ਹੋ।
- ਕੋਡ ਦੇ ਕੰਮ ਲਈ: ਕੋਡਸਟ੍ਰਲ ਜਾਂ ਕਵੇਨ ਕੋਡਰ ਮਾਡਲ 'ਤੇ ਟੈਬ-ਆਟੋ-ਕੰਪਲੀਟ, Llama 3.1 8B 'ਤੇ ਲੰਬੀਆਂ ਚੈਟਾਂ, 70B 'ਤੇ ਡੂੰਘੇ ਤਰਕ ਸੈਸ਼ਨ, ਜਦੋਂ ਕਾਰਜ ਇਸਦੀ ਵਾਰੰਟੀ ਦਿੰਦਾ ਹੈ।
- ਅੰਦਰੂਨੀ RAG ਲਈ, ਇੱਕ ਪਾਈਥਨ ਸਕ੍ਰਿਪਟ ਜੋ ਪ੍ਰੋਜੈਕਟ ਦੇ ਡੌਕਸ/ਫੋਲਡਰ ਅਤੇ ਇੱਕ ਕ੍ਰੋਮਾ ਡੇਟਾਬੇਸ ਵੱਲ ਇਸ਼ਾਰਾ ਕਰਦੀ ਹੈ।
- ਏਜੰਟ ਪ੍ਰੋਟੋਟਾਈਪਿੰਗ ਲਈ, ਲੈਂਗਗ੍ਰਾਫ ਜਾਂ ਇੱਕ ਛੋਟਾ ਕਸਟਮ ਲੂਪ ਜੋ Ollama ਐਂਡਪੁਆਇੰਟ ਨੂੰ ਕਾਲ ਕਰਦਾ ਹੈ - ਇੱਕੋ ਪੈਟਰਨ, ਵੱਖਰਾ ਗੂੰਦ।
ਉਹ ਚੀਜ਼ ਜੋ ਅਸਲ ਵਿੱਚ ਬਦਲਦੀ ਹੈ ਜਦੋਂ ਤੁਹਾਡਾ LLM ਸਥਾਨਕ ਹੁੰਦਾ ਹੈ ਉਹ ਤਰੀਕਾ ਹੈ ਜਿਸਦੀ ਤੁਸੀਂ ਵਰਤੋਂ ਕਰਦੇ ਹੋ। ਕਿਸੇ ਪੁੱਛਗਿੱਛ ਲਈ ਕੋਈ ਵਾਧਾ ਲਾਗਤ ਨਹੀਂ ਹੈ, ਇਸਲਈ ਤੁਸੀਂ ਮਾਡਲ ਤੋਂ ਹੋਰ ਸਵਾਲ ਪੁੱਛੋ। ਕੋਈ ਗੋਪਨੀਯਤਾ ਚਿੰਤਾ ਨਹੀਂ ਹੈ, ਇਸਲਈ ਤੁਸੀਂ ਉਤਪਾਦਨ ਲੌਗਸ, ਅੰਦਰੂਨੀ ਦਸਤਾਵੇਜ਼ਾਂ, ਗਾਹਕ ਈਮੇਲਾਂ ਵਿੱਚ ਪੇਸਟ ਕਰੋ। ਤੁਸੀਂ ਛੋਟੀਆਂ CLI ਸਕ੍ਰਿਪਟਾਂ ਲਿਖਦੇ ਹੋ ਜੋ ਇੱਕ ਢਾਂਚਾਗਤ ਸਾਰਾਂਸ਼ ਕੱਢਣ ਲਈ 200 ਦਸਤਾਵੇਜ਼ਾਂ ਵਿੱਚੋਂ ਲੰਘਦੀਆਂ ਹਨ, ਅਤੇ ਤੁਸੀਂ ਪ੍ਰਤੀ-ਟੋਕਨ ਬਿੱਲ ਬਾਰੇ ਦੋ ਵਾਰ ਨਹੀਂ ਸੋਚਦੇ, ਕਿਉਂਕਿ ਕੋਈ ਬਿੱਲ ਨਹੀਂ ਹੈ।
9. ਬੈਂਚਮਾਰਕ ਅਤੇ ਇਮਾਨਦਾਰ ਤੁਲਨਾ ਬਨਾਮ ਕਲਾਉਡ
ਮੈਨੂੰ ਬਹੁਤ ਸਿੱਧਾ ਹੋਣ ਦਿਓ: ਮੈਂ ਟੋਕਨ-ਪ੍ਰਤੀ-ਸੈਕਿੰਡ ਨੰਬਰਾਂ ਨੂੰ ਪ੍ਰਕਾਸ਼ਿਤ ਨਹੀਂ ਕਰਨ ਜਾ ਰਿਹਾ ਹਾਂ ਜੋ ਮੈਂ ਇੱਕ ਸਖਤ ਨਿਯੰਤਰਿਤ ਬੈਂਚਮਾਰਕ ਵਿਧੀ ਨਾਲ ਤਿਆਰ ਨਹੀਂ ਕੀਤਾ ਹੈ। ਇੰਟਰਨੈਟ ਅਜਿਹੇ ਸੰਖਿਆਵਾਂ ਨਾਲ ਭਰਿਆ ਹੋਇਆ ਹੈ, ਅਕਸਰ ਵੱਖੋ-ਵੱਖਰੇ ਮਾਤਰਾ ਦੇ ਪੱਧਰਾਂ ਅਤੇ ਸੰਦਰਭ ਲੰਬਾਈ ਅਤੇ ਪ੍ਰੋਂਪਟ ਫਾਰਮੈਟਾਂ ਦੀ ਤੁਲਨਾ ਕਰਦਾ ਹੈ, ਅਤੇ ਉਹ ਸਪੱਸ਼ਟ ਕਰਨ ਨਾਲੋਂ ਜ਼ਿਆਦਾ ਉਲਝਣ ਵਿੱਚ ਪਾਉਂਦੇ ਹਨ। ਇਸਦੀ ਬਜਾਏ ਮੈਂ ਕੀ ਕਰਾਂਗਾ ਇੱਕ ਫੈਸਲਾ ਮੈਟ੍ਰਿਕਸ ਪ੍ਰਕਾਸ਼ਿਤ ਕਰਨਾ ਹੈ ਜੋ ਕੈਪਚਰ ਕਰਦਾ ਹੈ Mac Studio ਅਸਲ ਵਿੱਚ ਕਿਸ ਤਰ੍ਹਾਂ ਦਾ ਵਰਕਲੋਡ ਜਿੱਤਦਾ ਹੈ, ਜਿੱਥੇ ਇਹ ਨਹੀਂ ਹੈ, ਅਤੇ ਜਿੱਥੇ ਸਹੀ ਜਵਾਬ ਹੈ "ਦੋਵਾਂ ਦੀ ਵਰਤੋਂ ਕਰੋ"।

9.1 ਬ੍ਰੇਕ-ਈਵਨ ਗਣਿਤ
128 GB ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਵਾਲਾ ਇੱਕ Mac Studio M4 Max ਅਤੇ ਇੱਕ 2 TB SSD ਲਗਭਗ ਉਸੇ ਕੀਮਤ ਬੈਂਡ ਵਿੱਚ ਲੈਂਡ ਕਰਦਾ ਹੈ ਜਿਵੇਂ ਕਿ ਇੱਕ ਹਮੇਸ਼ਾ-ਚਾਲੂ ਕਲਾਉਡ GPU ਉਦਾਹਰਨ ਦੇ ਕੁਝ ਮਹੀਨਿਆਂ ਵਿੱਚ। ਸਾਰੇ ਖਾਸ ਡਾਲਰ ਦੇ ਅੰਕੜਿਆਂ ਨੂੰ ਅਨੁਮਾਨਿਤ ਅਤੇ ਖੇਤਰ ਅਤੇ ਛੋਟ ਦੇ ਕਾਰਜ ਵਜੋਂ ਮੰਨੋ:
- ਇੱਕ Mac Studio M4 Max, ਚੰਗੀ ਤਰ੍ਹਾਂ ਸੰਰਚਿਤ: ਲਗਭਗ $4,000- $6,000 ਇੱਕ ਵਾਰ (ਅੰਦਾਜਨ; ਸੰਰਚਨਾ ਵੱਖ-ਵੱਖ ਹੁੰਦੀ ਹੈ)।
- ਇੱਕ AWS
g5.xlarge(ਸਿੰਗਲ A10G, 24 GB VRAM) 24x7 ਆਨ-ਡਿਮਾਂਡ ਚੱਲ ਰਿਹਾ ਹੈ: $700- $900 ਪ੍ਰਤੀ ਮਹੀਨਾ (ਖੇਤਰ-ਨਿਰਭਰ) ਦੇ ਕ੍ਰਮ ਵਿੱਚ। - ਇੱਕ AWS
p4d.24xlarge(8x A100): ਮੰਗ 'ਤੇ $20,000-$30,000 ਪ੍ਰਤੀ ਮਹੀਨਾ ਦਾ ਆਰਡਰ ਜੇਕਰ ਤੁਸੀਂ ਇਸ ਨੂੰ ਕਿਸੇ ਤਰ੍ਹਾਂ ਛੱਡ ਦਿੱਤਾ ਹੈ (ਤੁਸੀਂ ਨਹੀਂ ਕਰੋਗੇ, ਪਰ ਇਹ ਉਲਟ ਸਪੱਸ਼ਟ ਕਰਦਾ ਹੈ)।
ਅੰਕਗਣਿਤ ਕਹਿੰਦਾ ਹੈ ਕਿ ਇੱਕ ਹਮੇਸ਼ਾਂ-ਚਾਲੂ ਡਿਵ ਬਾਕਸ ਲਈ, Mac Studio ਇੱਕ ਤੁਲਨਾਤਮਕ ਹਮੇਸ਼ਾਂ-ਆਨ ਕਲਾਉਡ ਉਦਾਹਰਣ ਦੇ ਮੁਕਾਬਲੇ ਕੁਝ ਮਹੀਨਿਆਂ ਵਿੱਚ ਆਪਣੇ ਲਈ ਭੁਗਤਾਨ ਕਰਦਾ ਹੈ, ਅਤੇ ਸਾਲਾਂ ਤੱਕ ਬਿਜਲੀ ਦੇ ਰੂਪ ਵਿੱਚ ਆਪਣੇ ਲਈ ਭੁਗਤਾਨ ਕਰਨਾ ਜਾਰੀ ਰੱਖਦਾ ਹੈ। ਬਰਸਟ ਸਿਖਲਾਈ ਦੀਆਂ ਨੌਕਰੀਆਂ ਲਈ ਗਣਿਤ ਪਲਟ ਜਾਂਦਾ ਹੈ: ਇੱਕ ਘੰਟੇ ਲਈ ਕਿਰਾਏ 'ਤੇ, ਦੌੜੋ, ਇਸਨੂੰ ਵਾਪਸ ਦਿਓ। ਨੌਕਰੀ ਲਈ ਸਹੀ ਸਾਧਨ ਦੀ ਵਰਤੋਂ ਕਰੋ।
9.2 ਜਦੋਂ ਬੱਦਲ ਸਹੀ ਉੱਤਰ ਹੈ
- ਤੁਹਾਨੂੰ 128 GB ਵਿੱਚ ਫਿੱਟ ਹੋਣ ਤੋਂ ਵੱਡੇ ਮਾਡਲ ਨੂੰ ਸਿਖਲਾਈ ਦੇਣ ਜਾਂ ਵਧੀਆ-ਟਿਊਨ ਕਰਨ ਦੀ ਲੋੜ ਹੈ।
- ਤੁਹਾਨੂੰ ਸਖਤ SLOs ਅਤੇ ਲਚਕੀਲੇ ਸਮਰੱਥਾ ਦੇ ਨਾਲ ਇੱਕ ਗਲੋਬਲ ਉਪਭੋਗਤਾ ਅਧਾਰ ਦੇ ਪੱਧਰ 'ਤੇ ਸੇਵਾ ਕਰਨ ਦੀ ਲੋੜ ਹੈ।
- ਤੁਸੀਂ ਇੱਕ ਪ੍ਰਯੋਗ ਚਲਾ ਰਹੇ ਹੋ ਜੋ 8x A100 ਜਾਂ H100 ਸਮਾਨਤਾ ਤੋਂ ਲਾਭ ਪ੍ਰਾਪਤ ਕਰਦਾ ਹੈ।
- ਤੁਹਾਡੇ ਸੰਗਠਨ ਦੀ ਪਾਲਣਾ ਦੀ ਸਥਿਤੀ ਦੱਸਦੀ ਹੈ ਕਿ ਅਨੁਮਾਨ ਨੂੰ ਖਾਸ ਆਡਿਟ ਟ੍ਰੇਲ ਦੇ ਨਾਲ ਇੱਕ ਖਾਸ ਕਲਾਉਡ ਖੇਤਰ ਵਿੱਚ ਚੱਲਣਾ ਚਾਹੀਦਾ ਹੈ।
9.3 ਜਦੋਂ Mac Studio ਸਹੀ ਜਵਾਬ ਹੈ
- ਤੁਸੀਂ ਆਪਣੀ ਟੀਮ ਲਈ ਇੱਕ ਹਮੇਸ਼ਾ-ਚਾਲੂ ਨਿੱਜੀ ਅਨੁਮਾਨ ਬਾਕਸ ਚਾਹੁੰਦੇ ਹੋ।
- ਤੁਸੀਂ RAG, ਏਜੰਟ, ਜਾਂ IDE ਕੋਪਾਇਲਟ ਬਣਾ ਰਹੇ ਹੋ ਜਿੱਥੇ ਡੇਟਾ ਰੈਜ਼ੀਡੈਂਸੀ ਅਤੇ ਗੋਪਨੀਯਤਾ ਮਹੱਤਵਪੂਰਨ ਹੈ।
- ਤੁਸੀਂ ਇੱਕ ਸ਼ਾਂਤ, ਘੱਟ-ਪਾਵਰ ਵਾਲਾ ਦੇਵ ਬਾਕਸ ਚਾਹੁੰਦੇ ਹੋ ਜਿਸ ਲਈ ਸਰਵਰ ਰੂਮ ਦੀ ਲੋੜ ਨਹੀਂ ਹੈ।
- ਤੁਸੀਂ ਤੇਜ਼ੀ ਨਾਲ ਪ੍ਰੋਟੋਟਾਈਪ ਕਰ ਰਹੇ ਹੋ ਅਤੇ ਕਲਾਊਡ API ਦੀ ਪ੍ਰਤੀ-ਟੋਕਨ ਬਿਲਿੰਗ ਤੁਹਾਡੇ ਰਾਹ ਵਿੱਚ ਹੈ।
- ਤੁਸੀਂ ਸਟੈਕ ਸਿੱਖਣਾ ਚਾਹੁੰਦੇ ਹੋ - ਇੱਕ ਮਾਡਲ ਦੇ ਮਾਲਕ, ਇੱਕ ਰਨਟਾਈਮ ਦੇ ਮਾਲਕ, ਇੱਕ ਵੈਕਟਰ ਸਟੋਰ ਦੇ ਮਾਲਕ, ਲੂਪ ਦੇ ਮਾਲਕ।
10. ਚੁਣੌਤੀਆਂ ਅਤੇ ਸੀਮਾਵਾਂ
ਮੈਂ ਇਸ ਲੇਖ ਨੂੰ ਕੋਈ ਪੱਖ ਨਹੀਂ ਕਰਾਂਗਾ ਜੇ ਮੈਂ ਮੋਟੇ ਕਿਨਾਰਿਆਂ ਦਾ ਨਾਮ ਨਹੀਂ ਲੈਂਦਾ. Apple Silicon ਸਥਾਨਕ AI ਲਈ ਸ਼ਾਨਦਾਰ ਹੈ, ਪਰ ਅਸਲ ਚੇਤਾਵਨੀਆਂ ਹਨ।
10.1 ਸਿਖਲਾਈ ਅਜੇ ਵੀ ਅਨੁਮਾਨ ਨਾਲੋਂ ਕਮਜ਼ੋਰ ਕਹਾਣੀ ਹੈ
ਲਈ Apple Silicon AI ਕਹਾਣੀ ਬਹੁਤ ਮਜ਼ਬੂਤ ਹੈ ਅਨੁਮਾਨ ਲਈ ਵੱਧ ਸਿਖਲਾਈ. PyTorch ਦਾ MPS ਬੈਕਐਂਡ ਕਾਫ਼ੀ ਪਰਿਪੱਕ ਹੋ ਗਿਆ ਹੈ, ਅਤੇ Apple ਦਾ ਆਪਣਾ MLX ਫਰੇਮਵਰਕ ਅਸਲ ਵਿੱਚ ਵਧੀਆ ਹੈ, ਪਰ CUDA-ਸਿਰਫ ਸਿਖਲਾਈ ਟੂਲਿੰਗ ਦੀ ਚੌੜਾਈ ਅਜੇ ਵੀ ਵਿਸ਼ਾਲ ਹੈ। ਜੇ ਤੁਹਾਡਾ ਦਿਨ ਦਾ ਕੰਮ ਨਾਵਲ ਮਾਡਲ ਆਰਕੀਟੈਕਚਰ ਜਾਂ ਵੱਡੇ ਪੈਮਾਨੇ ਦੀ ਫਾਈਨ-ਟਿਊਨਿੰਗ ਹੈ, ਤਾਂ ਤੁਸੀਂ ਛੇਕ ਕਰੋਗੇ ਜੋ ਤੁਸੀਂ ਲੀਨਕਸ + NVIDIA 'ਤੇ ਨਹੀਂ ਮਾਰਦੇ.
10.2 ਈਕੋਸਿਸਟਮ ਕਈ ਥਾਵਾਂ 'ਤੇ CUDA ਨੂੰ ਮੰਨਦਾ ਹੈ
ਬਹੁਤ ਸਾਰੇ AI ਰੈਪੋ ਅਜੇ ਵੀ CUDA ਧਾਰਨਾਵਾਂ ਲਈ ਡਿਫਾਲਟ ਹਨ। ਬਹੁਤੇ ਰੱਖ-ਰਖਾਅ ਵਾਲੇ ਪ੍ਰੋਜੈਕਟਾਂ ਵਿੱਚ ਹੁਣ ਧਾਤੂ / MPS ਮਾਰਗ ਹਨ, ਪਰ ਕਦੇ-ਕਦਾਈਂ ਘਿਰਣਾ ਦੀ ਉਮੀਦ ਕਰਦੇ ਹਨ: ਇੱਕ ਲਾਇਬ੍ਰੇਰੀ ਜਿਸ ਲਈ ਸਰੋਤ ਤੋਂ ਬਿਲਡਿੰਗ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ, ਇੱਕ ਕਰਨਲ ਜਿਸਦਾ ਕੋਈ ਧਾਤੂ ਸਮਾਨ ਨਹੀਂ ਹੈ, ਇੱਕ ਬੈਂਚਮਾਰਕ ਸੂਟ ਜੋ ਸਿਰਫ NVIDIA 'ਤੇ ਚੱਲਦਾ ਹੈ। ਇਸਦੇ ਲਈ ਸਮਾਂ ਯੋਜਨਾ ਬਣਾਓ।
10.3 ਸਕੇਲਿੰਗ ਆਊਟ DIY ਹੈ
ਇੱਕ Mac Studio ਇੱਕ ਸਿੰਗਲ ਬਾਕਸ ਹੈ। ਵਰਗੇ ਸੰਦ EXO ਅਤੇ ਹੋਰ ਤੁਹਾਨੂੰ ਬਹੁਤ ਸਾਰੇ ਡਿਵਾਈਸਾਂ ਵਿੱਚ ਬਹੁਤ ਵੱਡੇ ਮਾਡਲਾਂ ਨੂੰ ਚਲਾਉਣ ਲਈ ਮੈਕਸ ਨੂੰ ਕਲੱਸਟਰ ਕਰਨ ਦਿੰਦੇ ਹਨ, ਪਰ ਇਹ ਉਹ ਪਾਲਿਸ਼ਡ ਕਹਾਣੀ ਨਹੀਂ ਹੈ ਜੋ ਤੁਸੀਂ g5s ਦੇ Kubernetes ਕਲੱਸਟਰ ਨਾਲ ਪ੍ਰਾਪਤ ਕਰਦੇ ਹੋ। ਜੇਕਰ ਤੁਹਾਡੇ ਕੰਮ ਦੇ ਬੋਝ ਨੂੰ ਹਰੀਜੱਟਲ ਲਚਕੀਲੇਪਨ ਦੀ ਲੋੜ ਹੈ, ਤਾਂ ਕਲਾਊਡ ਅਜੇ ਵੀ ਬਿਹਤਰ ਹੈ।
10.4 ਮੁਰੰਮਤ ਅਤੇ ਅੱਪਗਰੇਡ
ਤੁਸੀਂ ਬਾਅਦ ਵਿੱਚ RAM ਨਹੀਂ ਜੋੜ ਸਕਦੇ ਹੋ। ਤੁਸੀਂ ਬਾਅਦ ਵਿੱਚ SSD ਨੂੰ ਸਵੈਪ ਨਹੀਂ ਕਰ ਸਕਦੇ (ਅਮਲੀ ਤੌਰ 'ਤੇ)। ਜੋ ਤੁਹਾਨੂੰ ਚਾਹੀਦਾ ਹੈ ਉਹ ਖਰੀਦੋ, ਫਿਰ ਪਲੱਸ ਵਨ - ਖਾਸ ਕਰਕੇ ਮੈਮੋਰੀ 'ਤੇ। 128 GB ਟੀਅਰ ਉਹ ਹੈ ਜੋ ਮੈਂ ਗੰਭੀਰ AI ਕੰਮ ਲਈ ਸਿਫਾਰਸ਼ ਕਰਾਂਗਾ; 64 GB ਮੰਜ਼ਿਲ ਹੈ।
10.5 ਸਥਿਰ ਲੋਡ ਅਧੀਨ ਥਰਮਲ
Mac Studio ਵਿਹਲੇ ਹੋਣ 'ਤੇ ਠੰਡਾ ਅਤੇ ਸ਼ਾਂਤ ਚੱਲਦਾ ਹੈ (ਉਪਰੋਕਤ ਸਕ੍ਰੀਨਸ਼ੌਟ ਪ੍ਰਸ਼ੰਸਕਾਂ ਨੂੰ ਸੁਣਨ ਤੋਂ ਬਾਹਰ 37 C ਅਤੇ 30 C ਦਿਖਾਉਂਦਾ ਹੈ)। ਲਗਾਤਾਰ ਭਾਰੀ LLM ਲੋਡ ਦੇ ਤਹਿਤ, ਪ੍ਰਸ਼ੰਸਕ ਘੁੰਮਦੇ ਹਨ - ਉੱਚੀ ਨਹੀਂ, ਪਰ ਸੁਣਨ ਨਾਲ - ਅਤੇ ਚਿੱਪ ਗਰਮ ਹੁੰਦੀ ਹੈ। ਇਹ ਨਾਮਾਤਰ ਥਰਮਲ ਲਿਫ਼ਾਫ਼ਿਆਂ ਦੇ ਅੰਦਰ ਚੰਗੀ ਤਰ੍ਹਾਂ ਹੈ; ਬਸ ਧਿਆਨ ਰੱਖੋ ਕਿ "ਚੁੱਪ" ਇੱਕ ਵਿਹਲਾ ਅਤੇ ਹਲਕਾ-ਲੋਡ ਵਿਸ਼ੇਸ਼ਤਾ ਹੈ, ਇੱਕ ਪੂਰਨ ਨਹੀਂ।
11. Apple Silicon 'ਤੇ ਸਥਾਨਕ AI ਦਾ ਭਵਿੱਖ
ਤਿੰਨ ਰੁਝਾਨ ਇਕੱਠੇ ਹੋ ਰਹੇ ਹਨ ਜੋ Apple Silicon 'ਤੇ ਸਥਾਨਕ AI ਲਈ ਅਗਲੇ 12-24 ਮਹੀਨਿਆਂ ਨੂੰ ਦਿਲਚਸਪ ਬਣਾਉਂਦੇ ਹਨ।
ਪਹਿਲਾਂ, ਓਪਨ-ਵੇਟ ਮਾਡਲ ਸਮਰੱਥਾ ਨੂੰ ਗੁਆਏ ਬਿਨਾਂ ਛੋਟੇ ਹੁੰਦੇ ਰਹਿੰਦੇ ਹਨ. Phi-3.5, Qwen 2.5 ਛੋਟਾ, ਅਤੇ Llama 3.x ਪਰਿਵਾਰ ਆਪਣੇ ਭਾਰ ਵਰਗ ਤੋਂ ਉੱਪਰ 8B ਪੰਚ 'ਤੇ। ਇੱਕ 2026 8B ਮਾਡਲ ਬਹੁਤ ਸਾਰੇ ਕੰਮਾਂ ਵਿੱਚ ਗੁਣਵੱਤਾ ਵਿੱਚ 2023 70B ਨਾਲ ਤੁਲਨਾਯੋਗ ਹੈ। ਇਸਦਾ ਮਤਲਬ ਹੈ ਕਿ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਦੇ 32-64 GB ਵਿੱਚ ਵਧੇਰੇ ਵਰਕਲੋਡ ਆਰਾਮ ਨਾਲ ਫਿੱਟ ਹੋ ਜਾਂਦੇ ਹਨ, ਅਤੇ ਇੱਕ 128 GB Mac Studio ਇੱਕ ਮਲਟੀ-ਮਾਡਲ ਸਰਵਿੰਗ ਬਾਕਸ ਬਣ ਜਾਂਦਾ ਹੈ।
ਦੂਜਾ, ਐਪਲ ਦਾ ਆਪਣਾ MLX ਫਰੇਮਵਰਕ ਸੁਧਾਰ ਕਰਦਾ ਰਹਿੰਦਾ ਹੈ. MLX ਇੱਕ NumPy-ਵਰਗੇ API, ਆਲਸੀ ਮੁਲਾਂਕਣ, ਮੂਲ ਰੂਪ ਵਿੱਚ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਜਾਗਰੂਕਤਾ, ਅਤੇ ਗਤੀਸ਼ੀਲ ਗਣਨਾ ਗ੍ਰਾਫ ਪ੍ਰਦਾਨ ਕਰਦਾ ਹੈ। MLX ਕਮਿਊਨਿਟੀ ਇੱਕ ਤੇਜ਼ ਕਲਿੱਪ 'ਤੇ ਮਾਡਲ, ਟੋਕਨਾਈਜ਼ਰ, ਅਤੇ ਸਿਖਲਾਈ ਲੂਪਸ ਨੂੰ ਪੋਰਟ ਕਰ ਰਹੀ ਹੈ। ਜੇਕਰ ਤੁਸੀਂ ਅੱਜ ਮੈਕ 'ਤੇ ਇੱਕ ਨਵਾਂ ML ਪ੍ਰੋਜੈਕਟ ਸ਼ੁਰੂ ਕਰ ਰਹੇ ਹੋ, ਤਾਂ MLX ਕੁਦਰਤੀ ਵਿਕਲਪ ਹੈ; ਜੇਕਰ ਤੁਸੀਂ PyTorch ਦੀ ਵਰਤੋਂ ਕਰ ਰਹੇ ਹੋ, ਤਾਂ MPS ਬੈਕਐਂਡ ਹਰ ਰੀਲੀਜ਼ ਵਿੱਚ ਵਧੇਰੇ ਵਰਤੋਂ ਯੋਗ ਹੈ।
ਤੀਜਾ, quantisation ਅਤੇ KV-ਕੈਸ਼ ਕੰਪਰੈਸ਼ਨ ਬਿਹਤਰ ਹੁੰਦੇ ਰਹਿੰਦੇ ਹਨ. Q4_K_M, IQ-ਪਰਿਵਾਰਕ ਮਾਤਰਾਵਾਂ, ਅਤੇ GGUF ਸੁਧਾਰਾਂ ਵਰਗੀਆਂ ਤਕਨੀਕਾਂ ਦਾ ਮਤਲਬ ਹੈ ਕਿ ਉਹੀ ਮਾਡਲ ਘੱਟ ਮੈਮੋਰੀ ਵਿੱਚ ਫਿੱਟ ਬੈਠਦਾ ਹੈ ਜੋ ਕਿ ਛੇ ਮਹੀਨੇ ਪਹਿਲਾਂ ਸੀ, ਘੱਟ ਗੁਣਵੱਤਾ ਦੇ ਨੁਕਸਾਨ ਦੇ ਨਾਲ। ਸਥਾਨਕ AI ਇੱਕ ਕਰਵ 'ਤੇ ਹੈ ਜਿੱਥੇ ਮਾਡਲ + ਕੁਆਂਟ ਪੇਅਰਿੰਗ ਦੀ ਹਰੇਕ ਪੀੜ੍ਹੀ ਉਪਭੋਗਤਾ-ਕੀਮਤ ਵਾਲੇ ਹਾਰਡਵੇਅਰ ਦੀ ਵਿਹਾਰਕ ਪਹੁੰਚ ਨੂੰ ਵਧਾਉਂਦੀ ਹੈ।
ਇਸ ਸਭ ਵਿੱਚ ਭਵਿੱਖੀ ਐਮ-ਸੀਰੀਜ਼ ਚਿਪਸ (M5, ਭਵਿੱਖ ਦੇ ਅਲਟਰਾ, ਸਟੂਡੀਓ ਰਿਫਰੈਸ਼) ਦੇ ਆਲੇ ਦੁਆਲੇ ਅਫਵਾਹ ਮਿੱਲ ਨੂੰ ਸ਼ਾਮਲ ਕਰੋ, ਅਤੇ ਚਾਲ ਸਪੱਸ਼ਟ ਹੈ: ਡੈਸਕ-ਸਾਈਡ AI ਬਾਕਸ ਇੱਥੇ ਹੈ, ਅਤੇ ਇਹ ਬਿਹਤਰ ਹੁੰਦਾ ਜਾ ਰਿਹਾ ਹੈ.
12. ਟੀਮ ਏਆਈ ਬਾਕਸ ਦੇ ਤੌਰ 'ਤੇ Mac Studio ਨੂੰ ਸਖ਼ਤ ਕਰਨਾ
ਜੇਕਰ ਤੁਸੀਂ ਆਪਣੇ Mac Studio ਨੂੰ ਇੱਕ ਛੋਟੀ ਟੀਮ ਨਾਲ ਸਾਂਝਾ ਕਰਨਾ ਚਾਹੁੰਦੇ ਹੋ - ਕਹੋ, Ollama, ਇੱਕ ਓਪਨ WebUI ਉਦਾਹਰਨ, ਅਤੇ ਇੱਕ RAG ਅੰਤਮ ਬਿੰਦੂ ਨੂੰ ਮੁੱਠੀ ਭਰ ਸਹਿਯੋਗੀਆਂ ਦੇ ਨਾਲ ਬੇਨਕਾਬ ਕਰੋ - ਇਹ ਉਹ ਹੈ ਜੋ ਮੈਂ ਕਰਦਾ ਹਾਂ:
- FileVault ਚਾਲੂ ਹੈ ਅਤੇ ਇੱਕ ਮਜ਼ਬੂਤ ਲਾਗਇਨ ਪਾਸਵਰਡ। ਇਸਨੂੰ UPS 'ਤੇ ਰੱਖੋ।
- ਟੇਲਸਕੇਲ ਬਾਕਸ 'ਤੇ ਹੈ ਤਾਂ ਜੋ ਇਸ ਨੂੰ ਜਨਤਕ ਇੰਟਰਨੈਟ ਦੇ ਸੰਪਰਕ ਵਿੱਚ ਲਏ ਬਿਨਾਂ ਤੁਹਾਡੀ ਟੀਮ ਦੀਆਂ ਡਿਵਾਈਸਾਂ ਤੋਂ ਪਹੁੰਚਿਆ ਜਾ ਸਕੇ।
- Ollama ਨੂੰ ਲੋਕਲਹੋਸਟ ਨਾਲ ਬੰਨ੍ਹੋ ਅਤੇ ਇਸਨੂੰ ਇੱਕ ਪਤਲੇ ਪ੍ਰਮਾਣਿਕਤਾ ਪ੍ਰੌਕਸੀ (ਕੈਡੀ, ਟ੍ਰੈਫਿਕ, ਜਾਂ ਇੱਕ ਛੋਟਾ ਨੋਡ/ਪਾਈਥਨ ਸਰਵਰ) ਦੇ ਨਾਲ ਸਾਹਮਣੇ ਰੱਖੋ ਜੋ ਅੱਗੇ ਭੇਜਣ ਤੋਂ ਪਹਿਲਾਂ ਪ੍ਰਮਾਣਿਕਤਾ ਅਤੇ ਦਰ ਨੂੰ ਸੀਮਿਤ ਕਰਦਾ ਹੈ
11434. - ਡੌਕਰ ਡੈਸਕਟਾਪ ਵਿੱਚ ਓਪਨ ਵੈਬਯੂਆਈ ਚਲਾਓ ਇੱਕ ਸਥਾਈ ਵਾਲੀਅਮ ਦੇ ਨਾਲ; ਇਸਨੂੰ ਸਥਾਨਕ Ollama ਅੰਤਮ ਬਿੰਦੂ 'ਤੇ ਪੁਆਇੰਟ ਕਰੋ।
- ਬੈਕਅੱਪ RAG ਡੇਟਾਬੇਸ ਲਈ ਇੱਕ ਐਨਕ੍ਰਿਪਟਡ ਬਾਹਰੀ SSD ਜਾਂ ਇੱਕ ਟਾਈਮ ਮਸ਼ੀਨ ਟੀਚੇ ਲਈ।
- ਆਟੋ-ਅੱਪਡੇਟ ਇੱਕ ਅਨੁਸੂਚੀ 'ਤੇ macOS ਅਤੇ Homebrew ਪੈਕੇਜ; Ollama ਅਤੇ ਮਾਡਲ ਸੰਸਕਰਣਾਂ ਨੂੰ ਆਟੋ-ਪੁਲਿੰਗ ਨਵੀਨਤਮ ਦੀ ਬਜਾਏ ਜਾਣਬੁੱਝ ਕੇ ਪਿੰਨ ਕਰੋ।
ਵਧੀਆ ਕੀਤਾ, ਤੁਹਾਡੇ ਕੋਲ ਇੱਕ ਨਿਜੀ, ਆਡਿਟ-ਅਨੁਕੂਲ AI ਅੰਤਮ ਬਿੰਦੂ ਹੈ ਜਿਸਦੀ ਵਰਤੋਂ ਤੁਹਾਡੀ ਟੀਮ ਹਰ ਰੋਜ਼ ਕਰਦੀ ਹੈ ਅਤੇ ਇਹ ਕਦੇ ਵੀ ਇਮਾਰਤ ਦੇ ਨੈਟਵਰਕ ਤੋਂ ਟੋਕਨ ਨਹੀਂ ਭੇਜਦੀ ਹੈ।
13. ਸਿੱਟਾ: ਡੈਸਕ 'ਤੇ ਇੱਕ ਸ਼ਾਂਤ ਇਨਕਲਾਬ
2026 ਵਿੱਚ ਇੱਕ Mac Studio M4 Max ਨੂੰ ਅਨਬਾਕਸ ਕਰਨਾ ਇੱਕ ਡੈਸਕਟਾਪ ਖਰੀਦਣ ਵਰਗਾ ਘੱਟ ਅਤੇ ਇੱਕ ਛੋਟਾ AI ਉਪਕਰਣ ਖਰੀਦਣ ਵਰਗਾ ਮਹਿਸੂਸ ਕਰਦਾ ਹੈ ਜੋ ਇੱਕ ਮੈਕ ਵੀ ਹੁੰਦਾ ਹੈ। ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਦੇ 128 GB, 40 GPU ਕੋਰ, 16 CPU ਕੋਰ, ਇੱਕ ਨਿਊਰਲ ਇੰਜਣ, ਹਾਰਡਵੇਅਰ ਮੀਡੀਆ ਏਨਕੋਡਰ, ਇੱਕ 2 TB SSD, ਅਤੇ ਸਿੰਗਲ ਵਾਟਸ ਵਿੱਚ ਮਾਪਿਆ ਇੱਕ ਨਿਸ਼ਕਿਰਿਆ ਪਾਵਰ ਡਰਾਅ - ਇਹ ਸਭ ਇੱਕ ਬਾਕਸ ਵਿੱਚ ਤੁਸੀਂ ਇੱਕ ਹੱਥ ਨਾਲ ਚੁੱਕ ਸਕਦੇ ਹੋ।
ਸੈੱਟਅੱਪ ਤੇਜ਼ ਹੈ, ਪਹਿਲਾ LLM ਇੱਕ ਘੰਟੇ ਦੇ ਅੰਦਰ ਚੱਲ ਰਿਹਾ ਹੈ, ਅਤੇ ਇੱਕ ਦੁਪਹਿਰ ਦੇ ਅੰਦਰ ਤੁਹਾਡੇ ਕੋਲ ਇੱਕ ਨਿੱਜੀ RAG ਪਾਈਪਲਾਈਨ ਹੈ ਜੋ ਤੁਹਾਡੇ ਆਪਣੇ ਦਸਤਾਵੇਜ਼ਾਂ ਦੇ ਸਵਾਲਾਂ ਦੇ ਜਵਾਬ ਦਿੰਦੀ ਹੈ। ਸਾਰੀ ਚੀਜ਼ ਤੁਹਾਡੇ ਡੈਸਕ 'ਤੇ ਵਾਪਰਦੀ ਹੈ, ਬੈਕਗ੍ਰਾਉਂਡ ਵਿੱਚ ਕੋਈ ਕਲਾਉਡ ਬਿੱਲ ਟਿਕ ਨਾ ਹੋਣ ਦੇ ਨਾਲ। ਇਹ ਇਸ ਤਰੀਕੇ ਨਾਲ ਬਦਲਦਾ ਹੈ ਕਿ ਤੁਸੀਂ AI ਨਾਲ ਕਿਵੇਂ ਬਣਾਉਂਦੇ ਹੋ, ਜਦੋਂ ਤੱਕ ਤੁਸੀਂ ਇਸ ਨੂੰ ਅਜ਼ਮਾਉਂਦੇ ਹੋ ਉਦੋਂ ਤੱਕ ਦੱਸਣਾ ਮੁਸ਼ਕਲ ਹੁੰਦਾ ਹੈ।
ਜੇਕਰ ਤੁਸੀਂ ਇਹ ਮੁਲਾਂਕਣ ਕਰ ਰਹੇ ਹੋ ਕਿ ਕੀ ਤੁਹਾਡੀ ਟੀਮ ਦੇ ਹਾਰਡਵੇਅਰ ਮਿਸ਼ਰਣ ਵਿੱਚ ਇੱਕ Mac Studio ਹੈ, ਤਾਂ ਮੈਂ ਉਮੀਦ ਕਰਦਾ ਹਾਂ ਕਿ ਇਸ ਲੇਖ ਨੇ ਤੁਹਾਨੂੰ ਇੱਕ ਆਧਾਰਿਤ ਦ੍ਰਿਸ਼ ਦਿੱਤਾ ਹੈ: ਕੀ ਹੈਰਾਨੀਜਨਕ ਹੈ, ਮੋਟਾ ਕੀ ਹੈ, ਕਿੱਥੇ ਬੱਦਲ ਅਜੇ ਵੀ ਜਿੱਤਦਾ ਹੈ, ਅਤੇ ਜਿੱਥੇ ਤੁਹਾਡੇ ਡੈਸਕ 'ਤੇ ਬਕਸਾ ਵਧੀਆ ਜਵਾਬ ਹੈ। ਸਾਥੀ ਛੋਟਾ ਬਲੌਗ ਸਾਂਝਾ ਕਰਨ ਲਈ 5-ਮਿੰਟ ਦੇ ਰੀਡ ਵਿੱਚ ਉਸੇ ਵਰਕਫਲੋ ਨੂੰ ਡਿਸਟਿਲ ਕਰਦਾ ਹੈ।
ਜੇ ਇਹ ਲਾਭਦਾਇਕ ਸੀ - ਯੂਟਿਊਬ 'ਤੇ ਅਨਬਾਕਸਿੰਗ ਦੇਖੋ (https://youtube.com/shorts/HUlUoHNsyNM, ਫਾਲੋ-ਅਪ ਟਿਊਟੋਰਿਅਲਸ (MLX ਫਾਈਨ-ਟਿਊਨਿੰਗ, ਮਲਟੀ-ਮੈਕ ਇਨਫਰੈਂਸ, ਏਜੰਟ ਸਟੈਕ) ਲਈ ਚੈਨਲ ਦੀ ਗਾਹਕੀ ਲਓ, ਅਤੇ ਲੜੀ ਦੇ ਅਗਲੇ ਲੇਖ ਲਈ ਇੱਥੇ ਵਾਪਸ ਦੇਖੋ। Apple Silicon 'ਤੇ ਸਥਾਨਕ AI ਹੁਣੇ ਸ਼ੁਰੂ ਹੋ ਰਿਹਾ ਹੈ, ਅਤੇ ਸਟੈਕ ਦੇ ਪਰਿਪੱਕ ਹੋਣ 'ਤੇ ਮੈਂ ਲਿਖਦਾ ਰਹਾਂਗਾ।
ਇਸ ਲੇਖ ਲਈ ਐਸਈਓ ਸਨੈਪਸ਼ਾਟ
- ਐਸਈਓ ਸਿਰਲੇਖ: ਅਨਬਾਕਸਿੰਗ Mac Studio M4: ਆਪਣਾ ਪਹਿਲਾ LLM ਸਥਾਨਕ ਤੌਰ 'ਤੇ ਚਲਾਓ
- ਮੈਟਾ ਵਰਣਨ: 128 GB ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਦੇ ਨਾਲ ਇੱਕ Mac Studio M4 Max ਨੂੰ ਅਨਬਾਕਸ ਕਰੋ, Ollama ਸਥਾਪਤ ਕਰੋ, Llama 3 ਸਥਾਨਕ ਤੌਰ 'ਤੇ ਚਲਾਓ, ਅਤੇ ਇੱਕ ਨਿੱਜੀ RAG ਪਾਈਪਲਾਈਨ ਬਣਾਓ। ਅਸਲ ਰੀਡਿੰਗ, ਇਮਾਨਦਾਰ ਤੁਲਨਾ.
- ਪ੍ਰਾਇਮਰੀ ਕੀਵਰਡ: Mac Studio AI, Mac Studio LLM, Mac Studio 'ਤੇ LLM ਨੂੰ ਚਲਾਉਣਾ, Ollama Mac Studio, Apple Silicon AI, ਸਥਾਨਕ AI ਸੈੱਟਅੱਪ, Mac Studio RAG, ਸਥਾਨਕ LLM ਟਿਊਟੋਰਿਅਲ, Llama ਸਥਾਨਕ ਤੌਰ 'ਤੇ ਚਲਾਓ, Mac Studio M4 ਸਮੀਖਿਆ।
- Twitter / X (280 ਅੱਖਰਾਂ ਤੋਂ ਘੱਟ): ਇੱਕ Mac Studio M4 Max ਨੂੰ ਅਨਬਾਕਸ ਕੀਤਾ ਗਿਆ। 128 GB ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ। 6.48 ਡਬਲਯੂ 'ਤੇ ਆਈਡਲਜ਼ ਨੇ Ollama ਰਾਹੀਂ Llama 3.1 8B ਨੂੰ ਖਿੱਚਿਆ, ਦੁਪਹਿਰ ਵਿੱਚ ਇੱਕ ਸਥਾਨਕ RAG ਪਾਈਪਲਾਈਨ ਬਣਾਈ, ਕੋਈ ਕਲਾਊਡ ਬਿੱਲ ਨਹੀਂ। ਪੂਰਾ 4000-ਸ਼ਬਦ ਵਾਕਥਰੂ + 6 ਡਾਇਗ੍ਰਾਮ + YouTube ਛੋਟਾ। #AppleSilicon #LocalLLM
- ਲਿੰਕਡਇਨ ਪੋਸਟ: ਨਵਾਂ Mac Studio M4 Max ਮੇਰੇ ਡੈਸਕ 'ਤੇ ਉਤਰਿਆ ਅਤੇ ਮੈਂ ਇਸਨੂੰ ਇੱਕ AI ਉਪਕਰਣ ਦੀ ਤਰ੍ਹਾਂ ਸਮਝਿਆ: ਮੈਕਟੌਪ ਤੋਂ ਅਸਲ ਰੀਡਿੰਗ (6.48 W ਨਿਸ਼ਕਿਰਿਆ, 128 GB UMA, 40 GPU ਕੋਰ), Ollama ਇੰਸਟਾਲ, Llama 3.1 8B ਸਥਾਨਕ ਤੌਰ 'ਤੇ ਚੱਲ ਰਿਹਾ ਹੈ, ਇੱਕ ਪੂਰੀ RAG ਪਾਈਪਲਾਈਨ ਦੇ ਵਿਰੁੱਧ ਦੁਪਹਿਰ ਵਿੱਚ ਮੇਰੀ ਆਪਣੀ ਇੱਕ ਪਾਈਪਲਾਈਨ ਹੈ। ਮੈਂ ਛੇ ਮੂਲ ਚਿੱਤਰਾਂ, ਇੱਕ ਇਮਾਨਦਾਰ ਕਲਾਉਡ-ਬਨਾਮ-ਸਥਾਨਕ ਫੈਸਲੇ ਮੈਟ੍ਰਿਕਸ, ਅਤੇ ਇੱਕ ਭਾਗ ਜਿੱਥੇ ਕਲਾਉਡ ਅਜੇ ਵੀ ਜਿੱਤਦਾ ਹੈ, ਦੇ ਨਾਲ ਪੂਰਾ ਵਰਕਫਲੋ ਲਿਖਿਆ ਹੈ। ਜੇਕਰ ਤੁਸੀਂ ਆਪਣੀ ਟੀਮ ਲਈ ਸਥਾਨਕ AI ਦਾ ਮੁਲਾਂਕਣ ਕਰ ਰਹੇ ਹੋ, ਤਾਂ ਇਹ ਸ਼ੁਰੂ ਕਰਨ ਲਈ ਇੱਕ ਆਧਾਰਿਤ ਥਾਂ ਹੈ।