Workstation প্রযুক্তিগত সংক্ষিপ্ত: কিভাবে LLM এবং মাল্টি-এজেন্ট বাধাগুলি উন্মোচন করবেন ওপেনটেলিমেট্রি, Prometheus/Grafana/Thanos, এবং LLM প্ল্যাটফর্ম যেমন ল্যাংফিউজ / LMNR — স্প্যান স্কিমা, খরচ অ্যাট্রিবিউশন, স্যাম্পলিং এবং হার্ড ইউজ ক্যাপ সহ। সঙ্গী: ব্যবসা ব্লগ পরিবেশন: টার্বোচার্জিং LLMs ল্যাব: এন্টারপ্রাইজ এআই ল্যাব.
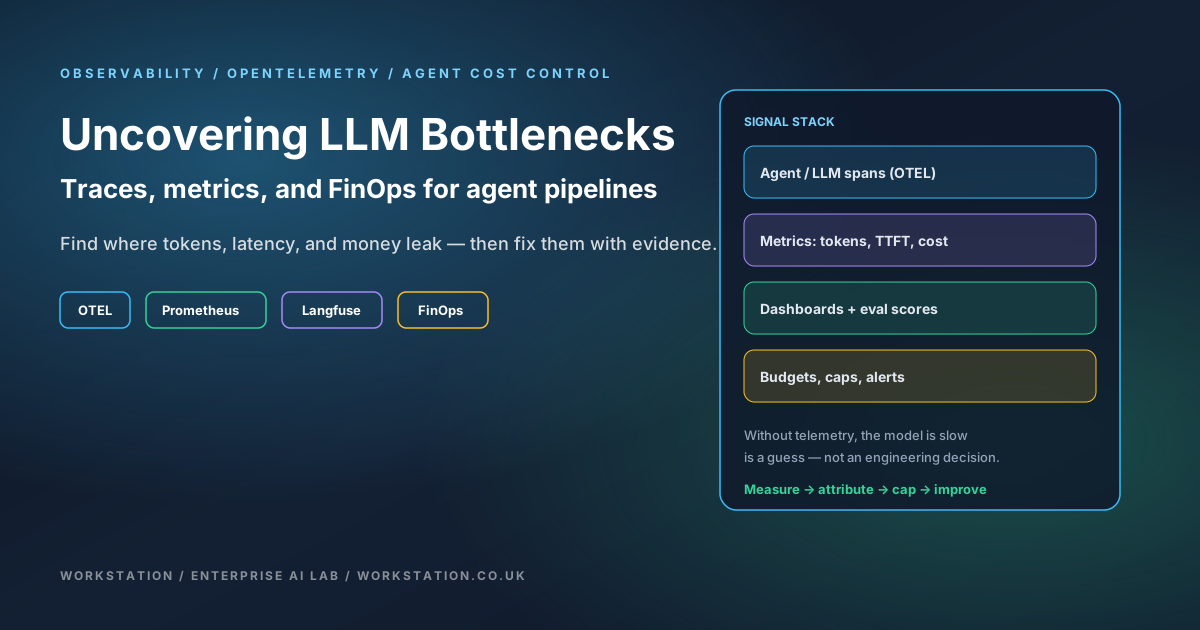
- সমস্যা: এজেন্ট খরচ এবং লেটেন্সি হপসে লুকান (LLM → টুলস → RAG → পুনঃপ্রচার), একটি একক "মডেল ইজ স্লো" মেট্রিকে নয়।
- স্ট্যান্ডার্ড: OpenTelemetry সহ যন্ত্র; টোকেন, মডেল, ভাড়াটে, রুট, আনুমানিক_কস্ট_ইউএসডির জন্য একটি বৈশিষ্ট্য স্কিমা।
- মেট্রিক্স পাথ: সোনালী সংকেতের জন্য প্রমিথিউস (+ থানোস); SLO এবং FinOps বোর্ডের জন্য Grafana।
- LLM পথ: ট্রেস, স্কোর, ডেটাসেট, প্রম্পট সংস্করণের জন্য Langfuse/LMNR।
- নিয়ন্ত্রণ: ক্যাপ টোকেন, টুল কল, এবং ডিবাগ রাউন্ড; ধাপে অসুবিধা দ্বারা রুট মডেল.
- জয়: আপনি আরও GPU কেনার আগে বা API কোটা বাড়াতে খরচ-প্রতি-সফল-টাস্ক পরিমাপ করুন।
1. LLM এজেন্টদের জন্য "বাটলনেক" বলতে কী বোঝায়
প্রশিক্ষণের সময় বাধা (ডেটা, FLOPs) পরিবেশন-সময়ের থেকে আলাদা এবং এজেন্ট সময় বাধা উৎপাদন এজেন্টে প্রভাবশালী বর্জ্য মোড হল:
- প্রম্পট bloat — বড় আকারের সিস্টেম প্রম্পট, অপ্রয়োজনীয় প্রেক্ষাপট, অনুপস্থিত উপসর্গ/ক্যাশে হিট।
- মডেল overkill — শ্রেণীবদ্ধ/রুট পদক্ষেপের জন্য ব্যবহৃত ফ্রন্টিয়ার মডেল যা একটি ছোট মডেল করতে পারে।
- সীমাহীন লুপ — টুল পুনরায় চেষ্টা এবং একটি কঠিন বাজেট ছাড়া স্ব-ডিবাগ চক্র (এতে Self-Debugging ট্রেড-অফ দেখুন টার্বোচার্জিং LLMs).
- বাহ্যিক অপেক্ষা — ভেক্টর DB, SaaS APIs, এবং হিউম্যান-ইন-দ্য-লুপ গেটগুলি "LLM লেটেন্সি"-এর জন্য ভুল বৈশিষ্ট্যযুক্ত৷
- ফ্র্যাগমেন্টেশন পরিবেশন — GPU (PagedAttention/vLLM টেরিটরি) এ KV ক্যাশে বর্জ্য আপনি ইতিমধ্যে নিশ্চিত করেছেন যে এজেন্ট গ্রাফটি সুস্থ।
বিতরণ করা ট্রেস ছাড়া আপনি এগুলি আলাদা করতে পারবেন না। পর্যবেক্ষণযোগ্যতা তাই একটি চমৎকার ড্যাশবোর্ড নয় - এটি AI পণ্যগুলিতে FinOps এবং SRE-এর নিয়ন্ত্রণ প্লেন।
2. রেফারেন্স আর্কিটেকচার
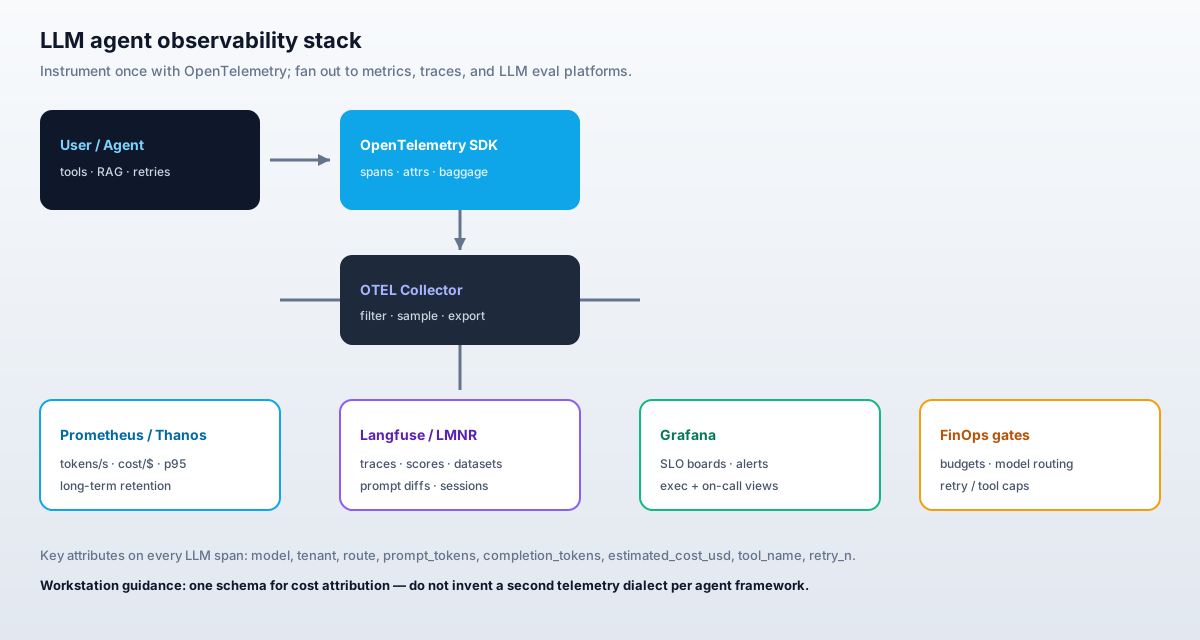
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. LLM কলের জন্য OpenTelemetry স্প্যান স্কিমা
ফ্রেমওয়ার্ক জুড়ে একটি কনভেনশন গ্রহণ করুন (LangChain, কাস্টম Go/Python এজেন্ট, বেডরক SDKs)। সেম্যান্টিক কনভেনশন পছন্দ করুন যেখানে তারা বিদ্যমান, এবং স্থিতিশীল Workstation বৈশিষ্ট্যগুলির সাথে প্রসারিত করুন:
| বৈশিষ্ট্য | উদাহরণ | কেন |
|---|---|---|
gen_ai.system | openai / anthropic / bedrock / vllm | প্রদানকারী rollups |
gen_ai.request.model | claude-sonnet-4/llama-3.1-8b | মডেল অনুযায়ী খরচ এবং গুণমান |
gen_ai.usage.input_tokens | 1820 | প্রম্পট খরচ ড্রাইভার |
gen_ai.usage.output_tokens | 410 | সম্পূর্ণ খরচ ড্রাইভার |
wsw.estimated_cost_usd | 0.0124 | পরে মূল্য শীট যোগদান ছাড়া FinOps |
wsw.tenant_id | acme-প্রোড | চার্জব্যাক |
wsw.route | support.triage | পণ্য বৈশিষ্ট্য অ্যাট্রিবিউশন |
wsw.agent_step | পরিকল্পনা / টুল / সমালোচনা | ব্যয়বহুল পদক্ষেপ খুঁজুন |
wsw.retry_n | 2 | লুপ সনাক্তকরণ |
wsw.prompt_version | triage@v17 | রিগ্রেশন লিঙ্কেজ |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
অনুশীলন: গণনা estimated_cost_usd স্প্যান এ প্রাইস শীটে টোকেন গণনায় যোগদানের জন্য একটি রাতের কাজের জন্য অপেক্ষা করবেন না — অন-কল এবং পণ্যের মালিকদের লাইভ FinOps প্রয়োজন।
3 খ. মাল্টি-এজেন্ট স্প্যান শ্রেণিবিন্যাস এবং লাগেজ
এজেন্ট গ্রাফগুলির জন্য একটি স্থিতিশীল পিতামাতা/শিশু মডেলের প্রয়োজন যাতে খরচ সঠিকভাবে রোল আপ হয়:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- ব্যবহারকারীর টাস্ক প্রতি একটি রুট — LLM কল প্রতি নয়। সেশন খরচ = সন্তানের যোগফল
wsw.estimated_cost_usd. - লাগেজ — প্রচার করা
wsw.tenant_idএবংwsw.routeasync কর্মী/সারি জুড়ে তাই টুল স্প্যান প্রতিটি কল সাইট পুনরায় প্লাম্বিং ছাড়াই চার্জব্যাক লেবেল উত্তরাধিকারী হয়। - লিঙ্ক — যখন একটি সাব-এজেন্ট একটি নতুন ট্রেস শুরু করে (যেমন পৃথক সারি ভোক্তা), প্যারেন্ট সেশনে ফিরে স্প্যান লিঙ্কগুলি ব্যবহার করুন যাতে Langfuse/Grafana এখনও গ্রাফটি সেলাই করতে পারে।
- সর্বদা-নমুনা উচ্চ খরচ — 5-20% এ মাথার নমুনা সুখী পথের জন্য ঠিক আছে; যখন সেশন খরচ একটি থ্রেশহোল্ড বা স্থিতি = ERROR অতিক্রম করে তখন নমুনা বাধ্য করুন৷
4. ম্যাট্রিক্স যা গুরুত্বপূর্ণ (প্রমিথিউস)
হিস্টোগ্রাম এবং কাউন্টার রপ্তানি করুন (OTEL মেট্রিক্স বা প্রমিথিউস ক্লায়েন্টের মাধ্যমে)। ন্যূনতম কার্যকর সেট:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}যেখানে দিক ∈ {ইনপুট, আউটপুট}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_secondsহিস্টোগ্রামagent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}— খরচ-প্রতি-সাফল্যের জন্য হর
প্রাপ্ত FinOps প্রশ্ন (PromQL স্কেচ):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
থানোস (বা মিমির/কর্টেক্স) গুরুত্বপূর্ণ যখন ফিনান্স কোয়ার্টার-ওভার-কোয়ার্টার মডেল খরচের জন্য বলে। স্থানীয় প্রমিথিউস একা অন-কলের জন্য ঠিক আছে; এটি একটি FinOps সংরক্ষণাগার নয়।
5. Grafana বোর্ড এবং সতর্কতা
একটি ডেটাসোর্স থেকে তিনটি শ্রোতা পাঠান:
- অন-কল: ত্রুটির হার, p95 e2e, নির্ভরতা ব্যর্থতা (ভেক্টর DB / টুলস)।
- প্ল্যাটফর্ম: টোকেন/s, GPU util (যদি স্ব-হোস্ট করা হয়), সারির গভীরতা, TTFT।
- FinOps / পণ্য: ভাড়াটে এবং রুট দ্বারা $/সফলতা, শীর্ষ ব্যয়বহুল প্রম্পট, মডেল মিক্স।
বার্নের বিষয়ে সতর্কতা, ভ্যানিটি নয়:
- খরচ-প্রতি-সাফল্য > বাজেট SLO 30m জন্য
- একটি রুটের জন্য পুনরায় চেষ্টা করার হার > 15%
- ক্রমবর্ধমান ইনপুট টোকেনগুলির সাথে p95 e2e লঙ্ঘন (প্রম্পট রিগ্রেশন)
6. LLM-নেটিভ প্ল্যাটফর্ম: Langfuse, LMNR, এবং বন্ধুরা
মেট্রিক্স আপনাকে বলে যে খরচ spiked; LLM প্ল্যাটফর্ম আপনাকে বলে যা প্রম্পট সংস্করণ এবং কোন টুল স্প্যান এটা করেছে ল্যাংফিউজ এবং LMNR এই শ্রেণীর ওপেন সোর্স উদাহরণ:
- অনুক্রমিক ট্রেস (সেশন → এজেন্ট → LLM / টুল স্প্যান)
- বিচারক হিসাবে মানবিক এবং LLM স্কোর
- আপনি যখন প্রম্পট পরিবর্তন করেন তখন অফলাইন ইভালের জন্য ডেটাসেট
- পণ্যের উন্নতির জন্য ঐচ্ছিক ব্যবহার টেলিমেট্রি (গোপনীয়তা নীতিকে সম্মান করুন)
ইন্টিগ্রেশন প্যাটার্ন: OTEL-কে SRE-এর রেকর্ডের সিস্টেম হিসাবে রাখুন; প্রম্পট ইঞ্জিনিয়ারিংয়ের জন্য ল্যাংফিউজে দ্বৈত-রপ্তানি বা সেতু। একটি দ্বিতীয়, বেমানান বৈশিষ্ট্য অভিধান উদ্ভাবন করবেন না.
ফ্রেমওয়ার্ক পরীক্ষা-নিরীক্ষা যেমন ফাংশন-ফার্স্ট এজেন্ট রানটাইম (ঐতিহাসিকভাবে কাঠামোগত স্ট্রিমিং এজেন্টের চারপাশে বাজারজাত করা হয়) বয়লারপ্লেট কমাতে পারে, কিন্তু কুলুঙ্গি ফ্রেমওয়ার্ককে ঐচ্ছিক হিসাবে বিবেচনা করে — পর্যবেক্ষণযোগ্যতার মানগুলি সেগুলিকে ছাড়িয়ে যায়।
7. স্কোরিং পাইপলাইন: ম্যানুয়াল বনাম স্বয়ংক্রিয়
| পদ্ধতি | বাস্তবায়ন | ব্যর্থতা মোড |
|---|---|---|
| ম্যানুয়াল | Langfuse UI-তে থাম্বস/রুব্রিক্স; স্বর্ণ সেট পর্যালোচনা. | স্কেল না; ক্রমাঙ্কনের জন্য এখনও প্রয়োজন। |
| স্বয়ংক্রিয় | LLM-বিচারক হিসাবে, ইউনিট চেক, স্কিমা যাচাইকারী, পুনরুদ্ধার প্রত্যাহার। | বিচারক প্রবাহ; গেমিং যদি শুধুমাত্র বিচারকের জন্য অপ্টিমাইজ করে। |
স্প্যান ইভেন্ট বা ল্যাংফিউজ স্কোর হিসাবে স্কোর সংযুক্ত করুন wsw.prompt_version. প্রম্পটের গেট প্রচারগুলি একইভাবে আপনি অ্যাপ সংস্করণগুলি গেট করেন — কোডের জন্য Ring Promoter; প্রম্পট জন্য eval গেট.
8. খরচ-সঞ্চয় প্রক্রিয়া (বিস্তারিত)
- বেসলাইন সপ্তাহ: আচরণ পরিবর্তন নেই; শুধুমাত্র যন্ত্র। $/সাফল্য, টোকেন/সফলতা, পুনরায় চেষ্টা করার হার ক্যাপচার করুন।
- অ্যাট্রিবিউশন: খরচ × ভলিউম দ্বারা রুট র্যাঙ্ক. শীর্ষ তিনটি বাছুন।
- মডেল রাউটিং: বিভক্ত শ্রেণীবদ্ধ/ছোট/স্থানীয় মডেলের নির্যাস; সংশ্লেষণের জন্য সীমান্ত রাখুন। গুণমানের স্কোর পুনরায় পরিমাপ করুন।
- দ্রুত অস্ত্রোপচার: অব্যবহৃত টুল স্কিমা অপসারণ; কয়েকটি শট ছোট করা; যেখানে নিরাপদ সেখানে উপসর্গ ক্যাশে সক্ষম করুন।
- লুপ ক্যাপ: সর্বোচ্চ টুল কল, সর্বোচ্চ স্ব-ডিবাগ রাউন্ড, সার্কিট ব্রেকার সহ সূচকীয় ব্যাকঅফ।
- স্যাম্পলিং: 100% মেট্রিক্স রাখুন; নমুনা ট্রেস (যেমন 5-20%) প্লাস ত্রুটি এবং উচ্চ-খরচ সেশনের জন্য সর্বদা স্যাম্পলিং।
- সংশোধন: রপ্তানির আগে স্প্যান অ্যাট্রিবিউট থেকে PII স্ট্রিপ করুন; TTL-এর সাথে শুধুমাত্র অনুমোদিত দোকানে সম্পূর্ণ প্রম্পট সঞ্চয় করুন।
- রিভিউ ক্যাডেন্স: সাপ্তাহিক FinOps বোর্ড; মানুষের বিরুদ্ধে মাসিক বিচারক ক্রমাঙ্কন.
8 খ. লাইভ বাজেটের সাথে এজেন্টের ব্যবহার পরিচালনা করা
শুধু ড্যাশবোর্ডই পলাতক এজেন্টদের থামায় না। রানটাইমে বাজেট প্রয়োগ করুন, একটি স্প্যান ইভেন্ট হিসাবে সিদ্ধান্তটি নির্গত করুন এবং যখন সেশনগুলি প্রায়শই সিলিংয়ে আঘাত করে তখন সতর্ক করুন:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- প্রতি-সেশন ক্যাপ — USD, LLM কল, টুল কল (উপরে)।
- প্রতি ভাড়াটে দৈনিক কোটা — রেডিস/কাউন্টার দ্বারা চাবি করা
wsw.tenant_id; ক্লান্ত হয়ে গেলে একটি নিয়ন্ত্রিত অবনমিত পথ ফিরিয়ে দিন। - প্রতি-রুট মডেল নীতি — জন্য অনুমোদিত মডেল
support.triageবনামlegal.draft; নীতি মিস এবং রেকর্ড প্রত্যাখ্যান বা ডাউনশিফ্টwsw.policy_action=downshift. - ইমপোটেন্ট টুল কী — হ্যাশ টুল আর্গস তাই পুনঃপ্রচারের জন্য এক্সটারনাল APIs দ্বিগুণ বিল না।
- খরচের সূত্র —
cost = in_tokens × p_in + out_tokens × p_out + tool_fees; রিফ্রেশp_in/p_outএকটি সংস্করণ মূল্য শীট থেকে তাই ঐতিহাসিক Thanos ডেটা তুলনাযোগ্য থাকে।
ক্যাপ ল্যান্ডের পরে দেখার মেট্রিক: agent_budget_exhausted_total{route,reason}. একটি স্পাইক মানে হয় অপব্যবহার, একটি ভাঙা টুল লুপ, অথবা একটি বাজেট যা বাস্তব কাজের চাপের জন্য খুব শক্ত।
9. কালেক্টর কনফিগারেশন স্কেচ
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. সুবিধা, অসুবিধা, এবং কখন বিরক্ত করবেন না
সুবিধা: চার্জব্যাক, দ্রুত ঘটনা ট্রাইজ, প্রম্পট/মডেল পরিবর্তনে পরিমাপযোগ্য ROI, কমপ্লায়েন্স-ফ্রেন্ডলি অডিট ট্রেল, ML এবং প্ল্যাটফর্ম টিমের মধ্যে ভাগ করা ভাষা।
অসুবিধা: উপকরণ ঋণ; স্টোরেজ খরচ যদি আপনি প্রতিটি প্রম্পট চিরতরে রাখেন; ভুল ব্যাকএন্ডে PII পাঠানোর ঝুঁকি; ইঞ্জিনিয়ারদের শেখার জন্য আরেকটি কনসোল।
এড়িয়ে যান (আপাতত) যদি: আপনার নির্দিষ্ট দৈনিক খরচ সহ একটি একক অফলাইন ব্যাচের কাজ আছে এবং কোনো ইন্টারেক্টিভ এজেন্ট নেই। এখনও লগ টোকেন; কনকারেন্সি উপস্থিত না হওয়া পর্যন্ত সম্পূর্ণ মাল্টি-ব্যাকএন্ড স্ট্যাকটি এড়িয়ে যান।
11. মাইগ্রেশন চেকলিস্ট
- ☐ এজেন্ট রানটাইমে OTEL SDK; ক্লাস্টারে সংগ্রাহক
- ☐ স্প্যান বৈশিষ্ট্যগুলির মধ্যে রয়েছে মডেল, টোকেন, খরচ, ভাড়াটে, রুট
- ☐ প্রমিথিউস মেট্রিক্স + গ্রাফানা ফিনঅপস বোর্ড
- ☐ ল্যাংফিউজ (বা LMNR) অন্তত একটি জটিল পথের জন্য তারযুক্ত
- ☐ টোকেন / টুলস / পুনঃপ্রয়াসের উপর হার্ড ক্যাপ
- ☐ রিডাকশন নীতি নিরাপত্তা দ্বারা পর্যালোচনা করা হয়েছে
- ☐ শীর্ষ রুটের জন্য $/সফলতার সাপ্তাহিক পর্যালোচনা
- ☐ নথি ADR লিঙ্কিং পর্যবেক্ষণযোগ্যতা → পরিবেশন (vLLM) → প্রচার (Ring Promoter)
12. সম্পর্কিত Workstation উপাদান
- ব্যবসায়িক ব্লগ সহচর
- টার্বোচার্জিং LLMs — আপনি বাধা দেখতে পাওয়ার পরে পরিবেশন ঠিক করুন
- Ring Promoter - স্বাস্থ্য গেট সহ এজেন্ট পরিষেবা প্রচার করুন
- Muse Glimmer / স্থানীয় এজেন্ট
- যোগাযোগ Workstation এন্টারপ্রাইজ এআই ল্যাব ব্যস্ততার জন্য
তথ্যসূত্র
দ্বারা প্রকাশিত Workstation.


